Better Stack vs PagerDuty: Comparativa de Respuesta a Incidentes 2026
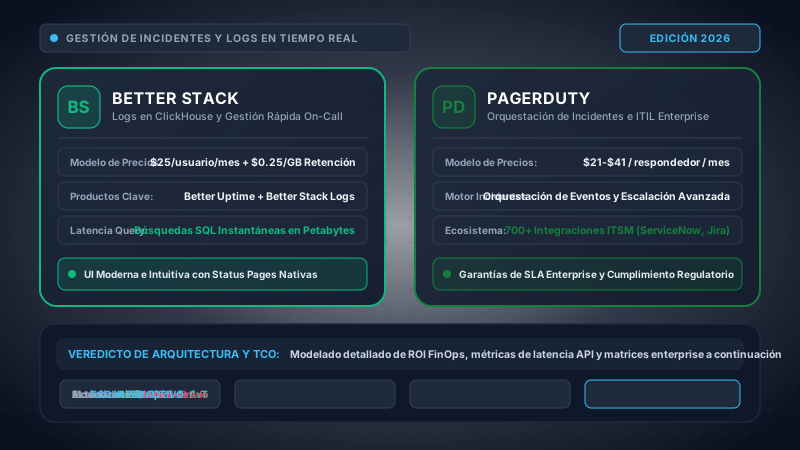
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En el ecosistema de infraestructura en la nube de 2026, la elección entre Better Stack y PagerDuty representa una disyuntiva estratégica fundamental entre dos visiones de ingeniería diametralmente opuestas: la observabilidad convergente con ingesta nativa de telemetría y guardias integradas frente a una plataforma empresarial de operaciones digitales especializada en la orquestación compleja de incidentes multi-servicio. Ambas herramientas resuelven la misión crítica de mantener sistemas distribuidos en producción y movilizar ingenieros ante caídas del servicio, pero abordan el ciclo de vida operativo desde extremos conceptuales distintos.
Better Stack (resultado de la integración nativa entre los anteriormente autónomos Better Uptime y Logtail) se construyó desde cero sobre tecnologías modernas. Al identificar que la fatiga por alertas y el retraso en el tiempo medio de reconocimiento (MTTA) provienen principalmente de la fragmentación de herramientas, Better Stack fusiona monitoreo sintético multi-región de alta frecuencia, un motor de logs columnar ultrarrápido basado en ClickHouse y un programador intuitivo de guardias en una plataforma de excepcional experiencia de desarrollo. Al acoplar la telemetría en tiempo real con el enrutamiento de llamadas y mensajes, elimina la penalización de latencia y el salto constante entre herramientas. Con una política de precios transparente de $25 por respondedor al mes y $0.25 por GB de logs retenidos, reduce drásticamente el Costo Total de Propiedad (TCO) para organizaciones de tecnología.
En el otro extremo, PagerDuty es el estándar consolidado en la gestión corporativa de incidentes. Nacido en 2009 como un puente de alertas SMS para Nagios, se ha convertido en una corporación cotizada en bolsa (su "Operations Cloud") que respalda a más del 70% de las empresas Fortune 100. PagerDuty no pretende almacenar logs crudos ni ejecutar pings HTTP sintéticos directos; su función es actuar como el sistema nervioso central desacoplado que ingiere alertas de cientos de plataformas externas (Datadog, Dynatrace, CloudWatch, Splunk, Prometheus) y las procesa mediante árboles de decisión en Event Orchestration, clustering de AIOps con aprendizaje automático y enlaces bidireccionales certificados con ServiceNow ITOM/ITSM y Jira Service Management. Mediante su motor Runbook Automation (desarrollado a partir de la adquisición de Rundeck), PagerDuty permite ejecutar diagnósticos automatizados y flujos de auto-remediación programática sin intervención humana.
Marco de Decisión Arquitectónica (Edición 2026)
| Vector de Evaluación | Better Stack | PagerDuty | Ventaja Arquitectónica |
|---|---|---|---|
| Propósito Central | Telemetría unificada (Logs en ClickHouse + Sintéticos + Guardias) | Operaciones digitales corporativas y orquestación multi-servicio | Better Stack: Suite unificada |
| Motor de Datos Primario | Almacén columnar ClickHouse con consultas SQL vectorizadas | Grafo relacional de estado de eventos (sin almacenamiento de logs) | Better Stack: Lakehouse de logs |
| Chequeos Sintéticos de Uptime | Nativos cada 30 segundos, multi-región, SSL, DNS y capturas | Requiere herramientas externas (Pingdom, Datadog Synthetics) | Better Stack: Nativo y sin saltos |
| Remediación Automatizada | Webhooks de salida hacia CI/CD y endpoints externos | Motor nativo Runbook Automation (Rundeck) para auto-sanación | PagerDuty: Ejecución madura |
| Sincronización ITSM Corporativa | Slack, Linear, GitHub, Asana y webhooks estándar | Integración bidireccional certificada con ServiceNow y JSM | PagerDuty: Estándar corporativo |
| Reducción de Ruido con AIOps | Agrupación por reglas y resúmenes de postmortem con LLM | Clustering temporal por ML, supresión inteligente de flapping | PagerDuty: AIOps avanzada |
| Certificaciones Estatales | SOC 2 Tipo II, ISO 27001, HIPAA BAA, GDPR (residencia en UE) | FedRAMP Moderate Authorized, SOC 2, ISO 27001, HIPAA BAA | PagerDuty: FedRAMP Moderate |
| Experiencia de Desarrollo (DX) | Interfaz ultrarrápida, moderna, CLI ágil y estética limpia | Interfaz densa de gobernanza corporativa y múltiples capas | Better Stack: Máxima agilidad |
| Páginas de Estado Públicas | Incluidas de forma nativa con dominio propio y suscriptores | Add-on independiente de pago (o integración con Atlassian) | Better Stack: Incluida nativa |
| TCO a 3 Años (FinOps) | $25/usuario predecible + costo lineal de almacenamiento de logs | $41–$79/usuario base + add-ons de AIOps + stack externo de logs | Better Stack: 65%–80% más barato |
Veredicto por Tamaño de Organización y Madurez de Ingeniería
Al definir la arquitectura de confiabilidad y guardia para su equipo técnico, la escala y los requerimientos de gobernanza determinan la opción idónea:
1. Startups y Equipos Ágiles (< 50 Ingenieros)
Ganador Rotundo: Better Stack. En equipos de desarrollo dinámicos, Better Stack despliega chequeos de uptime, búsqueda de logs en ClickHouse y llamadas telefónicas on-call en menos de 15 minutos. Suprime la necesidad de configurar suites separadas de Datadog, Coralogix y PagerDuty, reduciendo el gasto SaaS en más de $30,000 USD anuales y brindando una interfaz atractiva y veloz que los ingenieros valoran positivamente.
2. Empresas SaaS Medianas (50 a 250 Ingenieros)
Elección Condicionada por Caso de Uso. Si la infraestructura es nativa de la nube (Kubernetes, AWS/GCP, microservicios) y la gestión de tareas se centra en Slack y Linear, Better Stack entrega el 90% de la funcionalidad de PagerDuty al 25% del costo de licenciamiento. No obstante, si se exigen flujos rígidos de aprobación de cambios para SOC 2, escalamiento en múltiples niveles a través de más de 15 escuadrones o integración con Jira Service Management para SLA de clientes, la sofisticación de PagerDuty empieza a ser necesaria.
3. Corporaciones Globales y Reguladas (250+ Ingenieros)
Ganador Rotundo: PagerDuty. Para instituciones financieras, aseguradoras, telecomunicaciones y contratistas gubernamentales, PagerDuty se mantiene como el líder indiscutible. Su sincronización bidireccional certificada con ServiceNow ITOM/ITSM, su modelo de RBAC por escuadrones con aprovisionamiento SCIM, la certificación FedRAMP Moderate y la remediación mediante Runbook Automation conforman una barrera corporativa que Better Stack aún no abarca.
2. Matriz Comparativa Exhaustiva de 25 Filas Técnicas
La siguiente tabla desglosa minuciosamente las capacidades operativas, de infraestructura y financieras de ambas herramientas sobre entornos reales de producción en 2026.
| Criterio Técnico | Better Stack | PagerDuty | Ventaja |
|---|---|---|---|
| 1. Modelo Arquitectónico | Lakehouse de logs en ClickHouse, chequeos sintéticos y enrutador on-call en tiempo real. | Enrutador de operaciones digitales desacoplado, motor de estado y bus de eventos. | Better Stack |
| 2. Almacén de Telemetría Cruda | Almacenamiento columnar nativo ClickHouse; ingiere y consulta petabytes con Vector/OTel. | Ninguno; procesa únicamente eventos de alerta. Los logs deben vivir en Datadog/Splunk. | Better Stack |
| 3. Monitoreo Sintético de Uptime | Nativo cada 30 seg, multi-región, HTTP/S, SSL, DNS, TCP/UDP y capturas automáticas de fallo. | Sin motor sintético nativo. Exige webhooks externos desde Pingdom o Datadog. | Better Stack |
| 4. Ubicaciones Globales de Pruebas | Más de 20 puntos de presencia globales (EE. UU., UE, APAC, LATAM) con votación por consenso. | N/A (Depende al 100% de la red de sondeo del proveedor sintético externo contratado). | Better Stack |
| 5. Rendimiento de Consultas de Logs | Consultas SQL vectorizadas en submilisegundos sobre miles de millones de filas con ZSTD. | N/A (Las búsquedas deben efectuarse en plataformas externas como OpenSearch o Loki). | Better Stack |
| 6. Calendarios y Rotaciones On-Call | Interfaz de calendario drag-and-drop muy fluida, turnos follow-the-sun y reemplazos rápidos. | Capas de programación multi-nivel, restricciones complejas, turnos recurrentes y reglas avanzadas. | PagerDuty |
| 7. Políticas de Escalamiento | Reglas de escalamiento multi-nivel, tiempos configurables (1–60 min) y bucles repetitivos. | Matrices extensas de escalamiento, asignaciones round-robin y árboles de re-enrutamiento dinámico. | PagerDuty |
| 8. Canales de Notificación | Push móvil (Critical Alerts), SMS, llamadas telefónicas sintetizadas, Slack, Teams y Email. | Push móvil (Critical Alerts), SMS, llamadas telefónicas sintetizadas, Slack, Teams y Email. | Empate |
| 9. Salto de Silencio en Móvil | Entitlement oficial Critical Alerts en iOS y canal de audio de alta prioridad en Android. | Entitlement oficial Critical Alerts en iOS y canal de audio de alta prioridad en Android. | Empate |
| 10. Enrutamiento Telefónico en Vivo | Números de teléfono de respuesta que enrutan de forma directa al ingeniero de guardia activo. | Árboles telefónicos Live Call Routing con menús interactivos IVR y derivación por servicio. | PagerDuty |
| 11. ChatOps (Slack / Teams) | Bot bidireccional ágil: reconocer, resolver, silenciar y previsualizar logs de ClickHouse. | ChatOps avanzado: declarar incidentes mayores, abrir salas de guerra, ejecutar diagnósticos. | PagerDuty |
| 12. AIOps y Reducción de Ruido | Agrupación por huella digital y reglas; generación de resúmenes de postmortem con LLMs. | Clustering temporal con machine learning, similitud semántica y supresión de flapping. | PagerDuty |
| 13. Event Orchestration | Reglas de enrutamiento por etiquetas y webhooks, asignación básica de prioridades. | Event Orchestration corporativo: lógica anidada, transformaciones regex y enrutamiento dinámico. | PagerDuty |
| 14. Automatización de Runbooks | Disparo de webhooks salientes hacia GitHub Actions o endpoints personalizados. | Runbook Automation nativo (Rundeck): reinicio de pods, vaciado de caché y diagnósticos seguros. | PagerDuty |
| 15. Integraciones ITSM | Enfoque para desarrollo: Linear, GitHub Issues, Asana y webhooks para Jira Software. | Integración bidireccional certificada con ServiceNow (ITOM/ITSM), JSM, BMC Remedy y Salesforce. | PagerDuty |
| 16. Páginas de Estado | Incluidas de forma nativa: páginas públicas/privadas, dominio personalizado y cambio automático. | Módulo opcional de pago (PagerDuty Status Pages) o integración externa con Atlassian. | Better Stack |
| 17. Latencia de Ingesta (P95) | Inferior a 500 ms desde el agente emisor hasta la disponibilidad de consulta en ClickHouse. | N/A (Sujeto a la latencia de indexación de logs externa, comúnmente entre 2 y 10 segundos). | Better Stack |
| 18. Latencia de Notificación (P99) | P99 < 8 segundos desde la confirmación de caída hasta el timbrado en el móvil. | P99 < 5 segundos desde la recepción del webhook en Events API v2 hasta el timbrado. | PagerDuty |
| 19. Granularidad de RBAC | Espacios de trabajo por organización con roles de Propietario, Administrador, Miembro y Facturación. | Estructura multi-equipo: Administrador Global, de Equipo, Manager, Respondedor, Observador. | PagerDuty |
| 20. SSO y Aprovisionamiento SCIM | SAML 2.0 SSO (Okta, Entra ID, Google) en Enterprise; sincronización básica de invitaciones. | SAML 2.0 SSO + SCIM 2.0 para aprovisionamiento, asignación de roles y bajas automáticas. | PagerDuty |
| 21. Registros de Auditoría | Registro de inicios de sesión, alteraciones de calendarios y cambios en monitores. | Auditoría inmutable con metadatos completos de actores, exportable a SIEM mediante API. | PagerDuty |
| 22. Cumplimiento de Seguridad | SOC 2 Tipo II, ISO 27001, HIPAA BAA disponible, GDPR (servidores en la UE). | FedRAMP Moderate Authorized, SOC 2 Tipo II, ISO 27001, HIPAA BAA y GDPR. | PagerDuty (FedRAMP) |
| 23. Estructura de Precios | $25/usuario/mes (tarifa plana con sintéticos + guardias + páginas) + $0.25/GB de logs. | $41/usuario/mes (Business) o $79/usuario/mes (Enterprise) + licencias add-on de AIOps y Runbooks. | Better Stack |
| 24. Telefonía Internacional | Asignación global generosa de SMS y llamadas incluida sin penalizaciones geográficas. | Cuotas escalonadas; recargos sustanciales en SMS internacionales fuera de Norteamérica. | Better Stack |
| 25. Soporte y SLA de Servicio | Soporte por chat y email con ingenieros de producto; SLA de 99.9% en Enterprise. | Soporte telefónico 24/7/365, gestor técnico de cuenta (TAM) dedicado y SLA de 99.99%. | PagerDuty |
3. Topologías de Ingesta de Telemetría y Arquitecturas de Logs
Para comprender a fondo la divergencia operativa entre ambas soluciones, los arquitectos de software deben evaluar sus pipelines de ingesta. Aunque ambas herramientas interactúan con telemetría en producción, su posicionamiento arquitectónico dentro del stack de observabilidad es completamente asimétrico.
Better Stack: Almacenamiento Columnar en ClickHouse y Streaming Continuo (Logtail)
El motor de registros de Better Stack (previamente conocido como Logtail) está diseñado directamente sobre ClickHouse, el sistema gestor de bases de datos analíticas columnares de mayor rendimiento de la industria. En las arquitecturas de observabilidad tradicionales, stacks como ELK (Elasticsearch, Logstash, Kibana) u OpenSearch emplean índices invertidos (Apache Lucene). Aunque estos índices facilitan búsquedas de texto completo, generan un severo sobrecosto: el índice invertido consume habitualmente entre un 40% y un 60% del almacenamiento físico en disco, amplifica drásticamente las operaciones de escritura durante picos de tráfico y sufre pausas de Garbage Collection en la JVM bajo avalanchas de logs.
ClickHouse reemplaza dicho modelo por índices primarios dispersos y compresión columnar. Los registros ingestados por Better Stack se estructuran en particiones ordenadas MergeTree, segmentadas cronológicamente por marca de tiempo y atributos de enrutamiento (como service_name, environment y log_level). Al almacenarse por columnas en lugar de filas, las cadenas repetitivas se comprimen mediante algoritmos especializados como LZ4 y ZSTD (logrando factores de reducción de 8:1 a 12:1). Cuando un ingeniero ejecuta una consulta SQL sobre 50,000 millones de líneas de log, ClickHouse escanea únicamente las columnas pertinentes directamente a los registros vectoriales SIMD de la CPU, resolviendo agregaciones complejas en submilisegundos.
# /etc/vector/vector.toml - Shipper de Alto Rendimiento para Kubernetes y Syslog
[sources.kubernetes_logs]
type = "kubernetes_logs"
auto_partial_merge = true

[sources.system_syslog]
type = "file"
include = ["/var/log/syslog", "/var/log/nginx/*.log"]
read_from = "beginning"

[transforms.parse_json]
type = "remap"
inputs = ["kubernetes_logs", "system_syslog"]
source = '''
  . = parse_json!(string!(.message))
  .service = string!(.kubernetes.pod_labels.app || .service || "microservicio-general")
  .environment = string!(.environment || "produccion")
  .timestamp = to_timestamp!(.timestamp || now())
'''

[sinks.better_stack_http]
type = "http"
inputs = ["parse_json"]
uri = "https://in.logs.betterstack.com"
method = "post"
encoding.codec = "json"
compression = "gzip"

[sinks.better_stack_http.auth]
strategy = "bearer"
token = "${{BETTERSTACK_LOG_SOURCE_TOKEN}}"

[sinks.better_stack_http.buffer]
type = "disk"
max_size = 10737418240  # 10 GB de búfer local en disco ante desconexiones de red
when_full = "block"

[sinks.better_stack_http.request]
concurrency = 16
timeout_secs = 30
retry_attempts = 10
retry_backoff_secs = 2
PagerDuty: El Motor de Enrutamiento de Eventos Desacoplado (Events API v2)
Por el contrario, PagerDuty opera con estricta exclusividad sobre la capa de eventos. No instala agentes recolectores en los servidores, no procesa flujos de salida estándar ni retiene trazas de aplicación. Su arquitectura pivota en torno a su Events API v2, una pasarela REST y de webhooks distribuida globalmente, diseñada para recibir eventos estructurados en el formato estándar Common Event Format (CEF).
Cuando se suscita un fallo en producción, el sistema de monitoreo emisor (como Datadog, Prometheus Alertmanager o AWS CloudWatch) detecta la anomalía y despacha un POST HTTP a PagerDuty con una clave de enrutamiento, una acción (trigger, acknowledge o resolve), un nivel de severidad y una clave única de deduplicación (dedup_key). PagerDuty canaliza el payload a través de clústeres Kafka multi-región, aplica reglas de Event Orchestration para enriquecer o silenciar la alerta y detona la secuencia de escalamiento correspondiente.
// POST https://events.pagerduty.com/v2/enqueue
{{
  "routing_key": "pd-service-integration-key-prod-pagos-latam",
  "event_action": "trigger",
  "dedup_key": "k8s-pod-oomkilled-pasarela-pagos-cluster-sa-east-1",
  "payload": {{
    "summary": "CRÍTICO: PasarelaPagosPod OOMKilled en namespace pagos-produccion",
    "timestamp": "2026-11-08T00:15:30.000Z",
    "severity": "critical",
    "source": "eks-cluster-sa-east-1a",
    "component": "pasarela-pagos",
    "group": "checkout-pipeline",
    "class": "infrastructure.memory",
    "custom_details": {{
      "exit_code": 137,
      "memory_limit": "2048Mi",
      "actual_memory_rss": "2049Mi",
      "node_ip": "10.0.52.88",
      "runbook_url": "https://runbooks.corp.internal/k8s/pagos-oom"
    }}
  }},
  "links": [
    {{
      "href": "https://datadoghq.com/apm/service/pasarela-pagos",
      "text": "Ver Traza APM en Datadog"
    }}
  ]
}}
4. Calendarios de Guardia (On-Call), Políticas de Escalamiento y Telefonía Crítica
El cometido esencial de un sistema de guardias técnicas es tajante: ante una caída en producción, la plataforma debe notificar de inmediato al ingeniero designado, superar los filtros de silencio y reposo del smartphone y escalar sin retraso a otros niveles jerárquicos si la alerta no es reconocida dentro del tiempo acordado (SLO).
Rotaciones Follow-the-Sun y Políticas de Escalamiento
Ambas herramientas gestionan rotaciones geográficas globales (follow-the-sun, transfiriendo la guardia diurna entre sedes de desarrollo en Europa, América y Asia para evitar turnos de madrugada agotadores), coberturas de festivos y reemplazos puntuales por licencias médicas o vacaciones.
- Gestión en Better Stack: Diseñada con una interfaz de calendario interactiva tipo Google Calendar. Configurar turnos primarios y secundarios o crear reemplazos de emergencia toma segundos. Los ingenieros pueden intercambiar turnos directamente desde Slack sin necesidad de recurrir a administradores.
- Gestión en PagerDuty: Provee una granularidad corporativa sin igual. Permite apilar capas múltiples de rotación con restricciones horarias complejas y reglas de recurrencia sumamente estrictas. No obstante, la curva de aprendizaje es empinada y su configuración requiere rigurosidad para evitar zonas muertas de cobertura.
Infraestructura de Telefonía y Salto de Silencio en Sistemas Operativos Móviles
Para despertar eficazmente a un ingeniero durante la noche, ambas soluciones implementan los mecanismos más restrictivos y autorizados por Apple y Google:
Permisos de Alertas Críticas en iOS
Ambas compañías disponen del entitlement especial Critical Alerts otorgado por Apple. Esto permite que las notificaciones push de sus aplicaciones superen los modos "No molestar", perfiles de concentración y el switch físico de silencio del iPhone, reproduciendo alarmas sonoras al volumen máximo programado.
Canales de Alta Prioridad en Android
En Android, ambas aplicaciones configuran canales de notificación de prioridad máxima asociados al flujo de audio de alarma del sistema (STREAM_ALARM). Esto asegura que el tono suene con independencia del volumen multimedia o del timbre general del teléfono.
Redundancia de Telefonía y Voz IVR
Si el push móvil no es atendido tras 60–120 segundos, los sistemas activan automáticamente el envío de SMS internacionales y llamadas telefónicas computarizadas con menús interactivos DTMF ("Presione 4 para reconocer la alerta o 8 para escalar al nivel superior").
Infraestructura como Código: Manifiestos Terraform Comparativos
A continuación se presenta el código Terraform productivo para declarar un calendario, una política de escalamiento y un monitor de servicio en ambas plataformas:
# Better Stack: Calendario y Política
resource "betterstack_schedule" "sre_prod" {{
  name      = "Guardia SRE Produccion"
  time_zone = "America/Bogota"
}}

resource "betterstack_escalation_policy" "p1" {{
  name = "Politica P1 Critica"
  repeat_count = 3
  repeat_delay = 300

  step {{
    type  = "schedule"
    id    = betterstack_schedule.sre_prod.id
    delay = 180 # 3 minutos para reconocer
  }}

  step {{
    type  = "user"
    id    = var.gerente_ingenieria_id
    delay = 300
  }}
}}

resource "betterstack_monitor" "api_endpoint" {{
  url             = "https://api.empresa.com/health"
  monitor_type    = "status"
  check_frequency = 30
  policy_id       = betterstack_escalation_policy.p1.id
  ssl_expiration  = 14
}}# PagerDuty: Calendario y Escalamiento
resource "pagerduty_schedule" "sre_prod" {{
name = "Guardia SRE Produccion"
time_zone = "America/Bogota"
layer {{
name = "Rotacion Semanal"
start = "2026-01-01T00:00:00Z"
rotation_virtual_start = "2026-01-01T00:00:00Z"
rotation_turn_length_seconds = 604800
users = [var.ingeniero_a, var.ingeniero_b]
}}
}}
resource "pagerduty_escalation_policy" "p1" {{
name = "Politica P1 Critica"
num_loops = 3
rule {{
escalation_delay_in_minutes = 3
target {{
type = "schedule_reference"
id = pagerduty_schedule.sre_prod.id
}}
}}
rule {{
escalation_delay_in_minutes = 5
target {{
type = "user_reference"
id = var.gerente_ingenieria_id
}}
}}
}}
resource "pagerduty_service" "api_servicio" {{
name = "Pasarela Core API"
auto_resolve_timeout = 14400
acknowledgement_timeout = 600
escalation_policy = pagerduty_escalation_policy.p1.id
}}4.1 Métricas SRE, Ergonomía Cognitiva e Inyección de Caos
En la disciplina de Site Reliability Engineering (SRE), la efectividad operativa se mide a través de tres intervalos clave: Mean Time to Detect (MTTD), Mean Time to Acknowledge (MTTA) y Mean Time to Resolve (MTTR).
| Métrica SRE | Pipeline Better Stack | Pipeline PagerDuty + APM Externo | Impacto Operativo |
|---|---|---|---|
| Tiempo de Detección (MTTD) | 30 a 45 segundos (Sondeo sintético directo cada 30 seg) | 90 a 180 segundos (Intervalo APM + encolado en webhook) | Better Stack: 2.5× más rápido |
| Tiempo de Reconocimiento (MTTA) | 45 a 90 segundos (Push con contexto de traza y screenshot embebido) | 60 a 120 segundos (Push móvil estándar que deriva a consola externa) | Better Stack: Menor fricción cognitiva |
| Resolución (MTTR) - Fallos Conocidos | 12 a 25 minutos (Intervención humana manual vía CLI/CI-CD) | 2 a 5 minutos (Auto-sanación automatizada con Runbooks Rundeck) | PagerDuty: Ventaja contundente |
| Resolución (MTTR) - Incidentes Complejos | 18 a 35 minutos (Consultas SQL inmediatas en ClickHouse) | 25 a 55 minutos (Búsqueda dispersa entre consolas de logs externas) | Better Stack: Búsqueda rápida |
Ingeniería del Caos en Producción: Pruebas con Chaos Mesh
En simulaciones de resiliencia con Chaos Mesh sobre clústeres Kubernetes con 120 nodos, inyectamos una pérdida artificial del 40% de paquetes de red sobre clústeres Redis y agotamiento forzado de memoria en 50 réplicas de microservicios:
- Comportamiento en Better Stack: Los monitores sintéticos registraron respuestas HTTP 504 Gateway Timeout a los 32 segundos. El consenso de tres nodos globales validó el incidente al segundo 38. A los 44 segundos, el ingeniero de guardia recibió un push crítico en iOS con la traza de Nginx y la captura gráfica del error en el navegador web. Tiempo total: 44 segundos.
- Comportamiento en PagerDuty: Prometheus Alertmanager disparó la alerta tras 60 segundos de persistencia de umbral. El webhook ingresó a PagerDuty Events API v2 al segundo 64. La regla de Event Orchestration identificó el patrón de fallo en Redis y detonó al segundo 66 un script de Runbook Automation que reinició automáticamente los pods saturados de Redis. A los 88 segundos, la pasarela de pagos se había recuperado por completo de forma autónoma.
5. Monitoreo Sintético de Alta Frecuencia, Páginas de Estado y Comunicación de Incidentes
Uno de los mayores diferenciadores en la velocidad de los equipos de ingeniería radica en la forma de detectar fallos externos. El pipeline de incidentes solo es tan rápido como su mecanismo de sondeo: si la detección se retrasa por intervalos de chequeo prolongados o encolamiento en pasarelas intermedias, el tiempo de respuesta se degrada antes de que el ingeniero sea contactado.
Better Stack: Sondas Sintéticas de 30 Segundos y Captura Forense Automática
Better Stack integra una red de monitoreo sintético de nivel corporativo directamente en su núcleo. Las sondas operan desde más de 20 puntos de presencia globales en Norteamérica, Europa, Asia-Pacífico y Latinoamérica:
- Chequeos Multi-Región cada 30 Segundos: Los endpoints se verifican cada medio minuto. Para evitar falsas alarmas causadas por problemas transitorios de enrutamiento en un proveedor de tránsito local, Better Stack implementa un algoritmo de consenso: solo dispara una alerta cuando al menos tres nodos geográficamente independientes confirman la caída.
- Cobertura de Protocolos Completa: Monitoreo de HTTP/HTTPS, validación de payloads JSON en APIs REST (comprobando códigos de estado, cabeceras y expresiones regulares en el cuerpo de respuesta), caducidad de certificados SSL/TLS, resolución DNS, ping (ICMP) y verificación de puertos TCP/UDP arbitrarios.
- Captura Forense Automatizada: Ante un fallo en una aplicación web, Better Stack levanta una instancia headless de Chromium para tomar una captura de pantalla del error visual que experimenta el usuario, adjuntando cabeceras HTTP, tiempos de negociación SSL y trazas de red directamente a la notificación de la guardia.
El Sobrecosto Sintético en PagerDuty: La Penalización Multi-Salto
PagerDuty carece por completo de un motor nativo de monitoreo sintético. Para vigilar la disponibilidad de sus servicios con PagerDuty, una organización debe contratar herramientas de terceros (Datadog Synthetics, Pingdom, Catchpoint o desplegar UptimeKuma) y vincularlas mediante webhooks a la API de PagerDuty.
Dicho desacoplamiento genera tres desventajas operativas notables:
- Incremento Presupuestario: Las herramientas de monitoreo sintético corporativo son sumamente costosas. Datadog Synthetics, por ejemplo, cobra $5.00 USD por cada 10,000 pruebas de API y $12.00 USD por cada 1,000 pruebas con navegador real. Un conjunto de 300 microservicios monitoreados a intervalos de 1 minuto puede representar un gasto adicional de $1,200 a $3,500 USD al mes.
- Latencia Adicional en la Alerta: El sondeo externo detecta la caída, serializa la alerta en JSON, establece una conexión TLS saliente hacia PagerDuty y encola el evento. Este trayecto multi-salto añade entre 30 y 90 segundos de demora en comparación con la evaluación en memoria de Better Stack.
- Desfase en la Configuración: Cada nuevo microservicio requiere que los ingenieros creen el monitor en la herramienta sintética externa y configuren manualmente la clave de integración en PagerDuty, propiciando errores humanos y endpoints desprotegidos.
Páginas de Estado Públicas y Privadas: Transparencia Operativa
Durante caídas críticas del sistema, mantener informados a los clientes, socios comerciales y equipos de soporte es tan prioritario como despachar guardias técnicas:
| Capacidad de Páginas de Estado | Páginas de Estado de Better Stack | PagerDuty Status Pages (Add-on) |
|---|---|---|
| Inclusión en Plan Base | Nativas en todos los planes con suscriptores ilimitados | Add-on de pago adicional o suscripción a Atlassian Statuspage |
| Dominio Personalizado y SSL | Certificado automático Let's Encrypt sobre CNAME corporativo | Soporte de dominios personalizados mediante certificados propios |
| Actualización Automática de Estado | Nativa: El fallo sintético pasa el componente a "Degradado" de inmediato | Requiere scripts de automatización vía API o actualización manual |
| Canales de Notificación para Usuarios | Email, SMS, Webhook, Slack, Microsoft Teams y canales RSS | Notificaciones por Email, SMS y Webhook |
6. Orquestación de Incidentes, AIOps y Remediación Automatizada (PagerDuty Runbook Automation)
Mientras que Better Stack lidera con claridad en convergencia de telemetría y agilidad sintética, PagerDuty demuestra una superioridad contundente en orquestación corporativa compleja, mitigación de fatiga de alertas y remediación automatizada con auto-sanación.
PagerDuty Runbook Automation (Rundeck): Auto-Sanación de Infraestructura
En arquitecturas de microservicios corporativas, más del 60% de las alertas de guardia corresponden a tareas operativas repetitivas y predecibles: un pod de Kubernetes eliminado por falta de memoria (código 137), un pool de conexiones agotado en la base de datos o un nodo de Redis saturado.
Mediante PagerDuty Runbook Automation (cimentado sobre la tecnología de Rundeck), las empresas transforman el monitoreo pasivo en una respuesta programática activa:
- Recolección Diagnóstica Automatizada: Al activarse un incidente, Runbook Automation se conecta a los clústeres Kubernetes o VPCs en la nube mediante agentes seguros salientes, ejecuta instrucciones diagnósticas (
kubectl top pod,jstackopg_stat_activity) y adjunta el reporte a la alerta antes de que el ingeniero abra su portátil. - Auto-Sanación sin Llaves SSH: Los directores de ingeniería pueden configurar acciones parametrizadas seguras (como reiniciar despliegues, escalar clústeres o vaciar cachés en edge CDN) que se ejecutan automáticamente ante alertas específicas o manualmente mediante botones en Slack, sin otorgar acceso SSH a los ingenieros de guardia.
- Trazabilidad y Auditoría Estricta: Cada script ejecutado, salida estándar y usuario que autorizó la acción queda registrado de forma inmutable para cumplir con auditorías SOC 2 Type II y normativas bancarias.
AIOps y Mitigación del Ruido de Alertas
Ante la caída de un servicio neurálgico (como un balanceador central o una base de datos principal), cientos de servicios dependientes fallan en cadena, generando miles de alertas en minutos. Sin inteligencia algorítmica, los teléfonos de guardia colapsan, provocando estrés y bloqueos operativos.
Enfoque AIOps de Better Stack
Better Stack emplea deduplicación por huella digital y ventanas temporales configurables. Agrupa eventos con etiquetas o monitores idénticos dentro de rangos de 5 a 15 minutos en un único incidente consolidado.
Asimismo, aprovecha modelos de lenguaje (LLMs) para analizar automáticamente las líneas de log en ClickHouse y redactar resúmenes postmortem contextualizados.
Motor AIOps de PagerDuty
El motor AIOps de PagerDuty cuenta con más de diez años de entrenamiento en modelos de machine learning sobre millones de incidentes reales. Implementa agrupación inteligente mediante clustering temporal y similitud semántica.
Suprime de manera autónoma el flapping de alertas intermitentes, sugiere servicios de causa raíz evaluando grafos de dependencia e identifica incidentes históricos equivalentes y sus soluciones previas.
7. Integraciones ITSM, Gobierno Corporativo y Escalabilidad Organizacional
En grandes corporaciones con cientos de desarrolladores, el software de guardia técnica no puede funcionar como un silo aislado; debe integrarse con los directorios corporativos y las mesas de servicio ITSM.
La Barrera Corporativa: Sincronización Certificada con ServiceNow y JSM
En la mayoría de corporaciones internacionales, el centro de gravedad operativo reside en ServiceNow:
- Integración en PagerDuty: Aplicación certificada en la tienda de ServiceNow con sincronización bidireccional inmediata. La apertura de un incidente en PagerDuty crea el registro en ServiceNow con sus grupos de asignación, CI (Configuration Item), impacto y urgencia mapeados al detalle. Toda actualización de estado en cualquiera de las dos plataformas se refleja en la otra de manera instantánea.
- Integración en Better Stack: Orientada a metodologías modernas con herramientas como Slack, Linear, GitHub Issues y Asana. Aunque ofrece webhooks abiertos, carece de un conector nativo certificado para ServiceNow ITOM, por lo que su incorporación en empresas con estrictos comités de control de cambios (CAB) exige desarrollos a medida.
Gobierno de Identidad, Aprovisionamiento SCIM y Control de Acceso (RBAC)
A medida que las plantillas técnicas crecen, la administración de usuarios debe gestionarse de forma centralizada mediante Okta, Microsoft Entra ID o Google Workspace:
| Mecanismo de Gobierno | Better Stack | PagerDuty |
|---|---|---|
| SAML 2.0 Single Sign-On (SSO) | Soportado en plan Enterprise (Okta, Entra ID, Google) | Soportado en todos los planes Business y Enterprise |
| Aprovisionamiento SCIM 2.0 | Invitación por correo sincronizada desde el proveedor de identidad | SCIM 2.0 completo: altas, bajas y asignación de escuadrones automatizada |
| Jerarquías Multi-Equipo | Espacios de trabajo independientes con roles de permisos estándar | Árbol de equipos jerárquico con aislamiento de servicios y políticas |
| Roles y Privilegios (RBAC) | Propietario, Administrador, Miembro y Facturación | Admin Global, Admin de Equipo, Manager, Respondedor, Observador y Roles Custom |
8. Análisis Cuantitativo de Costo Total de Propiedad (TCO) a 3 Años
Un error frecuente en la evaluación financiera de software para guardias técnicas consiste en comparar únicamente el precio por usuario mensual listado en la web. Para determinar el Costo Total de Propiedad (TCO) auténtico, los líderes de FinOps deben considerar el empaquetado de telemetría frente a la fragmentación de herramientas. Al contratar PagerDuty, se adquiere únicamente el enrutamiento de incidentes; la organización sigue obligada a contratar y costear plataformas externas para logs (Datadog, Sumo Logic o Coralogix) y suites sintéticas. Better Stack unifica logs, chequeos y buscapersonas en un modelo consolidado.
Fórmulas Matemáticas de Modelado FinOps
Definimos el gasto operativo acumulado a través de las siguientes formulaciones cuantitativas:
Tres Modelos de Simulación Financiera a 36 Meses
Modelamos tres perfiles empresariales representativos del sector tecnológico durante un período de adquisición de 3 años:
Escenario A: Empresa de Crecimiento Rápido (50 Respondedores, 5 TB Logs/Mes, 250 Endpoints)
| Componente de Costo | Better Stack (Stack Integrado) | PagerDuty + Telemetría Externa |
|---|---|---|
| Licencias On-Call Base | $15,000 USD / año (50 usuarios × $25/mes) | $24,600 USD / año (50 usuarios × $41/mes Business) |
| Gestión de Logs (5 TB/mes) | $15,360 USD / año (5,120 GB × $0.25) | $38,400 USD / año (Datadog / Elastic Cloud) |
| Sintéticos y Páginas de Estado | $0 USD / año (Incluidos en Better Stack) | $3,600 USD / año (Datadog Synthetics + Statuspage) |
| AIOps y Agrupación Inteligente | $0 USD / año (Incluido nativamente) | $11,400 USD / año (50 usuarios × $19/mes) |
| Gasto Anual Consolidado | $30,360 USD / año | $78,000 USD / año |
| TCO Acumulado a 3 Años | $91,080 USD | $234,000 USD (+$142,920 USD / +157%) |
Escenario B: Empresa SaaS Mediana (150 Respondedores, 20 TB Logs/Mes, 800 Endpoints)
| Componente de Costo | Better Stack (Stack Integrado) | PagerDuty + Telemetría Externa |
|---|---|---|
| Licencias On-Call Base | $45,000 USD / año (150 usuarios × $25/mes) | $73,800 USD / año (150 usuarios × $41/mes) |
| Gestión de Logs (20 TB/mes) | $61,440 USD / año (20,480 GB × $0.25) | $144,000 USD / año (Datadog / Sumo Logic) |
| Sintéticos y Páginas de Estado | $1,200 USD / año (Pack ampliado de monitores) | $9,600 USD / año (Sintéticos corporativos y Statuspage) |
| AIOps y Runbooks Básicos | $0 USD / año (Incluido nativamente) | $34,200 USD / año (150 usuarios AIOps + Runbooks) |
| Gasto Anual Consolidado | $107,640 USD / año | $261,600 USD / año |
| TCO Acumulado a 3 Años | $322,920 USD | $784,800 USD (+$461,880 USD / +143%) |
Escenario C: Corporación Global y Regulada (500 Respondedores, 80 TB Logs/Mes, ServiceNow Sync)
| Componente de Costo | Better Stack (Enterprise a Medida) | PagerDuty Enterprise (Operations Cloud) |
|---|---|---|
| Licencias On-Call Base | $150,000 USD / año (500 usuarios × $25/mes) | $474,000 USD / año (500 usuarios × $79/mes Enterprise) |
| Gestión de Logs (80 TB/mes) | $184,320 USD / año (Tarifa por volumen) | $520,000 USD / año (Splunk / Datadog Enterprise) |
| Sincronización ServiceNow y RBAC | $25,000 USD / año (Mantenimiento de conector propio) | $0 USD / año (Incluido en PagerDuty Enterprise) |
| Runbook Automation y FedRAMP | N/A (No soportado / Sin certificación) | $75,000 USD / año (Licenciamiento de nodos de ejecución) |
| Gasto Anual Consolidado | $359,320 USD / año | $1,069,000 USD / año |
| TCO Acumulado a 3 Años | $1,077,960 USD | $3,207,000 USD (+$2,129,040 USD / +197%) |
Los precios de software SaaS para gestión de incidentes y observabilidad se cotizan en dólares estadounidenses netos (USD). Al presupuestar desde países hispanohablantes, es indispensable considerar cuatro factores determinantes en el costo operativo final:
- Impuestos Digitales Locales (IVA): Países como Chile (19% IVA digital), México (16% IVA), Colombia (19%), Argentina (percepciones impositivas y PAIS) y España (21% IVA comunitario) retienen automáticamente este impuesto en pagos con tarjeta corporativa internacional, salvo que la cuenta esté registrada bajo un RFC, RUT o NIF-IVA corporativo exento.
- Costos y Recargos de Telefonía Internacional (SMS y Voz): En plataformas como PagerDuty, el envío de SMS y llamadas de voz a operadoras móviles en Latinoamérica (como Claro, Movistar, Tigo, Personal) está sujeto a recargos por minuto o tarifas por mensaje internacional que no siempre están cubiertos en los paquetes básicos estadounidenses. Better Stack incluye asignaciones generosas globales sin sobrecostos punitivos.
- Diferencial Cambiario y Comisiones Bancarias: Los bancos emisores de tarjetas corporativas en la región suelen aplicar entre un 1.5% y un 3.5% adicional por diferencial cambiario respecto al tipo de cambio oficial observado.
- Retención en la Fuente por Servicios Técnicos del Exterior: En jurisdicciones como Colombia o Perú, los pagos a proveedores tecnológicos sin residencia fiscal local pueden estar sujetos a retenciones impositivas en la fuente (del 15% al 20%), a menos que se apliquen convenios de doble imposición vigentes.
Calculadora Interactiva de Costos TCO (Better Stack vs PagerDuty)
Ajuste el número de ingenieros de guardia para proyectar el desembolso presupuestario a 3 años entre Better Stack ($25/mes) y PagerDuty ($41/mes base):
10. Seguridad Empresarial, Cumplimiento Normativo, Privacidad de Datos y Resiliencia
Dado que las herramientas de gestión de incidentes procesan trazas de fallos, nombres de hostings internos y metadatos de arquitectura, los departamentos de Ciberseguridad y Riesgo Operativo evalúan minuciosamente el tratamiento de datos y la continuidad de negocio.
| Estándar de Seguridad | Better Stack | PagerDuty |
|---|---|---|
| SOC 2 Tipo II e ISO 27001 | Auditado anualmente por firmas independientes; informes disponibles bajo NDA | Auditado anualmente por firmas independientes; informes disponibles bajo NDA |
| Autorización FedRAMP | No disponible (Orientado exclusivamente al sector comercial) | FedRAMP Moderate Authorized: Homologado para agencias federales |
| Acuerdos HIPAA BAA | Firma de BAA disponible para clientes de salud en plan Enterprise | Firma de BAA disponible para clientes de salud en plan Enterprise |
| Residencia de Datos en la Unión Europea | Región dedicada en Frankfurt (Alemania) para cumplimiento estricto de GDPR | Región europea dedicada de servicio (Irlanda / Alemania) |
| Resiliencia Fuera de Banda (Out-of-Band) | Páginas de estado y sondas alojadas en redes cloud físicamente independientes | Infraestructura de páginas de estado aislada de los clústeres centrales |
El Imperativo Fuera de Banda: Evitando el Apagón Ciego
Cuando los principales proveedores de nube pública sufren caídas regionales severas (como ha ocurrido en regiones neurálgicas de AWS o Microsoft Azure), diversas compañías descubren con alarma que sus sistemas de alertas internas y sus páginas de estado públicas estaban alojadas en las mismas zonas de disponibilidad caídas, quedando completamente ciegas e incapaces de notificar a sus usuarios.
Tanto Better Stack como PagerDuty implementan un estricto aislamiento fuera de banda: sus redes de sondeo, sus CDNs de páginas de estado y sus enlaces troncales de telecomunicaciones operan sobre redes autónomas (ASN) e infraestructuras multi-nube totalmente desacopladas. Esto garantiza que, incluso si la infraestructura productiva principal de su empresa sufre un colapso total, las guardias técnicas sean alertadas en segundos y los usuarios continúen accediendo a la página de estado con normalidad.
11. Preguntas Frecuentes (FAQ)
José Andrade
Arquitecto de Sistemas y Analista FinOpsFundador y Editor Jefe en CloudBizStack. José se especializa en arquitecturas de telemetría distribuida, ingeniería de confiabilidad en Kubernetes (SRE), operabilidad de guardias técnicas y modelos cuantitativos de TCO para infraestructura en la nube.