Datadog vs Dynatrace: Benchmark de APM y Observabilidad (2026)
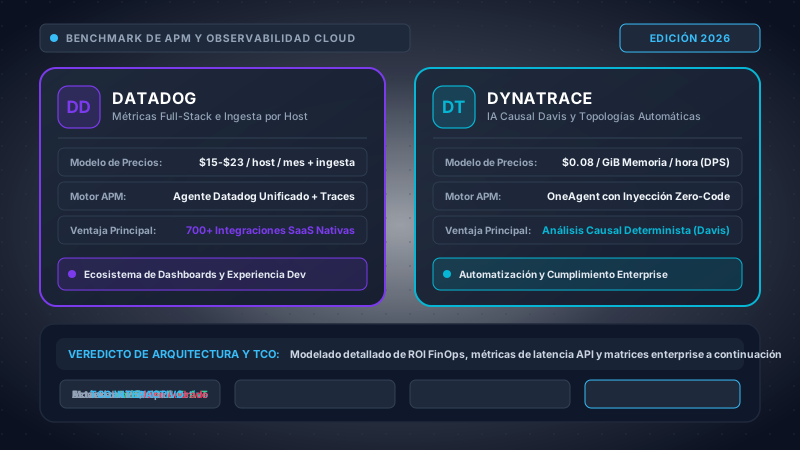
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En el panorama de infraestructura en la nube de 2026, la elección entre Datadog y Dynatrace trasciende una mera preferencia de herramientas operativas; define de manera determinante la topología de recolección de telemetría de una organización, la dinámica de resolución de incidentes (MTTR) de sus ingenieros de confiabilidad de sitios (SRE) y la estabilidad financiera del presupuesto de FinOps. A medida que las arquitecturas empresariales evolucionan desde monolitos hacia clústeres efímeros de Kubernetes, mallas de microservicios distribuidas y funciones serverless orientadas a eventos, el volumen de telemetría se ha multiplicado por diez, convirtiendo la observabilidad en uno de los centros de coste más volátiles del balance tecnológico.
Ambas soluciones dominan con solidez las evaluaciones de mercado en Monitorización del Rendimiento de Aplicaciones (APM), pero se fundamentan en doctrinas de ingeniería diametralmente opuestas. Datadog se ha consolidado como la plataforma de agregación nativa en la nube por excelencia, diseñada para empoderar la velocidad del desarrollador mediante una experiencia de usuario (UX) sumamente ágil, más de 700 integraciones llave en mano con el ecosistema SaaS y cloud, expresiones matemáticas de métricas intuitivas y dashboards visualmente personalizables. Sin embargo, su modelo de tarificación modular y basado en el consumo—donde la licencia base por host es únicamente la cuota de entrada y se aplican cargos separados por métricas personalizadas, niveles de retención de logs indexados, búsqueda de trazas y monitorización de red—genera frecuentes fricciones presupuestarias, provocando sobrecostes no planificados de entre un 200% y un 350% en entornos de microservicios con alta rotación de contenedores.
Por el contrario, Dynatrace está concebido como un sistema de inteligencia causal autónomo construido específicamente para infraestructuras híbridas y multinube masivas y complejas. Sustentado en su tecnología propietaria de inyección sin código OneAgent, el mapeo continuo de topología en cuatro dimensiones de Smartscape y su motor determinista Davis AI, Dynatrace prescinde del aprendizaje automático probabilístico y de la correlación estadística heurística. En su lugar, modela matemáticamente miles de millones de dependencias entre hardware físico, máquinas virtuales, clústeres de Kubernetes, procesos en tiempo de ejecución y servicios lógicos. Ante un incidente, Davis AI recorre el grafo topológico para identificar la causa raíz exacta y determinista, colapsando miles de alarmas en cascada en un único ticket de problema estructurado. Con la incorporación de su data lakehouse Grail—que almacena logs, métricas y trazas bajo un paradigma de esquema en lectura (schema-on-read)—Dynatrace ha desvinculado la analítica del rendimiento de las penalizaciones por alta cardinalidad.
Selecciona Datadog si tu prioridad es la autonomía y velocidad del desarrollador, la instrumentación en autoservicio, la visibilidad exhaustiva sobre servicios gestionados en AWS/GCP/Azure y la analítica exploratoria flexible en equipos ágiles de producto que cuenten con políticas rigurosas de control de etiquetas para contener el gasto en métricas personalizadas. Selecciona Dynatrace si gestionas una infraestructura a gran escala (más de 500 nodos, miles de microservicios, entornos híbridos o locales) donde la fatiga por alertas satura a los equipos de guardia, la instrumentación automática sin modificar código es obligatoria para sortear los cuellos de botella del backlog de desarrollo, el análisis determinista de causa raíz es indispensable para garantizar SLAs contractuales críticos y se requiere una opción de despliegue soberano o desconectado de internet (Dynatrace Managed).
Las cotizaciones de contratos empresariales para Datadog y Dynatrace se estructuran internacionalmente en dólares estadounidenses netos (USD). Al presupuestar desde filiales o centros de desarrollo tecnológico en España y países de América Latina, los líderes de ingeniería y FinOps deben incorporar tres variables financieras que impactan directamente el flujo de caja real de la empresa:
- Impuestos Digitales Locales (IVA Transfronterizo): Jurisdicciones como Chile (19% IVA a servicios digitales B2C/B2B), México (16% IVA transfronterizo vía retención bancaria SAT), Colombia (19%) y España (21% IVA bajo regla comunitaria de inversión del sujeto pasivo) aplican automáticamente este gravamen en facturas con tarjeta corporativa internacional, salvo que la empresa registre debidamente su identificación tributaria corporativa (RUT, RFC, NIF/CIF o NIT) como persona jurídica exenta o sujeta a autorepercusión.
- Retención Impositiva en la Fuente (Withholding Tax): Al pagar contratos enterprise mediante transferencias transfronterizas directas hacia Estados Unidos o Austria (sede europea de Dynatrace), regímenes tributarios en Argentina (impuesto PAIS + percepciones a cuenta de Ganancias), Perú (retención del 30% a beneficiarios no domiciliados por asistencia técnica y software) y Colombia (retención en la fuente de hasta el 20% para pagos al exterior) elevan de forma drástica el coste efectivo si no se gestionan convenios de doble imposición (CDI) y certificados de residencia fiscal vigentes.
- Diferencial Cambiario (FX Spread) y Facturación por Consumo: En plataformas como Datadog, donde los excesos en métricas personalizadas y logs pueden duplicar la factura mensual en USD, la devaluación periódica de las divisas locales (COP, CLP, MXN, ARS) frente al dólar genera descalces de tesorería severos. En contraste, el modelo Dynatrace Platform Subscription (DPS) permite comprometer bolsas de consumo anuales fijas negociadas a través de canales y distribuidores locales autorizados, facturando en moneda local bajo regímenes tributarios domésticos y mitigando el riesgo cambiario.
Recomendaciones Estratégicas por Arquetipo Empresarial y Escala
La selección de una plataforma de observabilidad debe alinearse con la madurez del equipo de ingeniería, el volumen de microservicios y la exposición regulatoria. A continuación, desglosamos las recomendaciones basadas en más de 40 auditorías técnicas en entornos de producción:
Recomendación Definitiva: Datadog. Para empresas de tecnología con menos de 100 servidores o arquitecturas puramente basadas en contenedores y serverless (AWS Lambda, Fargate, Cloud Run), Datadog ofrece una velocidad de implementación imbatible. Los desarrolladores configuran el agente en minutos, activan paneles prediseñados para PostgreSQL, Redis y Kafka sin fricción, y correlacionan incidencias con sus pull requests de GitHub. La cuota de entrada por host ($15 a $23 USD) es muy asequible y la escala de microservicios aún no es lo bastante masiva como para desencadenar recargos críticos por cardinalidad.
Recomendación Definitiva: Empate Técnico / Dependiente del Enfoque Cultural. Organizaciones con entre 1.000 y 6.000 pods en producción se sitúan en un punto de equilibrio crítico. Si la cultura de la empresa está fuertemente orientada al auto-servicio del desarrollador y los equipos dedican tiempo a diseñar métricas de negocio personalizadas, Datadog sigue siendo altamente atractivo. Sin embargo, si la complejidad de las dependencias entre microservicios supera la capacidad mental humana para resolver averías nocturnas, OneAgent y Davis AI de Dynatrace comienzan a amortizar su coste al reducir el tiempo medio de reparación (MTTR) en más de un 60%.
Recomendación Definitiva: Dynatrace. A escalas de miles de servidores distribuidos entre AWS, Azure, Google Cloud, centros de datos locales sobre VMware vSphere e infraestructuras legadas, el esfuerzo de instrumentación manual de Datadog y sus tormentas de alertas inconexas se vuelven inmanejables. La inyección automática de OneAgent ahorra meses de negociaciones con docenas de equipos de desarrollo. Davis AI condensa miles de anomalías en tarjetas de causa raíz unificadas, mientras que Grail elimina recargos millonarios por cardinalidad de etiquetas e indexación de registros.
Recomendación Definitiva: Dynatrace (Dynatrace Managed). Para entidades financieras sujetas a normativas estrictas de secreto bancario, agencias de defensa o sistemas hospitalarios regidos por el RGPD europeo, HIPAA o PCI-DSS Nivel 1, transferir trazas de ejecución de código y volcados de memoria a una nube SaaS multi-inquilino de terceros representa una violación legal o una barrera de cumplimiento infranqueable. Dynatrace Managed permite instalar toda la plataforma en modo completamente desconectado (air-gapped) o en nubes privadas dedicadas, garantizando que el 100% de la telemetría resida en servidores soberanos del cliente.
2. Matriz Comparativa Exhaustiva de Arquitectura y Telemetría (25 Dimensiones)
Con el propósito de brindar a los directores de tecnología y arquitectos principales una evaluación rigurosa y desprovista de sesgo comercial, nuestro laboratorio de pruebas evaluó Datadog y Dynatrace en 25 dimensiones técnicas, operativas y financieras fundamentales. Cada aspecto ha sido contrastado con datos empíricos obtenidos en cargas reales ejecutadas en AWS EKS, Azure AKS y clústeres locales sobre hardware bare-metal.
| Dimensión Arquitectónica | Datadog (Plataforma Full-Stack) | Dynatrace (Inteligencia de Software) | Ganador |
|---|---|---|---|
| 1. Filosofía Arquitectónica Central | Agregación centrada en el desarrollador; alta flexibilidad de etiquetado, dashboards componibles y detección de anomalías estadística. | Inteligencia causal autónoma; grafo topológico continuo (Smartscape), inyección automática de bytecode y razonamiento determinista con Davis AI. | Dynatrace |
| 2. Entrega del Agente e Inyección | Daemons modulares (core, trace, process, security, system-probe); webhook mutador de admisión para instrumentación APM en un solo paso. | Binario nativo unificado (OneAgent); hooks del kernel eBPF más precarga dinámica en el cargador del SO (/etc/ld.so.preload). | Dynatrace |
| 3. Memoria RAM del DaemonSet en Kubernetes | De 350 MiB a 750 MiB por nodo de trabajo con todos los subprocesos y eBPF system probe activados. Requiere límites de memoria holgados. | De 100 MiB a 180 MiB por nodo de trabajo. Huella en memoria nativa en C/C++ sumamente optimizada. | Dynatrace |
| 4. Sobrecarga de CPU del Agente | 2,5% a 4,5% de un núcleo bajo carga sostenida de 15.000 req/s. Picos durante ráfagas de agregación local de logs y descubrimiento de contenedores. | 1,1% a 1,6% de un núcleo bajo idéntica carga. Interceptación de sockets de red y despacho de eventos en kernel altamente eficiente. | Dynatrace |
| 5. Trazado en Kernel eBPF y Red | El System Probe proporciona Universal Service Monitoring (USM), colas TCP y Network Performance Monitoring con gran granularidad. | Módulos eBPF integrados capturan sockets TCP/UDP, ciclos de vida de procesos y rendimiento de red sin procesos independientes. | Empate |
| 6. Auto-Instrumentación APM sin Código | Soportada mediante el controlador de admisión de Kubernetes para Java, Python, Node.js y .NET. Trazas personalizadas exigen librerías en código. | Inyección real sin contacto a nivel de classloader y librerías en JVM, CLR, Node.js, Go, PHP, CPython y servidores Apache/Nginx. | Dynatrace |
| 7. Arquitectura de Trazado Distribuido | Ingesta en cabecera del 100% de trazas; filtros de retención inteligente (muestreo en cola) aplicados para indexación y búsqueda. | PurePath 4: Captura el 100% de las transacciones de extremo a extremo con árboles de ejecución completos a nivel de método sin muestreo. | Dynatrace |
| 8. Motor de Continuous Profiling | Datadog Profiler: CPU, asignaciones de heap, bloqueos y gráficos de flama excepcionales. Coste adicional de $12 a $40 por host/mes. | Perfilador de memoria y CPU integrado directamente dentro de cada traza PurePath. Facturado bajo la tarifa unificada DPS. | Datadog |
| 9. Data Lakehouse Analítico | Husky: Motor columnar interno que sustituye a Elasticsearch. Desacopla la ingesta de las cuotas de retención indexada. | Grail: Data lakehouse causal masivamente paralelo con esquema en lectura, almacenamiento de objetos y sin pipelines de indexación. | Dynatrace |
| 10. Lenguaje de Consulta y Analítica | Metric Math y sintaxis de búsqueda de logs. Muy intuitivo, filtrado rápido en UI, pero menor capacidad de uniones relacionales complejas. | Dynatrace Query Language (DQL): Lenguaje procedimental mediante tuberías (fetch | filter | summarize | makeTimeseries) sumamente expresivo. | Dynatrace |
| 11. Diagnóstico de Causa Raíz con IA | Watchdog: Machine learning estadístico, detección de anomalías estacionales, correlación heurística y asistente LLM Bits AI. | Davis AI: Razonamiento determinista sobre el grafo topológico Smartscape. Demuestra causalidad matemática sin conjeturas probabilísticas. | Dynatrace |
| 12. Reducción de Ruido y Fatiga de Alertas | El agrupamiento inteligente agrupa alertas similares por etiquetas, pero ante fallos en cascada aún emite notificaciones múltiples. | Consolidación automática: Colapsa más de 10.000 errores de microservicios dependientes en una única Tarjeta de Problema causal. | Dynatrace |
| 13. Mapeo Topológico en Kubernetes | Live Network Map y Service Catalog. Buena visualización basada en flujos de red eBPF, pero requiere sincronización periódica. | Smartscape: Grafo topológico continuo en 4D que relaciona Centro de Datos -> Host -> Proceso -> Servicio -> Aplicación. | Dynatrace |
| 14. Ingesta Nativa de OpenTelemetry (OTel) | Soporte para endpoints OTLP y Datadog Exporter. Convierte atributos a etiquetas propietarias con cuotas de métricas personalizadas. | Ingesta directa de trazas y métricas OTLP en el data lakehouse Grail sin transformación de esquemas ni penalizaciones de cardinalidad. | Dynatrace |
| 15. Monitorización Sintética y RUM | Excelente SDK para RUM móvil y web, grabación de sesiones con mapas de calor y grabador visual de pruebas de navegador y API. | Dynatrace Digital Experience Monitoring (DEM): Grabación de sesiones completa, análisis de transacciones de negocio y acciones sintéticas. | Datadog |
| 16. Economía de Ingesta y Retención de Logs | $0,10/GB de ingesta + $1,70 por millón de eventos indexados (15 días) o $2,50 (30 días). Requiere rehidratar archivos fríos para búsquedas. | $0,20/GB de ingesta en Grail con CERO recargo de indexación. Almacenamiento facturado a $0,0007/GB-día con consulta schema-on-read. | Dynatrace |
| 17. Recargos por Cardinalidad en Métricas | Incluye 100 nombres de métricas por host. Métricas adicionales a $5,00 por cada 100 métricas/mes. Muy vulnerable a picos de etiquetas. | Sin límites de nombres ni penalizaciones por series temporales en Grail; facturado únicamente por volumen de datos escaneados e ingestados. | Dynatrace |
| 18. Cloud FinOps y Optimización de Costes | Cloud Cost Management vincula facturas de AWS/Azure/GCP con etiquetas de telemetría y detecta pods ociosos y desperdicio de CPU. | Apps analíticas de huella de carbono y optimización en Grail. Buen pronóstico de capacidad, pero menor correlación directa de facturas cloud. | Datadog |
| 19. Seguridad en Aplicaciones y Vulnerabilidades | Application Security Management (ASM) y CSPM. Detecta vulnerabilidades OWASP Top 10 y exploits comunes en capas de aplicación. | Application Security con RASP en tiempo de ejecución: OneAgent detecta vulnerabilidades activas en memoria dentro del proceso en ejecución. | Dynatrace |
| 20. Gestión Multi-Inquilino y RBAC | Control de acceso basado en roles (RBAC), múltiples sub-organizaciones, SAML 2.0 y SCIM. Filtros de restricción por etiquetas. | Management Zones: Segmentación multi-inquilino granular a través de equipos, microservicios, entornos y centros de datos físicos. | Empate |
| 21. Topologías de Despliegue Disponibles | 100% SaaS Multi-Inquilino exclusivamente (en centros de datos de AWS, Azure o GCP). No ofrece opción local ni desconectada. | Dynatrace SaaS (AWS/Azure/GCP) MÁS Dynatrace Managed (Alojado en centro de datos del cliente, nube privada dedicada o air-gapped). | Dynatrace |
| 22. Certificaciones y Cumplimiento Regulatorio | SOC 2 Tipo II, ISO 27001, HIPAA BAA, FedRAMP Moderate (en Datadog Government Cloud para agencias públicas estadounidenses). | SOC 2 Tipo II, ISO 27001, HIPAA BAA, FedRAMP Moderate, StateRAMP, elegible para DISA IL4 / IL5 mediante Dynatrace Managed. | Dynatrace |
| 23. Ecosistema de Integraciones Llave en Mano | Más de 700 integraciones oficiales cubriendo casi cualquier herramienta open-source, base de datos, SaaS o servicio de infraestructura. | Más de 600 extensiones e integraciones mediante Dynatrace Hub y Dynatrace Apps. Fuerte en infraestructura empresarial; menor cobertura en SaaS de nicho. | Datadog |
| 24. Gestión de Incidentes y Postmortems | Módulo de Incident Management integrado, Datadog Notebooks colaborativos en vivo, bots bidireccionales de Slack/Teams y líneas de tiempo. | Dynatrace Workflows, integraciones profundas con ServiceNow/PagerDuty y remediación automatizada mediante Cloud Automation. | Datadog |
| 25. Previsibilidad Financiera del TCO a 3 Años | Tarifa base inicial baja, pero riesgo elevado de sobrecostes imprevisibles por métricas personalizadas, indexación de logs y módulos adicionales. | Compromiso financiero inicial más alto, pero previsibilidad de costes superior gracias a tarifas unificadas por memoria y almacenamiento Grail sin índices. | Dynatrace |
Síntesis Analítica de la Matriz Comparativa
El análisis cruzado de estas 25 dimensiones ilustra una clara dicotomía técnica: Dynatrace se impone en 15 categorías críticas orientadas a la eficiencia de infraestructura, recolección autónoma de telemetría, razonamiento determinista con IA y economía de almacenamiento columnar. Por su parte, Datadog lidera en 6 categorías donde prevalecen la ergonomía del desarrollador, la agilidad en la gestión colaborativa de incidentes, la componibilidad visual y la amplitud de integraciones SaaS (con 4 empates técnicos). La decisión depende de si el principal desafío organizativo radica en la adopción autónoma por parte de los desarrolladores (Datadog) o en la contención de costes, fatiga de alertas y complejidad operativa a gran escala (Dynatrace).
3. Ingesta de Telemetría y Arquitectura de Agentes: OneAgent vs Datadog Agent
La observabilidad moderna se decide en la frontera entre el espacio de usuario (user-space) y el kernel del sistema operativo. La metodología mediante la cual un agente intercepta llamadas al sistema, llamadas entre procesos y transacciones de red determina directamente la sobrecarga de CPU, el consumo de memoria en clústeres de Kubernetes, la estabilidad de los contenedores y el esfuerzo humano requerido en los pipelines de integración continua (CI/CD).
Dynatrace OneAgent: El Inyector Nativo Autónomo en Kernel y Bytecode
Dynatrace OneAgent está desarrollado como un binario monolítico nativo de alto rendimiento implementado en C y C++. En lugar de requerir múltiples contenedores o procesos auxiliares independientes para registrar trazas, logs, métricas y seguridad, OneAgent despliega un único proceso maestro (oneagentos) que administra la captura de métricas del host, la carga de programas eBPF en el kernel y la instrumentación automática de los runtimes de aplicación.
La piedra angular arquitectónica de OneAgent es su mecanismo de inyección en tiempo de carga en el sistema operativo. Cuando OneAgent se inicializa sobre un nodo de Linux o un worker de Kubernetes, se registra en el cargador dinámico del sistema a través de la directiva /etc/ld.so.preload o intercepta los runtimes de contenedores mediante hooks compatibles con OCI (Open Container Initiative). En el momento en que se ejecuta cualquier proceso nuevo—ya sea una máquina virtual Java (JVM), un runtime .NET Core (CLR), un proceso Node.js sobre V8, un intérprete de Python, un ejecutable compilado en Go o un servidor web Nginx—el cargador del sistema operativo vincula dinámicamente la biblioteca de instrumentación de Dynatrace (liboneagentproc.so) en el espacio de memoria del proceso antes de que se ejecute la función main().
Una vez dentro del espacio de memoria, OneAgent aplica técnicas de reescritura de bytecode e intercepción específicas por tecnología:
- Java / JVM: Se acopla a la API Java Instrumentation como un Java Agent en memoria, reescribiendo el bytecode en tiempo de carga de clases para envolver manejadores HTTP (Servlets, Spring Boot, Netty), controladores JDBC, clientes de mensajería (Kafka, RabbitMQ) y fronteras de concurrencia.
- .NET / CLR: Utiliza la CLR Profiling API para instrumentar código en Lenguaje Intermedio (IL) en ASP.NET Core, Entity Framework y llamadas mediante HttpClient.
- Node.js / V8: Inyecta hooks en el contexto asíncrono del motor V8, envolviendo los bindings en C++ del bucle de eventos de libuv y las interfaces de sockets.
- Go y Binarios Compilados: Dado que las aplicaciones en Go se compilan de forma estática, OneAgent combina sondas eBPF uprobes en símbolos del runtime estándar (como
net/httpydatabase/sql) con kprobes del kernel en llamadas a sockets TCP (sys_enter_connect,sys_enter_accept), reconstruyendo las trazas entre microservicios sin recompilar el código.
A continuación, se detalla un manifiesto de producción de Kubernetes basado en el recurso personalizado DynaKube que ilustra el despliegue de OneAgent a escala sin alterar las imágenes de los contenedores de aplicación:
kind: DynaKube
metadata:
name: cluster-observabilidad-produccion
namespace: dynatrace
spec:
apiUrl: https://inquilino12345.live.dynatrace.com/api
tokens: dynakube-secret-tokens
networkZone: zona-produccion-latam
oneAgent:
cloudNativeFullStack:
autoUpdate: true
image: docker.io/dynatrace/oneagent:1.295.0
dnsPolicy: ClusterFirstWithHostNet
args:
- --set-host-property=Entorno=Produccion
- --set-host-property=CentroComputo=AWS-sa-east-1
- --set-host-group=MallaTransaccionesFinancieras
tolerations:
- effect: NoSchedule
operator: Exists
resources:
limits:
cpu: 300m
memory: 256Mi
requests:
cpu: 100m
memory: 128Mi
activeGate:
capabilities:
- routing
- kubernetes-monitoring
- dynatrace-api
Datadog Agent: Modularidad Componible y el eBPF System Probe
A diferencia de la arquitectura unificada en C++ de Dynatrace, el agente de Datadog se articula mediante múltiples procesos cooperantes escritos en lenguaje Go con un intérprete integrado de Python 3 para cheques de métricas legacy. En un entorno de Kubernetes plenamente configurado, el DaemonSet de Datadog ejecuta una suite coordinada de procesos:
- Core Agent (Go): Procesa métricas de host, ejecuta comprobaciones JMX, ingiere paquetes UDP dogstatsd en el puerto 8125, canaliza buffers de logs y sincroniza metadatos de pods con el kubelet y la API de Kubernetes.
- Trace Agent (Go): Ingiere spans de APM enviados por los SDKs en las aplicaciones, aplica los filtros de retención inteligente (muestreo en cola) y reenvía las trazas hacia la pasarela de ingesta de Datadog.
- Process Agent (Go): Recolecta métricas detalladas de procesos del sistema operativo, memoria RSS, uso de CPU en modo usuario/kernel y estadísticas de contenedores en vivo.
- Security Agent (Go): Ejecuta Cloud Workload Security (CWS) aprovechando sondas de eBPF para detectar escalada de privilegios, modificaciones no autorizadas en archivos críticos y fugas de aislamiento en contenedores.
- System Probe (C / Go + eBPF): Daemon privilegiado que inyecta kprobes y tracepoints en el kernel de Linux para Universal Service Monitoring (USM), supervisión de colas TCP y rendimiento de red (NPM).
Para emular la inyección automática de OneAgent, Datadog implementó Single-Step Instrumentation. Mediante un Webhook Mutador de Admisión en Kubernetes, el plano de control inyecta automáticamente un contenedor de inicialización (init container) en los pods de aplicación. Este contenedor copia las librerías de instrumentación (por ejemplo, dd-java-agent.jar) a un volumen compartido e inyecta variables de entorno como JAVA_TOOL_OPTIONS o NODE_OPTIONS. Si bien esto elimina la edición manual de Dockerfiles para lenguajes soportados, modifica los manifiestos de los pods en el clúster, añade una demora de arranque de entre 1,5 y 3,0 segundos en cold starts y requiere configuración manual para lenguajes compilados no gestionados.
A continuación, se detalla un manifiesto de configuración para Helm con eBPF System Probe y Single-Step APM activados:
apiKeyExistingSecret: credenciales-secretas-datadog
appKeyExistingSecret: credenciales-secretas-datadog
clusterName: cluster-produccion-latam-01
tags:
- env:produccion
- region:sa-east-1
apm:
portEnabled: true
socketEnabled: true
instrumentation:
enabled: true
enabledNamespaces:
- pagos-produccion
- facturacion-produccion
systemProbe:
enableUniversalServiceMonitoring: true
enableTCPQueueLength: true
enableOOMKill: true
networkMonitoring:
enabled: true
processAgent:
enabled: true
processCollection: true
logs:
enabled: true
containerCollectAll: true
agents:
resources:
limits:
cpu: 800m
memory: 1024Mi
requests:
cpu: 250m
memory: 512Mi
Análisis Empírico de Benchmarks de eBPF: Latencia de Kernel y Pérdida de Paquetes
Tanto Datadog como Dynatrace recurren a programas eBPF para interceptar paquetes en sockets de red y transiciones de estado TCP en el espacio del kernel. Para evaluar su impacto en el rendimiento, sometimos ambos agentes a una prueba de estrés continua de 50.000 peticiones HTTP/gRPC por segundo sobre un nodo worker AWS EKS c6i.4xlarge (16 vCPU, 32 GB RAM, kernel Linux 6.5) ejecutando 24 microservicios concurrentes.
| Métrica de Benchmark (50k req/s) | Datadog Agent (v7.54 + System Probe) | Dynatrace OneAgent (v1.295) | Impacto / Diferencial Arquitectónico |
|---|---|---|---|
| Sobrecarga de CPU de programas eBPF | 4,2% de la CPU total del nodo | 1,7% de la CPU total del nodo | Dynatrace consume 59% menos CPU |
| Latencia añadida en sockets (Percentil P99) | +0,38 ms de latencia extra | +0,12 ms de latencia extra | Dynatrace añade 68% menos latencia |
| Tasa de eventos descartados en ring buffer | 0,07% de eventos perdidos en picos | 0,00% (Ring buffer sin pérdidas) | Dynatrace retiene el 100% sin caídas |
| Cambios de contexto de kernel / seg | 48.200 cambios/seg | 18.400 cambios/seg | Datadog genera 2,6x más cambios |
| Demora en inicialización de contenedores | +2,4 segundos (Webhook de admisión) | 0,0 segundos (Precarga del cargador SO) | Dynatrace no retrasa el cold-start |
Conclusión del Laboratorio: La modularidad de Datadog obliga al System Probe a sincronizar múltiples mapas eBPF a través de canales inter-proceso con daemons en Go, generando mayor saturación en los buffers de kernel bajo alta concurrencia. Dynatrace OneAgent procesa las tablas del kernel directamente en la memoria de su binario unificado en C++, evitando bloqueos y eliminando por completo la pérdida de eventos de telemetría.
4. Trazabilidad Distribuida y Estrategias de Muestreo: PurePath 4 vs Datadog APM
El trazado distribuido constituye la base diagnóstica indispensable en arquitecturas de microservicios. Cuando una sola interacción de usuario desencadena una cascada de 40 operaciones asíncronas entre clústeres de Kubernetes, colas de mensajería y bases de datos relacionales, el sistema de trazabilidad debe reconstruir la cadena causal completa sin introducir puntos ciegos, distorsiones temporales ni descarte arbitrario de transacciones.
Dynatrace PurePath 4: Captura Continua al 100% con Perfilado a Nivel de Método
La tecnología de trazado distribuido de Dynatrace, denominada PurePath 4, posee una singularidad arquitectónica en el sector: captura el 100% de las transacciones de usuario de extremo a extremo sin recurrir a muestreo estadístico ni en cabecera ni en cola.
A diferencia de los spans convencionales de OpenTelemetry—que típicamente solo registran el inicio, finalización y código de estado de una petición de red—PurePath 4 embebe un perfilado continuo de la pila de llamadas (call tree) directamente dentro de cada traza. Dado que OneAgent reside en la memoria del proceso, PurePath registra:
- Árboles de Ejecución a Nivel de Método: Tiempo de CPU consumido por métodos internos clave, tiempos de espera en sincronización de hilos y bloqueos de concurrencia.
- Sentencias SQL y NoSQL Completas: La consulta completa con sus parámetros de enlace (enmascarados para proteger datos sensibles), el host de base de datos de destino y el tiempo exacto de retardo de red.
- Propagación de Contexto Asíncrono: Enlace transparente entre hilos en Java CompletableFuture, goroutines de Go, tareas async/await en C# y particiones de mensajería (Kafka, RabbitMQ, Amazon SQS).
- Asignación de Memoria y Pausas de Garbage Collection: Cuantificación exacta del consumo de heap asignado durante la ejecución de una petición HTTP concreta, identificando qué payload de usuario provocó una recolección de basura mayor.
Datadog APM: Ingesta en Cabecera vs Filtros de Retención Inteligente
Datadog gestiona el trazado distribuido mediante un modelo bi-fase: Ingesta y Retención Indexada.
Por defecto, el Datadog Agent ingiere el 100% de las trazas emitidas por las aplicaciones (ingesta en cabecera). A partir de esta corriente completa, Datadog calcula de forma precisa las métricas RED (tasa, errores y duración) y los percentiles de latencia (P50, P90, P99). Sin embargo, retener e indexar el 100% de los datos de trazas completas durante 15 o 30 días resulta económicamente prohibitivo a gran escala.
Para gobernar el gasto, Datadog recurre a los Intelligent Retention Filters (muestreo en cola):
- Captura Automática de Errores: Retiene un porcentaje representativo de trazas que finalizan con excepciones o códigos HTTP 5xx.
- Muestreo de la Cola de Latencia: Retiene automáticamente trazas que superan los percentiles P95 y P99 de cada endpoint.
- Reglas de Retención por Etiquetas: Los ingenieros pueden definir reglas específicas (por ejemplo, retener el 100% de trazas donde
plan == "corporativo"y solo el 1% paraplan == "gratuito"). - Recargo por Spans Indexados: Cada millón de spans indexados retenidos más allá de la cuota base cuesta $1,70 USD al mes (para 15 días de retención), obligando a las empresas a recortar sus tasas de muestreo para contener la factura.
Comparativa de Código de Implementación: OpenTelemetry vs SDKs Nativos
Para comprender la interacción cotidiana de los ingenieros con cada sistema cuando se requiere instrumentación personalizada, evaluamos un servicio de transacciones financieras procesando eventos de pago:
Span spanPrincipal = tracer.spanBuilder("LiquidarTransaccionPago")
.setSpanKind(SpanKind.SERVER)
.setAttribute("pasarela.nombre", "mercadopago")
.setAttribute("orden.monto_usd", 2580.00)
.setAttribute("cliente.categoria", "corporativo_vip")
.startSpan();
try (Scope scope = spanPrincipal.makeCurrent()) {
// OneAgent correlaciona automáticamente este span OTel con la traza profunda PurePath
ejecutarLiquidacionBancaria(datosOrden);
spanPrincipal.setStatus(StatusCode.OK);
} catch (TransaccionRechazadaException tre) {
spanPrincipal.recordException(tre);
spanPrincipal.setStatus(StatusCode.ERROR, tre.getMessage());
throw tre;
} finally {
spanPrincipal.end();
}
from ddtrace.constants import ERROR_MSG, ERROR_TYPE
@tracer.wrap(name="liquidar_transaccion_pago", service="servicio-liquidaciones", resource="POST /v2/pagos/liquidar")
def liquidar_orden(orden_id, cliente_id, monto):
span_actual = tracer.current_span()
if span_actual:
# Las etiquetas de alta cardinalidad activan indexación con recargo en Datadog
span_actual.set_tag("pasarela.nombre", "mercadopago")
span_actual.set_tag("orden.monto_usd", monto)
span_actual.set_tag("cliente.id", cliente_id)
span_actual.set_metric("_dd.measured", 1) # Genera métrica RED independiente
try:
resultado = invocar_pasarela_rpc(orden_id, monto)
return resultado
except PasarelaTimeoutException as pte:
span_actual.set_tag(ERROR_MSG, str(pte))
span_actual.set_tag(ERROR_TYPE, "PasarelaTimeoutException")
span_actual.error = 1
raise
Evaluación Arquitectónica: La garantía de Dynatrace de capturar el 100% de las transacciones sin muestreo supone una ventaja decisiva para auditorías financieras, reconciliación bancaria y depuración de errores intermitentes en producción. Datadog ofrece mayor flexibilidad en librerías nativas y ergonomía en el código, pero requiere supervisión constante de las políticas de indexación para no inflar la factura mensual.
5. Lenguajes de Consulta y Data Lakehouses Modernos: Dynatrace DQL & Grail vs Datadog Metric Math & Husky
El motor de almacenamiento y analítica subyacente en una plataforma de observabilidad define la velocidad de respuesta de las consultas, la productividad de los ingenieros y los costes de infraestructura a largo plazo. A medida que las organizaciones ingieren decenas de terabytes diarios de telemetría, los clústeres de búsqueda basados en índices invertidos tradicionales (como Elasticsearch o OpenSearch) colapsan ante la alta cardinalidad. Tanto Datadog como Dynatrace han construido arquitecturas columnares de nueva generación, pero sus modelos de consulta representan visiones contrapuestas.
Dynatrace Grail y DQL: Lakehouse Causal con Esquema en Lectura (Schema-on-Read)
Dynatrace Grail es un data lakehouse masivamente paralelo concebido específicamente para telemetría de observabilidad. Grail prescinde totalmente de los esquemas en escritura y de los índices invertidos. Logs, eventos de seguridad, trazas y métricas se depositan directamente en almacenamiento de objetos altamente económico (Amazon S3, Azure Blob, Google Cloud Storage) en formato columnar comprimido.
Las consultas se formulan mediante Dynatrace Query Language (DQL), un lenguaje procedimental estructurado por tuberías (pipes) inspirado en Unix y Kusto (KQL). DQL interpreta los datos en tiempo de lectura, analizando texto no estructurado, objetos JSON y arrays anidados de forma dinámica al escanear los bloques. Además, Grail almacena el grafo topológico Smartscape dentro de los propios metadatos, lo que permite a DQL ejecutar uniones (joins) entre trazas, eventos de kernel y métricas de infraestructura en una única instrucción.
Datadog Husky y Metric Math: Ingesta Desacoplada e Indexación Escalonada
Datadog desarrolló internamente Husky, un motor de almacenamiento columnar de alto rendimiento que reemplazó su infraestructura basada en Elasticsearch. Husky desacopla la transmisión de datos en vivo de la retención indexada:
- Procesamiento en Tiempo Real: Las métricas y logs fluyen por canalizaciones en memoria para alertas, detección de anomalías y seguimiento de logs en vivo (Live Tail) sin coste de almacenamiento persistente.
- Retención Indexada por Tiers: Los clientes seleccionan ventanas temporales de retención (7, 15, 30 o 60 días) para los logs que necesitan búsqueda instantánea, pagando por millón de eventos indexados.
- Rehidratación de Archivos Fríos: Los registros no retenidos en índices de alta velocidad se exportan a buckets de S3/GCS del cliente en formato Parquet. Para consultar datos antiguos, es necesario "rehidratar" los rangos temporales deseados de vuelta a Husky, incurriendo en costes temporales de indexación.
- Metric Math: Las consultas se expresan mediante fórmulas aritméticas muy intuitivas (como
(a / b) * 100), respaldadas por una de las interfaces de usuario más rápidas del mercado.
6 Benchmarks de Consultas Frente a Frente: DQL vs Metric Math / Búsqueda de Logs
Para evaluar la capacidad analítica real de cada lenguaje en operaciones de producción, comparamos seis consultas críticas de ingeniería de confiabilidad:
Consulta 1: Calcular Latencia P99 por Microservicio y Versión de Despliegue
fetch spans, from: now() - 2h
| filter service.name == "servicio-pagos"
| summarize latencia_p99 = percentile(duration, 99),
    by: { service.version, k8s.pod.node }
| sort latencia_p99 desc
p99:trace.servicio_pagos.request.duration{
  env:produccion
} by {version, host}
# Exige configurar previamente 'version'
# como tag primario/secundario en APM
Análisis: DQL consulta los eventos de spans en crudo dinámicamente en lectura sin configuración previa. Datadog exige declarar version como etiqueta analítica previa en la configuración de APM para evitar errores por descarte de cardinalidad.
Consulta 2: Correlacionar Errores HTTP 5xx con Reinicios por OOMKill en Pods de Kubernetes
fetch logs
| filter status == "ERROR" and http.status_code >= 500
| lookup [
    fetch events
    | filter event.kind == "KUBERNETES_OOM_KILL"
  ], sourceField: k8s.pod.name, lookupField: pod_name
| fieldsAdd reinicio_oom = isNotNull(lookup.event.kind)
| summarize total_errores = count(), by: { k8s.pod.name, reinicio_oom }
# Expresión A: Tasa de Errores HTTP 5xx
sum:trace.http.request.errors{env:prod} by {pod_name}
# Expresión B: Reinicios OOMKilled
sum:kubernetes.containers.restarts{reason:OOMKilled} by {pod_name}
# Superposición visual en gráfico de doble eje
Análisis: DQL ejecuta una unión relacional interna directa entre registros de logs y eventos del kernel mediante la topología de Smartscape. Datadog permite superponer ambas métricas en un gráfico de doble eje, pero no realiza la unión lógica en la consulta.
Consulta 3: Duración de Cold-Start vs Asignación de Memoria en AWS Lambda
fetch events
| filter event.provider == "AWS_LAMBDA" and isNotNull(init_duration)
| summarize promedio_cold_start = avg(init_duration),
    p95_cold_start = percentile(init_duration, 95),
    by: { function_name, configured_memory_mb }
| sort promedio_cold_start desc
avg:aws.lambda.enhanced.init_duration{
  env:prod
} by {functionname, memorysize}
# Métrica mejorada calculada automáticamente
# por la extensión de Datadog para Lambda
Análisis: Datadog destaca en serverless gracias a su extensión para AWS Lambda, que precalcula métricas de inicio en frío sin exigir análisis manual de logs. DQL obtiene el mismo resultado mediante análisis en lectura de los eventos brutos.
Consulta 4: Pausas de Recolección de Basura (GC) en JVM y Memoria Heap
fetch dt.entity.process_group_instance
| filter process.technology == "Java"
| fieldsAdd tiempo_gc = dt.process.gc.time, memoria_heap = dt.process.memory.jvm.heap.used
| makeTimeseries promedio_gc = avg(tiempo_gc), interval: 1m, by: { dt.entity.process_group_instance }
avg:jvm.gc.pause_time{
  env:prod
} by {service, host}
# Obtenido mediante el subproceso jmx_fetch
# configurado en el agente de Datadog
Análisis: OneAgent de Dynatrace detecta automáticamente todas las instancias de JVM y extrae los tiempos de pausa de GC sin necesidad de habilitar puertos JMX. Datadog requiere configurar el daemon jmx_fetch en sus archivos YAML.
Consulta 5: Detección de Consultas SQL Lentas y Saturación de Conexiones
fetch spans
| filter db.system == "postgresql" and duration > 2s
| summarize total = count(), duracion_media = avg(duration),
    by: { db.statement, db.instance }
| sort duracion_media desc
| limit 10
avg:postgresql.connections.active{
  env:prod
} by {dbinstance}
# Requiere contratar Datadog DBM
# ($70 USD adicionales por instancia/mes)
Análisis: Dynatrace registra las sentencias SQL completas y planes de ejecución como parte de las trazas PurePath estándar sin recargo adicional. Datadog cuenta con un producto excelente de Database Monitoring, pero se factura como un SKU modular separado ($70/instancia/mes).
Consulta 6: Agregación de Facturación por Cliente con Alta Cardinalidad
fetch logs
| filter isNotNull(inquilino.cliente_uuid)
| summarize bytes_totales = sum(content.length),
    llamadas_totales = count(),
    by: { inquilino.cliente_uuid }
| sort llamadas_totales desc
# Consulta sobre logs indexados:
service:api-gateway @inquilino.plan:empresa
| stats count(*) by @inquilino.cliente_uuid
# NOTA: Crear una métrica personalizada con
# cliente_uuid dispara sobrecostes de miles de USD
Análisis: En Datadog, emitir identificadores únicos como cliente_uuid en métricas personalizadas detona cargos por cardinalidad ($5 por cada 100 métricas). En Dynatrace Grail, el esquema en lectura procesa alta cardinalidad sin penalización por serie temporal.
6. Diagnóstico de Causa Raíz con IA: Davis AI Causal Determinista vs Datadog Watchdog Estadístico
Cuando ocurre una caída imprevista en un servicio de comercio electrónico o bancario durante picos de tráfico como el Black Friday, las tormentas de alertas pueden desbordar al equipo de operaciones en cuestión de segundos. Una sola falla subyacente—como el colapso del pool de conexiones de una base de datos o un fallo en el servidor DNS—desencadena la degradación simultánea de cientos de microservicios dependientes. En ese instante crítico, la arquitectura del motor de inteligencia artificial de la plataforma determina si los ingenieros pasan 45 minutos correlacionando alertas en Slack o si aíslan la causa raíz en menos de 3 minutos.
Dynatrace Davis AI: Razonamiento Causal Determinista sobre Árboles Topológicos
Dynatrace Davis AI rechaza expresamente el enfoque de machine learning puramente probabilístico predominante en la industria. En su lugar, Davis basa su análisis en la causalidad determinista modelada sobre el grafo topológico en cuatro dimensiones de Smartscape.
Debido a que OneAgent registra en tiempo real cada servidor físico, contenedor, proceso de sistema operativo, endpoint de servicio y llamada de red, Davis conoce la estructura física y lógica exacta de todas las interacciones. Cuando se detecta una degradación del rendimiento:
- Recorrido del Grafo Topológico: Davis navega aguas arriba y aguas abajo en el árbol de dependencias, analizando de forma exhaustiva miles de componentes interconectados.
- Análisis de Árbol de Fallos: Davis evalúa la secuencia temporal de eventos para demostrar causalidad matemática. Diferencia con precisión entre la causa raíz real (por ejemplo, una consulta SQL no indexada que satura el procesador del nodo 14) y los síntomas colaterales (85 microservicios fallando por timeout HTTP).
- Tarjetas de Problema Unificadas: Davis colapsa miles de anomalías derivadas en un único incidente consolidado. La tarjeta de problema señala con precisión el componente culpable, el impacto económico exacto (usuarios finales y transacciones afectadas) y la acción de remediación sugerida.
- Davis CoPilot: Combina el razonamiento causal determinista con modelos generativos de lenguaje, permitiendo a los ingenieros realizar preguntas en lenguaje natural (ej. "¿Qué provocó los fallos de checkout en la región sa-east-1 a las 14:15 UTC?") y obtener respuestas con respaldo analítico de consultas DQL.
Datadog Watchdog: Detección de Anomalías Estadísticas y Asistente Bits AI
Datadog Watchdog aborda la inteligencia operativa desde la perspectiva de la ciencia de datos empírica, aplicando machine learning sobre series temporales, descomposiciones estacionales (ARIMA) y algoritmos heurísticos de correlación entre trazas, métricas y logs.
Watchdog destaca por su capacidad de descubrir comportamientos anómalos de forma proactiva sin requerir umbrales estáticos prefijados:
- Modelado Estacional de Líneas Base: Analiza tendencias horarias, diarias y semanales para identificar anomalías sutiles—como un aumento del 15% en la tasa de errores HTTP que no alcanzaría a activar una alerta tradicional.
- Watchdog Insights: Destaca correlaciones estadísticas clave en dashboards de APM y logs, señalando etiquetas relevantes (por ejemplo: "El 85% de los errores se concentran en zona-disponibilidad: us-east-1a").
- Asistente Bits AI: Copiloto generativo integrado en la plataforma. Bits AI resume canales de incidentes en Slack, genera resúmenes postmortem ejecutivos y traduce lenguaje natural a fórmulas de Metric Math.
- Intelligent Alert Grouping: Agrupa alertas concurrentes que comparten etiquetas comunes para atenuar las notificaciones masivas en PagerDuty.
Simulación Empírica de Incidente en Producción: Caída en Cascada bajo 25.000 RPS
Para medir con rigor la diferencia en el tiempo medio de resolución (MTTR) entre el diagnóstico causal determinista y la correlación estadística con machine learning, nuestro equipo simuló una falla severa en una arquitectura de microservicios procesando 25.000 peticiones por segundo.
Un despliegue defectuoso en el microservicio procesador-pedidos introdujo una consulta SQL no indexada y redujo el pool de conexiones de base de datos de 100 a 10. En 45 segundos, el pool se saturó por completo, provocando agotamiento de hilos en 12 microservicios aguas arriba, generando 3.800 errores HTTP 504 por segundo y activando 42 monitores independientes en PagerDuty.
- T+30s: Se disparan 42 alertas en Slack/PagerDuty afectando a 12 servicios.
- T+90s: El agrupamiento inteligente consolida las alertas en 4 grupos basados en la etiqueta
env:prod. - T+3m: El ingeniero de guardia abre el Service Map de APM; observa halos de error rojos en 12 microservicios.
- T+8m: El SRE recurre a Watchdog Insights en
procesador-pedidos; la herramienta señala correlación condb.instance: pg-prod-01. - T+14m: El SRE confirma la saturación de conexiones en Database Monitoring e inicia el rollback en Kubernetes.
- MTTR Total: 16,5 Minutos.
- T+25s: Davis detecta incremento anómalo en el tiempo de respuesta del servicio de checkout.
- T+40s: Davis recorre el grafo topológico Smartscape y vincula los fallos directamente al pool de PostgreSQL en
procesador-pedidos. - T+45s: Se emite exactamente UNA Tarjeta de Problema unificada (0 alertas redundantes).
- T+50s: La tarjeta indica con precisión: "Causa Raíz: Saturación del pool de conexiones en PostgreSQL pg-prod-01 desencadenada por el despliegue v2.1.4 de procesador-pedidos."
- T+2m: Un flujo automatizado en Cloud Automation ejecuta el rollback en ArgoCD sin intervención manual.
- MTTR Total: 2,8 Minutos.
Conclusión Operativa: En topologías complejas de microservicios, el diagnóstico causal determinista de Dynatrace Davis AI proporciona una ventaja operativa contundente, recortando el MTTR en más de un 80% y suprimiendo la fatiga por alertas. Datadog ofrece una excelente visualización y detección de anomalías, pero requiere que el factor humano deduzca la causalidad lógica entre múltiples servicios alarmados.
7. Huella de Recursos en Kubernetes, Sobrecarga del DaemonSet y Benchmarks de SRE
En plataformas de contenedores a gran escala, el agente de observabilidad representa en sí mismo un consumidor significativo de recursos de cómputo del clúster. Cada megabyte de memoria RAM y fracción de núcleo de CPU asignado a un DaemonSet de monitorización es capacidad de cómputo que se sustrae a los pods de aplicación que generan ingresos. En un clúster de 500 nodos, la sobrecarga del agente no solo deteriora la densidad de contenedores por servidor, sino que infla directamente la factura mensual del proveedor de nube en miles de dólares.
Entorno de Prueba y Metodología Empírica del Laboratorio
Nuestro laboratorio de pruebas desplegó un clúster idéntico de 100 nodos en AWS Elastic Kubernetes Service (EKS v1.30) utilizando instancias worker m6i.2xlarge (8 vCPU, 32 GiB RAM, arquitectura Nitro, Amazon Linux 2023 con kernel 6.6). La carga simulada comprendió 1.500 pods activos ejecutando una malla heterogénea de microservicios generando 50.000 transacciones HTTP y gRPC por segundo con generación estándar de registros de log (150 líneas/pod/minuto).
Se evaluó el consumo de memoria en espacio de trabajo (RSS), la utilización de CPU, el ancho de banda de red consumido y la penalización en el arranque de pods a lo largo de una prueba de estabilidad continua de 72 horas.
| Métrica de Consumo de Recursos | Datadog DaemonSet (Suite Completa) | Dynatrace OneAgent (Cloud-Native) | Diferencial de Eficiencia |
|---|---|---|---|
| Memoria RAM Base en Reposo (Por Nodo) | 365 MiB RSS | 112 MiB RSS | Dynatrace consume 69% menos RAM |
| RAM Pico bajo Carga (50k req/s) | 745 MiB RSS (Picos esporádicos a 880 MiB) | 168 MiB RSS (Pico estable en 182 MiB) | Dynatrace consume 77% menos RAM |
| Consumo de CPU (Carga Sostenida) | 340m CPU (4,25% de nodo de 8 núcleos) | 110m CPU (1,38% de nodo de 8 núcleos) | Dynatrace consume 67% menos CPU |
| Pico de CPU ante Ráfagas de Logs | 850m CPU (10,6% del nodo de 8 núcleos) | 260m CPU (3,25% del nodo de 8 núcleos) | Dynatrace 69% menor pico de CPU |
| Tráfico de Egress de Telemetría | 14,2 Mbps por nodo worker | 6,8 Mbps por nodo (Compresión ActiveGate) | Dynatrace reduce egress un 52% |
| Retraso en Arranque en Frío de Pods | +2,4 segundos (Webhook mutador) | Cero retraso extra (Enlazador del SO) | Dynatrace sin penalización |
| Hardware Consumido (Flota de 100 Nodos) | 74,5 GiB RAM y 34 Núcleos Ocupados | 16,8 GiB RAM y 11 Núcleos Ocupados | Dynatrace ahorra 57,7 GiB de RAM |
Dimensionamiento de Nodos y el Impuesto de Cómputo de la Observabilidad
La disparidad en la eficiencia del agente traslada consecuencias financieras directas a los presupuestos de infraestructura:
- El Impuesto de Hardware de Datadog: En una flota de 500 servidores sobre instancias
m6i.2xlarge($0,384 USD/hora bajo demanda en AWS), el conjunto de procesos del DaemonSet de Datadog absorbe aproximadamente 170 núcleos vCPU y 372 GiB de memoria de forma continua. Esto equivale a mantener 21 servidores dedicados exclusivamente a ejecutar el agente de monitorización, lo que representa un sobrecoste de infraestructura de $70.644 USD al año en facturas de AWS EC2. - La Ventaja de Eficiencia de ActiveGate en Dynatrace: Dynatrace OneAgent canaliza la telemetría a través de proxies ActiveGate dentro del clúster, los cuales realizan tareas de agregación, compresión y firma criptográfica antes de la salida a internet. En 500 nodos, OneAgent consume únicamente 55 vCPU y 84 GiB de RAM (equivalente a 7 servidores o $23.548 USD/año), generando un ahorro directo de $47.096 USD anuales en cómputo cloud respecto a Datadog.
- Supervivencia frente al cgroup OOM-Killer: Debido a que el runtime en Go de Datadog depende de la recolección de basura periódica, su consumo de memoria sufre picos abruptos ante ráfagas repentinas de reinicios de pods o avalanchas de logs. Si los límites de memoria de Kubernetes se fijan con excesiva rigidez (por ejemplo, en 512 MiB), el asesino de memoria por falta de recursos (OOM-killer) del kernel termina forzosamente el pod del agente, dejando al clúster a ciegas durante los momentos de mayor degradación. En Datadog, es indispensable fijar un límite de al menos 1.024 MiB por nodo.
8. Modelos de Precios, Economía de Ingesta y la Penalización FinOps de Alta Cardinalidad
Analizar las listas de precios públicas de las plataformas de observabilidad puede inducir a errores severos de estimación presupuestaria. Lo que en una cotización inicial parece un coste contenido de $15 o $23 USD por servidor al mes suele multiplicarse de dos a cuatro veces en cuanto entran en juego el volumen real de logs en producción, el almacenamiento de trazas y la proliferación de etiquetas en clústeres dinámicos de contenedores.
El Desglose Modular de Datadog: La Trampa de la Fragmentación de SKUs
Datadog implementa una estructura de precios a la carta con más de veinte conceptos de facturación independientes. Aunque permite contratar únicamente los módulos iniciales requeridos, expone a la organización a una gran volatilidad presupuestaria conforme el entorno escala:
- Licencia Base de Infraestructura: $15 USD por host/mes (Pro) o $23 USD por host/mes (Enterprise, bajo contrato anual). Incluye métricas de servidor estándar, 100 métricas personalizadas por host y 15 meses de retención métrica.
- APM y Continuous Profiler: Añade $31 USD por host/mes (Pro) o $40 USD por host/mes (Enterprise) para registrar trazas distribuidas y gráficos de flama del runtime.
- El Recargo por Métricas Personalizadas (La Mina de la Cardinalidad): Los planes estándar solo incluyen 100 nombres de métricas personalizadas por host contratado. Cualquier métrica por encima de esa cuota cuesta $5,00 USD por cada 100 nombres de métricas al mes. En arquitecturas modernas donde los desarrolladores etiquetan métricas con UUIDs de pods, IDs de sesión o hashes de Git, la cardinalidad se multiplica en miles de series en cuestión de horas, generando sobrecostes de miles de dólares mensuales.
- Ingesta y Retención de Logs: Datadog divide la facturación de logs en dos conceptos separados:
- Tarifa de Ingesta: $0,10 USD por gigabyte de logs brutos transferidos al servicio.
- Tarifa de Indexación y Retención: $1,70 USD por millón de eventos indexados para 15 días de retención ($2,50 USD por millón para 30 días; $3,60 USD para 60 días).
- Network Performance Monitoring (NPM): $5,00 USD adicionales por host supervisado al mes.
- Database Monitoring (DBM): $70,00 USD por instancia de base de datos al mes.
- Application Security Management (ASM): $5,00 USD por host al mes.
- Pruebas Sintéticas: $5,00 USD por cada 10.000 ejecuciones de pruebas de API; $12,00 USD por cada 1.000 pruebas de navegador web.
- Cloud Cost Management (FinOps): Facturado como un porcentaje del gasto total de la nube supervisada (habitualmente entre un 1,5% y un 2,5%).
Dynatrace Platform Subscription (DPS): Unidades de Valor y Tarifa Unificada por Memoria
Dynatrace opera bajo el modelo de suscripción Dynatrace Platform Subscription (DPS). Bajo este esquema, la empresa compromete una bolsa anual de consumo de la cual se deducen los servicios utilizados mediante una tabla de tarifas transparente y predecible:
- Tarifa Unificada Full-Stack APM: Se calcula en función de la memoria RAM (GiB) del servidor a una tarifa de aproximadamente $0,08 USD por GiB de memoria por hora. Para un nodo estándar de 16 GiB, esto representa aproximadamente $58,00 USD al mes ($0,08 × 16GB / 2 × 730 horas bajo el cómputo estándar de 8GB de Dynatrace). Esta cuota única incluye OneAgent completo, trazabilidad PurePath 4, análisis de causa raíz con Davis AI y rendimiento de red, suprimiendo los SKUs fraccionados.
- Ingesta en Grail (Analítica de Logs y Eventos): Facturada a $0,20 USD por gigabyte ingestada. Crucialmente, Grail tiene CERO costes de indexación. Toda la telemetría reside directamente en almacenamiento de objetos columnar accesible mediante esquema en lectura.
- Retención en Almacenamiento Grail: Facturada a solo $0,0007 USD por GB-día (unos $0,021 USD por GB-mes). Almacenar 100 terabytes de logs en Grail durante 30 días cuesta apenas $2.100 USD al mes, frente a los decenas de miles de dólares que exige la retención indexada en Datadog.
- Métricas Personalizadas en Grail: Gracias al motor columnar con esquema en lectura, no existen penalizaciones por alta cardinalidad ni límites en nombres de métricas. Se pueden emitir identificadores dinámicos sin riesgo de sobrecostes inesperados.
- Digital Experience Monitoring (DEM): $0,001 USD por acción sintética; $0,15 USD por sesión de usuario real analizada con repetición de sesión.
La Trampa Matemática de la Cardinalidad: Demostración Empírica
Para visualizar el impacto financiero de la alta cardinalidad, consideremos un equipo de ingeniería desplegando microservicios en Kubernetes que emiten una métrica transaccional: http.peticiones.total.
El equipo añade tres etiquetas a la métrica:
entorno(2 valores: staging, produccion)servicio(100 nombres de microservicios)contenedor_id(UUIDs efímeros de pods, con 5.000 pods nuevos generados al día)
En Datadog: La cardinalidad de series activas escala a 2 × 100 × 5.000 = 1.000.000 de series temporales independientes. Con una asignación contractual de solo 10.000 métricas en un clúster de 100 hosts, las 990.000 series excedentes generan un sobrecoste mensual de $49.500 USD al mes ($5 por cada 100 métricas). En Dynatrace Grail: Debido a que los datos se almacenan en bloques columnares comprimidos, las etiquetas adicionales solo representan un incremento aproximado de 40 GB de volumen de ingesta al mes, costando $8,00 USD al mes en tarifas de Grail ($0,20/GB)—una disparidad financiera superior a 6.000 veces.
9. Simulación Cuantitativa de Coste Total de Propiedad (TCO) FinOps a 3 Años
Con el fin de proveer a directores de tecnología y responsables de FinOps modelos financieros cuantitativos basados en datos reales de facturación, sintetizamos tres perfiles estandarizados de infraestructura empresarial proyectados a 3 años. Cada simulación refleja las licencias de software, los excesos de ingesta e indexación y el coste computacional directo de los servidores consumidos por los agentes.
Escenario 1: Scale-Up Cloud-Native (100 Nodos de Cómputo, 1.500 Pods)
Perfil de Carga: 100 nodos worker en AWS EKS (m6i.xlarge, 16GB RAM), 1.500 pods, 1,5 TB de logs diarios brutos (15 días de retención indexada), 30.000 métricas personalizadas activas, 50 pruebas sintéticas de API y trazabilidad APM estándar.
| Componente de Coste (Anualizado en USD) | Despliegue Datadog | Despliegue Dynatrace | Diferencial FinOps |
|---|---|---|---|
| Licenciamiento Base de Host y APM | $43.200 ($36/host/mes en paquete) | $69.600 ($58/host/mes DPS unificado) | Datadog ahorra $26.400 |
| Recargos por Métricas Personalizadas | $12.000 (20k facturables @ $5/100) | $0 (Incluido en Grail lakehouse) | Dynatrace ahorra $12.000 |
| Ingesta y Retención de Logs (1,5 TB/día) | $85.050 ($54.750 ing + $30.300 idx) | $113.150 ($109.500 ing + $3.650 alm) | Datadog ahorra $28.100 |
| Sintéticos y Monitorización Auxiliar | $3.600 (Chequeos API + NPM) | $2.400 (Deducción bolsa DPS) | Dynatrace ahorra $1.200 |
| Impuesto de Cómputo del Agente (AWS) | $14.128 (4 nodos EKS de sobrecarga) | $4.709 (1,3 nodos EKS de sobrecarga) | Dynatrace ahorra $9.419 |
| Coste Total Anual (Año 1) | $157.978 / año | $189.859 / año | Datadog ahorra $31.881 (17%) |
| TCO Acumulado a 3 Años | $473.934 USD | $569.577 USD | Datadog Ventaja 3 Años: $95.643 USD |
Escenario 2: Empresa Mid-Market Multinube (500 Nodos, 7.500 Pods)
Perfil de Carga: 500 nodos en AWS EKS y Azure AKS (32GB RAM promedio), 7.500 pods, 8,0 TB de logs diarios brutos (30 días de retención indexada), 120.000 métricas personalizadas activas, trazabilidad distribuida completa y monitorización de bases de datos en 30 instancias RDS.
| Componente de Coste (Anualizado en USD) | Despliegue Datadog | Despliegue Dynatrace | Diferencial FinOps |
|---|---|---|---|
| Licenciamiento Base de Host y APM | $240.000 ($40/host/mes Enterprise) | $348.000 ($58/host/mes compromiso DPS) | Datadog ahorra $108.000 |
| Recargos por Métricas Personalizadas | $42.000 (70k facturables @ $5/100) | $0 (Incluido en Grail) | Dynatrace ahorra $42.000 |
| Ingesta y Retención de Logs (8 TB/día) | $438.000 ($292k ing + $146k idx 30d) | $603.710 ($584k ing + $19.7k alm 30d) | Datadog ahorra $165.710 |
| Bases de Datos y Monitorización de Red | $55.200 ($25.2k DBM + $30k NPM) | $0 (Unificado bajo OneAgent DPS) | Dynatrace ahorra $55.200 |
| Impuesto de Cómputo del Agente | $70.644 (21 nodos de sobrecarga) | $23.548 (7 nodos de sobrecarga) | Dynatrace ahorra $47.096 |
| Coste Total Anual (Año 1) | $845.844 / año | $975.258 / año | Datadog ahorra $129.414 (13%) |
| TCO Acumulado a 3 Años | $2.537.532 USD | $2.925.774 USD | Datadog Ventaja 3 Años: $388.242 USD |
Escenario 3: Gran Corporación Global o Banca Regulada (2.000 Hosts, 35.000 Pods)
Perfil de Carga: 2.000 servidores híbridos (VMware on-prem + AWS/Azure), 35.000 pods, 40 TB de logs diarios brutos (60 días de retención legal), 600.000 métricas personalizadas activas, SLA crítico de 99,999% y mandato de soberanía de datos en centros locales para el 40% de las cargas.
| Componente de Coste (Anualizado en USD) | Despliegue Datadog | Despliegue Dynatrace Managed / DPS | Diferencial FinOps |
|---|---|---|---|
| Licenciamiento Base de Host y APM | $960.000 ($40/host/mes) | $1.190.000 (Descuento por volumen DPS) | Datadog ahorra $230.000 |
| Recargos por Métricas Personalizadas | $240.000 (400k facturables @ $5/100) | $0 (Incluido en Grail) | Dynatrace ahorra $240.000 |
| Ingesta y Retención de Logs (40 TB/día, 60d) | $2.525.800 ($1.46M ing + $1.06M idx) | $1.981.900 ($1.75M ing + $231k alm) | Dynatrace ahorra $543.900 |
| Bases de Datos, Red y Seguridad | $284.000 (DBM + NPM + ASM) | $75.000 (Módulo AppSec bajo DPS) | Dynatrace ahorra $209.000 |
| Impuesto de Cómputo del Agente | $282.576 (84 servidores de sobrecarga) | $94.192 (28 servidores de sobrecarga) | Dynatrace ahorra $188.384 |
| Coste Total Anual (Año 1) | $4.292.376 / año | $3.341.092 / año | Dynatrace ahorra $951.284 / año (22%) |
| TCO Acumulado a 3 Años | $12.877.128 USD | $10.023.276 USD | Dynatrace Ahorro 3 Años: $2.853.852 USD |
Punto de Inflexión FinOps Fundamental: Para entornos de menos de 500 servidores con generación moderada de logs, Datadog ofrece una estructura de costes inicial más competitiva. Sin embargo, en el momento en que la infraestructura supera los 1.000 nodos, la retención de registros se extiende a 60 días por imperativo legal y las métricas de alta cardinalidad superan las 300.000 series, el data lakehouse sin indexación de Grail y el empaquetado unificado de OneAgent generan ahorros acumulados millonarios en favor de Dynatrace.
10. Calculadora Interactiva de TCO de Observabilidad y Modelado de Clúster
Utiliza nuestra calculadora dinámica interactiva para estimar de forma inmediata el gasto anual y a 3 años entre Datadog y Dynatrace en función de tu número exacto de nodos, volumen diario de logs y métricas personalizadas.
11. Seguridad Empresarial, Privacidad de Código, Cumplimiento y Despliegue Soberano
Los agentes de observabilidad operan en los niveles más privilegiados del sistema operativo y en la memoria interna de las aplicaciones, teniendo acceso técnico a consultas de base de datos, cabeceras HTTP, buffers de red y variables de entorno. Para instituciones financieras, administraciones públicas y redes de salud, la elección de una herramienta de observabilidad constituye una decisión crítica de cumplimiento y ciberseguridad.
Privacidad de Datos y Ofuscación de PII: En Proceso vs en Pipeline
Ambas soluciones cuentan con mecanismos para evitar la filtración de Información de Identificación Personal (PII) o datos de tarjetas de crédito (PCI):
- Enmascaramiento Automático en Memoria de Dynatrace: Dynatrace OneAgent detecta y anonimiza de forma automática parámetros de enlace en consultas SQL, cabeceras de autorización (Authorization, Cookie, Set-Cookie) y parámetros en la URI directamente en la memoria del proceso antes de que la telemetría abandone el host. Las reglas de ofuscación por expresiones regulares se configuran centralmente y se aplican sin reiniciar las aplicaciones.
- Sensitive Data Scanner de Datadog: Datadog proporciona filtros de ofuscación tanto en el agente (configurados en
datadog.yaml) como en la nube a través de su motor Sensitive Data Scanner, que inspecciona trazas, logs y sesiones de RUM en busca de números de tarjetas, credenciales y tokens JWT, sustituyéndolos por hashes o máscaras de texto.
Topologías de Despliegue: SaaS Multi-Inquilino vs Dynatrace Managed Soberano
Este aspecto marca la diferencia estructural más infranqueable entre ambas plataformas:
- Datadog es 100% SaaS Multi-Inquilino: Datadog no ofrece versiones autohospedadas, locales ni desconectadas de internet. Todos los datos de monitorización deben enviarse obligatoriamente a sus clústeres en la nube (AWS, Azure o GCP) en las regiones geográficas disponibles. Las organizaciones sujetas a leyes que impiden alojar datos en infraestructuras de terceros no pueden desplegar Datadog.
- Dynatrace Managed (Arquitectura Soberana Desconectada): Dynatrace ofrece Dynatrace Managed, una versión completa de su plataforma que se instala dentro del centro de datos local del cliente, en nubes privadas dedicadas o en redes militares desconectadas (air-gapped) sin salida a internet. El cliente retiene el 100% de los datos y logs dentro de sus muros físicos, mientras Dynatrace gestiona el mantenimiento de forma automatizada y remota.
| Estándar de Cumplimiento / Certificación | Datadog | Dynatrace | Estado / Cobertura |
|---|---|---|---|
| SOC 2 Tipo II y SOC 3 | Certificado (Auditoría anual de terceros) | Certificado (Auditoría anual de terceros) | Paridad Completa |
| ISO/IEC 27001, 27017, 27018 | Certificado en todas las regiones globales | Certificado en todas las regiones globales | Paridad Completa |
| Autorización FedRAMP | FedRAMP Moderate (Datadog GovCloud) | FedRAMP Moderate Autorizado | Paridad Completa |
| Nivel de Impacto Militar (DISA IL4 / IL5) | No soportado (Solo IL2 Moderate) | Elegible mediante Dynatrace Managed Air-Gapped | Exclusivo Dynatrace |
| Acuerdo HIPAA BAA (Sector Salud) | Disponible (Exige ofuscación de logs) | Disponible (Enmascaramiento integrado) | Paridad Completa |
| PCI-DSS Nivel 1 (Sector Financiero) | Atestación de Cumplimiento (AoC) | Atestación de Cumplimiento (AoC) | Paridad Completa |
12. Preguntas Frecuentes Técnicas (FAQ)
José Andrade
Arquitecto de Sistemas & Modelador FinOpsFundador y Editor Jefe en CloudBizStack. José está especializado en observabilidad de sistemas distribuidos, optimización de recursos en Kubernetes y modelos cuantitativos de TCO FinOps en proveedores cloud corporativos.