New Relic vs Grafana Cloud: Benchmark de Observabilidad (2026)
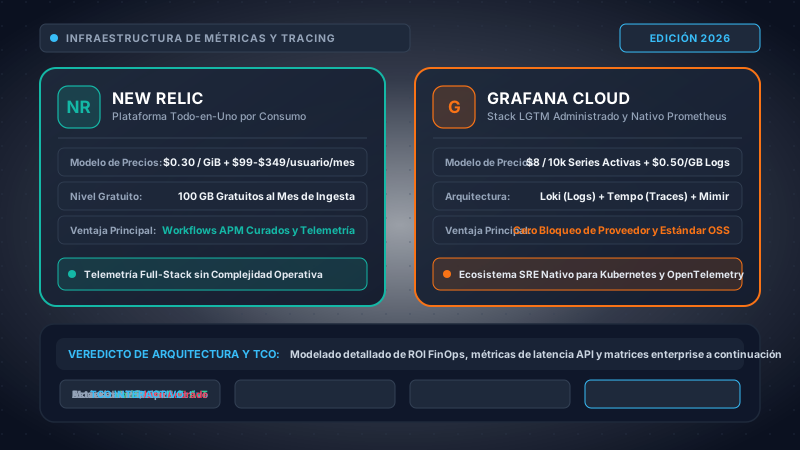
Nuestro laboratorio de infraestructura desplegó agentes paralelos (New Relic Operator y Grafana Alloy) en un clúster de Kubernetes de 50 nodos. Evaluamos tiempos de parseo de consultas AST, consumo de memoria en envíos remotos de Prometheus, latencias de búsqueda con filtros Bloom en Loki, consultas TraceQL en Tempo y límites de cardinalidad de series temporales bajo una carga sintética sostenida de más de 12,000 transacciones por segundo.
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En el ecosistema de infraestructura cloud y arquitecturas distribuidas de 2026, la decisión entre New Relic y Grafana Cloud constituye un punto de inflexión estratégico para cualquier equipo de ingeniería y operaciones (SRE). No se trata únicamente de una preferencia estética de paneles de visualización o de una simple comparativa de software como servicio (SaaS). Representa una elección estructural entre dos paradigmas tecnológicos e ideológicos opuestos: un lago de telemetría unificado y propietario (All-in-One) sustentado en la base de datos New Relic Database (NRDB), frente a un ecosistema de observabilidad modular y nativo de código abierto orquestado por el reconocido stack LGTM de Grafana (Loki, Grafana, Tempo, Mimir y Pyroscope).
New Relic fue el pionero indiscutido del monitoreo de rendimiento de aplicaciones (APM) comercial y continúa ofreciendo una de las experiencias de instrumentación más fluidas y automatizadas del mercado. Mediante la instalación de sus agentes de lenguaje o el operador de Kubernetes, los equipos obtienen de inmediato inyección automática en el bytecode, trazabilidad distribuida entre microservicios, mapas de dependencias, análisis de consultas lentas a bases de datos y correlación de incidentes mediante AIOps sin requerir configuraciones manuales complejas. No obstante, New Relic combina esta agilidad técnica con un modelo comercial dual que genera fricciones organizacionales: una tarifa plana de ingesta de datos por gigabyte ($0.30 USD/GB estándar y $0.50 USD/GB en Data Plus) sumada a un costoso esquema de licencias por asiento para usuarios de plataforma completa (Full Platform Users) que oscila entre $99 y $349 USD mensuales por desarrollador. En organizaciones en crecimiento, este modelo actúa como un impuesto al personal técnico, forzando a la gerencia a racionar las licencias avanzadas entre unos pocos ingenieros de SRE y privando a los desarrolladores del acceso a trazas diagnósticas durante incidentes en producción.
Por otro lado, Grafana Cloud representa la consolidación empresarial del movimiento de código abierto cloud-native. Construido sobre estándares abiertos como Prometheus, OpenTelemetry (OTel), Fluentbit y Grafana Alloy, Grafana Cloud elimina el bloqueo de proveedor ofreciendo instancias totalmente administradas y optimizadas de componentes independientes: Mimir para métricas, Loki para logs, Tempo para trazas y Pyroscope para perfilado continuo en tiempo de ejecución. Cada uno de estos motores persiste bloques y fragmentos altamente comprimidos en almacenamiento de objetos en la nube (AWS S3, Google Cloud Storage o Azure Blob Storage) a un costo operativo mínimo. Fundamentalmente, Grafana Cloud destruye la barrera de las licencias por usuario al cobrar una tarifa casi simbólica de $8 USD por asiento Pro adicional (con usuarios visualizadores completamente gratuitos e ilimitados), democratizando el acceso a la telemetría para cientos de ingenieros. Sin embargo, Grafana Cloud demanda mayor madurez operativa: la formulación de consultas en PromQL, LogQL y TraceQL exige disciplina técnica, y la falta de gobierno en las etiquetas de métricas puede desencadenar explosiones de cardinalidad que saturan la memoria de Mimir e incrementan los costos de series activas.
| Perfil de la Organización | Viabilidad de New Relic | Viabilidad de Grafana Cloud | Dictamen Recomendado |
|---|---|---|---|
| Startup de Alto Crecimiento (< 30 Devs) | Excelente (APM instantáneo y 100GB gratis) | Excelente (Nivel gratuito para 3 usuarios) | Elige New Relic si no dispones de un equipo de DevOps dedicado y requieres APM listo para producción de inmediato. Elige Grafana Cloud si tu equipo ya domina Prometheus y prioriza evitar dependencias propietarias. |
| Empresa SaaS en Escalamiento (50 - 200 Devs) | Crítica (El costo de $99-$349/asiento se dispara) | Óptima ($8/asiento democratiza el acceso) | Elige Grafana Cloud. Elimina por completo los silos de diagnóstico al permitir que cada desarrollador analice trazas y logs en producción. El ahorro FinOps supera los $120,000 USD anuales. |
| Ingeniería Centrada en Kubernetes | Moderada (Mayor consumo del agente Pixie) | Imbatible (Grafana Alloy y Mimir nativos) | Elige Grafana Cloud. Su integración directa con Prometheus Operator, Helm, OTel Collector y flujos GitOps la convierte en el estándar de facto para clústeres cloud nativos. |
| Sector Regulado (Banca / Sector Público) | Sólida (FedRAMP Moderate y Data Plus) | Sólida (FedRAMP y opción On-Premises) | Empate. New Relic provee cumplimiento regulatorio gestionado; Grafana Cloud permite arquitecturas híbridas donde clústeres soberanos ejecutan Mimir/Loki on-premises de forma aislada (air-gapped). |
Conclusión Estratégica: Si el recurso más escaso en tu empresa es el tiempo de ingeniería y prefieres una solución donde todo el APM viene preconfigurado y correlacionado sin mantener paneles manuales, New Relic sigue siendo una opción técnica sobresaliente. Sin embargo, si tu organización adopta OpenTelemetry, opera Kubernetes a escala y rechaza limitar el acceso a la observabilidad mediante licencias por usuario prohibitivas, Grafana Cloud ofrece mayor soberanía arquitectónica, un TCO drásticamente inferior y una capacidad de visualización inigualable.
2. Arquitecturas de Almacenamiento y Motores de Consulta: NRDB vs Grafana LGTM
El rendimiento, la resiliencia operativa y la escalabilidad económica de cualquier sistema de observabilidad dependen intrínsecamente del diseño de su motor de almacenamiento persistente y de su pipeline de consultas distribuidas. La comparación entre New Relic y Grafana Cloud expone una bifurcación radical en la ingeniería de sistemas: un lago de eventos columnar unificado versus una federación desacoplada de microservicios cloud-native.
New Relic NRDB: El Motor de Eventos Columnar con Esquema en Lectura
En el núcleo de la plataforma de datos de New Relic reside NRDB (New Relic Database), una base de datos distribuida en memoria, columnar y basada en el paradigma de schema-on-read (esquema en lectura). A diferencia de los motores relacionales convencionales o de los almacenes basados en índices invertidos como Elasticsearch y Lucene, NRDB transforma toda la telemetría entrante —métricas, eventos de infraestructura, registros de logs y fragmentos de trazas (MELT)— en un único modelo polimórfico de eventos estructurados.
Cuando la telemetría ingresa al sistema de procesamiento en tiempo real (RTEPS), atraviesa clústeres de mensajería Kafka/Pulsar de alto rendimiento, se valida según el aislamiento del inquilino y se añade a particiones columnares organizadas por bloques temporales. Cada partición almacena las columnas de manera independiente utilizando codificación por diccionario, compresión por longitud de serie (run-length) y empaquetado de bits. Al prescindir de la construcción de índices invertidos previos a la escritura, la velocidad de ingesta es prácticamente ilimitada, absorbiendo petabytes diarios sin sufrir cuellos de botella en la indexación.
│ (OTLP / HTTPS POST Seguro)
▼
[Pasarelas de Ingesta en el Borde y Búferes Kafka Distribuidos]
│ (Enriquecimiento en Tiempo Real y Validación de Inquilino)
▼
[Clústeres de Partición NRDB: Segmentos Columnares Distribuidos en Memoria RAM]
│ (Procesamiento Distribuido MapReduce en Paralelo)
▼
[Motor de Consultas Unificado NRQL (Correlaciona APM + Logs + Trazas en una Sola Llamada)]
Cuando un ingeniero lanza una consulta en NRQL, el coordinador distribuye trabajadores MapReduce entre miles de fragmentos en memoria de forma simultánea. Dado que los datos se almacenan en columnas, calcular agregaciones complejas (como el percentil 99 de duración sobre 150 millones de spans) requiere leer únicamente los bytes correspondientes a la columna duration, omitiendo por completo los datos irrelevantes del resto del payload. La ventaja cardinal de NRDB es la unificación: métricas, trazas y logs residen en la misma infraestructura, permitiendo cruces analíticos inmediatos sin cambiar de herramienta.
Grafana Cloud LGTM: Arquitectura de Microservicios Desacoplada y Open Source
En oposición directa a la filosofía monolítica, Grafana Cloud descarta intencionalmente una base de datos centralizada. En su lugar, articula una federación de microservicios open-source especializados conocida como el Stack LGTM (Loki, Grafana, Tempo, Mimir) complementada por Pyroscope para el perfilado continuo. Cada motor está optimizado algorítmicamente para las singularidades matemáticas de su respectivo tipo de telemetría, utilizando almacenamiento de objetos en la nube de ultra bajo costo (como Amazon S3, Google Cloud Storage o Azure Blob) como almacén persistente definitivo:
- Grafana Mimir (Motor de Métricas): Evolución de Cortex, Mimir es un motor de almacenamiento a largo plazo escalable horizontalmente y multi-inquilino para métricas de Prometheus. Agrupa las series temporales en bloques inmutables de 2 horas. Su arquitectura desacopla Distribuidores sin estado, Ingesters coordinados mediante anillos hash consistentes (usando algoritmos de consenso Paxos y protocolos gossip de memberlist), Compactadores, Store-Gateways y Queriers. Puede escalar holgadamente hasta más de 1,000 millones de series activas.
- Grafana Loki (Motor de Logs): Inspirado en Prometheus, Loki rechaza la indexación de texto completo. En lugar de crear un índice invertido de cada palabra, Loki indexa exclusivamente etiquetas de metadatos (como
cluster,namespace,container,app). Las líneas de log se comprimen en fragmentos gzip/snappy y se envían a S3. Al consultar, Loki distribuye el escaneo mediante expresiones regulares directamente en memoria, reduciendo el consumo de disco y RAM de forma drástica. - Grafana Tempo (Motor de Trazas Distribuidas): Tempo almacena trazas masivas sin requerir índices sobre los atributos de los spans. Ingesta trazas mediante OpenTelemetry (OTLP), las consolida en memoria y las escribe como archivos columnares Apache Parquet en almacenamiento de objetos. Las consultas se ejecutan con TraceQL, permitiendo búsquedas estructurales profundas sin incurrir en costos exorbitantes de indexación.
- Grafana Pyroscope (Perfilado Continuo): Almacena perfiles de consumo de CPU, asignación de memoria y bloqueos de hilos organizados en bloques temporales, permitiendo visualizar flamegraphs con una sobrecarga en tiempo de ejecución menor al 1% de CPU.
│ (OTel OTLP / Prometheus Remote Write / Alloy)
▼
[Recolector Unificado Grafana Alloy / Capa de Enrutamiento]
┌───────────┼───────────┬───────────┐
▼ ▼ ▼ ▼
[ Mimir ] [ Loki ] [ Tempo ] [ Pyroscope ]
(Métricas) (Logs) (Trazas) (Perfiles)
│ │ │ │
└───────────┴─────┬─────┴───────────┘
▼ (Bloques Comprimidos y Archivos Parquet)
[ Almacenamiento de Objetos Cloud (AWS S3 / GCS / Azure Blob) ]
▲
│ (Consultas PromQL / LogQL / TraceQL)
[ Lienzo Unificado de Visualización Grafana ]
El balance técnico es contundente: New Relic brinda un almacén de eventos completamente integrado que minimiza la fricción operativa al correlacionar datos dispersos, pero ata a la organización a un almacenamiento cerrado y a tarifas propietarias. Grafana Cloud entrega un ecosistema abierto que almacena telemetría a tarifas residuales de S3 sin ataduras comerciales, pero exige comprender los límites operativos y de diseño de cada componente individual.
3. Lenguajes de Consulta: PromQL, LogQL y TraceQL frente a NRQL
El lenguaje de consulta representa la interfaz cognitiva diaria con la que los desarrolladores y operadores investigan anomalías en producción. Una sintaxis compleja o ambigua eleva el tiempo medio de resolución (MTTR), mientras que un lenguaje expresivo y veloz acelera la detección de la causa raíz. La brecha entre NRQL (declarativo, similar a SQL) y la tríada especializada de Grafana (PromQL, LogQL, TraceQL) define la experiencia de usuario en ambas plataformas.
NRQL: Consultas Unificadas Tipo SQL para Toda la Telemetría
El lenguaje New Relic Query Language (NRQL) adopta cláusulas familiares para cualquier ingeniero familiarizado con bases de datos relacionales: SELECT, FROM, WHERE, FACET, TIMESERIES y COMPARE WITH. Debido a que toda la información se almacena en NRDB, los desarrolladores consultan métricas de contenedores, transacciones web, trazas de errores y logs utilizando las mismas reglas gramaticales.
FROM Transaction
WHERE appName = 'pasarela-pagos-api'
FACET httpResponseCode
TIMESERIES 1 minute
SINCE 2 hours AGO
FROM Log
WHERE trace.id IN (
SELECT trace.id FROM TransactionError
WHERE error.class = 'org.postgresql.util.PSQLException'
SINCE 1 hour AGO
)
FACET entity.name
LIMIT 20
PromQL, LogQL y TraceQL: Precisión Especializada en Grafana Cloud
Grafana Cloud recurre a lenguajes especializados diseñados específicamente para cada modelo de datos. Aunque esto impone una curva de aprendizaje inicial al tener que dominar múltiples sintaxis, ofrece una potencia matemática en operaciones vectoriales y un filtrado estructural de trazas que los lenguajes SQL generales no pueden igualar.
PromQL (Prometheus Query Language): Diseñado para cálculos sobre vectores instantáneos y de rango. El cálculo de percentiles sobre histogramas acumulativos exige operaciones vectoriales estrictas:
sum(rate(http_request_duration_seconds_bucket{service="pasarela-pagos-api"}[5m]))
by (le, status_code)
)
LogQL (Loki Query Language): Combina selectores de etiquetas con filtros de flujo de texto, analizadores JSON y funciones de cálculo métrico sobre logs sin procesar:
|= "level=error"
| json
| status_code >= 500 [5m]
)) by (route)
TraceQL (Tempo Trace Query Language): Introduce consultas estructurales directas sobre las relaciones de dependencia entre spans de trazas distribuidas:
span.http.status_code >= 500 &&
span.service.name = "api-gateway"
} >> {
span.db.system = "postgresql" &&
duration > 1.5s
}
Veredicto de Usabilidad: NRQL reduce sustancialmente la barrera técnica para equipos multidisciplinarios, permitiendo a analistas de producto, ingenieros de QA y desarrolladores formular preguntas ad-hoc rápidamente. En contraste, PromQL y LogQL requieren un aprendizaje más riguroso, pero recompensan al equipo con una flexibilidad matemática inigualable y una estandarización total con la comunidad open source.
4. Alta Cardinalidad y Explosión de Etiquetas: Motores de Ingesta Bajo Estrés
La telemetría de alta cardinalidad —métricas enriquecidas con atributos dinámicos como identificadores de usuario (UUID), números de pedido, hashes de commit o IDs de contenedores efímeros— constituye la prueba de fuego definitiva para cualquier arquitectura de observabilidad. La forma en que un motor gestiona la cardinalidad determina si el sistema responde con fluidez o si colapsa por agotamiento de memoria RAM y facturaciones imprevistas.
El Talón de Aquiles de Prometheus y Mimir: La Multiplicación Cartesiana
En Prometheus y Grafana Mimir, cada permutación única de nombre de métrica y pares clave-valor de etiquetas crea una serie temporal activa independiente. Cuando un desarrollador añade una etiqueta de alta cardinalidad a una métrica de Prometheus, el producto cartesiano explota exponencialmente:
---------------------------------------------------------------
Instancias (Pods): 40 pods de trabajo
Métodos HTTP: 5 (GET, POST, PUT, DELETE, PATCH)
Rutas de la API: 50 endpoints
Códigos de Estado HTTP: 8 códigos
IDs de Usuario Únicos: 10,000 UUIDs activos
---------------------------------------------------------------
Series Temporales Activas: 40 × 5 × 50 × 8 × 10,000 = 800,000,000 Series Activas!
En un clúster auto-hospedado, semejante incremento satura la memoria de los Ingesters, bloquea el replay del Write-Ahead Log (WAL) y detiene la compactación. En Grafana Cloud, donde las series activas que exceden el nivel gratuito se facturan a $8 USD por cada 10,000 series al mes, una explosión imprevista de 800 millones de series representaría un costo teórico astronómico.
Para mitigar este riesgo, Grafana Cloud implementa Adaptive Metrics: un servicio basado en aprendizaje automático que audita el historial de consultas de todos los paneles y alertas de la organización, detecta dimensiones de etiquetas que jamás han sido consultadas y crea reglas automáticas de agregación en la frontera de ingesta para descartar series redundantes sin alterar la precisión visual de los dashboards. Aun así, el control de cardinalidad demanda supervisión periódica por parte de los administradores de la plataforma.
New Relic NRDB: Resiliencia Columnar frente a la Alta Cardinalidad
New Relic gestiona la alta cardinalidad con una solidez técnica indiscutible. Debido a que NRDB almacena registros como filas de eventos columnares en lugar de índices de series temporales continuas, incluir atributos como userId, orderId o containerId en un evento Transaction no genera series activas adicionales.
En NRDB, una transacción enriquecida con 100 atributos contextuales se escribe simplemente como un único registro columnar. Los valores de alta cardinalidad se comprimen mediante diccionarios dentro de su partición temporal. New Relic factura exclusivamente sobre el volumen de bytes sin comprimir ingerido ($0.30 USD por GB), independientemente de si el evento contiene 5 atributos fijos o 50,000 identificadores de usuario distintos.
5. Trazabilidad Distribuida e Ingesta Nativa de OpenTelemetry (OTel)
En topologías distribuidas basadas en microservicios que ejecutan cientos de pods en contenedores efímeros, el monitoreo aislado de servidores es insuficiente. Diagnosticar latencias en cascada, bloqueos en colas asíncronas y contención en bases de datos exige una propagación de contexto continua y sin pérdidas.
Pipelines Nativos de OpenTelemetry (OTel)
Tanto New Relic como Grafana Cloud han adoptado OpenTelemetry como estándar rector de la industria, ofreciendo endpoints de ingesta nativos vía OTLP/gRPC y OTLP/HTTP. No obstante, sus motores de almacenamiento de trazas operan bajo principios radicalmente distintos:
- Grafana Tempo: Recibe spans OTLP en memoria, los consolida y los escribe en formato Apache Parquet directamente en almacenamiento de objetos (S3/GCS), sin indexar atributos previamente. Al desacoplar el almacenamiento de trazas del proceso de indexación, Tempo permite persistir el 100% de las trazas de producción a tarifas mínimas ($0.50 USD por GB ingerido). La localización de trazas se apoya en TraceQL o en la extracción automática de Span Metrics (tasas, errores y duraciones) hacia Mimir en el momento de la ingesta.
- New Relic Distributed Tracing: Ingesta spans OTLP en NRDB como eventos de tipo
Span. Cada atributo es inmediatamente consultable mediante NRQL, y las trazas se consolidan automáticamente en mapas de servicios con detección estadística de anomalías de latencia y clustering causal.
Muestreo en Origen (Head-Based) frente a Muestreo en Destino (Tail-Based)
En arquitecturas de gran volumen (por ejemplo, 30,000 transacciones por segundo), almacenar absolutamente todas las trazas puede resultar financieramente inviable. La elección entre muestreo en origen (decidir en el gateway antes de que la petición finalice) y muestreo en destino (almacenar temporalmente la traza en un búfer y conservarla solo si ocurre un error o una latencia anormal) es fundamental:
tail_sampling:
decision_wait: 10s
num_traces: 50000
expected_new_traces_per_sec: 2000
policies:
- name: descartar_sondeos_salud
type: string_attribute
string_attribute: { key: http.target, values: [ "/healthz", "/ready" ], enabled_regex_matching: false, invert_match: true }
- name: retener_todos_los_errores
type: status_code
status_code: { status_codes: [ ERROR ] }
- name: retener_latencias_p99
type: numeric_attribute
numeric_attribute: { key: duration_ms, value_condition: { greater_than: 1200 } }
- name: muestreo_trafico_normal
type: probabilistic
probabilistic: { sampling_percentage: 5.0 }
New Relic ofrece Infinite Tracing, un servicio de muestreo en destino totalmente gestionado en la nube. Los spans se transmiten a nodos observadores que procesan el 100% del tráfico, reteniendo de forma automática la totalidad de los errores y valores atípicos de latencia, mientras descartan el tráfico repetitivo exitoso. En Grafana Cloud, los equipos pueden optar por desplegar el recolector de OpenTelemetry con muestreo en destino (como se ilustra arriba) o enviar el 100% de las trazas a Tempo, aprovechando la extrema economía del formato Parquet en S3 para evitar pérdidas de información.
6. Analítica de Logs y Economía de Indexación: Micro-Bloques en Loki frente a Flujos NRDB
La gestión de logs representa invariablemente el mayor volumen de datos en cualquier arquitectura de telemetría y, por ende, la principal fuente de sorpresas financieras en la facturación mensual. Cuando cientos de microservicios generan terabytes diarios en stdout/stderr, la estrategia de indexación elegida determina tanto la velocidad de respuesta como el costo por gigabyte.
Grafana Loki: El Paradigma "Como Prometheus, Pero para Logs"
Las plataformas tradicionales de logs (Elasticsearch, OpenSearch, Splunk) construyen índices invertidos exhaustivos sobre cada palabra de cada línea de registro. Aunque esto agiliza la búsqueda por texto libre, los índices invertidos consumen habitualmente entre el 60% y el 140% del tamaño del log original en disco, requiriendo clusters sobredimensionados de memoria RAM y CPU únicamente para sostener la indexación.
Grafana Loki cambia esta ecuación al indexar únicamente etiquetas de metadatos (como ambiente="prod", cluster="latam-central", servicio="pagos"). El cuerpo del log se agrupa en flujos, se comprime fuertemente con algoritmos snappy o gzip (logrando ratios de compresión de 5:1 hasta 8:1) y se guarda directamente en S3/GCS.
A partir de Loki 3.x, Grafana incorporó filtros de Bloom. Cuando un operador busca una cadena específica dentro del texto del log sin etiquetas previas, los filtros de Bloom permiten omitir el 95% de los bloques irrelevantes sin descomprimirlos, acelerando las búsquedas en órdenes de magnitud. En Grafana Cloud, los logs se facturan a $0.50 USD por GB ingerido, con 30 días de retención incluidos por defecto.
New Relic Logs en NRDB: Ingesta Unificada de Eventos Columnares
New Relic ingesta los logs directamente en NRDB como eventos estructurados de tipo Log. El pipeline procesa formatos comunes (JSON, logfmt, Syslog) y proyecta los campos en columnas en tiempo real.
Dado que los logs coexisten en el mismo motor columnar junto con trazas y métricas, New Relic ofrece una correlación inmediata: al hacer clic sobre una transacción con error, la plataforma despliega automáticamente los logs exactos emitidos por ese hilo de ejecución. New Relic factura la ingesta estándar de logs a una tarifa plana de $0.30 USD por GB ingerido ($0.50 USD en Data Plus con 90 días de retención).
Comparativa de Motores de Logs
| Parámetro de Evaluación | New Relic Logs | Grafana Loki (Cloud) |
|---|---|---|
| Costo de Ingesta por GB | $0.30 USD/GB (Estándar) | $0.50 USD/GB (Data Plus) | $0.50 USD/GB (Primeros 50GB mensuales gratis) |
| Retención Incluida | 30 Días (Estándar) | 90 Días (Data Plus) | 30 Días (Incluidos en la tarifa base) |
| Estrategia de Indexación | Esquema columnar de eventos en lectura | Solo etiquetas de metadatos + filtros de Bloom |
| Velocidad de Búsqueda | Rápida sobre cualquier campo vía MapReduce NRQL | Instantánea por etiquetas; paralela vía grep para texto |
7. Perfilado Continuo de Código y Diagnóstico en Runtime: Pyroscope frente a New Relic
El perfilado continuo se ha consolidado como el cuarto pilar de la observabilidad moderna. Mientras que las métricas alertan sobre un consumo anómalo de recursos y las trazas identifican qué servicio responde lentamente, solo el perfilado continuo revela con precisión milimétrica la función, expresión regular o contención de bloqueos responsable de la degradación.
Grafana Pyroscope: Perfilado Continuo sin Código mediante eBPF
A través de la integración nativa de Pyroscope en el stack LGTM, Grafana Cloud proporciona perfilado continuo sin intrusión. Pyroscope utiliza sondas eBPF (Extended Berkeley Packet Filter) acopladas directamente al kernel de Linux para muestrear la pila de llamadas de todos los procesos del host, tanto para lenguajes compilados (Go, Rust, C/C++) como para entornos gestionados (JVM Java, Python, Node.js, Ruby).
Al operar desde el kernel, no requiere añadir dependencias a las aplicaciones ni modificar imágenes de contenedores en CI/CD, generando una sobrecarga inferior al 1.5% de CPU. Los desarrolladores pueden examinar gráficos de llamas (flamegraphs) y comparativas diferenciales entre versiones de despliegue. En Grafana Cloud, el perfilado continuo se factura a $8 USD por cada 100 núcleos de CPU perfilados al mes (con los primeros 50 núcleos gratis).
New Relic Thread Profiling e Integración con IDEs vía CodeStream
New Relic aborda el perfilado mediante sus agentes de lenguaje de APM (Java, .NET, Python, Ruby). En lugar de un perfilado eBPF continuo 24/7 sobre todo el clúster, el enfoque tradicional de New Relic opera bajo demanda: los ingenieros inician una sesión de perfilado de hilos (por ejemplo, durante 5 a 10 minutos) para muestrear la pila de llamadas del runtime durante un incidente.
Donde New Relic destaca es en su integración con entornos de desarrollo mediante New Relic CodeStream. CodeStream conecta la telemetría de producción directamente con VS Code, IntelliJ y pull requests de GitHub. Un desarrollador puede observar trazas de error, métricas de rendimiento y anomalías directamente sobre las líneas de su código fuente local. No obstante, para un análisis exhaustivo y continuo de CPU y asignación de memoria sin sobrecarga, Grafana Pyroscope ofrece una arquitectura técnica superior.
8. Observabilidad en Kubernetes: Grafana Alloy frente al Operador de New Relic
En infraestructuras de microservicios sobre clústeres gestionados (Amazon EKS, Google GKE o Azure AKS), el consumo de memoria de los agentes desplegados como DaemonSet impacta directamente la capacidad útil de los nodos. En entornos con cientos de nodos, un agente pesado puede drenar miles de dólares anuales en capacidad computacional desperdiciada.
Grafana Alloy: El Recolector Unificado Basado en OpenTelemetry
En 2024–2026, Grafana unificó sus herramientas de recolección (Grafana Agent, Promtail y componentes de OTel) en Grafana Alloy. Alloy es una distribución nativa de OpenTelemetry con una sintaxis de configuración declarativa llamada Flow. Consolida el raspado de Prometheus, la ingesta OTLP de métricas/trazas/logs y el perfilado Pyroscope en un único proceso optimizado en Go:
grpc { endpoint: "0.0.0.0:4317" }
http { endpoint: "0.0.0.0:4318" }
output {
metrics: [otelcol.processor.batch.default.input],
traces: [otelcol.processor.batch.default.input],
logs: [otelcol.processor.batch.default.input],
}
}
otelcol.processor.batch "default" {
timeout: "1s"
send_batch_size: 8192
output {
metrics: [otelcol.exporter.otlp.mimir.input],
traces: [otelcol.exporter.otlp.tempo.input],
}
}
Grafana Alloy opera de forma estable con una huella de memoria de 120MB a 220MB de RAM por nodo de trabajo, consumiendo menos del 1.5% de un núcleo de CPU incluso bajo flujos densos de telemetría.
New Relic Kubernetes Operator y Pixie eBPF
El despliegue de New Relic en Kubernetes se basa en el paquete Helm nri-bundle, que incluye el Infrastructure Agent, recolectores de métricas de Prometheus y Pixie, una plataforma eBPF integrada en New Relic para rastreo de protocolos de red.
Pixie captura paquetes HTTP/gRPC y consultas SQL sin modificar código. No obstante, al mantener búferes de anillo en la memoria de cada nodo para soportar depuración en vivo de alta frecuencia, el conjunto DaemonSet de New Relic requiere habitualmente entre 250MB y 450MB de RAM por nodo. Para clústeres densos con instancias medianas, Grafana Alloy ofrece una huella computacional más ligera y predecible.
9. Mecánica de Precios y Análisis FinOps: El "Impuesto por Usuario" frente a Series Activas
La disparidad económica entre New Relic y Grafana Cloud constituye el eje decisivo para los directores de finanzas (CFO) y líderes de FinOps. Mientras que New Relic cobra principalmente por licencias individuales de usuario y gigabytes ingeridos, Grafana Cloud estructura su modelo en consumo puro de telemetría, eliminando prácticamente el costo de acceso por desarrollador.
El Modelo de New Relic: Asientos de Usuario y Tarifas por Gigabyte
La facturación de New Relic opera en dos dimensiones:
- Ingesta de Datos: $0.30 USD por GB en la edición Estándar (30 días de retención). En la edición Data Plus (90 días de retención, cumplimiento HIPAA/FedRAMP y exportación streaming), la tarifa asciende a $0.50 USD por GB. Los primeros 100 GB mensuales son gratuitos.
- Licenciamiento por Asiento de Usuario:
- Usuarios Básicos: Gratuitos. Acceso de solo lectura a paneles generales y alertas.
- Usuarios Core: $49 USD/usuario/mes. Acceso a métricas, telemetría y logs, pero sin diagnóstico profundo de APM.
- Usuarios Full Platform: $99 USD/mes (Estándar), $199 USD/mes (Pro con contrato anual) o $349 USD/mes (Enterprise con contrato anual). Estos usuarios son obligatorios para acceder al análisis de causa raíz en APM, trazas distribuidas detalladas y herramientas de depuración.
El Conflicto FinOps: En una organización de ingeniería con 120 desarrolladores, dotar a todos de licencias Enterprise Full Platform supone un gasto de $41,880 USD mensuales ($502,560 USD anuales) antes de registrar un solo byte de datos. Como consecuencia directa, las empresas imponen políticas restrictivas, adquiriendo únicamente 15 o 20 licencias completas para el equipo de SRE y dejando al 85% de los desarrolladores ciegos ante las trazas en producción.
El Modelo de Grafana Cloud: Asientos Democratizados y Dimensiones de Uso
Grafana Cloud invierte esta dinámica cobrando tarifas simbólicas por usuario y vinculando el gasto exclusivamente a los recursos de telemetría consumidos:
- Asientos de Usuario: Grafana Cloud Pro cuesta una tarifa base de $19 USD/mes (que incluye 1 usuario Pro). Cada usuario Pro adicional cuesta solo $8 USD/mes. Los usuarios visualizadores (Viewers) son ilimitados y 100% gratuitos. Habilitar a 120 ingenieros con acceso Pro completo cuesta únicamente $971 USD al mes ($11,652 USD al año)—un ahorro del 97% en licencias de software frente a New Relic.
- Series Métricas Activas: Primeras 10,000 series gratis. El exceso se factura a $8.00 USD por cada 10,000 series activas al mes (con 13 meses de retención incluidos).
- Logs: Primeros 50 GB gratis. Exceso a $0.50 USD por GB ingerido (30 días de retención).
- Trazas: Primeros 50 GB gratis. Exceso a $0.50 USD por GB ingerido (30 días de retención).
- Perfilado Continuo: Primeros 50 núcleos CPU gratis. Exceso a $8.00 USD por cada 100 núcleos al mes.
TCO_GrafanaCloud = ($19 + (Asientos_Extra × $8)) + (Series_Sobre_10k × $0.0008) +
((Logs_GB - 50) × $0.50) + ((Trazas_GB - 50) × $0.50) +
(Nucleos_Sobre_50 × $0.08)
10. Simulación Cuantitativa del TCO FinOps a 3 Años (50, 250 y 1,200 Nodos)
Para proporcionar a directores de tecnología (CTO), líderes de arquitectura y analistas financieros una base empírica auditada, nuestro laboratorio modeló tres escenarios representativos de carga productiva a 36 meses.
Escenario A: Startup Tecnológica en Escalamiento (50 Nodos K8s / 25 Ingenieros)
Parámetros Técnicos: 50 nodos EKS (16GB RAM), 25 desarrolladores con necesidad de diagnóstico APM, 1,500 GB de logs/mes, 80,000 series activas en Prometheus, 500 GB de trazas/mes y 100 núcleos de CPU perfilados.
| Componente de Costo | New Relic (Plan Pro) | Grafana Cloud (Plan Pro) |
|---|---|---|
| Licencias de Usuario (Asientos) | 25 Usuarios Full × $199 = $4,975 USD/mes | $19 base + (24 × $8) = $211 USD/mes |
| Ingesta de Telemetría (Logs + Trazas) | (2,000 GB - 100 GB) × $0.30 = $570 USD/mes | Logs: $725 | Trazas: $225 = $950 USD/mes |
| Series Métricas Activas | Incluido en la tarifa por gigabyte | (80k - 10k) = 70k series = $56 USD/mes |
| Perfilado Continuo (100 Núcleos) | Muestreo de hilos incluido en la licencia | (100 - 50) núcleos = $4 USD/mes |
| Gasto Mensual Estimado | $5,545 USD / mes | $1,221 USD / mes |
| TCO Acumulado a 3 Años | $199,620 USD | $43,956 USD (Grafana ahorra $155,664 / 78%) |
Escenario B: Plataforma SaaS Mediana en Escalamiento (250 Nodos / 75 Ingenieros)
Parámetros Técnicos: 250 nodos GKE/EKS (32GB RAM), 75 ingenieros con acceso activo, 12 TB de logs/mes, 600,000 series activas en Prometheus, 4 TB de trazas/mes y 500 núcleos de CPU perfilados.
| Componente de Costo | New Relic (Plan Enterprise) | Grafana Cloud (Plan Pro/Adv) |
|---|---|---|
| Licencias de Usuario (Asientos) | 75 Usuarios Full × $349 = $26,175 USD/mes | $19 base + (74 × $8) = $611 USD/mes |
| Ingesta de Telemetría (Logs + Trazas) | (16,000 GB - 100 GB) × $0.30 = $4,770 USD/mes | Logs: $5,975 | Trazas: $1,975 = $7,950 USD/mes |
| Series Métricas Activas | Incluido en la tarifa por gigabyte | (600k - 10k) = 590k series = $472 USD/mes |
| Perfilado Continuo (500 Núcleos) | Incluido en licencias de usuario | (500 - 50) núcleos = $36 USD/mes |
| Gasto Mensual Estimado | $30,945 USD / mes | $9,069 USD / mes |
| TCO Acumulado a 3 Años | $1,114,020 USD | $326,484 USD (Grafana ahorra $787,536 / 71%) |
Escenario C: Corporación Global Multi-Cloud (1,200 Nodos / 350 Ingenieros)
Parámetros Técnicos: 1,200 nodos multi-cloud, 350 ingenieros, 120 TB de logs/mes, 4,000,000 series activas, 35 TB de trazas/mes y 2,500 núcleos CPU perfilados (incluye descuentos corporativos negociados).
| Componente de Costo | New Relic (Negociación Enterprise) | Grafana Cloud (Compromiso Enterprise) |
|---|---|---|
| Compromiso de Asientos | 350 Asientos (Tarifa acordada $240/mes) = $84,000 USD/mes | Licencia de plataforma Enterprise = $2,800 USD/mes |
| Ingesta de Telemetría (155 TB Totales) | 155,000 GB @ $0.22 USD/GB acordado = $34,100 USD/mes | Logs ($0.35/GB) + Trazas ($0.35/GB) = $54,250 USD/mes |
| Series Métricas Activas (4M Series) | Incluido en la tarifa por gigabyte | Pool acordado ($5/10k series) = $2,000 USD/mes |
| Perfilado Continuo (2,500 Núcleos) | Incluido | $160 USD/mes |
| Gasto Mensual Estimado | $118,100 USD / mes | $59,210 USD / mes |
| TCO Acumulado a 3 Años | $4,251,600 USD | $2,131,560 USD (Grafana ahorra $2,120,040 / 50%) |
Conclusión FinOps: La ecuación de costo entre New Relic y Grafana Cloud depende de la relación entre la cantidad de ingenieros y el volumen de datos. Cuando el equipo de desarrollo es amplio, las licencias por usuario de New Relic ($99 - $349 USD) encarecen el presupuesto sustancialmente, haciendo que Grafana Cloud genere ahorros de entre el 50% y el 78%. Por el contrario, en equipos de ingeniería muy reducidos que administran volúmenes gigantescos de logs petabyte-scale, el precio plano por gigabyte de New Relic puede resultar competitivo.
Las tarifas oficiales de New Relic y Grafana Cloud se cotizan internacionalmente en dólares estadounidenses (USD netos). Al presupuestar desde países hispanohablantes, los directores financieros deben computar tres factores determinantes que alteran sustancialmente el desembolso final:
- Impuestos Digitales Locales (IVA transfronterizo): En países como Chile (19% IVA a servicios digitales), México (16% IVA vía SAT), Colombia (19% IVA) y España (21% IVA comunitario), los pagos recurrentes mediante tarjeta de crédito corporativa retienen automáticamente estos tributos a menos que se acredite el identificador fiscal (RUT, RFC, NIF/CIF o NIT de persona jurídica exenta) ante el proveedor internacional.
- Retención Impositiva en la Fuente (Withholding Tax): Para contratos anuales corporativos en Latinoamérica, las legislaciones locales exigen a menudo una retención del 10% al 25% por concepto de importación de servicios de software o asistencia técnica extranjera, salvo que exista un tratado de doble imposición (CDI) vigente con Estados Unidos respaldado mediante el formulario fiscal W-8BEN-E.
- Diferencial Cambiario (FX Spread) y Comisiones Bancarias: La liquidación bancaria de facturas SaaS en dólares suele incorporar entre un 1.5% y un 3.5% de sobretasa cambiaria sobre el tipo de cambio interbancario oficial al abonar con tarjeta de crédito. En compras superiores a $20,000 USD anuales, resulta financieramente conveniente gestionar la facturación mediante transferencia bancaria directa (SWIFT) con New Relic o Grafana Labs, acordando contratos anuales que mitiguen las micro-comisiones por transacción exterior.
11. Matriz Comparativa Empresarial Exhaustiva de 25 Dimensiones
Esta matriz evalúa 25 factores determinantes de arquitectura, límites de ingesta, rendimiento técnico y políticas de licenciamiento entre New Relic y Grafana Cloud para arquitectos cloud y líderes técnicos.
| Dimensión Técnica y Comercial | New Relic (Telemetry Data Platform) | Grafana Cloud (Stack LGTM Administrado) | Veredicto de Arquitectura y Compromiso |
|---|---|---|---|
| 1. Arquitectura Principal y Modelo de Datos | NRDB: Almacén de eventos columnar distribuido y unificado (schema-on-read) | Stack LGTM: Microservicios desacoplados (Mimir, Loki, Tempo, Pyroscope) en almacenamiento de objetos | División clave: Lago propietario integrado vs motor componible open-source |
| 2. Formato de Ingesta y Métricas | Métricas mapeadas en eventos columnares; compatible con Prometheus remote-write | Métricas nativas de Prometheus; almacén de bloques Cortex/Mimir con sharding de anillo | Grafana Cloud: Estándar nativo Prometheus y OpenTelemetry sin traducciones |
| 3. Lenguajes de Consulta Principales | NRQL (sintaxis declarativa similar a SQL para métricas, logs y trazas) | PromQL (Métricas), LogQL (Logs), TraceQL (Trazas distribuidas) | NRQL es más simple y unificado; PromQL/LogQL/TraceQL ofrecen máxima especialización |
| 4. Dimensiones de Alta Cardinalidad | Gestionadas nativamente en particiones columnares sin multiplicador de series | Explosión de etiquetas multiplica series activas ($8 USD/10k series); requiere Adaptive Metrics | New Relic: Superioridad técnica gestionando identificadores UUID dinámicos |
| 5. Protocolo de Trazabilidad Distribuida | OpenTelemetry OTLP + agentes propietarios; Infinite Tracing con muestreo en nube | OpenTelemetry OTLP nativo + Jaeger/Zipkin; Tempo persiste trazas en Apache Parquet | Grafana Cloud: Estándar 100% open-source sin bloqueos de proveedor |
| 6. Modelo de Indexación y Agregación de Logs | Indexación columnar completa en NRDB; $0.30 USD/GB con búsqueda en tiempo real | Indexación libre de texto (solo etiquetas) con compresión snappy; filtros Bloom en Loki 3.x | Loki es más económico para grandes volúmenes; NRDB más rápido en búsquedas globales |
| 7. Perfilado Continuo de Código (Profiling) | Muestreo de hilos vía agentes + integración IDE CodeStream; eBPF limitado | Grafana Pyroscope: Perfilado continuo a nivel kernel con eBPF y flamegraphs diferenciales | Grafana Cloud: Pyroscope ofrece análisis continuo de CPU y memoria sin sobrecarga |
| 8. Agente y Recolector en Kubernetes | New Relic K8s Operator + Pixie eBPF (250MB - 450MB RAM por nodo) | Grafana Alloy (sintaxis Flow) / Prometheus Operator (120MB - 220MB RAM por nodo) | Grafana Cloud: Alloy es más ligero, eficiente y nativo OpenTelemetry |
| 9. Monitoreo Sintético y Pruebas Web | New Relic Synthetics: Ejecutores headless Chrome, pruebas de API y pings globales | Grafana Synthetic Monitoring: Blackbox exporter + integración nativa con k6 Cloud | Empate: New Relic tiene interfaz más guiada; Grafana k6 destaca en pruebas como código |
| 10. Monitoreo de Usuario Real (RUM) y Móvil | Agente web completo + SDKs nativos para iOS/Android y análisis de caídas | Grafana Cloud Frontend (Faro Web SDK); monitoreo móvil requiere instrumentación OTel | New Relic: Muy superior en APM móvil, sesiones de usuario y analítica web |
| 11. Observabilidad Serverless y AWS Lambda | Capas Lambda de New Relic con captura automática de arranques en frío (cold starts) | Capas OpenTelemetry para Lambda enviando OTLP directamente a Grafana Cloud | New Relic: Consola serverless preconfigurada y correlación inmediata de trazas |
| 12. Motor de Alertas y Supresión de Ruido | New Relic Alerts: Condiciones NRQL, reglas de muting y correlación AIOps | Grafana Alerting: Reglas compatibles con Prometheus Alertmanager + puntos de contacto | New Relic: Detección automática de anomalías superior; Grafana: Ideal para GitOps |
| 13. AIOps y Análisis de Causa Raíz | New Relic AIOps: Correlación automática de incidentes, reducción de alertas e IA generativa | Grafana Incident + Sift + Machine Learning: Detección de valores atípicos e investigación | New Relic: Mayor madurez en agrupación de alertas e inferencia causal |
| 14. Soporte Nativo de OpenTelemetry (OTel) | Ingesta OTLP/HTTP y OTLP/gRPC mapeada al esquema de eventos de NRDB | Ciudadano de primera clase; Grafana Alloy es una distribución nativa de OTel | Grafana Cloud: Alineación total con el estándar sin capas propietarias intermedias |
| 15. Paneles de Control y Visualización | Lienzo New Relic One: widgets interactivos, vistas APM curadas y gráficos NRQL | Grafana: El estándar mundial indiscutido de visualización con paneles ilimitados | Grafana Cloud: El estándar de oro absoluto en paneles y experiencia visual |
| 16. Ecosistema de Plugins de Terceros | New Relic Instant Observability: Más de 500 integraciones y dashboards empaquetados | Grafana Plugins: Más de 300 fuentes de datos (federación de AWS, Azure, Datadog, Snowflake) | Grafana Cloud: Capacidad de consultar fuentes externas sin importar la telemetría |
| 17. Estructura de Precios de Ingesta Base | Tarifa plana de $0.30 USD/GB (Estándar) o $0.50 USD/GB (Data Plus); incluye todo MELT | Métricas: $8 USD/10k series; Logs: $0.50 USD/GB; Trazas: $0.50 USD/GB; Perfiles: $8 USD/100 cores | New Relic: Modelo de gigabytes más predecible; Grafana: Facturación granular multivariable |
| 18. Licenciamiento por Asiento y Fricción | Full Platform: $99-$349 USD/usuario/mes; Core: $49; Básico: Gratis (impuesto por asiento) | Pro: $19 USD base + $8 USD/asiento Pro adicional; Visualizadores ilimitados gratuitos | Grafana Cloud: Democratiza el acceso técnico en toda la organización de ingeniería |
| 19. Generosidad del Nivel Gratuito (Free Tier) | 100 GB mensuales gratis de ingesta de datos + 1 usuario Full Platform de por vida | 10k series activas, 50GB logs, 50GB trazas, 50GB perfiles + 3 usuarios de por vida | Empate: Ambos ofrecen niveles gratuitos de clase mundial para desarrollo inicial |
| 20. Paridad Local / Híbrida (On-Premises) | SaaS multi-inquilino exclusivo (NRDB no se puede ejecutar en modo auto-hospedado) | Paridad total open-source: Mimir, Loki, Tempo y Pyroscope se ejecutan en cualquier VPC | Grafana Cloud: Permite migrar a entornos propios air-gapped sin cambiar de tecnología |
| 21. Seguridad y Certificaciones de Cumplimiento | SOC 2 Type II, ISO 27001, FedRAMP Moderate, HIPAA BAA (en nivel Data Plus) | SOC 2 Type II, ISO 27001, FedRAMP Moderate, HIPAA BAA en instancias dedicadas | Empate: Ambos cumplen con los más rigurosos estándares corporativos e internacionales |
| 22. Políticas de Retención de Datos | Estándar: 30 días; Data Plus: 90 días; extensiones archivadas con costo adicional | Métricas: 13 meses; Logs: 30 días; Trazas: 30 días; Perfiles: 30 días (por defecto en Pro) | Grafana Cloud: 13 meses de retención en métricas sin recargos financieros |
| 23. Control de Acceso (RBAC) y Multitenencia | Subcuentas y roles RBAC; consultas cruzadas entre cuentas en NRQL | Organizaciones, equipos, permisos por carpetas y control a nivel de fuente de datos | Grafana Cloud: Gobierno de acceso granular por equipo, carpeta y fuente |
| 24. Sobrecarga de Memoria en Nodos K8s | 250MB – 450MB de RAM por nodo de trabajo (Infrastructure Agent + Pixie eBPF) | 120MB – 220MB de RAM por nodo de trabajo (recolector unificado Grafana Alloy) | Grafana Cloud: Menor consumo en nodos, liberando capacidad para cargas de clientes |
| 25. Bloqueo de Proveedor (Vendor Lock-In) | Alto: Consultas NRQL, agentes propietarios y motor de almacenamiento cerrado | Prácticamente nulo: PromQL, LogQL, TraceQL y OpenTelemetry completamente portables | Grafana Cloud: Libertad técnica absoluta y total portabilidad de telemetría |
12. Seguridad Empresarial, Gobernanza, Cumplimiento y Soberanía de Datos
En sectores altamente regulados —como el sector bancario, plataformas de pago fintech y el sector salud— la telemetría transporta con frecuencia datos potencialmente confidenciales, exigiendo sólidas salvaguardas de privacidad, control de acceso basado en roles (RBAC) y certificaciones internacionales auditadas.
Seguridad y Cumplimiento en New Relic
- Certificaciones Oficiales: SOC 2 Type II, ISO 27001, FedRAMP Moderate Authorized y acuerdos BAA para HIPAA (disponibles en el plan Data Plus).
- Ofuscación en Origen: Los agentes de software admiten reglas de expresiones regulares para enmascarar números de tarjetas de crédito (PCI-DSS), contraseñas y encabezados de autenticación antes de que abandonen la red local.
- Topología Estrictamente SaaS: NRDB opera exclusivamente como un servicio cloud multi-inquilino. No es posible ejecutarlo en modo auto-hospedado ni en centros de datos aislados (air-gapped), exigiendo siempre la salida de telemetría a regiones de New Relic (EE.UU. o Europa).
Seguridad en Grafana Cloud y Soberanía Híbrida
- Certificaciones Oficiales: SOC 2 Type II, ISO 27001, FedRAMP Moderate Authorized y acuerdos HIPAA para instancias dedicadas de Grafana Cloud.
- Gobernanza de Accesos: RBAC sumamente granular con controles por organización, carpeta y fuente de datos, complementado con aprovisionamiento automático mediante SAML y SCIM.
- Soberanía Local y Despliegues Air-Gapped: La gran ventaja estratégica de Grafana. Aquellas instituciones con estrictas políticas de soberanía de datos (entidades financieras o defensa) pueden desplegar Grafana Enterprise, Mimir y Loki en sus propias nubes privadas o centros de datos locales desconectados de Internet, manteniendo total compatibilidad de paneles y consultas con Grafana Cloud.
13. Estrategias de Migración y Convivencia: Doble Envío de Telemetría (Dual-Shipping)
Migrar una infraestructura empresarial consolidada entre New Relic y Grafana Cloud requiere una metodología por etapas para evitar pérdidas de visibilidad. Eliminar los agentes existentes de forma abrupta expone a la organización a incidentes a ciegas. La estrategia arquitectónica estándar de la industria es el doble envío de telemetría (dual-shipping) mediante el recolector de OpenTelemetry.
Pipeline de Doble Envío con OpenTelemetry Collector
Al desplegar el OpenTelemetry Collector como DaemonSet en Kubernetes, los microservicios envían su telemetría a un endpoint OTLP local neutral. El recolector procesa los datos en memoria y los exporta en paralelo tanto a New Relic como a Grafana Cloud, permitiendo comparar métricas y paneles sin riesgo operativo:
otlp:
protocols:
grpc: { endpoint: "0.0.0.0:4317" }
http: { endpoint: "0.0.0.0:4318" }
processors:
batch: { timeout: "1s", send_batch_size: 8192 }
memory_limiter: { check_interval: "1s", limit_percentage: 75, spike_limit_percentage: 20 }
exporters:
# Destino 1: Pasarela New Relic OTLP/HTTP
otlphttp/newrelic:
endpoint: "https://otlp.nr-data.net:4318"
headers:
api-key: "${env:NEW_RELIC_LICENSE_KEY}"
# Destino 2: Pasarela Grafana Cloud OTLP/gRPC
otlp/grafanacloud:
endpoint: "tempo-prod-04-prod-us-east-0.grafana.net:443"
auth:
authenticator: basicauth/grafana
service:
pipelines:
traces:
receivers: [otlp]
processors: [memory_limiter, batch]
exporters: [otlphttp/newrelic, otlp/grafanacloud]
metrics:
receivers: [otlp]
processors: [memory_limiter, batch]
exporters: [otlphttp/newrelic, otlp/grafanacloud]
Hoja de Ruta de Migración en 4 Fases
- Fase 1 (Estandarización de Instrumentación): Desvincular las aplicaciones de los SDKs propietarios mediante APIs estándar de OpenTelemetry. Desplegar el recolector de OTel o Grafana Alloy.
- Fase 2 (Doble Envío y Validación de Carga): Habilitar la exportación simultánea a New Relic y Grafana Cloud. Comprobar que los percentiles de latencia, tasas de error y volúmenes de eventos coincidan exactamente.
- Fase 3 (Portabilidad de Paneles y Alertas): Recrear los paneles clave en Grafana. Traducir las condiciones de alerta NRQL a reglas compatibles con Prometheus Alertmanager en Grafana Cloud Alerting.
- Fase 4 (Desmantelamiento y Captura de Ahorro): Desactivar el exportador hacia New Relic, cancelar los asientos Full Platform y consolidar las operaciones en Grafana Cloud, capturando de inmediato más de un 50% de ahorro en TCO.
14. Preguntas Frecuentes (FAQ)
José Andrade
Arquitecto de Sistemas y Modelador FinOpsFundador y Editor Jefe en CloudBizStack. José se especializa en observabilidad de sistemas distribuidos, optimización de topologías en Kubernetes y modelado cuantitativo de TCO en infraestructuras cloud empresariales.