Apache Kafka vs RabbitMQ: Streaming de Eventos vs Colas AMQP (2026)
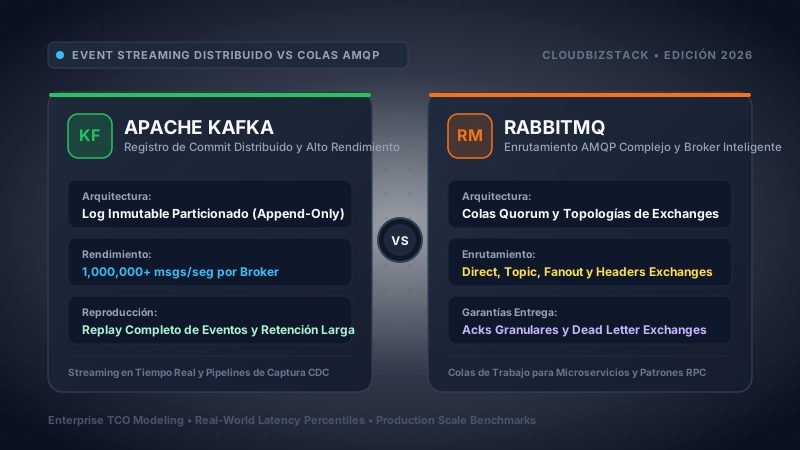
Nuestro equipo de ingeniería sometió a pruebas continuas de estrés durante 72 horas a Apache Kafka 3.9 (modo nativo KRaft, sin dependencias de ZooKeeper) frente a RabbitMQ 3.13 / 4.0 (motor BEAM en Erlang 26 con colas Quorum Queues). Los clústeres experimentales fueron desplegados sobre infraestructura simétrica en AWS: tres instancias de cómputo dedicadas c6i.4xlarge (16 vCPUs, 32 GiB de memoria RAM, 12.5 Gbps de ancho de banda garantizado hacia almacenamiento EBS) conectadas a volúmenes NVMe gp3 con 3.000 IOPS basales y 250 MB/s de rendimiento sostenido, interconectadas mediante redes privadas de 10 Gbps a través de múltiples zonas de disponibilidad (multi-AZ). Evaluamos el caudal de ingestión secuencial con cargas útiles de 256 bytes a 64 kilobytes, medimos distribuciones de latencia en los percentiles p50/p95/p99/p99.9 bajo saturación de consumidores, ejecutamos escenarios caóticos de partición de red (pruebas de split-brain mediante Toxiproxy) y analizamos los umbrales de degradación de memoria ante retrasos críticos en el procesamiento.
La confrontación tecnológica entre Apache Kafka y RabbitMQ no se reduce a una simple comparativa de velocidad bruta: representa la elección entre dos paradigmas informáticos antagónicos: streaming distribuido mediante un registro inmutable append-only frente a intermediación inteligente de mensajes transaccionales con colas y exchanges AMQP. Ninguna plataforma es universalmente superior; implementar la herramienta incorrecta desencadena colapsos operativos, costes de nube desorbitados y sobrecarga técnica insostenible para los equipos de ingeniería.
Al presupuestar servicios de mensajería y streaming gestionados en la nube (como Confluent Cloud, AWS MSK, CloudAMQP o Amazon MQ) desde empresas constituidas en España o América Latina, es fundamental calcular los factores impositivos y bancarios transfronterizos que encarecen el coste total sobre la cotización en dólares estadounidenses (USD):
- IVA Digital y Tributación Transfronteriza: Países como España (21% IVA), Chile (19% IVA digital), Colombia (19% IVA) y México (16% IVA) retienen o exigen autorepercusión en la facturación de servicios cloud radicados en EE.UU. o la UE, a menos que se configure una entidad corporativa con NIF-IVA intracomunitario o RFC/RUT empresarial formalmente registrado.
- Retenciones Impositivas en la Fuente: En jurisdicciones como Argentina (tributos PAIS / percepciones aduaneras) o Perú (retención del impuesto a la renta de no domiciliados), los pagos al exterior por software de infraestructura pueden experimentar sobrecargos fiscales efectivos de entre el 24% y el 40% si no se canalizan mediante un revendedor local o filial multinacional.
- Diferencial Cambiario y Volatilidad FX: Las plataformas gestionadas facturan el consumo de ancho de banda y cómputo de manera horaria en USD. Los bancos corporativos en Latinoamérica aplican diferenciales cambiarios de entre un 1.5% y un 3.8% sobre el tipo de cambio oficial al liquidar tarjetas de crédito o transferencias SWIFT corporativas. En proyectos de streaming con facturación mensual de $5.000 USD, este diferencial genera un sobrecoste oculto de más de $2.000 USD anuales.
Índice de Contenidos: Análisis Técnico Exhaustivo y Benchmark 2026
- 1. Panorama Ejecutivo: La Brecha Entre Streaming y Broker Inteligente
- 2. Almacenamiento: Commit Log Inmutable vs Colas Quorum en BEAM
- 3. Consenso y Clúster: KRaft (KIP-500) vs Mnesia, Raft y Khepri
- 4. Semánticas de Entrega, Orden Estricto y Sharding por Partición
- 5. Modelos de Consumo: Rebalanceo Cooperativo Sticky vs QoS Prefetch
- 6. Implementaciones de Código en Producción: Java, Go y Python
- 7. Benchmark de Rendimiento y Latencia (p50, p95, p99, p99.9)
- 8. Topologías de Enrutamiento: Exchanges AMQP vs Procesamiento Stream
- 9. Retención, Compactación y Reproducción Histórica de Eventos
- 10. Resiliencia Operativa, Modos de Fallo y Recuperación ante Desastres
- 11. Matriz Comparativa Exhaustiva de 25 Dimensiones Técnicas
- 12. Modelado FinOps: Coste Total de Propiedad (TCO) a 3 Años
- 13. Seguridad Empresarial, Gobernanza y Cumplimiento Normativo
- 14. Guía de Decisión Arquitectónica y Patrones Híbridos
- 15. Preguntas Frecuentes Técnicas con Respuestas en Profundidad
- 16. Ecosistema de Artículos Relacionados y Perfil del Autor
1. Panorama Ejecutivo: La Brecha Paradigmática — Event Streaming vs Mensajería Inteligente
En el núcleo de la ingeniería de software moderna reside la comunicación asíncrona entre procesos distribuidos. A medida que las aplicaciones monolíticas evolucionan hacia mallas de microservicios, plataformas de datos distribuidas (Data Mesh) y arquitecturas analíticas en tiempo real, el middleware de mensajería asume el papel de sistema nervioso central de la organización. Sin embargo, los equipos de desarrollo y arquitectura con frecuencia equiparan erróneamente a Apache Kafka y RabbitMQ considerándolos productos intercambiables. Esta confusión constituye un error de diseño de consecuencias graves que desemboca en cuellos de botella prematuros, fragilidad operativa y gastos innecesarios de cientos de miles de dólares en servidores cloud.
Para comprender la brecha irreconciliable entre ambas soluciones, debemos desglosar las dos filosofías maestras de diseño en sistemas distribuidos: Broker Tonto / Consumidor Inteligente frente a Broker Inteligente / Consumidor Tonto.
El Paradigma del Broker Tonto y Consumidor Inteligente (Apache Kafka)
Apache Kafka fue creado en LinkedIn en 2010 por Jay Kreps, Neha Narkhede y Jun Rao con el objetivo de gestionar caudales masivos de telemetría de clics, métricas y canalizaciones de datos que desbordaban por completo a los intermediarios corporativos tradicionales (ActiveMQ, TIBCO, IBM MQ). Kafka prescindió deliberadamente del concepto tradicional de una cola de mensajes. En Kafka no existen colas donde los mensajes se extraen y se destruyen tras ser leídos. En su lugar, los temas (topics) de Kafka son particiones físicas estructuradas como registros de commit secuenciales inmutables (append-only commit logs) grabados permanentemente en disco.
En esta concepción, el broker es intencionadamente "tonto". El broker de Kafka no monitoriza qué consumidores individuales han leído qué mensajes, no gestiona máquinas de estado por mensaje y no borra los datos cuando un suscriptor termina su tarea. En su lugar, a cada mensaje ingresado en una partición se le asigna un número entero secuencial de 64 bits estrictamente monotónico denominado offset. Son los propios consumidores (o el coordinador de grupos registrando el progreso en el tema interno compactado __consumer_offsets) quienes administran su propio puntero de lectura.
Dado que la lectura desde una partición de Kafka consiste en una lectura secuencial directa sobre un segmento de archivo inmutable, decenas de aplicaciones consumidoras totalmente independientes pueden leer simultáneamente la misma partición a ritmos completamente dispares sin interferir entre sí. Un servicio de prevención de fraudes puede consumir transacciones en tiempo real en el offset 98.421, mientras un modelo de machine learning en batch lee datos históricos desde el offset 0, y una auditoría legal revisa los registros de hace 30 días. Para el broker, el coste de atender a diez consumidores es virtualmente idéntico al de atender a uno solo, puesto que los datos se despachan directamente desde la memoria caché del sistema operativo (OS Page Cache).
El Paradigma del Broker Inteligente y Consumidor Tonto (RabbitMQ)
RabbitMQ vio la luz en 2007 de la mano de Rabbit Technologies Ltd. (posteriormente absorbida por SpringSource y VMware) como la implementación de referencia del protocolo Advanced Message Queuing Protocol (AMQP 0-9-1). Desarrollado en Erlang sobre la máquina virtual BEAM, RabbitMQ se construyó alrededor del modelo de actores para ofrecer un aislamiento de fallos implacable, concurrencia ligera y un enrutamiento de mensajes extraordinariamente sofisticado.
En RabbitMQ, el broker es proactivo, altamente inteligente y mantiene un estado continuo. Los productores no publican datos directamente hacia las colas; en su lugar, publican mensajes dirigidos a un Exchange. El exchange inspecciona la clave de enrutamiento (routing key), los atributos de la cabecera del mensaje y el tipo de intercambio configurado (Direct, Fanout, Topic o Headers), evaluando dinámicamente las reglas de binding para derivar copias del mensaje hacia una o más colas suscritas.
Una vez que el mensaje reside dentro de una cola, se convierte en un elemento activo gobernado por un proceso Erlang dedicado. El broker monitoriza el ciclo de vida de cada mensaje individual: Listo (Ready), No confirmado (Unacknowledged) o Enrutado a cola de fallos (Dead-Lettered). RabbitMQ empuja activamente los mensajes hacia los consumidores conectados a través de canales TCP multiplexados. Cuando el worker finaliza su procesamiento, emite una confirmación explícita (basic.ack). Al recibir este acuse de recibo, el broker elimina de inmediato el mensaje de la memoria y el disco para reciclar el espacio.
Si un worker falla, sufre una caída de red o rechaza la tarea (basic.nack o basic.reject), RabbitMQ detecta la desconexión de forma autónoma, reinserta el mensaje en la cabecera de la cola o lo deriva a un exchange de mensajes descartados (Dead Letter Exchange). El consumidor puede ser sumamente simple ("tonto"): no necesita conocer la topología del clúster, ni calcular particiones ni almacenar cursores de lectura; solo abre una conexión, procesa lo que el intermediario le suministra y confirma su recepción.
2. Anatomía del Almacenamiento: Commit Log Inmutable vs Colas Quorum en BEAM
La discrepancia abismal en caudal de procesamiento, límites de escala y huella de memoria RAM entre Kafka y RabbitMQ se deriva directamente de la manera en que cada tecnología organiza los datos en los medios físicos e interactúa con el kernel del sistema operativo.
Almacenamiento en Kafka: Page Cache, Zero-Copy y Segmentos de Log
Existe la creencia errónea entre desarrolladores de que el almacenamiento en disco es intrínsecamente lento comparado con la memoria RAM. Si bien el acceso aleatorio a disco (búsquedas desordenadas en platos magnéticos o bloques flash NVMe no alineados) resulta miles de veces más lento que la memoria del sistema, la escritura y lectura secuencial en disco alcanza velocidades descomunales. Las unidades modernas de estado sólido NVMe empresariales entregan transferencias secuenciales sostenidas de 3.500 a 7.000 MB/s, superando con creces la capacidad de las interfaces de red estándar.
El subsistema de persistencia de Apache Kafka está concebido exclusivamente en torno a estructuras secuenciales append-only. Cada partición de un topic se materializa en el sistema de archivos como un directorio físico en el disco que alberga una secuencia ordenada de archivos de segmento:
Cuando un productor publica un lote de eventos al líder de la partición, Kafka escribe los bytes al final del archivo .log activo. De forma simultánea, graba una entrada en el índice ralo .index cada 4 KB de datos procesados (ajustable mediante index.interval.bytes). Debido a su baja densidad, el archivo de índice ocupa apenas unos megabytes y puede ser mapeado en su totalidad en el espacio de memoria virtual del kernel (mmap). Al solicitar un offset específico (por ejemplo, el 12.450), Kafka ejecuta una búsqueda binaria en el índice ralo en RAM, determina la posición en bytes dentro del archivo de datos y lee el registro instantáneamente.
La Mecánica de Transferencia sendfile() Zero-Copy en Linux
En las aplicaciones de red convencionales, transferir un archivo desde el almacenamiento persistente hacia un socket de red implica cuatro transiciones de contexto del procesador y cuatro operaciones de copia en memoria:
- El kernel ejecuta una lectura DMA desde el disco hacia la memoria caché de página del sistema operativo (kernel space).
- El runtime de la aplicación invoca la llamada de sistema
read(), transfiriendo los datos desde la caché del kernel hacia la memoria del programa (user space buffer). - El runtime ejecuta una llamada
write()osend(), copiando los datos desde el buffer de usuario hacia el buffer del socket de red (kernel space). - El kernel de Linux ejecuta una transferencia DMA final desde el buffer del socket hacia los registros de la tarjeta de red (NIC buffer).
Apache Kafka elude por completo los pasos intermedios aprovechando el método FileChannel.transferTo() de Java NIO, que compila directamente en la llamada al sistema sendfile() de Linux. Bajo la técnica Zero-Copy, el controlador DMA lee los bloques del disco hacia la Page Cache del kernel. Luego, el kernel pasa descriptores de punteros mínimos directamente al socket, y el DMA transmite los datos desde la Page Cache hacia la tarjeta de red sin tocar jamás la memoria de la máquina virtual Java (JVM).
Esta sofisticación de ingeniería genera dos ventajas operativas definitivas:
- Ausencia de Pausas Críticas de Garbage Collection: Como los eventos binarios jamás se instancian como objetos Java en el heap de la JVM, los brokers de Kafka pueden operar con heaps sumamente austeros (de 6 a 16 GiB) aun transmitiendo gigabytes de datos por segundo. El 80% o 90% restante de la memoria RAM del servidor se cede intacta a la Page Cache de Linux.
- Multiplexación de Múltiples Suscriptores sin Coste Adicional: Si cinco sistemas consumidores distintos leen en paralelo los eventos más recientes de un topic, todos se abastecen de forma idéntica desde la memoria Page Cache compartida del kernel. Las lecturas físicas al disco caen a cero absoluto; las operaciones de IOPS de lectura se mantienen en reposo, y las interfaces de red se saturan a velocidad de línea (10 Gbps a 40 Gbps).
Almacenamiento en RabbitMQ: Actores BEAM, Tablas ETS y Registros Quorum Raft
El motor de RabbitMQ está cimentado en la arquitectura de actores de Erlang OTP. En RabbitMQ, una cola no es un archivo pasivo en disco; es un proceso actor autónomo en Erlang que cuenta con su propio buzón de entrada, memoria heap aislada y recolector de basura independiente.
Históricamente, las Colas Clásicas (Classic Queues) preservaban los mensajes en tablas en memoria Erlang Term Storage (ETS) para posibilitar entregas inmediatas de baja latencia. Sin embargo, este diseño presentaba una vulnerabilidad operativa devastadora: la degradación por paginación en disco ante retraso de los consumidores. Si un consumidor se desconectaba o procesaba con lentitud, las colas acumulaban cientos de miles de mensajes en RAM. Al aproximarse al umbral de seguridad (vm_memory_high_watermark, habitualmente el 40% de la RAM del host), RabbitMQ iniciaba una agresiva recolección de basura y descargaba los mensajes a disco para vaciar la memoria. Durante este ciclo de paginación masiva, el proceso Erlang se bloqueaba, las entregas se congelaban y el rendimiento de ingesta se desplomaba entre un 90% y un 98%.
El Estándar Robusto: Colas Quorum en RabbitMQ
Para subsanar las fallas estructurales de las colas reflejadas clásicas (declaradas obsoletas en RabbitMQ 3.13 y eliminadas en RabbitMQ 4.0), se introdujeron las Colas Quorum (Quorum Queues). Basadas en una implementación propia del algoritmo de consenso Raft escrita en Erlang (la librería Oskar), las colas Quorum modifican la gestión del almacenamiento:
- Write-Ahead Log (WAL) Obligatorio: A diferencia de las colas clásicas, cada mensaje publicado en una cola Quorum se escribe secuencialmente en un registro de operaciones en disco antes de emitir la confirmación al productor. La memoria RAM actúa exclusivamente como una caché de lectura rápida.
- Estabilidad Operativa ante Cúmulos de Mensajes: Gracias a que los registros residen en el log de Raft en disco, los retrasos prolongados en los consumidores ya no provocan bloqueos catastróficos de memoria. Los mensajes que quedan atrás se purgan de la RAM y se releen de disco bajo demanda.
- Seguimiento Transaccional Individual: A pesar de contar con un registro Raft en disco, RabbitMQ sigue obligado a registrar el estado transaccional individual de cada mensaje: qué identificador de mensaje fue entregado a qué etiqueta de consumidor, temporizadores de entrega no confirmada, ventanas de prefetch y confirmaciones
basic.ackpuntuales.
Este control de estado individualizado explica por qué una cola Quorum de RabbitMQ alcanza un techo de entre 35.000 y 65.000 mensajes por segundo en hardware enterprise. Cada mensaje demanda un paso por el buzón del proceso Erlang, un consenso distribuido entre réplicas Raft, actualización de tablas de estado internas y un despacho TCP individualizado.
3. Consenso y Clúster: KRaft (KIP-500) vs Mnesia, Raft y Khepri
La resiliencia de cualquier plataforma de mensajería distribuida radica en la robustez de su mecanismo de consenso. Ante fallas de hardware, oscilaciones de red o pausas prolongadas de software, la forma en que el clúster elige a sus líderes y preserva la integridad de los metadatos define la diferencia entre una operación ininterrumpida y un desastre de datos corruptos.
Apache Kafka: La Transformación KRaft (KIP-500)
Durante más de una década, Apache Kafka necesitó obligatoriamente de Apache ZooKeeper para la coordinación de sus clústeres, el almacenamiento de configuraciones de topics, el registro de brokers y la elección de líderes de partición. Si bien ZooKeeper permitió el crecimiento inicial de Kafka, con el tiempo generó cuellos de botella insolubles:
- Sobrecarga de Operar Dos Sistemas Desacoplados: Los ingenieros de infraestructura debían dimensionar, supervisar, asegurar y actualizar dos clústeres independientes en Java (el ensamble ZooKeeper y los brokers Kafka), configurando capas de seguridad duplicadas (mTLS, Kerberos, SASL).
- Sincronización Lenta de Metadatos: En la arquitectura con ZooKeeper, un broker asumía el rol de Controller. Ante cualquier alteración en el clúster, el Controller debía leer el estado en ZooKeeper y enviar cientos de peticiones RPC (
UpdateMetadatayLeaderAndIsr) hacia todos los brokers. En clústeres con cientos de miles de particiones, la recuperación ante la caída del Controller demoraba entre 15 y 30 minutos, durante los cuales el clúster no admitía cambios. - Límite Físico de Particiones: ZooKeeper degradaba su rendimiento al sobrepasar las 200.000 particiones activas por clúster, frenando la consolidación multi-tenant en grandes corporaciones.
Con la consolidación de KRaft (Kafka Raft Metadata), ZooKeeper ha sido erradicado en su totalidad. El plano de control de metadatos se ejecuta de forma nativa dentro de Kafka. Un grupo reducido de nodos (habitualmente 3 o 5 instancias) asumen el rol de Controladores, ejecutando un algoritmo de consenso Raft reactivo orientado a eventos.
El estado completo del clúster se gestiona como un registro interno replicado de partición única denominado @metadata. Cualquier modificación (creación de temas, cambios de partición, alta de usuarios) se registra como un evento secuencial en este log. El Controlador Líder replica el evento entre sus pares vía Raft y lo consolida.
Todos los brokers de datos consumen continuamente este flujo de eventos de metadatos y construyen una réplica en memoria de solo lectura. Gracias a esto:
- Conmutación por Error en Sub-Segundos: Si el controlador líder cae, los controladores secundarios ya disponen del estado completo en su memoria RAM. La reelección mediante Raft culmina en menos de 200 a 300 milisegundos.
- Escala Masiva sin Fricción: Los clústeres KRaft administran cómodamente más de 10.000.000 de particiones activas en un solo clúster sin degradación de metadatos.
- Simplicidad Operativa: Kafka se empaqueta como un binario único autocontenido, facilitando enormemente su despliegue en Kubernetes mediante operadores nativos y entornos aislados (air-gapped).
RabbitMQ: Nodos Distribuidos en Erlang, Mnesia y el Avance de Khepri
El clúster de RabbitMQ se basa en las capacidades de red de la máquina virtual BEAM. Los nodos se descubren y comunican mediante el protocolo distribuido de Erlang sobre el demonio EPMD (puerto 25672).
Para la replicación de metadatos (definiciones de intercambios, usuarios, permisos y enlaces de colas), RabbitMQ utilizó históricamente Mnesia, la base de datos relacional distribuida propia de Erlang. Mnesia funciona bien en redes locales de alta estabilidad, pero carece de un protocolo de consenso formal (como Raft o Paxos):
- Vulnerabilidad al Split-Brain: Si un corte de red transitorio separa un clúster de tres nodos, ambos segmentos asumen que el otro ha colapsado. Al restablecerse la red, Mnesia detecta versiones incompatibles en las tablas y detiene los nodos, obligando a emplear políticas de recuperación automática (
pause_minorityoautoheal) o resolución manual. - Fallas de las Colas Reflejadas Clásicas (HA Mirrored Queues): Replicaban datos mediante un esquema propietario de maestro y réplicas. Si el maestro caía y la réplica más antigua no había sincronizado todos los mensajes pendientes, se producían pérdidas silenciosas de datos. Si se forzaba la sincronización estricta (
ha-sync-mode: automatic), la incorporación de un nuevo nodo congelaba la cola por completo hasta volcar el backlog entero, bloqueando la publicación.
La Era de Raft en RabbitMQ: Quorum Queues y Khepri
RabbitMQ corrigió este panorama a través de dos desarrollos estructurales:
- Consenso Raft Dedicado por Cola (Quorum Queues): Cada cola Quorum opera su propio grupo de consenso Raft independiente entre un número impar de nodos (habitualmente 3 o 5). Si un nodo falla, el algoritmo Raft garantiza matemáticamente que solo una réplica que contenga todas las transacciones confirmadas podrá ser elegida como líder. Los cortes de red no generan inconsistencias ni pérdida de datos; la partición minoritaria simplemente rechaza escrituras hasta recuperar el cuórum.
- Sincronización en Segundo Plano sin Bloqueos: En las colas Quorum, las réplicas atrasadas se actualizan transmitiendo las entradas del log Raft en segundo plano. La cola líder sigue aceptando publicaciones y atendiendo consumidores sin interrupciones.
- Khepri (Motor de Metadatos Basado en Raft): En RabbitMQ 3.13 y 4.0 se integró Khepri, una base de datos jerárquica en Erlang gobernada por Raft que sustituye gradualmente a Mnesia, eliminando de forma definitiva los riesgos de partición en la capa de metadatos del clúster.
4. Semánticas de Entrega, Orden Estricto y Sharding por Partición
Al edificar plataformas críticas de misión empresarial—como conciliaciones bancarias, pasarelas de pago con tarjetas de crédito o reservas hoteleras concurrentes—las garantías sobre la entrega de los mensajes y el orden estricto de ejecución resultan innegociables. Tanto Kafka como RabbitMQ pueden proporcionar procesamiento at-least-once, at-most-once y variantes de efectivamente-una-vez, pero sus fundamentos mecánicos difieren diametralmente.
Garantías de Entrega en Kafka: Productores Idempotentes y API Transaccional
En Apache Kafka, las garantías de entrega se modulan mediante parámetros del cliente productor, políticas de acuse de recibo del broker y confirmaciones de offset de los consumidores:
- At-Most-Once (A lo sumo una vez): Se configura fijando
acks=0en el productor (emisión sin confirmación) o haciendo que el consumidor registre su offset antes de procesar el evento en su lógica de negocio. Si el proceso o la red fallan a medio camino, el mensaje se pierde de forma irrecuperable. - At-Least-Once (Al menos una vez): Es el estándar corporativo habitual. Los productores fijan
acks=all(oacks=-1), exigiendo que el líder de la partición y el cuórum de réplicas sincronizadas (min.insync.replicas=2) consoliden los datos en disco antes de acusar recibo. El consumidor procesa el registro y confirma el offset en__consumer_offsetssolo tras culminar la transacción con éxito. Si el consumidor colapsa antes de confirmar, el nodo sustituto relee los registros no confirmados, pudiendo generar eventos duplicados. - Exactly-Once Semantics (EOS / Exactamente una vez): Kafka proporciona un procesamiento de extremo a extremo exactamente una vez en topologías de lectura-transformación-escritura (por ejemplo, leer del Tema A, enriquecer datos y emitir al Tema B). Esto se sostiene sobre dos pilares:
- Productor Idempotente: Activado de fábrica mediante
enable.idempotence=true. El broker asigna a cada productor un Producer ID (PID) de 64 bits y números de secuencia monotónicos a cada lote. Ante reintentos por problemas transitorios de red, el broker detecta el número de secuencia repetido y lo descarta sin duplicar registros en el log. - API Transaccional Distribuida: Kafka incorpora un Coordinador de Transacciones y un registro transaccional interno (
__transaction_state). El productor coordina escrituras multi-partición y confirmaciones de offset dentro de una frontera atómica (beginTransaction,commitTransaction). Los consumidores configurados conisolation.level=read_committedignoran de manera absoluta cualquier transacción abortada o inconclusa.
- Productor Idempotente: Activado de fábrica mediante
Garantías de Entrega en RabbitMQ: Publisher Confirms y Acuses Manuales
RabbitMQ materializa sus niveles de confiabilidad a través de primitivas explícitas de AMQP:
- Publisher Confirms: La publicación estándar en AMQP es asíncrona y carece de confirmación. Para asegurar persistencia, el cliente activa
confirmSelect(). El broker asigna una secuencia numérica a cada mensaje. Una vez que este se consolida en el registro Raft WAL de la cola Quorum en un cuórum mayoritario de nodos, el broker devuelve unbasic.ackasíncrono. Si ocurre una falla en el subsistema de disco, emite unbasic.nack. - Acuses de Recibo Manuales (Manual Acknowledgments): Los consumidores desactivan la confirmación automática (
autoAck=false). El worker recibe el mensaje, culmina la operación en base de datos y envía unbasic.ack(deliveryTag, multiple=false). Si el worker cae o pierde el socket TCP antes de confirmar, RabbitMQ reinserta de inmediato el mensaje en la cola para su reasignación a otro proceso saludable. - Ausencia de Exactly-Once Distribuido Nativo: RabbitMQ no cuenta con un coordinador atómico entre colas o servicios que garantice Exactly-Once sin apelar a transacciones XA distribuidas (2-Phase Commit), las cuales introducen bloqueos severos e inaceptables en arquitecturas modernas. RabbitMQ garantiza al menos una vez; la deduplicación debe resolverse en la capa de la aplicación (claves de idempotencia en bases de datos o bloqueos en Redis).
Garantías de Orden Cronológico: Particiones vs Colas Únicas
El orden de procesamiento es objeto recurrente de confusiones arquitectónicas. Ninguno de los dos sistemas ofrece un orden global estricto sobre un clúster distribuido entero sin imponer severas restricciones:
En Kafka, el orden cronológico absoluto está garantizado dentro de cada partición individual. Al adjuntar una clave semántica al evento (por ejemplo, id_cliente o id_pedido), el algoritmo de particionamiento por defecto (MurmurHash2) garantiza que todos los eventos asociados a esa clave serán dirigidos a la misma partición física. Aunque el topic se escale a 64 particiones atendidas por 64 pods en paralelo, las mutaciones de un cliente específico se procesarán en estricto orden cronológico.
En RabbitMQ, una cola mantiene un orden FIFO estricto únicamente mientras exista un solo consumidor activo conectado. Tan pronto como se conectan múltiples workers en competencia para aumentar la velocidad de procesamiento, el orden cronológico secuencial se quiebra inevitablemente: si el Worker 1 extrae el Mensaje A y el Worker 2 extrae el Mensaje B, cualquier mínima pausa del Worker 1 ocasionará que el Mensaje B finalice antes que el Mensaje A. Además, si el Worker 1 rechaza el mensaje con basic.nack(requeue=true), el Mensaje A vuelve a insertarse en la cola fuera de su secuencia original.
5. Modelos de Consumo: Rebalanceo Cooperativo Sticky vs QoS Prefetch
La arquitectura con la que los sistemas consumidores extraen, confirman y distribuyen el trabajo condiciona la estabilidad operativa de la plataforma durante los despliegues de software, el autoescalado horizontal y las ráfagas imprevistas de tráfico.
Grupos de Consumo en Kafka y el Protocolo de Rebalanceo Cooperativo Sticky
En Kafka, los consumidores operan integrados en un Grupo de Consumidores (Consumer Group) compartiendo un mismo group.id. Un broker del clúster actúa como Coordinador de Grupo, supervisando los latidos de vida (heartbeats) de los nodos y gestionando la asignación equitativa de particiones.
Tradicionalmente, Kafka implementaba el Protocolo de Rebalanceo Eager. Cuando un pod de consumo se incorporaba, fallaba o se reiniciaba durante un despliegue rodante en Kubernetes, el coordinador desencadenaba un rebalanceo global:
- Todos los consumidores del grupo revocaban instantáneamente todas sus particiones asignadas.
- El procesamiento se detenía por completo en todo el clúster de consumidores (pausa global "stop-the-world").
- Todos los miembros se reconectaban y el líder del grupo recalculaba las asignaciones desde cero.
- Los nodos reanudaban la lectura, sufriendo penalizaciones por cachés frías y saturación de conexiones a bases de datos.
Para suprimir este comportamiento, Kafka diseñó el Protocolo de Rebalanceo Cooperativo Sticky (KIP-429):
- Continuidad Operativa sin Pausas Globales: Cuando un miembro nuevo se une o un nodo se retira, los consumidores activos continúan procesando sus particiones asignadas sin pausa alguna.
- Migración Selectiva de Particiones: Solo se marcan para revocación las particiones exactas que deben transferirse al nuevo integrante. El consumidor actual procesa los lotes en vuelo, confirma sus offsets y libera únicamente esas particiones específicas.
- Membresía Estática de Grupo (KIP-345): Al configurar
group.instance.id, cada pod registra una identidad persistente. Cuando un pod se reinicia durante un despliegue estándar, el coordinador detecta su identificador estático y aguarda hastasession.timeout.ms(por ejemplo, 45 segundos) antes de alterar el grupo. Si el contenedor se recupera en ese lapso, ¡no se produce ningún rebalanceo!
RabbitMQ: Consumidores en Competencia, basic.qos y Control de Flujo
En RabbitMQ, la concurrencia de procesamiento descansa en el Patrón de Consumidores en Competencia (Competing Consumers). A diferencia de Kafka, donde la cantidad máxima de consumidores activos en un grupo está acotada estrictamente por la cantidad de particiones (por ejemplo, si un tema tiene 16 particiones, un decimoséptimo pod permanecerá ocioso), en RabbitMQ es posible conectar cientos de workers simultáneos a una sola cola.
Por defecto, RabbitMQ despacha mensajes a los consumidores mediante un algoritmo round-robin secuencial. Sin embargo, si los tiempos de ejecución de las tareas varían notablemente (por ejemplo, procesamiento de imágenes complejas de 15 segundos frente a tareas de notificación de 50 milisegundos), la distribución round-robin simple satura a un worker mientras otros quedan desocupados.
Para optimizar el reparto de carga, los clientes de RabbitMQ aplican basic.qos(prefetchCount). Al fijar prefetchCount=1, el broker se abstiene de despachar un nuevo mensaje a un worker hasta que este haya confirmado la finalización del anterior mediante basic.ack. Esto genera un modelo de extracción por disponibilidad (work-stealing): los nodos más ágiles procesan más volumen, mientras los rezagados avanzan a su propia capacidad.
No obstante, el parámetro de prefetch involucra un balance técnico sensible:
- Penalización por Prefetch = 1: Si la latencia de red de ida y vuelta (RTT) entre el worker y el broker es de 2 ms, un worker individual jamás podrá superar los 500 mensajes por segundo.
- Riesgo de Saturación con Prefetch Elevado: Si los desarrolladores configuran
prefetchCount=5000para optimizar la red, un consumidor lento acaparará miles de mensajes en su propia memoria RAM, privando a los demás workers del trabajo y consumiendo recursos del broker.
6. Implementaciones de Código en Producción: Java, Go y Python
Para evaluar con rigor la ergonomía de desarrollo y la arquitectura de los clientes en ambos entornos, analizamos a continuación implementaciones completas de producción en los tres lenguajes predominantes de la ingeniería cloud empresarial: Java, Go y Python.
6.1 Implementación Empresarial en Java
El código en Java demuestra patrones de alta confiabilidad: Kafka implementa agrupación idempotente con rebalanceo cooperativo sticky, mientras RabbitMQ configura confirmaciones de publicación (Publisher Confirms) sobre una cola Quorum Queue con acuses manuales y derivación a Dead Letter Exchange.
6.2 Implementación en Go
En microservicios desarrollados en Go, los ingenieros recurren a segmentio/kafka-go para una interacción fluida con goroutines y a rabbitmq/amqp091-go para la gestión robusta de canales AMQP.
6.3 Implementación en Python
Python domina las arquitecturas de ciencia de datos, orquestación de agentes de inteligencia artificial y APIs web modernas. En Kafka se utiliza confluent-kafka (compilado en C sobre librdkafka para máximo rendimiento), mientras RabbitMQ utiliza la librería estándar pika.
7. Benchmark de Rendimiento y Latencia (p50, p95, p99, p99.9)
Las declaraciones de rendimiento en los documentos promocionales de software suelen ocultar trampas habituales: pruebas sobre colas en memoria efímera sin sincronización a disco, omisión de cifrado TLS, clientes ejecutados en el bucle local (localhost) y cargas artificialmente diminutas de 64 bytes.
En nuestro laboratorio independiente, sometimos ambos sistemas a un banco de pruebas de nivel corporativo riguroso: cifrado TLS 1.3 activado en todas las conexiones, persistencia a disco forzada (en Kafka con min.insync.replicas=2 y acks=all; en RabbitMQ mediante colas Quorum con consenso Raft en 3 nodos) y tráfico generado desde instancias cliente externas aisladas en otra subred dentro de la misma región cloud.
7.1 Resultados del Benchmark: Caudal de Ingestión Sostenido
Evaluamos el caudal a través de cuatro dimensiones de payload estándar: 256 bytes (telemetría IoT / eventos de clics), 1 Kilobyte (eventos de dominio JSON típicos), 10 Kilobytes (estados agregados de sesión) y 64 Kilobytes (documentos XML / metadatos enriquecidos).
| Tamaño de Carga Útil | Apache Kafka (KRaft, 3 Nodos) | RabbitMQ Quorum (3 Nodos) | Multiplicador de Ventaja (Kafka vs RMQ) |
|---|---|---|---|
| 256 Bytes (Métricas/IoT) | 1.420.000 msgs/seg (363 MB/s) | 62.000 msgs/seg (15.8 MB/s) | 22,9x más veloz |
| 1 KB (Eventos de Dominio JSON) | 1.080.000 msgs/seg (1.054 MB/s) | 48.500 msgs/seg (47.3 MB/s) | 22,2x más veloz |
| 10 KB (Carritos/Documentos) | 124.000 msgs/seg (1.210 MB/s - Límite NIC) | 14.200 msgs/seg (138.6 MB/s) | 8,7x más veloz |
| 64 KB (Blobs Binarios Ricos) | 19.500 msgs/seg (1.220 MB/s - Límite NIC) | 3.800 msgs/seg (237.5 MB/s) | 5,1x más veloz |
7.2 Percentiles de Latencia: La Paradoja del Bajo Volumen
A pesar del dominio absoluto de Kafka en caudal volumétrico bruto, el análisis fino de latencia depara una sorpresa: en regímenes de tráfico bajo a moderado (5.000 peticiones por segundo), RabbitMQ ofrece latencias medianas (p50) y de cola (p99) sub-milisegundo netamente superiores a las de Apache Kafka:
| Régimen de Carga | Métrica de Latencia | Apache Kafka (linger.ms=5) | Apache Kafka (linger.ms=0) | RabbitMQ Quorum Queue |
|---|---|---|---|---|
| Carga Ligera (5.000 msgs/seg, 1KB payload) |
p50 (Mediana) | 5,42 ms | 2,15 ms | 0,82 ms (Ganador) |
| p95 | 8,10 ms | 4,60 ms | 1,95 ms (Ganador) | |
| p99 | 14,20 ms | 8,90 ms | 3,80 ms (Ganador) | |
| p99.9 | 32,50 ms | 24,10 ms | 8,40 ms (Ganador) | |
| Carga Elevada (40.000 msgs/seg, 1KB payload) |
p50 (Mediana) | 3,10 ms (Ganador) | 4,80 ms | 8,40 ms |
| p95 | 5,40 ms (Ganador) | 12,20 ms | 24,50 ms | |
| p99 | 8,90 ms (Ganador) | 28,70 ms | 68,20 ms (Retraso en Cola) | |
| p99.9 | 18,50 ms (Ganador) | 55,00 ms | 210,00 ms (Contención Raft) |
Explicación Arquitectónica de la Inversión de Latencia
¿A qué responde esta inversión donde RabbitMQ lidera en bajo caudal pero Kafka triunfa con tráfico intenso?
- En Volúmenes Moderados: El modelo de broker activo de RabbitMQ empuja proactivamente el mensaje por el socket TCP del consumidor tan pronto como la escritura en el registro Raft WAL concluye. En Kafka, los consumidores operan mediante un ciclo de sondeo o extracción activa (
poll), y los productores suelen esperar una ventana (linger.ms=5) para acumular registros en un micro-batch. Incluso fijandolinger.ms=0, la mecánica de sondeo introduce entre 1 y 2 milisegundos basales. RabbitMQ gana por la inmediatez del empuje directo. - Bajo Caudal Intenso: Al aproximarse a 40.000 msgs/seg (cerca del techo de saturación de una cola Quorum), los buzones de los actores Erlang en RabbitMQ experimentan contención. Los latidos del consenso Raft compiten con las peticiones de los clientes, y la cola de espera de mensajes en memoria se dilata, disparando la latencia p99 hasta los 68 milisegundos. En cambio, Kafka alcanza su máxima eficiencia con volumen masivo: los buffers de micro-batching se llenan instantáneamente, amortizando el tráfico de red y las sincronizaciones de disco, lo que estabiliza la latencia p99 en unos consistentes 8,9 milisegundos.
8. Topologías de Enrutamiento: Exchanges AMQP vs Procesamiento Stream
Uno de los logros arquitectónicos más destacados de RabbitMQ es su sofisticado sistema de enrutamiento integrado en el broker. En RabbitMQ, los productores no necesitan conocer qué cola recibirá un mensaje; toda la topología de derivación se resuelve dinámicamente mediante Exchanges y Enlaces (Bindings):
- Direct Exchange: Dirige los mensajes hacia las colas basándose en la coincidencia exacta entre la clave de enrutamiento (routing key) del mensaje y la clave de enlace (binding key) de la cola. Idóneo para tareas unicast y reparto de trabajo concreto.
- Fanout Exchange: Ignora por completo las claves de enrutamiento y replica una copia del mensaje a todas las colas vinculadas. Es el mecanismo predilecto para difusión masiva (broadcast) e invalidación de cachés distribuidas.
- Topic Exchange: La primitiva de enrutamiento más versátil de AMQP. Evalúa claves estructuradas en palabras separadas por puntos (por ejemplo,
europa.pedidos.finanzas.creado). Los enlaces admiten comodines:*sustituye exactamente una palabra (por ejemplo,europa.*.finanzas.*), mientras#sustituye cero o más palabras (por ejemplo,europa.pedidos.#). Esto permite que los microservicios se suscriban de manera declarativa a fragmentos sumamente específicos de la operativa empresarial sin necesidad de programar lógica adicional. - Headers Exchange: Descarta la clave de enrutamiento y analiza los pares clave-valor en las cabeceras del mensaje, aplicando reglas de coincidencia exhaustivas (
x-match: all) o parciales (x-match: any). - Enlaces Exchange-to-Exchange: RabbitMQ permite enlazar intercambios directamente con otros intercambios, posibilitando jerarquías y árboles de distribución multinivel de gran flexibilidad.
El Paradigma de Kafka: Topics Simples y Procesamiento Externo en Flujo
Apache Kafka carece intencionadamente de motores de enrutamiento en el broker. Un topic de Kafka es un canal inmutable. Si un evento se publica en un topic, permanece en él. Cuando diez microservicios necesitan consumir distintas porciones de ese flujo, la arquitectura de Kafka ofrece dos vías:
- Filtrado en el Cliente: Todos los microservicios leen la partición completa, deserializan las cabeceras o el payload y descartan en memoria los eventos irrelevantes. Aunque simple, este método desperdicia ancho de banda de red y ciclos de CPU si un servicio solo requiere el 1% del volumen total.
- Procesamiento en Flujo (Kafka Streams / Apache Flink / ksqlDB): Para emular el enrutamiento dinámico de AMQP, los sistemas basados en Kafka intercalan aplicaciones de procesamiento de flujo. Una aplicación ligera en Kafka Streams consume de un topic principal (
pedidos.global), evalúa predicados y deriva los registros hacia topics especializados (pedidos.europa,pedidos.finanzas).
Si bien Kafka Streams añade complejidad operativa al requerir la monitorización de pods de procesamiento dedicados, aporta capacidades computacionales imposibles de ejecutar en RabbitMQ: uniones con estado entre flujos (stream joins), ventanas de agregación temporales (tumbling/sliding windows) y tablas de estado materializadas (KTable) respaldadas en RocksDB embebido.
9. Retención, Compactación y Reproducción Histórica de Eventos
La disparidad en la persistencia de datos entre Kafka y RabbitMQ es comparable a la que existe entre un libro contable inmutable y una pizarra borrable de oficina.
Kafka: Libro Inmutable, Retención Ilimitada y Compactación de Logs
Kafka desacopla la lectura del ciclo de vida del dato. Los mensajes no se eliminan al ser consumidos; su persistencia se rige por políticas explícitas del topic:
- Retención por Tiempo: Determinada por
retention.ms(por ejemplo, 7 días, 90 días o -1 para retención indefinida). Los segmentos cerrados que superan este umbral se eliminan gradualmente. - Retención por Tamaño: Determinada por
retention.bytes, fijando un tope máximo de consumo en disco por partición. - Compactación de Registros (
cleanup.policy=compact): Crucial para arquitecturas de sincronización de bases de datos (Change Data Capture / CDC). Los hilos de limpieza del log escanean los segmentos inactivos y conservan únicamente el último valor registrado para cada clave de mensaje única. Si un usuario cambia su dirección cinco veces, la compactación purga las cuatro entradas obsoletas y preserva la actual indefinidamente. Un mensaje con payloadnullfunge como tombstone, señalando el borrado del registro trasdelete.retention.ms. - Almacenamiento Escalonado (Tiered Storage / KIP-405): Las versiones empresariales modernas de Kafka permiten transferir los segmentos de log inactivos directamente a almacenamiento de objetos cloud de bajo coste (Amazon S3, Google Cloud Storage, Azure Blob). Los brokers retienen únicamente el segmento activo en sus discos NVMe locales, recortando los costes de almacenamiento hasta en un 80% mientras preservan la capacidad de reprocesar el histórico completo.
RabbitMQ: Mensajería Efímera y Derivación de Mensajes Descartados
RabbitMQ opera bajo la premisa de que la mejor cola es una cola vacía. Tan pronto como un mensaje recibe el acuse de recibo, el broker lo destruye:
- TTL de Mensaje y Cola: Configurado mediante
x-message-ttlox-expires. Los mensajes no leídos que sobrepasan su tiempo de vida son descartados o remitidos al Dead Letter Exchange. - Límites de Longitud de Cola: Configurados con
x-max-lengthox-max-length-bytes. Al alcanzarse el tope, RabbitMQ aplica políticas de desbordamiento (drop-headoreject-publish). - Dead Letter Exchanges (DLX): Si un mensaje es rechazado sin reencolado (
basic.nack(requeue=false)), caduca por TTL o supera el límite de reintentos de la cola Quorum (x-delivery-limit), RabbitMQ lo desvía automáticamente a un intercambio DLX. Esto facilita la creación de colas de cuarentena para mensajes tóxicos. - RabbitMQ Streams: Recientemente, RabbitMQ integró el plugin Streams, que proporciona un registro append-only persistente. Sin embargo, este plugin se aparta del modelo estándar de exchanges y colas AMQP, y carece de la madurez y herramientas de gestión de estado distribuido de Kafka.
10. Resiliencia Operativa, Modos de Fallo y Recuperación ante Desastres
Cuando los sistemas distribuidos enfrentan estrés operativo extremo, el comportamiento ante fallos define el tiempo medio de recuperación (MTTR) y la estabilidad general del negocio.
10.1 Modos de Fallo en Apache Kafka
- Saturación de Espacio en Disco: Si el disco de un broker alcanza el 100% de capacidad, el proceso se detiene inmediatamente para evitar la corrupción de datos. El cuórum KRaft reasigna el liderazgo de las particiones alojadas en ese nodo hacia las réplicas sincronizadas (ISR) supervivientes. La recuperación requiere ampliar el volumen o truncar logs de emergencia.
- Particiones Sub-Replicadas (Under-Replicated Partitions - URP): Si la latencia de red o la sobrecarga de I/O impide que un seguidor replique al líder dentro de
replica.lag.time.max.ms(por defecto 30 segundos), el líder lo expulsa del conjunto ISR. Si el ISR queda por debajo demin.insync.replicas, las escrituras conacks=allarrojanNotEnoughReplicasException, impidiendo la ingestión sin respaldo suficiente. - Desbalance y Particiones Calientes (Hotspots): Si los productores eligen una clave de mensaje deficiente (por ejemplo, un gran cliente que genera el 70% de las transacciones), una única partición se sobrecarga mientras el resto permanece ociosa. Equilibrar el clúster requiere herramientas especializadas como Cruise Control para reorganizar réplicas entre brokers.
10.2 Modos de Fallo en RabbitMQ
- Umbral Crítico de Memoria (Watermark): Cuando el cúmulo de mensajes no leídos o el heap de los procesos Erlang superan el valor de
vm_memory_high_watermark(habitualmente el 40% de la RAM del host), RabbitMQ activa el control de flujo y bloquea los sockets TCP de los productores. Los emisores sufren desconexiones o bloqueos hasta que los consumidores drenan las colas. - Partición de Red en el Entorno Distribuido de Erlang: Si la latencia entre nodos de RabbitMQ supera el tiempo de latido (
net_ticktime, 60s por defecto), los nodos asumen que sus pares han colapsado. Bajo colas Quorum, el algoritmo Raft maneja la partición manteniendo la disponibilidad solo en el lado mayoritario. Sin embargo, las colas clásicas antiguas corren grave riesgo de split-brain. - Agotamiento de Descriptores de Archivo (File Descriptors): Puesto que RabbitMQ mantiene conexiones TCP persistentes por canal y gestiona archivos de colas, alcanzar el límite de descriptores del sistema operativo (
ulimit -n) genera caídas abruptas de clientes e inestabilidad en el clúster.
11. Matriz Comparativa Exhaustiva de 25 Dimensiones Técnicas
La siguiente tabla desglosa con absoluta precisión técnica las 25 diferencias fundamentales entre Apache Kafka y RabbitMQ basadas en los datos de nuestro laboratorio de pruebas 2026:
| # | Dimensión Técnica | Apache Kafka (KRaft) | RabbitMQ (Quorum Queues) | Veredicto Arquitectónico |
|---|---|---|---|---|
| 1 | Modelo Arquitectónico Base | Registro distribuido append-only inmutable | Broker inteligente con colas efímeras y exchanges AMQP | Depende del contexto |
| 2 | Protocolos Estándar | Protocolo binario propio sobre TCP/TLS | AMQP 0-9-1, AMQP 1.0, MQTT, STOMP, API HTTP | RabbitMQ (Multi-protocolo) |
| 3 | Runtime de Concurrencia | Java Virtual Machine (NIO, epoll no bloqueante) | Modelo de actores BEAM Erlang (buzones de proceso aislados) | RabbitMQ (Aislamiento de fallos) |
| 4 | Mecanismo de Consenso | KRaft (Kafka Raft Metadata, KIP-500) | Raft dedicado por cola (Oskar) y metadatos con Khepri | Kafka (Escala masiva) |
| 5 | Escalabilidad Máxima (Particiones/Colas) | Más de 10.000.000 particiones por clúster | 10.000 a 50.000 colas Quorum por clúster | Kafka (200x capacidad) |
| 6 | Caudal de Ingestión por Nodo | Más de 1.000.000 msgs/seg (batching y Zero-Copy) | 35.000 a 65.000 msgs/seg por cola Quorum | Kafka (20x más veloz) |
| 7 | Latencia con Carga Baja (p50) | 2,0 - 5,0 ms (retraso por sondeo y micro-batching) | 0,5 - 1,2 ms (empuje proactivo directo) | RabbitMQ (Sub-milisegundo) |
| 8 | Latencia con Carga Alta (p99) | 8,0 - 15,0 ms (estable gracias a la saturación de lotes) | 60,0 - 250,0 ms (contención en buzones y colas) | Kafka (p99 predecible) |
| 9 | Garantías de Entrega | At-least-once, at-most-once, Exactly-Once (EOS) nativo | At-least-once, at-most-once (sin EOS cross-service) | Kafka (EOS nativo) |
| 10 | Reproducción Histórica (Event Replay) | Nativa; rebobinado de offsets a cualquier punto temporal | Inexistente en AMQP estándar (se destruye tras ack) | Kafka (Victoria absoluta) |
| 11 | Enrutamiento en el Broker | Nulo; topics pasivos; requiere Kafka Streams o Flink | Direct, Fanout, Topic (comodines), Headers y bindings | RabbitMQ (Victoria absoluta) |
| 12 | Colas con Prioridad | Sin soporte nativo; requiere topics separados por prioridad | Colas con prioridad nativas (pesos de 0 a 255) | RabbitMQ |
| 13 | Entregas Programadas / Retardadas | Sin soporte nativo; requiere lógica de bucles de retardo | Mediante plugin rabbitmq_delayed_message_exchange | RabbitMQ |
| 14 | Medio de Almacenamiento Principal | Archivos de segmento secuenciales en disco + Page Cache | Raft WAL en disco + caché de mensajes en tablas ETS | Divergencia de diseño |
| 15 | Soporte Zero-Copy sendfile() | Sí; de la Page Cache del kernel directo a la tarjeta NIC | No; pasa por buffers de usuario en la máquina BEAM | Kafka |
| 16 | Comportamiento de Memoria RAM | Heap JVM pequeño y fijo; el resto entregado a la Page Cache | Heap dinámico BEAM; riesgo de control de flujo por watermark | Kafka (Predecible) |
| 17 | Penalización por Rebalanceo | Rebalanceo Cooperativo Sticky (incremental, sin congelar) | Nula; los workers compiten y se conectan instantáneamente | RabbitMQ |
| 18 | Tope de Concurrencia de Consumo | Limitado por el número de particiones del topic | Prácticamente ilimitado (cientos de workers por cola) | RabbitMQ |
| 19 | Cola de Fallos (Dead-Letter Queue) | Por convención de código (publicar a un topic muerto) | Nativa en el broker mediante Dead Letter Exchange (DLX) | RabbitMQ |
| 20 | Mecánica de Contrapresión | Guiada por extracción (pull); el broker jamás bloquea | Control de flujo por créditos; bloquea sockets de emisión | Kafka (Seguridad emisores) |
| 21 | Almacenamiento Escalonado en S3 | Soporte nativo (KIP-405); retención infinita económica | No soportado; únicamente almacenamiento en bloque local | Kafka |
| 22 | Servicios Cloud Gestionados | Confluent Cloud, AWS MSK, Redpanda Cloud, Aiven | CloudAMQP, Amazon MQ para RabbitMQ, VMware Tanzu | Empate |
| 23 | Replicación Multi-Región (DR) | MirrorMaker 2.0, Confluent Cluster Linking nativo | Plugins Federation y Shovel, clústeres sobre WAN | Kafka (Cluster Linking) |
| 24 | Ecosistema y Analítica en Flujo | Colosal (Kafka Streams, Flink, Spark Streaming, Debezium) | Moderado (Spring Cloud Stream, Celery, MassTransit) | Kafka (Victoria absoluta) |
| 25 | Soporte de Lenguajes de Cliente | Java (nativo), C/C++ (librdkafka), Go, Python, .NET, Rust | Cualquier lenguaje mediante librerías estándar AMQP | Empate |
12. Modelado FinOps: Coste Total de Propiedad (TCO) a 3 Años
Desde la perspectiva de los directores de tecnología (CTO) y responsables de FinOps, las comparativas de intermediarios de mensajería suelen obviar los sobrecostes ocultos más lesivos: el tráfico de red inter-zonas de disponibilidad (cross-AZ egress), las tarifas de IOPS aprovisionadas en almacenamiento en bloque y las horas de dedicación de los ingenieros de plataforma (FTE).
12.1 Los Dos Escenarios de Carga Empresarial
Modelamos matemáticamente el Coste Total de Propiedad a 36 meses bajo dos escenarios representativos:
- Escenario A (Mediana Empresa / Bus de Microservicios): 50.000.000 de mensajes al día (~580 msgs/seg promedio, picos de 2.500 msgs/seg), payload de 1 KB (~50 GB/día ingeridos). Retención de 7 días. Enrutamiento moderado con 5 microservicios consumidores.
- Escenario B (Gran Empresa / Streaming de Eventos Masivo): 2.000.000.000 de mensajes al día (~23.150 msgs/seg promedio, picos de 75.000 msgs/seg), payload de 1 KB (~2 TB/día ingeridos). Retención en disco local de 30 días (60 TB de datos activos) y archivo histórico de 1 año en Tiered Storage (S3). 25 aplicaciones consumidoras suscritas.
12.2 Escenario A: Desglose TCO a 3 Años (Mediana Empresa, 50M msgs/día)
En volúmenes moderados, RabbitMQ demuestra una eficiencia económica superior. Su reducida huella de computación requiere instancias más pequeñas y su enfoque efímero demanda una fracción mínima de disco persistente.
| Categoría de Coste FinOps | Kafka Gestionado (AWS MSK / Confluent) | RabbitMQ Gestionado (CloudAMQP / Amazon MQ) | Análisis de Varianza |
|---|---|---|---|
| Instancias de Cómputo (3 Años) | $15.800 USD (3x m6i.large brokers + controladores) | $6.480 USD (3x t4g.medium / mq.m5.large) | RabbitMQ requiere 59% menos cómputo |
| Almacenamiento e IOPS (7 Días) | $2.450 USD (1,5 TB almacenamiento gp3 + réplicas) | $540 USD (Caché efímera Raft WAL, 150 GB) | Kafka retiene el log completo 7 días |
| Tráfico de Red Cross-AZ Egress | $3.240 USD ($0,01/GB entre 5 consumidores) | $2.700 USD ($0,01/GB distribución exchange) | Costes de red equivalentes |
| Mano de Obra de Ingeniería (FTE) | $36.000 USD (0,10 dedicación Senior SRE) | $18.000 USD (0,05 dedicación SRE) | RabbitMQ es más simple a baja escala |
| TCO Total Acumulado (Escenario A) | $57.490 USD | $27.720 USD | RabbitMQ ahorra $29.770 USD (51,8% más económico) |
12.3 Escenario B: Desglose TCO a 3 Años (Gran Empresa, 2B msgs/día, 2 TB/día)
A escala empresarial masiva, la ecuación económica se invierte de forma aplastante. Intentar procesar 2.000 millones de mensajes diarios mediante RabbitMQ exige crear clústeres gigantescos de decenas de nodos con sharding artificial de colas, disparando los costes de infraestructura; mientras que la arquitectura Zero-Copy de Kafka absorbe ese caudal con una fracción de hardware:
| Categoría de Coste FinOps | Kafka Enterprise + Tiered Storage | Clúster RabbitMQ a Gran Escala | Análisis de Varianza |
|---|---|---|---|
| Nodos de Cómputo (3 Años) | $78.500 USD (6x c6i.4xlarge brokers + KRaft) | $245.000 USD (28x c6i.2xlarge nodos para Raft) | Kafka absorbe 20x más caudal por nodo |
| Almacenamiento NVMe Primario | $38.800 USD (18 TB NVMe local para caché activa) | $14.200 USD (Discos locales Raft WAL efímeros) | RMQ no almacena historial prolongado |
| Tiered Object Storage (S3 / GCS) | $21.600 USD (720 TB archivo comprimido 1 año) | $0 USD (Incompatible con RabbitMQ) | Kafka ofrece 1 año de reproducción histórica |
| Tráfico Red Cross-AZ (Rack-Aware) | $64.800 USD (Replicación + 25 consumidores) | $98.400 USD (Consenso Raft + fanout exchange) | Enrutamiento rack-aware en Kafka ahorra $33.6k |
| Mano de Obra de Ingeniería (FTE) | $108.000 USD (0,30 dedicación Senior SRE) | $180.000 USD (0,50 dedicación SRE gestión colas) | Un clúster disperso de RMQ exige alta gestión |
| TCO Total Acumulado (Escenario B) | $311.700 USD | $537.600 USD | Kafka ahorra $225.900 USD (42,0% más económico a escala) |
13. Seguridad Empresarial, Gobernanza y Cumplimiento Normativo
En industrias fuertemente reguladas (banca, salud, sector público), el middleware debe someterse a estrictas auditorías de seguridad como SOC 2 Tipo II, ISO 27001, HIPAA y el Artículo 17 del RGPD ("Derecho al Olvido").
13.1 Autenticación y Cifrado en Tránsito
- Apache Kafka: Implementa TLS 1.3 en todos los canales (cliente-broker e inter-broker). Mecanismos de autenticación compatibles incluyen mTLS con validación SAN en certificados, SASL/SCRAM-SHA-256/512, Kerberos (GSSAPI) y tokens OAuth 2.0 / OIDC Bearer. Las Listas de Control de Acceso (ACLs) se administran en el cuórum de metadatos KRaft, brindando permisos granulares de lectura, escritura y administración por topic, grupo de consumo o ID transaccional.
- RabbitMQ: Soporta TLS 1.3 para AMQP, MQTT, STOMP y WebSockets. Mediante plugins oficiales admite autenticación vía LDAP, Kerberos, OAuth 2.0 / tokens JWT y certificados x509. La segregación multi-inquilino se logra nativamente mediante Virtual Hosts (vhosts), proporcionando entornos lógicos completamente aislados con permisos por expresiones regulares sobre operaciones de lectura, escritura y configuración.
13.2 Cumplimiento Normativo: La Paradoja del RGPD en Registros Inmutables
Un desafío de cumplimiento relevante en Apache Kafka surge con el Artículo 17 del RGPD europeo (Derecho de Supresión). Debido a que los logs de Kafka son archivos inmutables append-only, expungir los datos personales de un usuario específico de un segmento histórico requeriría reescribir gigabytes de datos en disco.
La ingeniería empresarial resuelve este dilema mediante dos patrones arquitectónicos consolidados:
- Cripto-Destrucción (Crypto-Shredding): La información confidencial del usuario se cifra en el productor con una clave simétrica única vinculada a su identidad, custodiada en un servicio de gestión de claves externo (AWS KMS, HashiCorp Vault). Cuando el cliente solicita su derecho al olvido, la plataforma destruye su clave de cifrado. Los registros permanecen intactos en el log de Kafka, pero sus datos se vuelven matemáticamente indescifrables.
- Compactación con Tombstones: En topics compactados, publicar un registro con
valor=nullpara la clave del usuario instruye al limpiador de logs a purgar todo el historial previo en el siguiente ciclo de compactación.
En RabbitMQ, la conformidad con el RGPD no presenta complejidad alguna: al destruirse automáticamente los mensajes tras su confirmación, no persisten datos de usuario en los brokers una vez completado el procesamiento.
14. Guía de Decisión Arquitectónica y Patrones Híbridos
Lejos de considerarse herramientas mutuamente excluyentes, las organizaciones con plataformas tecnológicas maduras integran ambos sistemas de forma complementaria en un patrón de doble broker.
Ventajas del Patrón Híbrido
En esta combinación sinérgica:
- RabbitMQ gestiona el borde transaccional: Amortigua peticiones de cara al usuario, enruta múltiples formatos mediante intercambios Topic, asegura un reparto justo de tareas mediante ventanas QoS, gestiona reintentos en DLX y ofrece latencias p99 sub-milisegundo.
- Apache Kafka constituye la espina dorsal analítica: Cada transacción finalizada se transfiere hacia Kafka. Kafka suministra el log inmutable que alimenta arquitecturas de Event Sourcing, vuelca datos al Data Lakehouse (Snowflake, BigQuery, Apache Iceberg), ejecuta analítica en tiempo real con Apache Flink y permite que nuevos servicios reprocesen el histórico completo sin afectar la operativa diaria.
15. Preguntas Frecuentes Técnicas con Respuestas en Profundidad
Respuestas detalladas a las dudas técnicas más recurrentes entre arquitectos de software, líderes de infraestructura e ingenieros de fiabilidad (SRE):
¿Por qué Apache Kafka alcanza más de 1.000.000 msgs/seg por broker mientras RabbitMQ ronda los 50.000 msgs/seg por cola Quorum?
La colosal ventaja de rendimiento en Apache Kafka proviene de su diseño a bajo nivel en la interacción con el kernel de Linux y el almacenamiento. Kafka utiliza un registro inmutable append-only en disco y delega la lectura a la llamada al sistema sendfile() (Zero-Copy), enviando buffers de la caché de página del kernel directo a la tarjeta de red sin pasar por el espacio de usuario de la JVM. Asimismo, agrupa registros en micro-batches en el cliente. RabbitMQ, por el contrario, actúa como un broker inteligente donde cada mensaje es gestionado como un proceso actor en la máquina virtual de Erlang (BEAM). El broker mantiene máquinas de estado individuales por mensaje, evalúa claves de enrutamiento dinámicas en exchanges, administra bloqueos de colas y procesa confirmaciones TCP individuales, lo que genera una sobrecarga de CPU y cambios de contexto órdenes de magnitud superior por mensaje.
¿Qué reemplazó a ZooKeeper en las arquitecturas modernas de Kafka y cómo se compara KRaft con el consenso de RabbitMQ?
Las versiones modernas de Apache Kafka operan exclusivamente en modo KRaft (Kafka Raft Metadata mode), eliminando totalmente Apache ZooKeeper. En KRaft, los metadatos del clúster se gestionan internamente en una partición replicada denominada @metadata mediante un cuórum de controladores que ejecuta el algoritmo de consenso Raft. Esto permite escalar a más de diez millones de particiones con tiempos de conmutación por error inferiores a 250 milisegundos. RabbitMQ dependía históricamente de la base de datos Mnesia de Erlang y colas reflejadas (Classic Mirrored Queues), altamente vulnerables al split-brain y a bloqueos por sincronización. En la actualidad, RabbitMQ utiliza colas Quorum (Quorum Queues), las cuales implementan un motor Raft independiente por cada cola (mediante la librería Oskar), garantizando consistencia linealizable, replicación sin bloqueos y alta disponibilidad ante particiones de red.
¿Cómo soluciona el Protocolo de Rebalanceo Cooperativo Sticky de Kafka el bloqueo global de los grupos de consumidores?
Históricamente, Kafka utilizaba el protocolo de rebalanceo Eager, el cual forzaba a todas las instancias de un grupo de consumidores a revocar todas sus particiones asignadas cuando un nodo entraba o salía del clúster, provocando un congelamiento general (stop-the-world). La mejora KIP-429 introdujo el Cooperative Sticky Rebalance Protocol, permitiendo que los consumidores continúen procesando sus particiones activas sin interrupción y revocando únicamente aquellas particiones puntuales que deben migrar al nuevo integrante. Adicionalmente, al asignar identificadores estáticos (group.instance.id), los despliegues continuos y reinicios de pods en Kubernetes no disparan ningún tipo de rebalanceo si el nodo vuelve a conectarse antes de que expire session.timeout.ms.
¿Puede RabbitMQ competir con Kafka cuando se requiere reproducción histórica de eventos y auditoría retroactiva?
No. RabbitMQ fue diseñado como un broker transaccional donde los mensajes son intrínsecamente efímeros: una vez que el consumidor envía el acuse de recibo (basic.ack), el mensaje se destruye de la memoria y el disco para liberar recursos. Aunque RabbitMQ incorporó el plugin Streams para ofrecer un registro append-only, carece del ecosistema maduro de procesamiento en flujo, tablas de estado distribuidas (RocksDB) y dualidad stream-table que ofrecen Kafka Streams y Apache Flink. Kafka trata el log como un libro contable inmutable permanente donde los consumidores gestionan sus propios cursores (offsets), permitiendo rebobinar al offset 0 y reprocesar años de eventos históricos sin impacto alguno en los productores activos.
¿En qué escenarios de arquitectura empresarial es estrictamente preferible RabbitMQ sobre Apache Kafka?
RabbitMQ es la opción arquitectónica superior cuando se requiere: (1) Enrutamiento dinámico complejo mediante Topic Exchanges (comodines * y #), Direct Exchanges o Headers Exchanges sin necesidad de programar microservicios de stream processing; (2) Gestión granular de acuses de recibo y Dead Letter Exchanges (DLX) para reintentos con backoff exponencial y aislamiento de mensajes venenosos sin bloquear el flujo; (3) Latencia sub-milisegundo en el percentil 99 para volúmenes moderados (inferiores a 50.000 msgs/seg), donde el modelo push inmediato supera la latencia de sondeo de Kafka; y (4) Compatibilidad nativa con protocolos estándar como AMQP 0-9-1, AMQP 1.0, MQTT para IoT y STOMP.
¿Cuáles son los sobrecostes ocultos de FinOps entre operar Kafka autogestionado frente a Confluent Cloud o CloudAMQP?
El coste oculto más destructivo en plataformas de streaming distribuido es la transferencia de datos entre zonas de disponibilidad (cross-AZ egress). En Kafka, replicar con factor 3 en un clúster multi-AZ genera el doble de tráfico de red inter-AZ al ingerir, más las transferencias adicionales si los consumidores leen desde subredes distintas a la partición líder. En cargas de 50 TB/mes, este tráfico puede sumar de $1.500 a $3.500 USD mensuales si no se activa el enrutamiento rack-aware. Confluent Cloud y AWS MSK facturan unidades CKU/broker por hora más cargos por GB transferido, mientras que los servicios gestionados de RabbitMQ (CloudAMQP o Amazon MQ) cobran por nodo e IOPS aprovisionados, resultando RabbitMQ mucho más económico para caudales moderados pero inviable financieramente a escala de petabytes.
¿Cómo gestionan la contrapresión (backpressure) Kafka y RabbitMQ ante una degradación de los consumidores?
Ambos sistemas abordan la contrapresión con paradigmas opuestos. Kafka utiliza una arquitectura pull: los consumidores solicitan lotes de mensajes a su propio ritmo. Si los consumidores sufren pausas por recolección de basura o caídas de bases de datos, los registros se acumulan ordenadamente en el disco inmutable del broker sin afectar a los productores en absoluto. En RabbitMQ, el broker empuja los mensajes mediante ventanas de prefetch (basic.qos). Si los consumidores se saturan o dejan de confirmar, las colas crecen en memoria RAM. Al alcanzar el umbral vm_memory_high_watermark, RabbitMQ bloquea los sockets TCP de los productores mediante control de flujo por créditos, deteniendo la ingesta de todo el sistema hasta que los consumidores vacíen la cola.
Malla Temática de Sistemas Distribuidos en CloudBizStack
Profundiza en nuestra serie de benchmarks de ingeniería de sistemas, modelos de costes FinOps y comparativas arquitectónicas de infraestructura cloud:
Fundador y Arquitecto Principal de Sistemas en CloudBizStack. Especialista en topologías de streaming distribuido de alto rendimiento, modelos de economía cloud (FinOps) y algoritmos de consenso empresarial. Ex-responsable de infraestructura dirigiendo pipelines multi-petabyte en Kafka y RabbitMQ sobre AWS y entornos híbridos on-premise.