Apache Iceberg vs Delta Lake: Formatos Lakehouse Abiertos (2026)
La contienda por la arquitectura del lakehouse empresarial en 2026 ha abandonado de manera definitiva los formatos propietarios de almacenamiento en la nube para consolidarse sobre especificaciones de tablas abiertas. Ninguna organización moderna orientada a datos puede permitirse el bloqueo de cómputo (vendor lock-in), las penalizaciones millonarias por replicación de información y las tarifas ocultas por egress de red asociadas a silos cerrados. Decidir entre Apache Iceberg vs Delta Lake representa la determinación de ingeniería de datos y FinOps más trascendental para Directores de Tecnología (CTO), Arquitectos Principales de Lakehouse y líderes de infraestructura que gestionan almacenes analíticos a escala de petabytes.
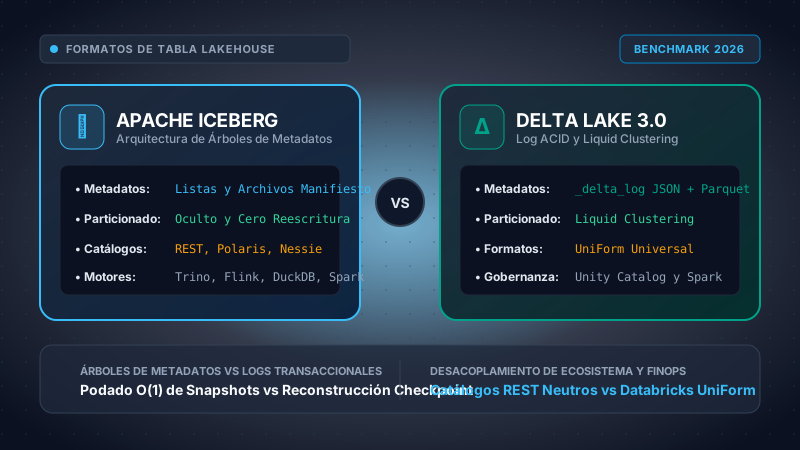
Nuestro equipo de investigación técnica desplegó un dataset sintético TPC-DS de 25TB distribuido entre Amazon S3 (us-east-1) y Google Cloud Storage. Evaluamos la latencia de planificación de escaneo de consultas, el rendimiento de commits bajo alta contención concurrente de escrituras, la cantidad total de llamadas a la API de S3 y la sobrecarga en lecturas Merge-on-Read en Apache Spark 3.5, Trino 442, DuckDB 1.1, Snowflake External Iceberg Tables y Databricks Runtime 14.3 LTS.
Elija Apache Iceberg si su estrategia técnica exige neutralidad total de proveedores en la nube, federación multi-motor heterogénea (Trino, Flink, DuckDB, Snowflake, Athena), catálogos REST verdaderamente abiertos (Apache Polaris, Snowflake Open Catalog, Project Nessie) y evolución de particiones real con cero reescritura de almacenamiento histórico. Elija Delta Lake 3.0 si el núcleo operativo de su ingeniería de datos gira en torno a Apache Spark o el ecosistema de Databricks, donde Liquid Clustering, la gobernanza centralizada de Unity Catalog, los Deletion Vectors nativos y la generación automática de metadatos de UniForm ofrecen una simplicidad operativa superior y un desempeño de escritura llave en mano.
Índice de Contenidos: Análisis Técnico Exhaustivo
- 1. La Muerte de Hive y el Auge del Lakehouse ACID
- 2. Arquitectura de Metadatos: Árboles Jerárquicos vs Logs
- 3. Gestión de Particiones: Evolución Oculta vs Liquid Clustering
- 4. Ecosistema de Catálogos: REST Catalogs vs Unity Catalog
- 5. Interoperabilidad Multi-Motor y Delta UniForm
- 6. Protocolos ACID, Concurrencia y Borrado a Nivel de Fila
- 7. FinOps y Modelado TCO: Costes de API S3 y Compactación
- 8. Matriz Comparativa Exhaustiva de Prestaciones
- 9. Seguridad Empresarial, Gobernanza y Normativa RGPD
- 10. Veredicto Arquitectónico y Estrategia de Migración
- 11. Preguntas Técnicas Frecuentes
1. La Muerte de Hive y el Auge del Lakehouse ACID
Durante más de una década, Apache Hive Metastore (HMS) fungió como el estándar absoluto para organizar conjuntos masivos de datos sobre sistemas de almacenamiento distribuido. En el esquema tradicional de Hive, una tabla se representaba elementalmente como una ruta de directorio en HDFS o en sistemas de almacenamiento de objetos en la nube (como Amazon S3, Google Cloud Storage o Azure Data Lake Storage), subdividida en subdirectorios que reflejaban las columnas de partición (por ejemplo: s3://lakehouse/eventos/anio=2026/mes=03/dia=20/).
Aunque este mecanismo de correspondencia basado en carpetas físicas operaba adecuadamente en sistemas de archivos locales compatibles con POSIX, colapsó irremediablemente al implementarse sobre almacenes de objetos en la nube con las escalas petabyte contemporáneas:
- Latencia O(N) por Listado Recursivo en S3: Para planificar una consulta simple, el motor analítico debía ejecutar solicitudes recursivas LIST sobre cada partición. En tablas con millones de objetos, el simple listado de directorios demandaba decenas de minutos antes de que el motor pudiera procesar el primer byte de datos columnares Parquet.
- Inexistencia de Aislamiento y Transacciones Atómicas: La escritura de datos consistía en colocar archivos dentro de un directorio. Si un trabajo de Spark fallaba a mitad de su ejecución, los archivos corruptos o incompletos quedaban expuestos a las consultas de downstream. Las escrituras concurrentes provocaban condiciones de carrera, lecturas fantasma y sobrescrituras silenciosas de datos críticos.
- Riesgos de Consistencia Eventual: Originalmente, los servicios como S3 no garantizaban consistencia fuerte tras escrituras, lo que generaba errores de tipo 404 Not Found o datos invisibles durante la ejecución de pipelines de datos.
- Acoplamiento Estricto de Particionado Físico: Los usuarios finales estaban obligados a incluir en sus filtros SQL las columnas físicas del particionado (por ejemplo,
WHERE anio = 2026 AND mes = 3). Si un analista filtraba directamente por una columna de marca de tiempo (timestamp), el motor realizaba un escaneo catastrófico de la tabla entera.
Para erradicar estas deficiencias estructurales, Apache Iceberg (creado en Netflix y donado a la Apache Software Foundation) y Delta Lake (desarrollado por los fundadores de Databricks y creadores de Apache Spark) desacoplaron la identidad lógica de una tabla de su disposición física en directorios. En lugar de registrar directorios, ambos formatos rastrean colecciones exactas e inmutables de archivos de datos mediante metadatos transaccionales explícitos. Este salto arquitectónico habilitó transacciones ACID completas, aislamiento serializable, planificación instantánea de consultas, viajes en el tiempo (Time Travel) y evolución de esquemas sin fricción sobre almacenamiento estándar de objetos.
2. Arquitectura de Metadatos: Árboles Jerárquicos vs Logs Transaccionales
La divergencia técnica más profunda entre Apache Iceberg y Delta Lake radica en cómo estructuran y gestionan sus metadatos. La representación del estado de una tabla influye de forma directa en la velocidad de planificación de consultas, el consumo de memoria en los nodos coordinadores (drivers), los límites de concurrencia en escrituras y el coste total acumulado de almacenamiento.
Apache Iceberg: El Árbol Jerárquico de Metadatos
Apache Iceberg estructura el estado de una tabla como un árbol inmutable de metadatos, segmentado en capas claramente delimitadas:
│
├── Instantánea (Snapshot) 1001 (Esquema, Especificación de Partición, Log de Snapshots)
│ └── Lista de Manifiestos (Manifest List): snap-1001-1-uuid.avro
│ ├── Entrada de Manifiesto 1: manifest-a.avro (Límites: fecha [2026-03-01 a 2026-03-15])
│ │ ├── data-file-1.parquet (Mín: 10, Máx: 500, Nulos: 0)
│ │ └── data-file-2.parquet (Mín: 501, Máx: 999, Nulos: 2)
│ └── Entrada de Manifiesto 2: manifest-b.avro (Límites: fecha [2026-03-16 a 2026-03-31])
│ └── data-file-3.parquet (Mín: 1000, Máx: 1450, Nulos: 0)
└── Instantánea (Snapshot) 1002 (Próximo Commit...)
En esta estructura:
- Puntero en el Catálogo: El catálogo (por ejemplo, Apache Polaris, Project Nessie o AWS Glue) almacena una única referencia que apunta al archivo
metadata.jsonactual. Modificar atómicamente este puntero representa la confirmación de la transacción (commit). - Archivo de Metadatos de Tabla (
v<N>.metadata.json): Contiene las especificaciones completas de esquemas, esquemas de particionado históricos, identificador de la instantánea activa, historial cronológico de instantáneas y criterios de ordenamiento físico. - Lista de Manifiestos (
.avro): Define una instantánea concreta. Cada registro en esta lista describe un archivo de manifiesto individual, detallando el rango mínimo y máximo de las particiones que contiene, el recuento de archivos añadidos y el número de filas. - Archivo de Manifiesto (
.avro): Rastrea individualmente los archivos de datos (y archivos de borrado), documentando la ruta exacta del objeto, tuplas de partición, límites de valores mínimos y máximos por columna, número de valores nulos y valores NaN.
La Ventaja Arquitectónica de Iceberg: Puesto que las listas de manifiestos incluyen los límites de las particiones, el motor de consultas puede descartar archivos enteros de manifiesto durante la fase de planificación sin necesidad de abrirlos ni descargarlos. La planificación de escaneo escala en tiempo $O(1)$ o sub-lineal frente al tamaño total de la tabla, permitiendo gestionar miles de millones de archivos sin desbordar la memoria de los coordinadores de consulta.
Delta Lake: El Log Transaccional ACID (_delta_log)
Delta Lake modela el estado de una tabla como una secuencia cronológica y ordenada de archivos de commit atómicos almacenados dentro de la carpeta reservada _delta_log/:
├── 00000000000000000000.json (Commit 0: protocol, metaData, add archivos)
├── 00000000000000000001.json (Commit 1: add archivos, remove archivos)
├── ...
├── 00000000000000000010.json (Commit 10)
├── 00000000000000000010.checkpoint.parquet (Instantánea de estado en commit 10)
├── 00000000000000000011.json (Commit 11)
└── _last_checkpoint (Puntero JSON: {"version": 10, "size": 1})
En el diseño operativo de Delta Lake:
- Logs de Commit JSON (
0000000000000000000X.json): Cada acción transaccional genera un archivo JSON atómico que documenta operaciones granulares:commitInfo,protocol,metaData,add(nuevos archivos Parquet con estadísticas por columna) yremove(archivos marcados como eliminados o tombstoned). - Checkpoints Consolidados (
.checkpoint.parquet): Cada 10 commits (por defecto), el motor consolida todo el historial previo en un archivo checkpoint comprimido en formato Parquet. Este proceso colapsa las acciones de adición y eliminación en una lista neta y limpia de archivos en producción. - Reconstrucción del Estado: Para conocer la versión activa de la tabla, el motor lee el archivo
_last_checkpoint, carga el checkpoint Parquet en memoria y reproduce secuencialmente hacia adelante los commits JSON posteriores.
La Compensación Técnica: La arquitectura de log secuencial de Delta Lake es conceptualmente brillante, análoga al Write-Ahead Logging (WAL) de los sistemas relacionales tradicionales. Para ingestas continuas en streaming y commits de micro-lotes frecuentes, añadir un archivo JSON es extraordinariamente rápido. Sin embargo, si los procesos de compactación de checkpoints se demoran o fallan, el motor de consultas se ve forzado a leer y procesar cientos de archivos JSON para calcular la lista de archivos activos, induciendo picos de latencia y presión de memoria en el driver de ejecución.
3. Gestión de Particiones: Evolución Oculta vs Liquid Clustering
La distribución física de los datos determina la eficacia del podado (pruning) en las consultas SQL. La manera en que cada formato estructura las particiones condiciona el volumen de datos innecesarios que el motor puede ignorar.
Apache Iceberg: Particionado Oculto y Evolución Real sin Reescritura
En los sistemas convencionales, el particionado requería columnas artificiales adicionales (por ejemplo, extraer fecha_orden a partir de un campo timestamp_evento). Esto originaba errores frecuentes: consultas que filtraban por timestamp_evento no aprovechaban el particionado a menos que el desarrollador recordara filtrar explícitamente por fecha_orden.
Apache Iceberg resolvió esto introduciendo el Particionado Oculto (Hidden Partitioning), donde las transformaciones de partición se configuran directamente dentro de los metadatos de la tabla:
years(ts),months(ts),days(ts),hours(ts): Granularidades temporales nativas.bucket(N, col): Hashing determinista Murmur3 en $N$ contenedores para asegurar co-localización en operaciones de join.truncate(W, col): Truncamiento de cadenas de texto para campos de alta cardinalidad.identity(col): Particionado clásico por valor exacto.
CREATE TABLE iceberg_prod.telemetria.lecturas_dispositivos (
id_dispositivo STRING,
fecha_lectura TIMESTAMP,
tipo_sensor STRING,
valor_metrica DOUBLE
)
USING iceberg
PARTITIONED BY (
days(fecha_lectura),
bucket(16, id_dispositivo)
);
-- La consulta poda particiones automáticamente sin hacer referencia a columnas ocultas
SELECT AVG(valor_metrica)
FROM iceberg_prod.telemetria.lecturas_dispositivos
WHERE fecha_lectura >= TIMESTAMP '2026-03-01 00:00:00'
AND fecha_lectura < TIMESTAMP '2026-03-02 00:00:00'
AND id_dispositivo = 'DEV-94812';
Evolución de Particiones sin Reescritura Física de Datos: A medida que el volumen de ingesta se incrementa, un equipo puede percatarse de que el particionado diario genera archivos demasiado pequeños, o que un particionado mensual crea archivos de 50GB imposibles de optimizar. Con Apache Iceberg, es posible modificar la especificación de partición mediante una única transacción de metadatos:
ALTER TABLE iceberg_prod.telemetria.lecturas_dispositivos
SET PARTITION SPEC (
hours(fecha_lectura),
bucket(32, id_dispositivo)
);
Lo fundamental es que ningún dato histórico se reescribe. Los archivos previos continúan vinculados a spec-id: 0, mientras que los datos recién insertados se almacenan bajo spec-id: 1. Cuando una consulta abarca periodos históricos y recientes, Iceberg coordina dinámicamente el podado sobre ambas especificaciones en un único plan de ejecución transparente.
Delta Lake 3.0: Liquid Clustering
Delta Lake empleaba tradicionalmente el particionado por directorios de Hive acoplado a la técnica de Z-Ordering multidimensional (mediante OPTIMIZE tabla ZORDER BY (col1, col2)). Sin embargo, el Z-Order implicaba un coste computacional elevado, obligaba a reescribir particiones completas y resultaba ineficiente cuando existía sesgo (skew) en los datos.
Introducido en Delta Lake 3.0, Liquid Clustering reemplaza por completo las carpetas físicas de partición y el Z-Order tradicional mediante algoritmos dinámicos basados en curvas de Hilbert:
CREATE TABLE delta_prod.telemetria.lecturas_dispositivos (
id_dispositivo STRING,
fecha_lectura TIMESTAMP,
tipo_sensor STRING,
valor_metrica DOUBLE
)
USING delta
CLUSTER BY (id_dispositivo, fecha_lectura);
-- Ejecución de Optimización Incremental de Liquid Clustering
OPTIMIZE delta_prod.telemetria.lecturas_dispositivos;
Mecánica Operativa de Liquid Clustering:
- Los archivos se guardan en un directorio plano sin subcarpetas anidadas de partición.
- Delta Lake calcula coordenadas a lo largo de una curva de Hilbert multidimensional que entrelaza los valores de las columnas seleccionadas en una línea unidimensional continua.
- Las escrituras se realizan velozmente sin reindexar todo el conjunto; las tareas posteriores de
OPTIMIZEcompactan y agrupan incrementalmente solo las áreas desorganizadas. - Las columnas de clustering pueden alterarse en cualquier momento (
ALTER TABLE ... CLUSTER BY ...) sin invalidar los datos ya organizados.
Conclusión sobre Particionado: Liquid Clustering de Delta Lake ofrece un comportamiento superior para consultas analíticas con filtros arbitrarios sobre múltiples columnas, eliminando de raíz el clásico problema de los archivos minúsculos por sobre-particionado. Por su parte, la Evolución de Particiones Ocultas de Iceberg sigue siendo matemáticamente más predecible y económica en lagos de series temporales donde el podado temporal determinista evita la necesidad de computación continua de reagrupamiento.
4. Ecosistema de Catálogos: REST Catalogs vs Unity Catalog
Un formato de tabla abierta no puede operar de forma aislada sin una fuente central de verdad que mantenga las referencias activas de las tablas y coordine el aislamiento transaccional concurrente. En las implementaciones modernas, la arquitectura del catálogo define el grado de libertad frente a proveedores y la madurez de la gobernanza.
Comparativa de Enfoques de Catálogo y Gobernanza
Protocolo HTTP/JSON definido mediante OpenAPI. Un único Catálogo REST (como Apache Polaris, Project Nessie o Snowflake Open Catalog) conecta a Trino, DuckDB, Flink y Spark mediante entrega de credenciales vended y políticas RBAC neutrales.
Motor de gobernanza de código abierto para datos e inteligencia artificial. Ofrece control de acceso unificado, enmascaramiento dinámico y linaje operativo integral. Gobierna de forma nativa Delta Lake y extiende puentes a Iceberg vía UniForm.
La Especificación del Catálogo REST de Apache Iceberg
Iceberg concibió la Especificación de Catálogo REST, un estándar abierto de API HTTP que desacopla por completo el almacenamiento de metadatos de los motores de ejecución. En lugar de vincular herramientas a librerías propietarias o protocolos Thrift de Hive, cualquier motor puede consultar y actualizar tablas Iceberg mediante llamadas REST estándar:
GET /v1/namespaces/{ns}/tables/{table}: Retorna el puntero del archivo de metadatos.POST /v1/namespaces/{ns}/tables/{table}: Ejecuta una actualización atómica mediante Compare-And-Swap (CAS).- Emisión de Credenciales Temporales (Credential Vending): El catálogo REST autentica al usuario (mediante OAuth2/OIDC) y le entrega credenciales temporales acotadas de AWS IAM o GCP STS que limitan el acceso exclusivamente a los prefijos de S3 de esa tabla específica.
Entre las implementaciones destacadas en producción se encuentran:
- Apache Polaris (incubating): Catálogo de código abierto impulsado por Snowflake, enfocado en gobernanza unificada multi-nube sin cautiverio comercial.
- Project Nessie: Aporta control de versiones estilo Git para el lakehouse, habilitando ramas de datos (
CREATE BRANCH staging_etl), transacciones atómicas multi-tabla y rollbacks inmediatos ante fallos lógicos. - AWS Glue Data Catalog: Incorpora interfaces nativas de Catálogo REST de Iceberg para Athena y Amazon EMR.
Delta Lake: Unity Catalog y Bloqueos de Almacenamiento
Delta Lake dependía originalmente de rutas directas sobre el almacenamiento (por ejemplo, delta.`s3://bucket/ruta`), utilizando mecanismos externos de sincronización (como Amazon DynamoDB) para resolver conflictos de escritura en sistemas que carecían de escrituras atómicas condicionales.
Con la liberación como software libre de Unity Catalog por parte de Databricks, Delta Lake integró una plataforma de gobernanza empresarial que incluye:
- Estructura jerárquica de tres niveles (
catalogo.esquema.tabla). - Control de acceso basado en atributos (ABAC), enmascaramiento dinámico de columnas y filtrado seguro de filas a nivel de motor.
- Linaje operacional completo capturado en tiempo real en trabajos de Spark y ejecuciones SQL.
Evaluación de Gobernanza: Unity Catalog está indiscutiblemente más maduro como suite integral de gobernanza lista para producción dentro de entornos donde Databricks es el motor preponderante. Por el contrario, el Catálogo REST de Iceberg es sustancialmente más independiente y cuenta con el respaldo unificado de los grandes proveedores cloud y motores analíticos independientes.
5. Interoperabilidad Multi-Motor y Delta UniForm
Los entornos empresariales modernos rara vez dependen de un único motor de computación. Es habitual contar con Apache Flink procesando flujos continuos en streaming, Apache Spark para pesadas transformaciones por lotes, Trino resolviendo tableros analíticos de baja latencia y DuckDB operando en estaciones locales para ciencia de datos.
La Realidad Multi-Motor Nativa
Apache Iceberg se diseñó desde su génesis como una capa agnóstica de almacenamiento. Operaciones de lectura y escritura en Trino, DuckDB o Snowflake son procedimientos nativos de primer nivel:
INSTALL iceberg;
LOAD iceberg;
SELECT id_cliente, SUM(monto_transaccion) AS gasto_total
FROM iceberg_scan('s3://lakehouse-prod/metadata/v24.metadata.json')
WHERE fecha_transaccion >= '2026-01-01'
GROUP BY id_cliente
ORDER BY gasto_total DESC LIMIT 10;
En contraste, Delta Lake mantuvo históricamente un estrecho acoplamiento con Apache Spark. Si bien las librerías delta-rs (en Rust) y Delta Kernel han mejorado significativamente las lecturas en Trino y DuckDB, las capacidades de escritura fuera del entorno oficial de Spark y Databricks continúan sufriendo limitaciones operativas.
Delta Lake UniForm: El Puente Hacia el Formato Universal
Para mitigar las preocupaciones corporativas sobre el confinamiento en un formato único, Databricks desarrolló Delta Lake UniForm (Universal Format). UniForm escribe archivos Parquet conforme al estándar de Delta Lake y genera automáticamente los metadatos de Apache Iceberg (y Apache Hudi) de forma asíncrona durante cada commit:
CREATE TABLE delta_prod.ventas.pedidos (
id_pedido BIGINT,
id_cliente STRING,
monto_total DECIMAL(10,2),
fecha_pedido TIMESTAMP
)
USING delta
TBLPROPERTIES (
'delta.universalFormat.enabledFormats' = 'iceberg',
'delta.universalFormat.iceberg.compatVersion' = '2'
);
Mecánica Interna de UniForm:
- El motor de Spark escribe los archivos Parquet y registra la transacción en
_delta_log/0000X.json. - Un proceso interno de traducción analiza el commit e inmediatamente genera los archivos de manifiesto Avro correspondientes, la lista de manifiestos y un nuevo
vX.metadata.jsonde Iceberg. - Los Deletion Vectors de Delta se traducen a archivos de Eliminación Posicional de Iceberg v2.
- Motores externos (como Snowflake, AWS Athena o Google BigQuery) apuntan directamente a los metadatos de Iceberg y leen los datos Parquet subyacentes con cero duplicación de almacenamiento.
Límites Reales de UniForm: Aunque UniForm representa una solución de ingeniería sobresaliente, es en su esencia un puente asimétrico de solo lectura. Ningún motor externo puede escribir de forma nativa en una tabla UniForm como emisor de Iceberg sin que se produzca una divergencia insalvable en los metadatos. Asimismo, la generación dual añade una ligera latencia tras el commit (habitualmente entre 500ms y 3 segundos) y siempre va rezagada respecto a las innovaciones más recientes de las especificaciones de Iceberg.
6. Protocolos ACID, Concurrencia y Borrado a Nivel de Fila
Los pipelines de ingeniería de datos requieren garantías ACID estrictas para gestionar simultáneamente cargas masivas por lotes, capturas continuas de cambios (CDC) y borrados exigidos por regulaciones de privacidad de datos (como el RGPD europeo).
Control de Concurrencia Optimista (OCC)
Ambos formatos confían en el Control de Concurrencia Optimista (OCC):
- El Principio Optimista: Los procesos asumen que ninguna otra transacción modificará los mismos archivos de datos mientras preparan sus escrituras. Cada escritor lee la instantánea activa, genera sus nuevos archivos Parquet y solicita el commit atómico.
- Resolución en Iceberg: El escritor realiza un intercambio atómico en el catálogo (por ejemplo, CAS en el puntero de metadatos). Si otro proceso confirmó antes, Iceberg examina si las modificaciones de ambos colisionan a nivel de partición o de archivos específicos. Si las operaciones afectaron datos disjuntos (por ejemplo, inserciones simultáneas o borrados en particiones diferentes), Iceberg reajusta la base del commit de manera automática sin abortar la operación.
- Resolución en Delta Lake: Delta Lake se basa en la numeración correlativa de los archivos JSON de commit. Con el soporte de escrituras condicionales atómicas en Amazon S3 (cabeceras ETag y conditional PUTs
If-None-Match), si dos procesos intentan crear el commit000012.jsona la vez, el rezagado recibe un código HTTP 412 Precondition Failed, comprueba si hubo solapamiento de archivos y reintenta registrarse como000013.json.
Mutaciones de Filas: Copy-on-Write vs Merge-on-Read
Cuando es preciso modificar o borrar registros individuales en archivos Parquet de gran tamaño, reescribir el archivo entero resulta prohibitivo en términos de cómputo:
| Modalidad de Mutación | Implementación en Apache Iceberg | Implementación en Delta Lake 3.0 |
|---|---|---|
| Copy-on-Write (CoW) | Reescribe el archivo Parquet completo en cada UPDATE o DELETE. Recomendado únicamente para tablas con lecturas muy intensivas y casi nulas mutaciones. | Reescribe el archivo Parquet completo. Alta amplificación de escritura en cargas transaccionales frecuentes. |
| Merge-on-Read (MoR): Registro de Borrado | Positional Deletes & Equality Deletes: Almacena rutas de archivos y posiciones de fila (0-indexed) en archivos Parquet de borrado independientes. | Deletion Vectors (DVs): Registra las filas eliminadas en mapas de bits comprimidos (Roaring Bitmaps) en archivos binarios diminutos o metadatos. |
| Sobrecarga en la Lectura | Los motores ejecutan joins hash en memoria o fusiones por streaming entre los datos base y los archivos de borrado durante la planificación del escaneo. | Los motores aplican operaciones lógicas a nivel de bits (bitwise) directamente en CPU, minimizando la latencia añadida en consultas. |
| Mantenimiento Exigido | Requiere invocar el procedimiento rewrite_data_files para fusionar los archivos de borrado y regenerar archivos Parquet limpios. |
Requiere ejecutar OPTIMIZE periódicamente para consolidar físicamente los archivos y purgar los registros tachados. |
Veredicto sobre Mutaciones de Filas: Los Deletion Vectors (DVs) de Delta Lake representan una ventaja técnica palpable frente a las Eliminaciones Posicionales de Iceberg. Al recurrir a mapas de bits Roaring, los motores filtran filas eliminadas en microsegundos sin requerir joins hash en memoria, lo que mantiene consultas notablemente más ágiles hasta que se ejecute la compactación.
7. FinOps y Modelado TCO: Costes de API S3 y Compactación
Desde la perspectiva de FinOps (gestión financiera del cloud), el coste real de un lakehouse trasciende ampliamente el precio nominal por gigabyte almacenado. Tablas mal configuradas o sin mantenimiento periódico pueden provocar sorpresas financieras multimillonarias derivadas de llamadas a la API de almacenamiento de objetos, saturación de memoria en clústeres y cómputo de compactación desmedido.
El Coste Oculto de las Solicitudes a la API de S3
Amazon S3 tarifica $0.005 USD por cada 1.000 peticiones de tipo PUT/POST/LIST y $0.0004 USD por cada 1.000 peticiones GET (en la capa Standard). En una tabla con ingesta continua que ejecute 100 micro-lotes por minuto distribuidos en múltiples particiones:
Ecuación de TCO para Almacenamiento en Lakehouse
Donde:
• $S_{base}$: Volumen neto de datos columnares Parquet en producción (TB/mes)
• $S_{snapshots}$: Espacio consumido por instantáneas históricas y archivos huérfanos por Time Travel
• $N_{API}$: Volumen acumulado de llamadas a la API del almacenamiento de objetos
• $C_{compactacion}$: Horas de clúster de cómputo dedicadas a tareas de bin-packing, clustering y reescritura de metadatos
El Impacto Real de las Llamadas a la API:
- Patrón de Delta Lake: Todo motor que inspecciona una tabla Delta debe consultar
_delta_log/. Si no se han realizado checkpoints recientes, el motor ejecuta peticiones LIST y GET continuas sobre decenas o cientos de archivos JSON. En organizaciones con tableros BI que refrescan con alta frecuencia (por ejemplo, 500 consultas por hora sobre 40 tablas), estos listados pueden detonar cientos de miles de peticiones al día. - Patrón de Apache Iceberg: Iceberg jamás ejecuta llamadas LIST en S3 durante la planificación ordinaria de consultas. El motor consulta el puntero en el catálogo, realiza una única lectura GET para el archivo
vX.metadata.json, un GET para la lista de manifiestos y lecturas GET dirigidas exclusivamente a los manifiestos que superaron el podado. En tablas a escala de petabytes con millones de archivos, esto ahorra miles de dólares mensuales en llamadas a S3 y elimina los temidos errores de throttling HTTP 503 SlowDown.
Mantenimiento Operativo y Cómputo de Compactación
Ambos formatos acumulan deuda técnica en el almacenamiento con el transcurso del tiempo (dispersión de archivos minúsculos, instantáneas caducadas y archivos de borrado huérfanos). Establecer tareas de mantenimiento automatizadas es imperativo:
-- 1. Compactar archivos pequeños en archivos óptimos de 512MB
CALL iceberg_prod.system.rewrite_data_files(
table => 'telemetria.lecturas_dispositivos',
strategy => 'binpack',
options => map('target-file-size-bytes', '536870912')
);
-- 2. Expirar instantáneas con más de 7 días para recuperar costes de storage
CALL iceberg_prod.system.expire_snapshots(
table => 'telemetria.lecturas_dispositivos',
older_than => date_sub(current_timestamp(), 7)
);
-- 3. Reorganizar archivos manifiesto para optimizar el árbol de escaneo
CALL iceberg_prod.system.rewrite_manifests(table => 'telemetria.lecturas_dispositivos');
-- 1. Compactar archivos y optimizar agrupamiento en Liquid Clustering
OPTIMIZE delta_prod.telemetria.lecturas_dispositivos;
-- 2. Eliminar archivos obsoletos no referenciados fuera del margen de seguridad
VACUUM delta_prod.telemetria.lecturas_dispositivos RETAIN 168 HOURS;
8. Matriz Comparativa Exhaustiva de Prestaciones
A continuación se presenta el balance técnico directo entre Apache Iceberg y Delta Lake 3.0 sobre 16 variables críticas de arquitectura, rendimiento y gobernanza corporativa:
| Dimensión Arquitectónica | Apache Iceberg | Delta Lake 3.0 | Ventaja Técnica |
|---|---|---|---|
| Organismo de Gobernanza | Apache Software Foundation (100% Neutral) | Linux Foundation (Controlado prioritariamente por Databricks) | Iceberg (Neutralidad) |
| Estructura de Metadatos | Árbol Jerárquico (Listas y Manifiestos en formato Avro) | Log Transaccional Secuencial (_delta_log JSON + Checkpoint Parquet) | Iceberg (Escalabilidad O(1)) |
| Evolución de Particionado | Evolución Oculta Real sin Reescritura (Multi-spec activa) | Liquid Clustering (Curvas de Hilbert, elimina directorios) | Empate Técnico |
| Borrados Merge-on-Read (MoR) | Positional & Equality Deletes (Archivos Parquet) | Deletion Vectors (Mapas de bits Roaring en memoria) | Delta Lake (Lectura Rápida) |
| Estándar de Catálogo | Especificación Abierta REST Catalog (Polaris, Nessie, Glue) | Unity Catalog y Acceso Directo por Ruta con Locks | Iceberg (Ecosistema Abierto) |
| Escrituras Multi-Motor | Escritura nativa de primer nivel en Spark, Flink y Trino | Predominantemente Spark / Databricks; conectores externos rezagados | Iceberg (Libertad Multi-Motor) |
| Interoperabilidad de Formatos | Lectura nativa en todos los grandes motores analíticos | UniForm (Genera metadatos Iceberg/Hudi automáticamente al commit) | Delta Lake (Puente UniForm) |
| Ingesta en Streaming | Sinks nativos en Flink y Spark con árboles de commit sub-segundo | Spark Structured Streaming nativo con inserción veloz en log | Empate Técnico |
| Control de Versiones Tipo Git | Ramificación (branching) y etiquetado nativo vía Nessie y REST | Time Travel nativo; la ramificación exige clonación de datos | Iceberg (Ramas y Tags) |
| Eficiencia de Solicitudes S3 | Cero llamadas S3 LIST durante la fase de planificación | Requiere llamadas S3 LIST sobre el commit log salvo caché activa | Iceberg (Menor Coste S3) |
| Analítica Local / Embebida | Escaneo nativo en DuckDB mediante extensión oficial Iceberg | Escaneo nativo en DuckDB mediante extensión Delta (lee log JSON) | Empate Técnico |
| Integración con Snowflake | Tablas Gestionadas y Externas Iceberg de primer nivel nativo | Solo lectura vía tablas externas o mediante traducción UniForm | Iceberg (Integración Nativa) |
| Integración con AWS Athena | Soporte serverless nativo gestionado mediante AWS Glue | Compatible mediante conectores Glue/Delta o vía UniForm | Iceberg |
| Motor Photon de Databricks | Soportado como lector externo (compatible vía UniForm) | Motor nativo C++ hiper-optimizado para Delta Lake | Delta Lake (Rendimiento Databricks) |
| Evolución de Esquemas | Completa: Añadir, renombrar, eliminar, reordenar y tipos anidados | Completa: Añadir, renombrar, eliminar y sobrescribir esquema | Empate Técnico |
| Simplicidad de Compactación | Procedimientos explícitos (rewrite_data_files, expire_snapshots) | Comandos consolidados unificados (OPTIMIZE, VACUUM) | Delta Lake (Simplicidad) |
9. Seguridad Empresarial, Gobernanza y Normativa RGPD
La administración de un lakehouse en sectores altamente regulados (servicios financieros, biotecnología, plataformas SaaS en Europa y Latinoamérica) impone exigencias severas de gobernanza y trazabilidad.
Entrega de Credenciales Zero-Trust (Credential Vending)
Históricamente, los motores analíticos requerían credenciales IAM con permisos globales de lectura sobre todo el bucket de almacenamiento de datos. Los formatos modernos han transformado este paradigma mediante la Entrega Delegada de Credenciales:
- Cuando un usuario lanza una consulta en Trino o DuckDB, el motor se autentica ante el catálogo central (como Apache Polaris o Unity Catalog).
- El catálogo valida las políticas RBAC y solicita a AWS STS (o GCP STS) un token temporal de sesión con una vigencia limitada (por ejemplo, 15 minutos).
- Dicho token otorga privilegios de lectura única y exclusivamente sobre los objetos Parquet específicos que requiere el plan de ejecución de esa consulta, impidiendo cualquier acceso no autorizado al resto del almacén.
Cumplimiento de Privacidad: Derecho al Olvido en RGPD y CCPA
Las directivas internacionales exigen erradicar permanentemente los registros de usuarios identificables en un plazo máximo de 30 días tras una solicitud formal:
- El Conflicto con las Instantáneas Inmutables: Dado que los formatos conservan versiones previas para soportar Time Travel, un comando
DELETE FROM tabla WHERE id_usuario = 'X'únicamente oculta la fila en la última instantánea. Las versiones anteriores continúan albergando datos personales protegidos. - Protocolo de Cumplimiento en Iceberg: Ejecutar el borrado lógico vía Merge-on-Read, activar de inmediato
rewrite_data_filespara purgar físicamente los registros en nuevos archivos Parquet, y ejecutarexpire_snapshotsestableciendo el parámetro de retención a 0 para eliminar definitivamente los manifiestos que referencian los datos revocados. - Protocolo de Cumplimiento en Delta Lake: Ejecutar la instrucción de borrado (que escribe un Deletion Vector), invocar
OPTIMIZEpara reorganizar físicamente los archivos sin las filas eliminadas, y correrVACUUM tabla RETAIN 0 HOURS(configurando previamentespark.databricks.delta.vacuum.parallelDelete.enabled = true) para purgar de forma irrecuperable los archivos de almacenamiento.
10. Veredicto Arquitectónico y Estrategia de Migración
Construir la base analítica de una organización en 2026 no implica adoptar una postura dogmática, sino dimensionar con rigor técnico el centro de gravedad del cómputo empresarial y los objetivos de portabilidad.
Marco de Decisión Estratégico para Arquitectos de Datos
- Adopte 100% Apache Iceberg si: Su infraestructura utiliza motores analíticos heterogéneos (por ejemplo, Trino para BI federado y Flink para ingesta en tiempo real); sus cargas residen prioritariamente en Snowflake, Google Cloud BigLake o AWS Athena; o su dirección prohíbe explícitamente depender de un único proveedor de analítica propietaria.
- Adopte 100% Delta Lake 3.0 si: Toda su ingeniería de datos se sustenta en clústeres estandarizados de Apache Spark o Databricks; busca la máxima simplicidad operativa con Liquid Clustering sin diseñar particiones manuales; y utiliza Unity Catalog como eje corporativo de gobernanza y linaje.
- Implemente la Estrategia Híbrida UniForm si: Sus pipelines de escritura operan sobre Databricks / Spark, pero necesita abastecer de forma continua a analistas externos que consultan directamente mediante Snowflake, Trino o DuckDB sin incurrir en costes de replicación de almacenamiento ni transferencias de red.
11. Preguntas Técnicas Frecuentes
¿Elimina Delta Lake UniForm la necesidad de elegir entre Iceberg y Delta Lake?
Delta Lake UniForm (Universal Format) permite que las tablas Delta generen metadatos de Apache Iceberg y Apache Hudi de forma asíncrona al confirmar transacciones (commits), lo que posibilita que motores nativos de Iceberg (como Snowflake o AWS Athena) lean datos gestionados por Delta sin duplicar almacenamiento físico. No obstante, UniForm no suprime la divergencia técnica: funciona primordialmente como un puente de compatibilidad de solo lectura. Las escrituras deben procesarse a través de un motor compatible con Delta (como Apache Spark o Databricks Photon), lo que significa que las arquitecturas multi-motor con escrituras distribuidas (por ejemplo, streaming en Flink junto a inserciones por lotes en Trino) siguen requiriendo la elección de un formato nativo único.
¿Cómo se compara la Evolución de Particiones de Iceberg con Liquid Clustering de Delta Lake en producción?
Apache Iceberg implementa la Evolución de Particiones rastreando identificadores de especificación (partition-spec-id) dentro de los archivos manifiesto. Cuando una partición analítica cambia de mensual a diaria (o agrega una clave hash agrupada por buckets), los archivos Parquet históricos no se tocan en absoluto; las nuevas escrituras adoptan la nueva especificación y los motores de consulta podan simultáneamente datos a través de múltiples especificaciones activas. Delta Lake 3.0 aborda este reto mediante Liquid Clustering, descartando las jerarquías de directorios estilo Hive en favor de carpetas planas ordenadas mediante curvas de Hilbert dinámicas. Liquid Clustering permite alterar las claves de ordenamiento en caliente, pero requiere ejecutar trabajos de mantenimiento periódicos (OPTIMIZE) para reorganizar físicamente los bloques de datos a lo largo del tiempo.
¿Por qué diseñó Netflix Apache Iceberg en lugar de adoptar Delta Lake o Hive?
Netflix diseñó Apache Iceberg para resolver las limitaciones críticas de escalabilidad de las tablas basadas en directorios de Hive Metastore sobre Amazon S3. Hive requería operaciones recursivas de listado de archivos O(N) en S3, sufría anomalías por consistencia eventual y carecía de aislamiento transaccional atómico. Mientras que Delta Lake se lanzó inicialmente como un proyecto muy acoplado al runtime propietario de Databricks y a Apache Spark, Iceberg se concibió desde el primer día con un árbol jerárquico de metadatos abierto (listas de manifiestos y manifiestos en Avro) y una especificación abierta de Catálogo REST, facilitando un soporte multi-motor de primer orden para Trino, Flink, Spark, DuckDB, Presto y Snowflake sin intermediarios propietarios.
¿En qué se diferencian las Eliminaciones Posicionales de Iceberg de los Deletion Vectors de Delta Lake en lecturas?
Ambos formatos emplean Merge-on-Read (MoR) para evitar reescribir archivos enteros (Copy-on-Write) en sentencias DELETE y UPDATE. Las Eliminaciones Posicionales de Iceberg guardan las rutas de los archivos afectados y las posiciones ordinales de las filas en archivos Parquet de borrado independientes, que los motores de consulta integran con los datos base mediante joins hash en memoria o fusiones por streaming durante la planificación del escaneo. Por su parte, los Vectores de Eliminación (Deletion Vectors o DVs) de Delta Lake codifican los índices de filas borradas como mapas de bits compactos (Roaring Bitmaps) incrustados en metadatos o en pequeños archivos binarios directos. Los DVs de Delta ofrecen menor sobrecarga de memoria y lecturas más rápidas, ya que las operaciones a nivel de bits (bitwise) en CPU son sustancialmente más livianas que los joins hash relacionales.
¿Cuáles son las implicaciones de costes de API S3 entre los árboles de Iceberg y los logs de Delta Lake?
Iceberg elimina por completo las llamadas LIST de la API de S3 al mantener punteros directos e inmutables dentro de sus archivos manifiesto Avro. Las consultas se ejecutan únicamente mediante peticiones directas y predecibles GET de S3 sobre la lista de manifiestos, los manifiestos podados y los archivos Parquet requeridos. Por contra, los motores sobre Delta Lake leen la carpeta _delta_log, lo que exige peticiones LIST continuas para identificar commits JSON recientes más allá del último checkpoint. En tablas a escala de petabytes con cientos de commits por hora y decenas de dashboards concurrentes, Iceberg reduce significativamente el gasto en peticiones de almacenamiento de objetos y evita bloqueos por throttling de S3 (HTTP 503), mientras que logs de Delta sin compactar pueden disparar micro-peticiones masivas si no se gestionan checkpoints de forma estricta.
Modele en tiempo real el gasto en cómputo multi-motor, volumen de llamadas API en S3, consumo de clústeres de compactación y coste por retención de datos.