
dbt vs Dagster (2026): Transformación SQL vs Orquestación Basada en Activos
Veredicto Rápido: La Falsa Dicotomía y la Decisión Arquitectónica Definitiva para 2026
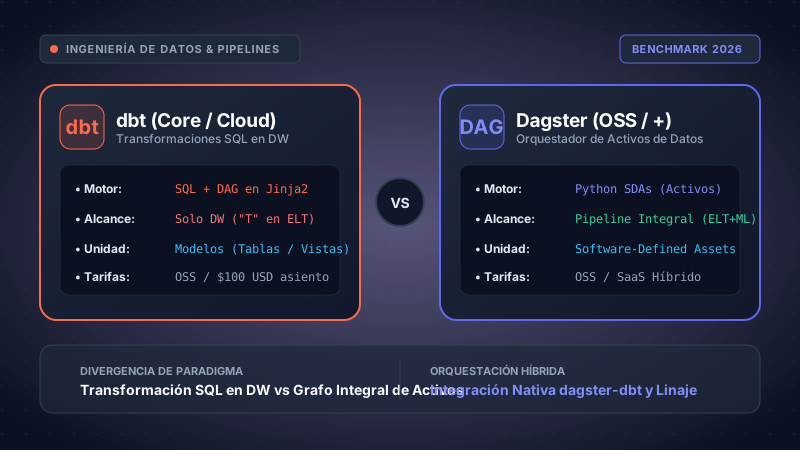
Plantear a dbt y Dagster como rivales excluyentes es uno de los malentendidos más extendidos en la ingeniería de datos contemporánea. dbt es un compilador de transformaciones SQL especializado estrictamente en ejecutar modelos dentro del almacén analítico mediante plantillas Jinja. Dagster es un orquestador de datos de última generación basado en el paradigma de Activos Definidos por Software (SDAs), diseñado para coordinar el ciclo de vida integral de la información a través de múltiples motores de cómputo.
Elige dbt en Solitario (Core o Cloud, 100 USD/asiento/mes) si tu perímetro operacional se encuentra 100% contenido dentro de un almacén cloud (Snowflake, BigQuery o Databricks), la ingesta está completamente delegada a conectores SaaS gestionados (Fivetran o Airbyte Cloud) y no requieres pipelines en Python, capas de Machine Learning, sensores reactivos ante eventos ni orquestación sub-horaria.
Elige Dagster (OSS o Dagster+) si tu plataforma abarca procesos heterogéneos: llamadas a APIs REST, aterrizaje de archivos Parquet en Amazon S3 o Google Cloud Storage, transformaciones pesadas en Apache Spark o Ray, entrenamiento de modelos en PyTorch y sincronizaciones operativas con herramientas Reverse ETL, exigiendo linaje declarativo, políticas de frescura y reprocesamientos (backfills) conscientes de particiones.
dagster-dbt. De este modo, se conservan los contratos y tests de dbt al tiempo que se integran en el grafo global de activos, observabilidad y gobernanza de Dagster.
Tabla de Contenidos
- 1. Fundamentos Arquitectónicos: SQL en Almacén vs Orquestación de Activos
- 2. Profundización de Paradigmas: Modelos dbt vs Activos Definidos por Software (SDAs)
- 3. Implementación Práctica: Caso Real de Código en dbt vs Dagster
- 4. La Simbiosis del Modern Data Stack: Integrando dbt en Dagster con dagster-dbt
- 5. Observabilidad, Linaje y Aislamiento de Fallos: dbt Explorer vs Dagster UI
- 6. Ergonomía para Desarrolladores y CI/CD: Slim CI vs Despliegues de Rama Efímeros
- 7. Matriz Comparativa Técnica Frente a Frente
- 8. Análisis FinOps y Modelado Matemático de Costes (TCO)
- 9. Seguridad Empresarial, Gobernanza, Retención Cero y Planos Híbridos
- 10. Marco de Decisión Estratégica: Arquetipos Organizacionales
- 11. Preguntas Frecuentes (FAQ)
1. Fundamentos Arquitectónicos: SQL en Almacén vs Orquestación de Activos
La maduración del Modern Data Stack (MDS) entre 2020 y 2026 consolidó la ingeniería analítica bajo estándares estrictos de desarrollo de software: control de versiones, integración continua, pruebas unitarias y entornos reproducibles. En el epicentro de esta disciplina emergen dbt (creado por dbt Labs) y Dagster (desarrollado por Elementl). Sin embargo, el debate corporativo suele confundir sus responsabilidades asumiendo que compiten en el mismo estrato tecnológico.
Para juzgarlos objetivamente, es imprescindible analizar sus principios fundacionales:
dbt (data build tool) nació con un propósito deliberadamente acotado y de altísimo impacto: gobernar la "T" del proceso ELT (Extract, Load, Transform). Históricamente, las transformaciones en bases de datos analíticas se implementaban mediante procedimientos almacenados imperativos, difíciles de versionar, sin pruebas de integridad y ejecutados mediante tareas ciegas de cron. dbt transformó radicalmente este paradigma al dotar a las sentencias SELECT de modularidad mediante Jinja2, compilación automática de grafos dirigidos acíclicos (DAGs) a través de la macro {{ ref(...) }}, parametrización de entornos y verificación de esquemas en tiempo de despliegue.
No obstante, dbt posee un límite arquitectónico estricto: no procesa datos por sí mismo. Opera como un compilador y orquestador interno de SQL que traduce archivos parametrizados a dialectos específicos (Snowflake SQL, Google BigQuery, Databricks Spark SQL, AWS Redshift o DuckDB) y delega la ejecución íntegra al motor de cómputo del almacén mediante conexiones JDBC/ODBC.
Dagster, por el contrario, fue concebido por Nick Schrock (coautor de GraphQL en Meta) con el objetivo de erradicar los defectos estructurales de los orquestadores tradicionales de tareas, como Apache Airflow, Luigi y Prefect 1.0. Las herramientas tradicionales modelan los flujos de datos como secuencias de tareas opacas (por ejemplo, BashOperator o PythonOperator). Cuando una tarea en Airflow finaliza exitosamente, el orquestador desconoce qué tabla se modificó, cuántas filas se insertaron o si el esquema sufrió una anomalía.
Dagster sustituye este modelo por el paradigma de los Activos Definidos por Software (Software-Defined Assets o SDAs). En Dagster, un activo es una declaración explícita en Python que representa un objeto de datos persistente (una tabla relacional, un directorio Parquet en AWS S3, un modelo predictivo serializado o una tabla de características para IA) vinculada a la función de código que lo produce. Al convertir el activo de datos y no la tarea informática en la entidad primaria del sistema, Dagster unifica la gobernanza y la observabilidad a través de toda la cadena de valor: extracción, transformación, computación distribuida e inferencia analítica.
2. Profundización de Paradigmas: Modelos dbt vs Activos Definidos por Software (SDAs)
Para contrastar cómo impacta cada paradigma en el trabajo diario de los equipos de datos, examinemos sus diferencias en cinco dimensiones estructurales:
| Dimensión Arquitectónica | dbt (Core / Cloud) | Dagster (OSS / Dagster+) |
|---|---|---|
| Abstracción Central | Modelo: Archivo .sql que formula una consulta declarativa envuelta en macros Jinja. |
Software-Defined Asset (SDA): Función en Python decorada con @asset que define dependencias de entrada y salida. |
| Ubicación del Cómputo | Exclusivamente en Almacén: Snowflake, BigQuery, Databricks, Redshift, DuckDB, Postgres. | Políglota y Universal: Consultas SQL en almacén, código Python local, clústeres Kubernetes, Spark, Ray, AWS Lambda. |
| Resolución de Linaje | Análisis sintáctico del código fuente buscando {{ ref('modelo') }} y {{ source(...) }}. |
Tipado estático en Python, argumentos de función coincidentes con claves de activos o deps=[AssetKey(...)]. |
| Calidad y Contratos | Pruebas genéricas a posteriori (unique, not_null) y contratos DDL forzados por el almacén. |
Decoradores @asset_check, validaciones con Pydantic/Pandera y registro dinámico de metadatos de ejecución. |
| Particionado y Reprocesos | Lógica condicional manual con is_incremental() dependiente de columnas de fecha. |
Definiciones nativas de particiones (DailyPartitionsDefinition) con interfaz visual de backfills matriciales. |
La conclusión arquitectónica fundamental radica en el perímetro: dbt desconoce qué ocurrió antes de que los datos aterrizaran en la tabla cruda (raw) del almacén, y desconoce qué sucederá después de que una tabla de reporting sea creada. Si un webhook de ingesta se detiene o retrasa su carga dos horas, dbt ejecutará sus transformaciones ciegamente sobre datos obsoletos a menos que un orquestador externo intervenga. Dagster, por el contrario, supervisa el flujo entero: detecta la llegada del archivo a S3, coordina la carga en el almacén, activa las transformaciones de dbt, comprueba las políticas de frescura y gatilla el reentrenamiento de un modelo predictivo en PyTorch.
3. Implementación Práctica: Caso Real de Código en dbt vs Dagster
Para apreciar la experiencia de desarrollo, analicemos cómo cada tecnología aborda un caso de uso común: la consolidación de transacciones de clientes, cálculo de valor de vida (LTV), validación de contratos de esquema y particionamiento incremental.
3.1 Implementación de un Modelo Incremental en dbt
En dbt, las reglas de negocio se estructuran en archivos SQL complementados por metadatos en YAML:
{{ config(
    materialized = 'incremental',
    unique_key = 'cliente_id',
    incremental_strategy = 'merge',
    on_schema_change = 'fail',
    cluster_by = ['cliente_id', 'ultimo_pedido_timestamp']
) }}

WITH stg_pedidos AS (
    SELECT
        pedido_id,
        cliente_id,
        monto_pedido_eur,
        estado,
        pedido_timestamp
    FROM {{ ref('stg_ecommerce__pedidos') }}
    {% if is_incremental() %}
        -- Reprocesar los últimos 3 días para mitigar eventos desfasados (late-arriving records)
        WHERE pedido_timestamp >= DATEADD('day', -3, (SELECT MAX(ultimo_pedido_timestamp) FROM {{ this }}))
    {% endif %}
),

agregaciones_cliente AS (
    SELECT
        cliente_id,
        COUNT(pedido_id) AS total_pedidos,
        SUM(CASE WHEN estado = 'completado' THEN monto_pedido_eur ELSE 0 END) AS total_ingresos_historicos_eur,
        MAX(pedido_timestamp) AS ultimo_pedido_timestamp,
        CURRENT_TIMESTAMP() AS dbt_actualizado_el
    FROM stg_pedidos
    GROUP BY cliente_id
)

SELECT
    cliente_id,
    total_pedidos,
    ROUND(total_ingresos_historicos_eur, 2) AS total_ingresos_historicos_eur,
    ultimo_pedido_timestamp,
    dbt_actualizado_el
FROM agregaciones_cliente
El contrato formal y los tests de calidad se declaran en el archivo complementario schema.yml:
version: 2

models:
  - name: fct_pedidos_clientes
    description: "Métricas consolidadas de clientes y cálculo de ingresos acumulados (LTV)."
    config:
      contract:
        enforced: true
    columns:
      - name: cliente_id
        data_type: varchar
        description: "Clave primaria anonimizada del cliente."
        tests:
          - unique
          - not_null
      - name: total_pedidos
        data_type: integer
        tests:
          - not_null
      - name: total_ingresos_historicos_eur
        data_type: numeric(18, 2)
        tests:
          - not_null
      - name: ultimo_pedido_timestamp
        data_type: timestamp_ntz
      - name: dbt_actualizado_el
        data_type: timestamp_tz
Ventajas de dbt: La sencillez y expresividad son máximas para analistas con conocimientos de SQL. No requiere desplegar contenedores, configurar clústeres de cómputo ni dominar conceptos avanzados de programación concurrente en Python.
3.2 Implementación de un Activo Definido por Software en Dagster
En Dagster, la lógica de datos se expresa en código nativo de Python, permitiendo registrar metadatos de ejecución en tiempo real, comprobar políticas de frescura e integrar tests atómicos:
from datetime import datetime
from dagster import (
    asset,
    asset_check,
    AssetCheckResult,
    AssetExecutionContext,
    DailyPartitionsDefinition,
    FreshnessPolicy,
    MaterializeResult,
    MetadataValue
)
from orquestacion.recursos.snowflake import RecursoSnowflake

particiones_diarias = DailyPartitionsDefinition(start_date="2025-01-01")

@asset(
    partitions_def=particiones_diarias,
    freshness_policy=FreshnessPolicy(maximum_lag_minutes=180),
    group_name="marts_financieros",
    compute_kind="snowflake_sql"
)
def pedidos_clientes_particionados(
    context: AssetExecutionContext,
    snowflake: RecursoSnowflake
) -> MaterializeResult:
    """
    Materializa la agregación diaria de pedidos en Snowflake
    registrando telemetría y metadatos de ejecución.
    """
    clave_particion = context.partition_key
    context.log.info(f"Procesando partición diaria de clientes para la fecha: {clave_particion}")

    sql = f"""
        CREATE OR REPLACE TABLE analitica.marts.pedidos_clientes_{clave_particion.replace('-', '_')} AS
        SELECT
            cliente_id,
            COUNT(pedido_id) AS total_pedidos,
            SUM(monto_pedido_eur) AS ingresos_diarios_eur,
            '{clave_particion}' AS fecha_particion
        FROM analitica.staging.stg_pedidos
        WHERE DATE(pedido_timestamp) = '{clave_particion}'
        GROUP BY cliente_id;
    """
    estadisticas = snowflake.ejecutar_consulta(sql)

    return MaterializeResult(
        metadata={
            "fecha_particion": clave_particion,
            "filas_afectadas": MetadataValue.int(estadisticas["filas"]),
            "id_consulta_snowflake": MetadataValue.text(estadisticas["query_id"]),
            "creditos_consumidos": MetadataValue.float(estadisticas["creditos"]),
            "vista_previa": MetadataValue.md(estadisticas["resumen_markdown"])
        }
    )

@asset_check(asset=pedidos_clientes_particionados)
def verificar_ingresos_no_negativos(snowflake: RecursoSnowflake) -> AssetCheckResult:
    """Verifica que ningún cliente presente ingresos diarios anómalos negativos."""
    anomalias = snowflake.consultar_escalar("""
        SELECT COUNT(*) FROM analitica.marts.pedidos_clientes
        WHERE ingresos_diarios_eur < 0
    """)
    cumplido = (anomalias == 0)
    return AssetCheckResult(
        passed=cumplido,
        metadata={"registros_con_ingreso_negativo": MetadataValue.int(anomalias)}
    )
Ventajas de Dagster: El control operativo es total. Cada materialización registra no solo el éxito de la tarea, sino el volumen de datos procesado, los créditos de cómputo devengados y las validaciones de calidad que bloquean o advierten de inconsistencias en tiempo real.
4. La Simbiosis del Modern Data Stack: Integrando dbt en Dagster con dagster-dbt
En arquitecturas de datos tradicionales, muchos ingenieros cometían el error de tratar a dbt como una tarea opaca de terminal dentro de su orquestador: dbt run && dbt test. Esta práctica es un grave antipatrón de diseño. Si un solo modelo falla entre 500 modelos que componen el repositorio, toda la tarea de Airflow se marcaba en rojo, sin capacidad de discernir qué tablas intermedias se habían actualizado correctamente y obligando a reprocesar todo el conjunto.
La librería oficial dagster-dbt redefine por completo esta interacción. En lugar de invocar a dbt como una caja negra, Dagster examina el proyecto en tiempo de carga e inspecciona el archivo de artefactos manifest.json:
from pathlib import Path
from dagster import AssetExecutionContext
from dagster_dbt import (
    DbtCliResource,
    dbt_assets,
    DagsterDbtTranslator,
    DagsterDbtTranslatorSettings
)

RUTA_PROYECTO_DBT = Path(__file__).joinpath("..", "..", "..", "dbt_almacen").resolve()

recurso_dbt = DbtCliResource(project_dir=RUTA_PROYECTO_DBT)
ruta_manifiesto = (
    RUTA_PROYECTO_DBT.joinpath("target", "manifest.json")
    if RUTA_PROYECTO_DBT.joinpath("target", "manifest.json").exists()
    else recurso_dbt.cli(["compile"]).wait().target_path.joinpath("manifest.json")
)

class TraductorPersonalizadoDbt(DagsterDbtTranslator):
    def get_group_name(self, dbt_resource_props):
        return dbt_resource_props.get("fqn", ["dbt"])[1]

@dbt_assets(
    manifest=ruta_manifiesto,
    dagster_dbt_translator=TraductorPersonalizadoDbt(
        settings=DagsterDbtTranslatorSettings(enable_asset_checks=True)
    )
)
def activos_almacen_dbt(context: AssetExecutionContext, dbt: DbtCliResource):
    """
    Expone cada modelo individual de dbt como un activo nativo
    (Software-Defined Asset) dentro del grafo de Dagster.
    """
    yield from dbt.cli(["build"], context=context).stream()
Al ejecutarse, dagster-dbt desglosa el grafo de dbt y lo inyecta en el catálogo de Dagster:
- Aislamiento Granular de Fallos: Si un modelo específico falla por una validación de clave única, únicamente se suspenden los modelos analíticos descendientes que dependen de él. Todos los modelos independientes continúan materializándose con normalidad.
- Linaje de Extremo a Extremo: Un activo de extracción en Python (por ejemplo, sincronizando transacciones desde Stripe o Salesforce) se conecta directamente al modelo de staging en dbt. Un modelo de propensión de compra en PyTorch se conecta a la salida del mart. El linaje nunca se fragmenta.
- Conversión de Pruebas en Comprobaciones de Activos: Los tests definidos en dbt (
not_null,unique, validaciones SQL) se transforman automáticamente en comprobaciones nativas de salud (AssetCheck), visibles y monitorizadas desde el panel central de Dagster.
5. Observabilidad, Linaje y Aislamiento de Fallos: dbt Explorer vs Dagster UI
La observabilidad en los pipelines de datos marca la diferencia entre solucionar una incidencia en 5 minutos o perder una mañana entera analizando logs de terminal ilegibles.
5.1 dbt Cloud Explorer
Dentro del ecosistema propietario de dbt Labs, la visibilidad se articula mediante dbt Cloud Explorer (disponible en planes Team y Enterprise):
- Inspección de Modelos: Ofrece un grafo visual interactivo de los modelos del almacén, linaje a nivel de columna, historial de compilación SQL y tiempos medios de construcción.
- Capa Semántica (dbt Semantic Layer): Permite trazar cómo se calculan las métricas de negocio definidas en MetricFlow a partir de los marts de datos.
- Límite Operativo: Explorer es ciego ante todo lo que ocurre fuera del almacén. No puede mostrar el retraso en la sincronización de las fuentes de origen (Fivetran/Airbyte) ni supervisar las aplicaciones o microservicios que leen los datos transformados.
5.2 Dagster UI (Dagit) y Catálogo Global de Activos
La interfaz de Dagster está unánimemente reconocida como la plataforma de observabilidad más avanzada de la industria de datos:
- Catálogo Unificado de Activos: Cada tabla, archivo Parquet o modelo ML cuenta con su propia ficha histórica: dependencias, esquemas, volumen de filas en el tiempo y duración de ejecuciones.
- Políticas de Frescura Declarativas: Mediante
FreshnessPolicy(maximum_lag_minutes=60), si un conjunto de datos no recibe registros frescos en 60 minutos, la interfaz alerta a los ingenieros antes de que los reportes ejecutivos muestren datos erróneos. - Matriz de Reprocesamiento por Partición: Dagster dibuja una cuadrícula bidimensional con el estado de cada partición diaria durante meses. Los ingenieros pueden seleccionar una fecha fallida concreta (ej. 15 de marzo de 2026) y relanzar el reprocesamiento exclusivo de ese día para decenas de tablas sin recalcular el histórico completo.
6. Ergonomía para Desarrolladores y CI/CD: Slim CI vs Despliegues de Rama Efímeros
La velocidad de entrega de un equipo de analítica depende de la agilidad de su ciclo de desarrollo y de la seguridad de sus tuberías de integración continua (CI/CD).
6.1 Desarrollo en dbt: CLI y Slim CI
dbt consolidó las mejores prácticas de la ingeniería analítica mediante su interfaz de comandos:
- Compilación Local: Con
dbt compile, los analistas comprueban de inmediato el código SQL traducido en la carpetatarget/compiled/antes de enviarlo a Snowflake o BigQuery. - Slim CI (Comparación de Estado): En proyectos empresariales con más de 2.000 modelos, ejecutar todo el repositorio en cada Pull Request de GitHub costaría cientos de dólares en cómputo. Slim CI resuelve esto comparando el
manifest.jsonde la rama con el de producción:dbt build --select state:modified+ --defer --state path/to/prod/artifactsSolo se construyen y prueban los modelos modificados y sus dependencias directas, reduciendo los tiempos de integración continua de 40 minutos a apenas 3 minutos.
6.2 Desarrollo en Dagster: Entornos Locales y Branch Deployments
Dagster traslada el rigor del desarrollo de software backend a los flujos de datos:
- Servidor Local Instantáneo: El comando
dagster devlevanta toda la interfaz web, el demonio y el planificador enlocalhost:3000en menos de 3 segundos, permitiendo iterar sin depender de conexiones cloud. - Pruebas Unitarias Rápidas con Pytest: Dado que los activos de Dagster son funciones estándar de Python, pueden validarse localmente mediante
pytestutilizando recursos simulados (Mocks o DataFrames sintéticos) sin gastar un solo céntimo en créditos de Snowflake:pytest tests/test_activos_clientes.py -k test_ingresos_no_negativos - Despliegues de Rama Efímeros (Dagster+ Branch Deployments): Cada vez que se abre un Pull Request en GitHub o GitLab, Dagster+ crea automáticamente un entorno de staging temporal e independiente. Los analistas y revisores de código pueden inspeccionar el grafo modificado, simular ejecuciones y verificar los datos antes de aprobar la fusión a
main.
7. Matriz Comparativa Técnica Frente a Frente
Evaluación técnica detallada entre dbt y Dagster basada en parámetros de producción actualizados para 2026. Puntuaciones asignadas en escala de 1.0 a 10.0:
| Criterio de Evaluación | dbt (Core / Cloud) | Dagster (OSS / +) | Análisis Arquitectónico y Compromisos |
|---|---|---|---|
| Especialización Principal | 9.8 / 10 | 9.4 / 10 | dbt es el referente incuestionable para modelado SQL en almacén; Dagster es el orquestador de activos más avanzado para pipelines integrales. |
| Curva de Aprendizaje y SQL | 9.9 / 10 | 7.8 / 10 | dbt posee una comunidad masiva, miles de paquetes públicos y nula barrera técnica para analistas que solo dominan SQL. |
| Orquestación Extremo a Extremo | 4.2 / 10 | 9.8 / 10 | dbt no puede coordinar tareas fuera del almacén (ingesta de APIs, jobs en Spark, modelos ML). Dagster orquesta todo el ecosistema de forma nativa. |
| Linaje de Datos Declarativo | 7.5 / 10 | 9.9 / 10 | El linaje en dbt se restringe a las tablas transformadas en el almacén. En Dagster abarca desde el origen en la API hasta el consumo en el modelo ML. |
| Particionado y Reprocesos (Backfills) | 5.5 / 10 | 9.7 / 10 | dbt delega el particionado en macros condicionales is_incremental(). Dagster ofrece soporte nativo temporal/estático con visualizador matricial. |
| Calidad y Validación de Datos | 8.8 / 10 | 9.5 / 10 | dbt comprueba tablas al concluir la corrida. Dagster admite validaciones pre y post ejecución con severidades configurables y alertas directas. |
| Integración Continua (CI/CD) | 8.5 / 10 | 9.6 / 10 | dbt Slim CI ahorra costes computacionales al diferir modelos no modificados. Dagster+ añade despliegues de rama efímeros con interfaz completa. |
| Autoalojamiento Open Source (OSS) | 9.2 / 10 | 8.4 / 10 | dbt Core es un paquete Python ligero ejecutable en contenedores o GitHub Actions. Dagster OSS requiere base PostgreSQL, demonio y clúster K8s. |
| Seguridad Híbrida Empresarial | 8.2 / 10 | 9.8 / 10 | dbt Cloud ofrece PrivateLink en Enterprise. La arquitectura híbrida de Dagster+ garantiza que el código y los datos nunca salgan de la VPC del cliente. |
8. Análisis FinOps y Modelado Matemático de Costes (TCO)
Para directores de tecnología (CTOs) y responsables de FinOps en empresas con presencia en la UE y América Latina, calcular el coste total de propiedad (TCO) exige analizar licencias SaaS, cómputo consumido en el almacén analítico, recursos de clústeres y horas de ingeniería de plataforma dedicadas al mantenimiento.
8.1 Ecuaciones Matemáticas para el Cálculo del TCO Anual
Las tres variantes de despliegue responden a las siguientes funciones matemáticas de coste:
Fórmula 1: TCO Anual de dbt Cloud (Plan Team / Enterprise)
Donde N_desarrolladores representa las licencias de edición ($100 USD/mes en Team), C_exceso_ejecucion son los recargos por modelos ejecutados con alta frecuencia, Q_dbt son los créditos consumidos en Snowflake/BigQuery por consultas de compilación y materialización, y H_mantenimiento son las horas de soporte interno.
Fórmula 2: TCO Anual de Dagster+ en Despliegue Híbrido
Donde la facturación de Dagster+ se basa en créditos de orquestación en el plano de control, C_agente_k8s es el coste del contenedor agente que ejecuta el código en el clúster EKS/GKE propio (~85 USD/mes), y las consultas analíticas Q_consultas se delegan directamente al almacén.
Fórmula 3: TCO Anual de Autoalojamiento Open Source (dbt Core + Dagster OSS / Airflow)
Donde el gasto en infraestructura incluye 3 instancias de cómputo (ej. c5.xlarge = ~3.600 USD/año), base de datos gestionada PostgreSQL (RDS = ~1.800 USD/año), y de forma crítica, Asignacion_FTE: entre el 25% y 40% del salario de un Senior Platform Engineer dedicado a parches, actualizaciones de Helm charts, rotación de secretos y soporte en guardia (equivalente a 30.000 a 48.000 USD/año).
8.2 Modelado Financiero Comparativo: Escenario Mediano vs Corporativo
Comparativa de costes reales (expresados en USD anuales) para dos dimensiones de empresa típicas:
| Partida de Gasto FinOps | Escenario A: Equipo Mediano (8 Ingenieros, 400 Modelos) dbt Cloud Team vs Dagster+ Híbrido |
Escenario B: Corporativo (35 Ingenieros, 2.500 Modelos) dbt Cloud Enterprise vs Dagster+ Híbrido |
|---|---|---|
| Suscripción SaaS Base |
dbt Cloud: $9.600/año (8 licencias @ $100/mes) Dagster+: $6.000/año (Consumo base) |
dbt Cloud Ent: $54.000/año (Paquete corporativo) Dagster+ Ent: $36.000/año (Créditos enterprise) |
| Ejecución y Runners |
dbt Cloud: $1.800/año (Tiempos de corrida) Dagster+: $1.200/año (Agente en K8s propio) |
dbt Cloud: $12.000/año (Sobrecostes de cómputo) Dagster+: $4.800/año (Pods agentes en EKS) |
| Cómputo en Almacén (Snowflake/BigQuery) | Idéntico: ~$36.000/año (Ambos delegan SQL) | Idéntico: ~$220.000/año (Consultas de transformación) |
| Horas de Mantenimiento Interno |
dbt Cloud: ~$7.200/año (40 h @ $180/h) Dagster+: ~$9.000/año (50 h soporte agente) |
dbt Cloud: ~$21.600/año (120 h gobernanza) Dagster+: ~$27.000/año (150 h sincronización RBAC) |
| Coste de Plataforma (Excluyendo DW) |
dbt Cloud: $18.600/año Dagster+: $16.200/año |
dbt Cloud: $87.600/año Dagster+: $67.800/año (Ahorro del 22.6%) |
Conclusión FinOps: Para departamentos pequeños centrados exclusivamente en consultas analíticas, dbt Cloud simplifica la contratación y evita gestionar infraestructura. No obstante, al superar los 20 ingenieros, el modelo híbrido de Dagster+ resulta notablemente más eficiente económicamente, ya que no penaliza a los analistas lectores con tarifas fijas por usuario y confina el cómputo de orquestación dentro de la infraestructura cloud propia.
9. Seguridad Empresarial, Gobernanza, Retención Cero y Planos Híbridos
En sectores regulados en España y Latinoamérica (finanzas, seguros, sanidad y administración pública), el requisito determinante no es la sintaxis, sino la privacidad: ¿Dónde reside el agente ejecutor y viajan datos confidenciales por los servidores del proveedor SaaS?
9.1 Despliegue Híbrido en Dagster+: Retención Cero de Datos (ZDR)
Dagster+ se construyó bajo un modelo de Arquitectura Híbrida Segura:
- Plano de Control (Alojado en Dagster SaaS): Mantiene la interfaz web, el catálogo de metadatos, la cola de tareas y los despachadores de alertas. El plano de control nunca tiene acceso directo a las bases de datos ni a los registros del cliente.
- Plano de Datos (En la VPC / Kubernetes del Cliente): Un agente ligero de Dagster se ejecuta dentro de su propio clúster (Amazon EKS, Google GKE o Azure AKS). Este agente establece conexiones salientes seguras mediante WebSockets hacia el plano de control para solicitar instrucciones.
- Retención Cero de Datos (Zero Data Retention): La información corporativa, las credenciales del almacén y el código fuente propietario residen íntegramente dentro de su perímetro privado. A los servidores de Dagster solo viajan confirmaciones de estado y resúmenes de metadatos (por ejemplo: "tabla materializada, 320.000 filas").
- Certificaciones: Auditorías SOC 2 Tipo II superadas, acuerdos BAA para cumplimiento de HIPAA y cumplimiento estricto del RGPD europeo.
9.2 Seguridad y Conectividad en dbt Cloud
dbt Cloud implementa una arquitectura SaaS gestionada con aislamiento de credenciales:
- Gestión de Credenciales: Las claves de Snowflake o credenciales de servicio de Google Cloud se almacenan cifradas en reposo mediante sobres KMS administrados por dbt Labs.
- Rutas de Red: Los runners de dbt Cloud envían consultas SQL directamente hacia el almacén del cliente a través de internet público o túneles seguros. Los resultados masivos de las tablas no viajan a dbt Cloud, pero los registros de compilación, trazas de errores y extractos de consultas sí se almacenan en su infraestructura.
- VPC Peering y Single-Tenant: En planes Enterprise, los clientes pueden contratar entornos aislados de un solo inquilino con interconexión privada mediante AWS PrivateLink o VPC Peering de Google Cloud.
10. Marco de Decisión Estratégica: Arquetipos Organizacionales
Para definir la arquitectura óptima, identifique en cuál de los siguientes cuatro arquetipos se ubica su organización:
Arquetipo 1: Analítica 100% en Almacén
Pila Técnica: Fivetran / Airbyte → Snowflake / BigQuery → dbt Cloud → Metabase / Power BI.
Recomendación: Adopta dbt en Solitario. Si el 100% de la lógica es SQL dentro del almacén y la ingesta está automatizada por conectores gestionados, introducir un orquestador completo añade complejidad innecesaria.
Arquetipo 2: Plataforma Moderna Híbrida Empresarial
Pila Técnica: Ingesta de APIs → Modelos dbt en Almacén → Spark / Modelos ML → Reverse ETL.
Recomendación: Despliega Dagster + dbt mediante dagster-dbt. El estándar de oro corporativo: los analistas desarrollan en SQL con dbt y los ingenieros de plataforma garantizan la observabilidad y el linaje de extremo a extremo en Dagster.
Arquetipo 3: Ingeniería en Lakehouse & Machine Learning
Pila Técnica: Amazon S3 / Delta Lake → PySpark / Polars / Ray → Feature Store → Embeddings / LLMs.
Recomendación: Adopta Dagster en Solitario. En pipelines basados en Python, dataframes distribuidos e inferencia de Machine Learning, el enfoque SQL de dbt es insuficiente. Dagster modela de forma natural activos de Python y objetos de cómputo avanzado.
Arquetipo 4: Código Abierto Estricto sin Licencias SaaS
Pila Técnica: Clúster Kubernetes interno propio, presupuesto cero para suscripciones externas.
Recomendación: dbt Core orquestado por Dagster OSS en Kubernetes. Los charts de Helm de Dagster son modernos, nativos en contenedores y mucho más sencillos de operar que los complejos clústeres heredados de Apache Airflow.
11. Preguntas Frecuentes (FAQ)
¿Es Dagster un competidor directo o un reemplazo total de dbt?
No. Dagster no es un reemplazo directo de dbt; es un orquestador de datos orientado a activos que opera en una capa arquitectónica superior. Mientras dbt se especializa exclusivamente en compilar y ejecutar modelos SQL modulares dentro del almacén cloud (Snowflake, BigQuery, Databricks), Dagster orquesta el ciclo de vida completo de los datos: desde la extracción de APIs e ingesta en S3 hasta modelos Spark, transformaciones SQL en dbt, entrenamiento de modelos de Machine Learning y sincronización Reverse ETL. En entornos empresariales de alta madurez, ambos conviven de forma simbiótica mediante dagster-dbt, que expone cada modelo dbt como un activo nativo dentro de Dagster.
¿Cuál es la diferencia fundamental entre la orquestación basada en tareas y los Activos Definidos por Software (SDAs)?
Los orquestadores tradicionales como Apache Airflow conciben los flujos como grafos de tareas imperativas opacas (ejecutar Script A, luego ejecutar Consulta B), sin conocimiento del estado del artefacto resultante. En contraste, Dagster estructura los pipelines en torno a Activos Definidos por Software (Software-Defined Assets o SDAs): funciones declarativas en Python donde la entidad principal es el dato persistente (una tabla relacional, un archivo Parquet o un modelo ML entrenado) junto con la lógica necesaria para materializarlo. Esto desbloquea políticas de frescura automáticas, linaje integral, backfills selectivos por partición y pruebas de calidad a nivel de activo.
¿Cómo funciona la integración oficial de dagster-dbt?
La librería dagster-dbt lee el archivo manifest.json generado por dbt en tiempo de compilación y traduce dinámicamente cada modelo SQL, seed y snapshot en un Software-Defined Asset nativo de Dagster. Cada modelo hereda automáticamente sus dependencias ascendentes y descendentes. En la interfaz gráfica de Dagster, los ingenieros pueden observar la ejecución en tiempo real, inspeccionar esquemas de columnas, transformar los tests de dbt en comprobaciones de activos (Asset Checks) y ejecutar rematerializaciones selectivas sin acceder a la línea de comandos de dbt.
¿Cómo se comparan los modelos de costes entre dbt Cloud y Dagster+ en 2026?
dbt Cloud factura bajo un esquema mixto de licencias por usuario y consumo: los asientos de desarrollador cuestan 100 USD/asiento/mes en el plan Team, mientras que en Enterprise se negocian paquetes anuales con cargos adicionales por minutos de ejecución. Dagster+ (anteriormente Dagster Cloud) utiliza un modelo de créditos basado en tiempo de cómputo del orquestador y recursos del plano de control, partiendo de paquetes de créditos de unos 10 USD. En despliegues híbridos, Dagster+ solo factura la coordinación SaaS mientras que las consultas corren en los clústeres EKS/GKE del cliente, permitiendo ahorros del 20% al 45% en equipos de más de 20 ingenieros.
¿Puede dbt Core sustituir a un orquestador en pipelines ELT sencillos?
Únicamente si la totalidad del flujo de datos reside dentro del almacén y la ingesta inicial está completamente delegada a herramientas gestionadas como Fivetran con sincronizaciones programadas. Sin embargo, dbt Core carece de un planificador persistente de demonios, sensores reactivos basados en eventos, dependencias entre sistemas externos y capacidad para ejecutar código fuera de la base de datos (como APIs Python, archivos no estructurados o inferencia ML). Depender únicamente de dbt Core ejecutado por cron genera puntos ciegos críticos en la gobernanza de datos.