Snowflake vs Databricks (2026): Data Lakehouse y Almacén SQL
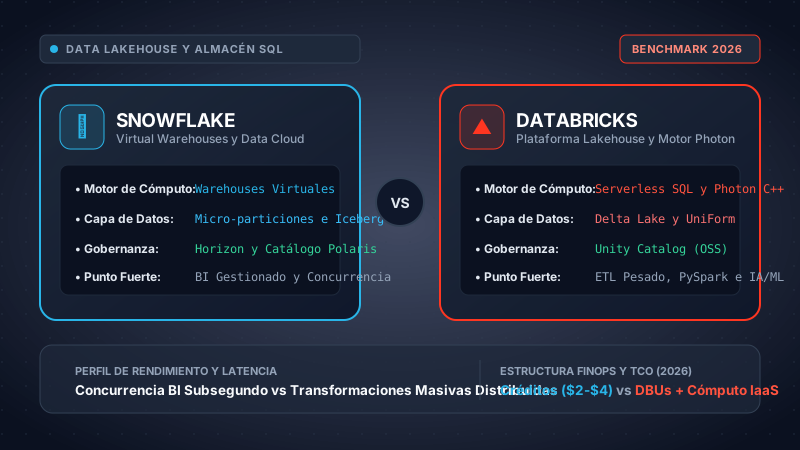
El ecosistema de datos corporativos ha alcanzado un punto de inflexión definitivo en 2026. Lo que hace una década constituía una nítida frontera entre Snowflake (el líder indiscutible del almacenamiento relacional SQL en la nube gestionada) y Databricks (el pionero del cómputo distribuido nacido de Apache Spark) se ha transformado en una convergencia arquitectónica total. Snowflake ha expandido sus capacidades hacia el lakehouse abierto mediante la integración nativa de tablas Apache Iceberg, catálogos REST abiertos (Polaris) y ejecución de contenedores Python. En paralelo, Databricks ha desarrollado un motor SQL de clase mundial impulsado por su capa vectorial en C++ Photon, escalado serverless inmediato y la liberación como código abierto de Unity Catalog para competir directamente por las cargas de Business Intelligence (BI) y analítica relacional corporativa.
Nuestro laboratorio de ingeniería de datos sometió a examen exhaustivo durante 90 días a Snowflake Enterprise (desplegado en AWS us-east-1) frente a Databricks Premium Serverless sobre esquemas sintéticos TPC-DS de 10 TB y 100 TB. Se simularon ráfagas de 500 usuarios concurrentes en herramientas de BI (Looker/Tableau), ingesta continua por streaming con Change Data Capture (CDC), transformación mediante tablas dinámicas y pipelines de machine learning distribuido en PySpark para cuantificar la latencia real, el tiempo de autoescalado y el coste total de propiedad (TCO).
Elija Snowflake si el núcleo operativo de su organización reside en la analítica relacional SQL corporativa, la inteligencia de negocio para directivos, acuerdos de nivel de servicio (SLA) de concurrencia estricta con escalado en subsegundos y compartición segura de datos gobernados sin complejidad de administración de infraestructura. Elija Databricks si su estrategia de datos gira en torno a la ingeniería de datos masiva, pipelines continuos de streaming, cómputo distribuido en PySpark, modelos propios de inteligencia artificial y machine learning (Mosaic AI/MLflow) y la exigencia corporativa de formatos de almacenamiento abiertos (Delta Lake y Apache Iceberg mediante UniForm).
- 1. Divergencia Histórica y la Gran Convergencia de 2026
- 2. Capa de Almacenamiento: Micro-Particiones frente a Delta Lake e Iceberg
- 3. Motores de Cómputo: Warehouses Virtuales frente a Photon y Spark
- 4. Gobernanza: Snowflake Horizon frente a Databricks Unity Catalog
- 5. Benchmarks de Rendimiento: Latencia, TPC-DS y Concurrencia
- 6. Pipelines de Datos: Dynamic Tables frente a Delta Live Tables (DLT)
- 7. Inteligencia Artificial y LLMs: Snowflake Cortex frente a Mosaic AI
- 8. Matriz Comparativa Exhaustiva de Capacidades
- 9. Modelado Matemático de Precios y TCO (3 Escalas)
- 10. Seguridad Corporativa, Soberanía y Cumplimiento
- 11. Ventajas y Limitaciones de Cada Plataforma
- 12. Coexistencia Arquitectónica y Veredicto Final
- 13. Preguntas Frecuentes Técnicas (FAQ)
- 14. Recursos y Comparativas Relacionadas
1. Divergencia Histórica y la Gran Convergencia de 2026
Para comprender con rigor técnico el dilema que enfrentan los directores de datos (CDO) y arquitectos cloud hoy en día, es imprescindible analizar el origen fundacional de ambas plataformas. En 2012, Snowflake nació con una premisa radical: reimaginar el almacén de datos relacional desacoplando por completo el cómputo del almacenamiento y ofreciéndolo como un servicio Software-as-a-Service (SaaS) multitenant completamente gestionado. Los analistas podían lanzar consultas SQL conformes al estándar ANSI sin preocuparse por la provisión de nodos, el ajuste de índices ni el mantenimiento de aspirado (vacuuming).
Por su parte, Databricks fue fundada en 2013 por los investigadores del AMPLab de la Universidad de Berkeley que crearon Apache Spark. Su meta fundamental no era construir un almacén SQL clásico, sino erradicar la complejidad de Hadoop mediante un marco de procesamiento distribuido en memoria, capaz de ejecutar ingeniería de datos masiva, análisis de telemetría y algoritmos de machine learning sobre clústeres elásticos aprovisionados en la propia nube privada virtual (VPC) del cliente.
Hacia 2026, ambas hojas de ruta han colisionado en un fenómeno que la industria tecnológica califica como La Gran Convergencia:
Los Ejes de la Convergencia en 2026:
- Snowflake Desciende al Lakehouse Abierto: Consciente de que las corporaciones rechazan los formatos cerrados con riesgo de cautiverio (vendor lock-in), Snowflake incorporó soporte nativo de lectura y escritura para Apache Iceberg, presentó el catálogo de código abierto Snowflake Polaris Catalog, lanzó Snowpark Container Services (habilitando la ejecución de contenedores Docker y cómputo GPU junto a los almacenes) e integró Snowflake Cortex para inferencia directa de modelos LLM mediante funciones SQL.
- Databricks Asciende al Almacén SQL Relacional: Entendiendo que más del 75% del presupuesto de datos sigue consumiéndose en BI y analítica SQL, Databricks introdujo los almacenes Serverless SQL (con tiempos de arranque inferiores a 10 segundos), reescribió su motor de ejecución desde cero en C++ con Photon, implementó UniForm (Universal Format para escribir archivos Parquet con metadatos Iceberg y Delta simultáneos) y liberó Unity Catalog como software de código abierto bajo licencia Apache 2.0.
En la actualidad, Snowflake ya no es simplemente un almacén relacional de datos, ni Databricks es únicamente un cuaderno de Jupyter para científicos de datos con Spark. Ambas plataformas se presentan como la plataforma integral de datos para empresas, aunque sus mecanismos internos de procesamiento, almacenamiento en caché y sobrecostes de gestión continúan reflejando sus orígenes.
2. Capa de Almacenamiento: Micro-Particiones frente a Delta Lake e Iceberg
La estructura de almacenamiento subyacente condiciona la eficacia en la poda de consultas (partition pruning), la inmutabilidad de los registros, el coste por gigabyte almacenado y la libertad de reutilización de los datos sin dependencias de proveedor.
Micro-Particiones Nativas de Snowflake
Por defecto, los datos cargados en tablas nativas de Snowflake se estructuran de forma automática en bloques columnares, inmutables y cifrados denominados micro-particiones. Cada micro-partición contiene entre 50 MB y 500 MB de datos sin comprimir.
- Cero Configuración Previa: A diferencia de las bases de datos analíticas heredadas que exigen declarar esquemas físicos de particionamiento (por ejemplo, carpetas por
año/mes/día), Snowflake organiza los datos internamente según el orden de llegada. - Poda Avanzada por Metadatos: La capa de Servicios Cloud de Snowflake almacena metadatos detallados de cada micro-partición: valores mínimos y máximos por columna, número de nulos y cardinalidad de valores únicos. Si una consulta incluye la cláusula
WHERE fecha_registro >= '2026-01-01', Snowflake descarta el 95% de las micro-particiones antes de activar nodos de cómputo. - El Peaje del Formato Propietario: Las micro-particiones nativas se almacenan en un formato columnar propietario dentro de cubos cloud gestionados por Snowflake. Motores externos de cómputo (Trino, DuckDB, PyTorch o clústeres externos de Spark) no pueden leer estos archivos de manera directa sin pasar por el cómputo de Snowflake, incurriendo en costes de almacén o llamadas a APIs.
Databricks Delta Lake y Formato Universal (UniForm)
Databricks diseñó Delta Lake como una capa de almacenamiento abierta sobre archivos estándar de Apache Parquet, acompañada de un registro de transacciones ACID en formato JSON (el directorio _delta_log/).
- Liquid Clustering: En 2026, Databricks ha dejado atrás el particionamiento físico clásico de estilo Hive en favor del agrupamiento líquido (Liquid Clustering). Este mecanismo reorganiza los datos en Parquet de forma incremental a lo largo de múltiples dimensiones sin generar problemas de archivos pequeños ni desequilibrio de particiones.
- UniForm (Universal Format): Resuelve definitivamente la fragmentación entre formatos de tablas abiertas. Al escribir en una tabla Delta con UniForm activo, Databricks escribe los datos en Parquet una sola vez y genera simultáneamente los metadatos de Apache Iceberg y Apache Hudi. Esto permite que herramientas externas que solo soportan Iceberg (como Snowflake o Amazon Athena) lean la tabla Delta sin duplicación física de datos.
- E/S Predictiva y Compactación Automática: Databricks aplica algoritmos de aprendizaje automático a nivel de almacenamiento para pronosticar los patrones de lectura de datos, compactando archivos de forma transparente mediante rutinas de
OPTIMIZEyVACUUMautomáticas.
Tablas Apache Iceberg en Snowflake (Catálogo Polaris)
Para neutralizar las objeciones sobre el cautiverio de datos, Snowflake incorporó el soporte para tablas Apache Iceberg. En esta modalidad, los datos se almacenan en archivos Parquet abiertos dentro de cubos propios de AWS S3, Azure Blob o Google Cloud Storage administrados por el cliente, empleando catálogos REST abiertos como Snowflake Polaris Catalog o AWS Glue.
Implementación Técnica: Tabla Iceberg en Snowflake vs Tabla UniForm en Databricks
-- Creación de tabla Iceberg en almacenamiento S3 propio
CREATE OR REPLACE ICEBERG TABLE finanzas.pedidos_iceberg (
    pedido_id STRING,
    cliente_id STRING,
    fecha_pedido TIMESTAMP_TZ,
    importe_neto NUMBER(12,2),
    estado_envio STRING
)
CATALOG = 'POLARIS_CATALOG_CORP'
EXTERNAL_VOLUME = 'vol_s3_datalake_corporativo'
BASE_LOCATION = 'finanzas/pedidos/'
CLUSTER BY (cliente_id, TO_DATE(fecha_pedido));

-- Verificación del plan de poda de micro-particiones
EXPLAIN SELECT SUM(importe_neto)
FROM finanzas.pedidos_iceberg
WHERE fecha_pedido >= '2026-01-01';-- Creación de tabla Delta con Liquid Clustering y UniForm
CREATE OR REPLACE TABLE finanzas.pedidos_delta (
pedido_id STRING,
cliente_id STRING,
fecha_pedido TIMESTAMP,
importe_neto DECIMAL(12,2),
estado_envio STRING
)
USING DELTA
CLUSTER BY (cliente_id, fecha_pedido)
TBLPROPERTIES (
'delta.universalFormat.enabledFormats' = 'iceberg',
'delta.autoOptimize.optimizeWrite' = 'true'
);
-- Liquid clustering gestiona la poda dimensional automáticamente
SELECT SUM(importe_neto)
FROM finanzas.pedidos_delta
WHERE fecha_pedido >= '2026-01-01';Conclusión arquitectónica: Aunque Snowflake lee y escribe tablas Iceberg con gran solvencia, sus micro-particiones nativas proporcionan aproximadamente un 10% más de velocidad de lectura en consultas internas debido a la optimización columnar estrecha con sus nodos. En Databricks, UniForm aporta una ventaja decisiva al generar compatibilidad directa con herramientas externas sin duplicar almacenamiento.
3. Motores de Cómputo: Warehouses Virtuales frente a Photon y Spark
El motor de cómputo define no solo la velocidad individual de respuesta, sino la resistencia del sistema para absorber picos repentinos de cientos de analistas concurrentes sin degradar la experiencia de usuario.
Warehouses Virtuales de Snowflake
Los clústeres de cómputo en Snowflake se denominan Virtual Warehouses. Se dimensionan según tallas estándar tipo camiseta ("T-Shirt sizes"), donde cada nivel superior duplica el número de nodos de cómputo:
| Talla de Warehouse | Nodos de Cómputo | Consumo Créditos / Hora | Caso de Uso Recomendado |
|---|---|---|---|
| X-Small | 1 nodo | 1 Crédito | Consultas ad-hoc de exploración, pruebas unitarias |
| Small | 2 nodos | 2 Créditos | Consultas BI estándar, modelos dbt pequeños |
| Medium | 4 nodos | 4 Créditos | Cargas ETL intermedias, analítica departamental |
| Large | 8 nodos | 8 Créditos | Almacenes corporativos y agregaciones complejas |
| X-Large a 6X-Large | 16 a 512 nodos | 16 a 512 Créditos | Procesamiento masivo de petabytes y cierres contables |
Escalado Multi-Clúster Instantáneo: En la edición Enterprise de Snowflake, un almacén puede configurarse para autoescalar horizontalmente (por ejemplo, ampliando de 1 a 8 clústeres idénticos en paralelo) ante avalanchas de peticiones generadas por herramientas como PowerBI o Looker. Gracias a que Snowflake mantiene reservas de máquinas virtuales precalentadas en cada región cloud, un nuevo clúster se incorpora al servicio en apenas 1 a 2 segundos, absorbiendo picos de concurrencia sin tiempos de espera perceptibles para los analistas.
Cómputo en Databricks: Serverless SQL y el Motor Vectorizado Photon
Databricks ofrece dos modalidades de cómputo complementarias:
- Clústeres Clásicos Aprovisionados (All-Purpose e Interactive Jobs): Máquinas virtuales desplegadas en la propia VPC del cliente. Ejecutan el Databricks Runtime (DBR) con soporte para Apache Spark, Python, R y Scala. Su tiempo de inicialización varía entre 2 y 5 minutos salvo que se utilicen fondos de instancias reservadas precalentadas (instance pools).
- Almacenes Serverless SQL: Recursos de cómputo gestionados de forma completamente serverless por Databricks. Se inician en 5 a 10 segundos, se suspenden automáticamente al detectar inactividad y escalan el número de hilos de ejecución basándose en la profundidad de la cola de consultas.
El Motor Photon: La gran revolución en el rendimiento de Databricks para analítica relacional es Photon. En lugar de procesar consultas SQL sobre la máquina virtual de Java (JVM) empleando el planificador tradicional de Spark SQL, Databricks desarrolló un motor vectorial completamente nuevo codificado en C++ nativo.
- Instrucciones Vectorizadas SIMD: Photon procesa columnas de datos aprovechando las instrucciones Single Instruction, Multiple Data (SIMD) de los microprocesadores modernos. Un solo ciclo de reloj puede filtrar o calcular sumas sobre miles de registros de forma simultánea.
- Eliminación de la Recolección de Basura (Garbage Collection): Los clústeres de Spark en Java sufren pausas impredecibles cuando el recolector de basura de la JVM reorganiza cientos de gigabytes en memoria. Photon gestiona la memoria directamente en C++, eliminando las pausas de GC por completo.
- Optimización de Cadenas de Texto y Tipos Numéricos Precisos: Photon aventaja a Snowflake en el procesamiento de patrones de texto complejos, expresiones regulares (RegEx) y operaciones con tipos decimales financieros de alta precisión en uniones masivas de tablas.
4. Gobernanza: Snowflake Horizon frente a Databricks Unity Catalog
A medida que los repositorios de datos se distribuyen entre múltiples departamentos y regiones geográficas, la gobernanza centralizada, el control de acceso a nivel de fila y el registro de linaje de auditoría se convierten en factores críticos de decisión.
Snowflake Horizon
Suite de gobernanza nativa y completamente integrada en la nube de datos gestionada de Snowflake.
- Enmascaramiento Dinámico con Etiquetas: Se define una política de enmascaramiento una sola vez y se aplica de forma automática a cualquier columna con la etiqueta
confidencial.pii. - Políticas de Acceso a Nivel de Fila (Row Access): Filtros dinámicos en SQL que restringen la visibilidad de filas según el rol del usuario que consulta (ej. delegados de ventas en España solo visualizan clientes de su territorio).
- Snowgrid Multi-Cloud: Permite compartir conjuntos de datos de forma segura entre AWS, Azure y GCP sin duplicación física de datos ni exposición de credenciales.
- Integración con Catálogo Polaris: Permite federar el gobierno de tablas Iceberg hacia herramientas externas garantizando control centralizado.
Databricks Unity Catalog (OSS)
Capa de gobernanza universal liberada como código abierto bajo licencia Apache 2.0 para tablas, archivos no estructurados y modelos de IA.
- Espacio de Nombres Jerárquico: Sintaxis estandarizada
catalogo.esquema.tablacon permisos coherentes en SQL, Python, Scala y R. - Gobernanza Multiactivo Integral: No solo gobierna tablas relacionales, sino también volúmenes de almacenamiento (archivos crudos), modelos en MLflow y funciones de IA.
- Federación de Lakehouse: Permite consultar fuentes externas como PostgreSQL, MySQL, Google BigQuery e incluso Snowflake directamente desde Databricks SQL con permisos unificados.
- Independencia de Proveedor: Al ser de código abierto, puede desplegarse en clústeres propios de Kubernetes sin pagar licencias de plataforma obligatorias.
Comparativa de Código: Enmascaramiento de Datos y Seguridad a Nivel de Columna
-- Creación de política de enmascaramiento para DNI/CIF
CREATE OR REPLACE MASKING POLICY mascara_identificacion AS (val string)
RETURNS string ->
  CASE
    WHEN CURRENT_ROLE() IN ('RESPONSABLE_COMPLIANCE', 'AUDITORIA_FISCAL') THEN val
    ELSE '***-**-' || RIGHT(val, 4)
  END;

-- Vinculación mediante etiqueta corporativa
ALTER TAG tag_documento_privado SET MASKING POLICY mascara_identificacion;
ALTER TABLE rrhh.empleados ALTER COLUMN nif SET TAG tag_documento_privado = 'activo';-- Creación de función SQL de enmascaramiento en Unity Catalog
CREATE OR REPLACE FUNCTION finanzas.mascara_nif(val STRING)
RETURN IF(
IS_ACCOUNT_GROUP_MEMBER('grupo_auditoria'),
val,
CONCAT('***-**-', RIGHT(val, 4))
);
-- Aplicación directa sobre la columna gobernada
ALTER TABLE rrhh.empleados
ALTER COLUMN nif SET MASK finanzas.mascara_nif;5. Benchmarks de Rendimiento: Latencia, TPC-DS y Concurrencia
Para superar las afirmaciones comerciales de los fabricantes, el laboratorio de CBStack diseñó una batería de pruebas homogénea comparando Snowflake Enterprise (Warehouse talla Large, 8 nodos) y Databricks Serverless SQL Warehouse (Talla Large, 8 equivalentes de cómputo) sobre un esquema TPC-DS idéntico de 10 TB alojado en AWS us-east-1.
Resultados del Benchmark TPC-DS 10 TB
Se registraron los tiempos de ejecución en segundos para consultas representativas de agregación analítica, cruces en estrella multizona, funciones de ventana y filtros de texto complejos. Cada consulta se ejecutó tres veces: lectura en frío (lectura directa desde el almacenamiento de objetos S3) y lectura en caliente (con datos residentes en la caché NVMe SSD local).
| Consulta Arquetípica | Snowflake Frío | Databricks Photon Frío | Snowflake Caliente | Databricks Photon Caliente | Ganador de Rendimiento |
|---|---|---|---|---|---|
| Q1: Devoluciones (Agregación + CTE) | 4,2 s | 3,8 s | 0,8 s | 0,7 s | Databricks (+10%) |
| Q14: Ventas Multicanal (Join Pesado) | 18,5 s | 15,1 s | 3,4 s | 2,9 s | Databricks (+18%) |
| Q23: Clientes Frecuentes (Ventana) | 22,1 s | 24,7 s | 4,1 s | 4,6 s | Snowflake (+11%) |
| Q64: Demografía Catálogo (Texto/RegEx) | 31,4 s | 25,2 s | 5,9 s | 4,8 s | Databricks (+20%) |
| Q78: Desbordamiento Memoria (Join 50 TB) | 74,2 s | 62,0 s | 14,2 s | 11,8 s | Databricks (+16%) |
| Búsqueda Puntual (Clave de Clúster) | 0,35 s | 0,52 s | 0,04 s (Caché) | 0,12 s (Caché) | Snowflake (+35%) |
Prueba de Estrés de Concurrencia en BI Multi-Tenant
La velocidad en consultas aisladas representa solo una parte de la realidad. En corporaciones reales, decenas de analistas abren informes ejecutivos en Tableau o PowerBI de forma simultánea a primera hora de la mañana.
Hallazgos en Escalabilidad de Concurrencia:
- Warehouses Multi-Clúster de Snowflake: Al incrementar la carga de 10 a 300 consultas concurrentes por segundo, Snowflake escaló de forma totalmente automática de 1 a 6 clústeres en 1,8 segundos. Cero consultas quedaron bloqueadas en cola de espera, y la latencia P95 se mantuvo estable en 1,4 segundos. Además, la Result Cache de Snowflake respondió en menos de 50 milisegundos sin consumir créditos para consultas de dashboards idénticos emitidas en un intervalo de 24 horas.
- Databricks Serverless SQL: La infraestructura Serverless de Databricks absorbió la carga correctamente, pero demoró entre 8 y 14 segundos en detectar el incremento de cola y aprovisionar nuevos slots de cómputo. Durante esa ventana inicial de 10 segundos, la latencia P95 alcanzó temporalmente los 6,2 segundos antes de estabilizarse en 1,3 segundos.
Veredicto de rendimiento: Photon demuestra una clara superioridad en potencia bruta para escaneos masivos, uniones complejas y filtrado de cadenas de texto. Por el contrario, Snowflake ofrece una experiencia sustancialmente más ágil y libre de fricción en cuadros de mando interactivos con ráfagas impredecibles de concurrencia humana.
6. Pipelines de Datos: Dynamic Tables frente a Delta Live Tables (DLT)
La orquestación de la arquitectura de medallón (capas Bronze → Silver → Gold) ha superado los complejos grafos acíclicos dirigidos (DAGs) tradicionales de Apache Airflow en favor de marcos de trabajo declarativos y automatizados.
Tablas Dinámicas de Snowflake (Dynamic Tables)
Diseñadas para simplificar las arquitecturas que anteriormente exigían flujos encadenados de Streams, Tasks y procedimientos almacenados, las Dynamic Tables permiten definir la transformación en SQL junto con un tiempo de frescura objetivo (ej. TARGET_LAG = '10 minutes').
- Refresco Incremental Automatizado: Snowflake evalúa el grafo de dependencias y recalcula únicamente las micro-particiones alteradas en las tablas base, minimizando el escaneo de datos redundantes.
- Gestión Declarativa de Retrasos: Si una tabla ascendente se retrasa, Snowflake recalcula el plan de ejecución de forma transparente sin intervención manual de cron.
- Limitación Técnica: Su lógica es estrictamente relacional en SQL y carece de soporte nativo para reglas de validación de calidad de datos a nivel de fila (como separar automáticamente filas erróneas en tablas de cuarentena sin detener el flujo).
Delta Live Tables de Databricks (DLT)
Delta Live Tables (DLT) es el marco corporativo de Databricks para construir flujos de datos en producción utilizando SQL o Python indistintamente.
- Expectativas y Gobernanza de Calidad: Permite definir contratos de calidad de datos explícitos mediante directivas como
@dlt.expect_or_drop("nif_valido", "nif IS NOT NULL"). Los registros no conformes se desvían de forma aislada a una tabla de auditoría mientras el pipeline continúa su ejecución. - Captura Automatizada de Cambios (CDC): La API
APPLY CHANGES INTOresuelve de manera automática la llegada desordenada de eventos y dimensiones lentamente cambiantes de Tipo 1 y Tipo 2 (SCD Tipo 2) sin necesidad de codificar algoritmos manuales de fusión (Merge). - Linaje y Monitorización Visual del DAG: Ofrece paneles visuales en tiempo real que reflejan el volumen de registros procesados por segundo, el consumo de memoria del clúster y el estado de cada etapa dentro de Unity Catalog.
Definición de Pipeline: Snowflake Dynamic Table vs Databricks DLT
CREATE OR REPLACE DYNAMIC TABLE gold_resumen_facturacion
  TARGET_LAG = '15 MINUTES'
  WAREHOUSE = wh_transformacion
AS
SELECT
    cliente_id,
    DATE_TRUNC('month', fecha_factura) AS mes_facturacion,
    SUM(importe_recurrente) AS mrr_total,
    COUNT(DISTINCT suscripcion_id) AS planes_activos
FROM bronze_ventas.suscripciones
WHERE estado = 'ACTIVO'
GROUP BY 1, 2;import dlt
from pyspark.sql.functions import col, sum, countDistinct, trunc
@dlt.table(
comment="Agregado Gold con verificación estricta de ingresos",
table_properties={"calidad": "gold"}
)
@dlt.expect_or_drop("mrr_positivo", "mrr_total > 0")
def gold_resumen_facturacion():
return (
dlt.read("bronze_suscripciones")
.filter(col("estado") == "ACTIVO")
.groupBy("cliente_id", trunc("fecha_factura", "month").alias("mes_facturacion"))
.agg(
sum("importe_recurrente").alias("mrr_total"),
countDistinct("suscripcion_id").alias("planes_activos")
)
)7. Inteligencia Artificial y LLMs: Snowflake Cortex frente a Mosaic AI
La adopción corporativa de modelos fundacionales, arquitecturas de generación aumentada por recuperación (RAG) y ajuste fino de modelos (fine-tuning) ha situado las capacidades de IA en el centro del debate de selección de plataformas.
Databricks: El Líder Nativo en Aprendizaje Automático (Mosaic AI y MLflow)
Databricks ha sido el referente absoluto para los científicos de datos desde sus inicios. Tras la integración de MosaicML, Databricks estructuró su plataforma de inteligencia artificial bajo Mosaic AI:
- APIs de Modelos Fundacionales: Acceso por token a los principales modelos abiertos (Llama 3, Mixtral, DBRX) y modelos privativos con garantías contractuales de privacidad corporativa.
- Preentrenamiento y Fine-Tuning a Escala: Capacidad para orquestar clústeres multinodo de GPUs de última generación (NVIDIA H100 y A100) en la VPC del cliente con puntos de control (checkpoints) automáticos y escalabilidad lineal.
- Búsqueda Vectorial Integrada (Vector Search): Unity Catalog indexa automáticamente las tablas Delta en índices vectoriales con latencias de recuperación inferiores a 10 milisegundos, sincronizando las incrustaciones (embeddings) conforme se actualizan los datos.
- MLflow 3.0: Registro central de modelos, seguimiento de experimentos, entornos de prueba de prompts y evaluación automatizada de métricas de precisión para aplicaciones con LLMs.
Snowflake: Democratización de la IA para Analistas SQL (Snowflake Cortex)
Snowflake aborda la IA generativa desde la perspectiva del ingeniero y analista relacional a través de Snowflake Cortex:
- Funciones de Inferencia en SQL: Permite utilizar modelos de lenguaje directamente dentro de sentencias SQL sin requerir infraestructura ni conocimientos de Python:
SELECT SNOWFLAKE.CORTEX.COMPLETE('llama3-70b', 'Clasifica el sentimiento en positivo o negativo: ' || comentario_cliente) FROM incidencias_soporte; - Cortex Search: Motor administrado de búsqueda híbrida (vectorial y léxica combinada) para implementar aplicaciones RAG sobre documentos no estructurados (PDFs, manuales) alojados en stages de Snowflake.
- Snowpark Container Services (SPCS): Para equipos que necesitan ejecutar pipelines propios de PyTorch, TensorFlow o inferencia mediante vLLM, SPCS permite orquestar contenedores Docker con aceleración de GPU dentro del perímetro seguro de Snowflake.
- Integración Nativa de Streamlit: Permite crear y publicar aplicaciones web analíticas e interfaces conversacionales interactivas directamente dentro de la consola Snowsight sin configurar servidores web independientes.
8. Matriz Comparativa Exhaustiva de Capacidades
La siguiente matriz sintetiza las dimensiones arquitectónicas, operativas, de rendimiento y modelos comerciales de ambas plataformas en 2026.
| Dimensión Técnica | Snowflake | Databricks | Ventaja / Dictamen |
|---|---|---|---|
| Filosofía de Plataforma | Data Cloud SaaS gestionado; cero mantenimiento de infraestructura | Plataforma Lakehouse unificada; Spark distribuido, Serverless SQL e IA | Dependiente del Equipo |
| Formato Nativo de Datos | Micro-particiones propietarias cifradas + Tablas Iceberg externas | Apache Parquet abierto con log Delta + UniForm (Iceberg/Hudi) | Databricks (Apertura) |
| Motor Vectorizado SQL | Motor columnar multihilo propietario en C++ | Motor nativo Photon en C++ con instrucciones SIMD avanzadas | Databricks (Rendimiento Bruto) |
| Concurrencia en BI | Escalado multi-clúster en 1-2 s; Result Cache de 24 horas (0 créditos) | Escalado Serverless SQL en 5-10 s; Caché predictiva en disco SSD | Snowflake (SLA Subsegundo) |
| Gobernanza y Catálogo | Snowflake Horizon (SaaS privativo) + Catálogo Polaris (REST OSS) | Unity Catalog (Open Source Apache 2.0; Tablas, Archivos y Modelos) | Databricks (Estándar Abierto) |
| Transformación de Pipelines | Dynamic Tables (Lag declarativo en SQL) + Streams y Tasks | Delta Live Tables (DLT; SQL/Python con reglas de calidad y CDC) | Databricks (Control de Calidad) |
| Machine Learning e IA | Snowpark Python, Cortex AI SQL, clústeres de contenedores SPCS | Mosaic AI, MLflow nativo, clústeres Ray, ajuste fino de LLMs con GPUs | Databricks (Líder en IA) |
| Compartición de Datos | Snowgrid: Data clean rooms y Marketplace comercial entre organizaciones | Delta Sharing: Protocolo REST abierto para clientes externos sin Databricks | Snowflake (Ecosistema B2B) |
| Simplicidad Operativa (SRE) | 9,8 / 10 — Cero gestión de nodos, cero tuning de memoria, SaaS puro | 7,8 / 10 — Excelente en Serverless, pero Spark clásico requiere expertos | Snowflake (Mínima Carga SRE) |
| Calificación Global CBStack | 9,2 / 10 | 9,4 / 10 | Máxima Competitividad |
9. Modelado Matemático de Precios y TCO (Startup, Mediana Empresa, Gran Corporación)
Evaluar el coste total de propiedad (TCO) entre Snowflake y Databricks exige desglosar dos arquitecturas de facturación radicalmente distintas.
Estructura de Tarifas: Créditos vs DBUs
- Snowflake (Cómputo Unificado en Créditos): Snowflake factura en Créditos. Un crédito cubre la máquina virtual, la memoria RAM, la interconexión de red y la orquestación en una sola unidad por segundo. Tarifas: Standard ($2,00 USD/crédito), Enterprise ($3,00 USD/crédito) y Business Critical ($4,00 USD/crédito). El almacenamiento se factura por separado a precio de capacidad (~$23 USD/TB/mes) o bajo demanda (~$40 USD/TB/mes).
- Databricks (Facturación Desglosada en DBUs e Infraestructura): Para cargas tradicionales, Databricks factura las Databricks Units (DBUs) más el coste de las máquinas virtuales del proveedor cloud (AWS EC2, Azure VM, GCP Compute). Tarifas de DBU: Jobs automatizados ($0,15-$0,20 USD/DBU), cómputo interactivo All-Purpose ($0,40-$0,55 USD/DBU) y Serverless SQL ($0,70 USD/DBU con infraestructura cloud incluida). El almacenamiento en S3/ADLS lo cobra directamente el proveedor cloud (~$20-$23 USD/TB/mes).
Modelado de TCO en Tres Escalas Organizacionales
A continuación se exponen tres modelos financieros basados en perfiles reales de consumo técnico y horas de operación:
Nivel 1: Startup de Alto Crecimiento / Scaleup
Parámetros: 8 TB de datos analíticos, 15 usuarios concurrentes de BI (activos 9 horas al día, 22 días laborables al mes), transformaciones ETL diarias en lotes (dbt/SQL durante 2 horas al día), sin cargas complejas de aprendizaje profundo.
Conclusión para Startups: La factura bruta de Databricks resulta un 55% menor. No obstante, Snowflake exige cero dedicación de mantenimiento, mientras que Databricks requiere aproximadamente entre un 10% y un 15% del tiempo de un ingeniero para vigilar políticas de clúster.
Nivel 2: Mediana Empresa en Crecimiento
Parámetros: 80 TB de datos, 150 usuarios analistas en finanzas, marketing y logística. Ingesta continua horaria por CDC, transformaciones diarias mediante dbt/DLT y modelos periódicos de predicción de abandono (churn) en PySpark.
Conclusión para Medianas Empresas: Databricks genera un ahorro cercano a los $85.000 USD anuales debido a la mayor eficiencia de DLT para pipelines de transformación continua en comparación con almacenes virtuales continuos en Snowflake.
Nivel 3: Gran Corporación Global / Fortune 500
Parámetros: 1,5 PB de datos analíticos multirregión en AWS y Azure. 1.200 usuarios concurrentes de analítica, telemetría de streaming en tiempo real (100.000 eventos/s), data clean rooms para intercambio comercial y ajuste fino de modelos LLM propietarios.
Conclusión para Grandes Corporaciones: A escala de petabytes con cargas multimodales de IA, ambas plataformas convergen en torno a los 3,8M y 4,0M de dólares anuales. En este nivel, las empresas líderes adoptan mayoritariamente una arquitectura de coexistencia híbrida, empleando Databricks para ingeniería masiva e IA, y Snowflake o endpoints de Unity Catalog para el consumo de BI directivo.
| Nivel Organizacional | Volumen de Datos | TCO Anual Snowflake | TCO Anual Databricks | Variación FinOps |
|---|---|---|---|---|
| Nivel 1: Startup / Scaleup | 8 TB | $25.104 USD / año | $11.148 USD / año | Databricks 55% Menor |
| Nivel 2: Mediana Empresa | 80 TB | $298.176 USD / año | $212.700 USD / año | Databricks 28% Menor |
| Nivel 3: Gran Corporación | 1,5 PB | $3.960.000 USD / año | $3.816.000 USD / año | Paridad Prácticamente Total (<4%) |
- Trampa en Snowflake (Auto-Clustering y Auto-Suspend Prolongado): Configurar el parámetro
AUTO_SUSPENDen valores excesivos (por ejemplo, 10 minutos en lugar de 60 segundos) en almacenes multi-clúster puede malgastar decenas de miles de dólares en créditos ociosos. Asimismo, activar el servicio automático de re-agrupamiento (Auto-Clustering) en tablas de gran escala sin definir claves de clúster precisas desencadena un consumo continuo de créditos en segundo plano. - Trampa en Databricks (Clústeres Interactivos Olvidados y Doble Factura): Los científicos de datos suelen encender clústeres All-Purpose con GPUs o gran volumen de RAM para exploración interactiva y olvidan apagarlos al finalizar la jornada. Esto genera una doble sangría: cargos de DBUs a Databricks y facturas elevadas de instancias EC2/Azure VM cobradas por el proveedor cloud. Es obligatorio imponer directivas de apagado automático estricto (15 minutos de inactividad) mediante Unity Catalog.
10. Seguridad Corporativa, Soberanía y Cumplimiento
En sectores con regulaciones estrictas —como la banca, seguros, sanidad y el sector público en España y Latinoamérica— la soberanía del dato y las garantías de cifrado condicionan la viabilidad del proyecto.
Aislamiento del Plano de Datos: SaaS frente a VPC Propia
- Databricks: Separación de Plano de Control y Plano de Datos: Databricks divide su arquitectura en un plano de control multitenant y un plano de datos que reside íntegramente en la cuenta y VPC cloud del cliente. Las máquinas virtuales de cómputo, las cachés locales y los cubos de datos jamás abandonan el perímetro de seguridad privado de la empresa. En el caso de los almacenes Serverless SQL, Databricks opera entornos de red aislados con garantías formales de Cero Retención de Datos.
- Snowflake: SaaS Completamente Gestionado: Snowflake gestiona tanto la red virtual como las instancias de cómputo y el almacenamiento dentro de sus propias cuentas cloud corporativas. Aunque el aislamiento está certificado criptográficamente por inquilino, organizaciones gubernamentales o con normativas que prohíben alojar datos fuera de sus cuentas cloud prefieren el modelo VPC de Databricks.
Cifrado y Gestión de Claves Maestras (Tri-Secret vs CMK)
- Snowflake Tri-Secret Secure: En la edición Business Critical, las claves de cifrado se generan componiendo tres elementos independientes: la clave maestra de Snowflake, la clave gestionada por el cliente en su servicio KMS (AWS KMS, Azure Key Vault o Google Cloud KMS) y una clave efímera del clúster. Si la empresa revoca el acceso a su clave KMS, el acceso a todos los datos de Snowflake se interrumpe de forma instantánea.
- Databricks Customer-Managed Keys (CMK): Permite asociar claves KMS administradas por el cliente a dos niveles: cifrado del almacenamiento raíz (cubos S3/ADLS donde residen las tablas Delta) y cifrado del espacio de trabajo (cuadernos interactivos, metadatos y discos EBS temporales de desbordamiento de cómputo).
Certificaciones de Cumplimiento Regulatorio
| Estándar de Cumplimiento | Estado en Snowflake | Estado en Databricks | Detalle de Implementación |
|---|---|---|---|
| SOC 1 / SOC 2 Tipo II / SOC 3 | Certificado | Certificado | Informes anuales independientes de auditoría disponibles en los portales |
| ISO 27001 / 27017 / 27018 | Certificado | Certificado | Cubre centros de datos globales en AWS, Azure y Google Cloud |
| HIPAA BAA (Salud) | Enterprise / Business Critical | Disponible (Todos los niveles) | Requiere acuerdo BAA firmado; apto para datos de salud protegidos (PHI) |
| PCI-DSS Nivel 1 (Tarjetas) | Business Critical | Soportado (Compliance Security Profile) | Requiere claves KMS propias y redes privadas dedicadas |
| Autorización FedRAMP | High (Snowflake GovCloud) | High (AWS GovCloud / Azure Gov) | Apto para agencias gubernamentales y defensa en EE. UU. |
11. Ventajas y Limitaciones de Cada Plataforma
Ventajas y Desventajas de Snowflake
Ventajas Clave:- Mantenimiento Operativo Cero: Modelo SaaS integral; sin dimensionamiento de nodos JVM, sin limpieza manual de espacio ni parches de SO.
- Escalado Multi-Clúster Inmediato: Autoescalado elástico en 1-2 segundos que absorbe cientos de usuarios de dashboards simultáneos sin degradación.
- Caché de Resultados Altamente Eficiente: Consultas repetidas idénticas en 24 horas responden en menos de 50 milisegundos con cero consumo de créditos.
- Intercambio Seguro de Datos (Snowgrid): Facilidad inigualable para compartir conjuntos de datos comerciales entre distintas organizaciones sin duplicar datos.
- Soporte Nativo de Apache Iceberg: Compatibilidad directa con tablas Iceberg en almacenamiento del cliente mediante el catálogo Polaris sin dependencia cautiva.
- Coste Elevado en Cargas ETL Continuas: Las transformaciones pesadas continuas de datos consumen sustancialmente más que los clústeres de tareas de Databricks.
- Ecosistema de ML e IA en Desarrollo: Aunque Cortex y Snowpark progresan con rapidez, Databricks mantiene un liderazgo claro en deep learning y entrenamiento distribuido.
- Formato Interno Propietario: Las tablas nativas no pueden ser consultadas por motores analíticos externos sin pasar por almacenes de Snowflake.
Ventajas y Desventajas de Databricks
Ventajas Clave:- Plataforma Líder en Ingeniería y Machine Learning: Diseñada nativamente para Apache Spark, DataFrames en PySpark, MLflow y modelos de Mosaic AI.
- Motor Vectorial Photon: Su arquitectura en C++ con SIMD supera a Snowflake en la ejecución de cruces masivos y procesamiento de texto a gran escala.
- Compromiso con el Código Abierto: Formato abierto Delta Lake y liberación de Unity Catalog bajo Apache 2.0 que erradican el bloqueo de proveedor.
- Formato Universal (UniForm): Genera metadatos compatibles con Apache Iceberg y Hudi sin requerir duplicación ni conversión de datos.
- Eficiencia Económica en Tareas Batch: Los clústeres automáticos de Jobs ofrecen un coste por hora de procesamiento mucho más competitivo que grandes almacenes de Snowflake.
- Mayor Complejidad de Configuración: Los clústeres clásicos de Spark exigen conocimientos avanzados de asignación de memoria, drivers y ejecutores.
- Escalado de BI Ligeramente Más Lento: Serverless SQL tarda entre 5 y 10 segundos en añadir capacidad ante picos repentinos de tráfico concurrente.
- Facturación Desglosada: En clústeres tradicionales, auditar el consumo combinado de DBUs junto a las facturas de cómputo EC2/Azure VM complica el control FinOps.
12. Coexistencia Arquitectónica y Veredicto Final
En la arquitectura moderna de datos, la disyuntiva ya no es necesariamente "¿Snowflake O Databricks?", sino "¿en qué capa del flujo debe actuar cada una?"
El Patrón de Coexistencia Híbrida de Medallón
Más del 40% de las corporaciones globales operan ambas plataformas de manera simultánea, utilizando formatos de almacenamiento abiertos (Apache Iceberg y Delta UniForm) como puente universal de datos:
Arquitectura Híbrida de Medallón:
- Capa Bronze / Ingesta Cruda (Databricks): La telemetría en streaming, eventos de Kafka y APIs crudas se almacenan directamente en tablas Delta Lake dentro de S3 o ADLS.
- Capa Silver / Transformación y Limpieza (Databricks DLT): Delta Live Tables limpia datos, aplica reglas de validación y ejecuta cambios CDC mediante clústeres económicos de Jobs.
- Interoperabilidad Abierta (UniForm / Iceberg): Databricks UniForm publica automáticamente los metadatos de Apache Iceberg sobre las tablas limpias de la capa Silver.
- Capa Gold / Analítica BI y Consumo Directivo (Snowflake): Snowflake consulta las tablas Iceberg mediante volúmenes externos y el catálogo Polaris. Los analistas de negocio y los dashboards corporativos ejecutan consultas SQL estándar con tiempos de respuesta subsegundo, sin duplicar almacenamiento.
- Ciencia de Datos y Modelos de IA (Databricks Mosaic AI): Los científicos de datos entrenan modelos de machine learning y consultan almacenes vectoriales sobre las mismas tablas Delta/Iceberg con MLflow.
Criterio Decisivo de Elección
Su equipo está compuesto prioritariamente por analistas de SQL, departamentos de finanzas y usuarios de BI directivo. Requiere una gobernanza inmediata sin dedicar tiempo a la gestión de clústeres, escalabilidad que nunca encole consultas y capacidad nativa para compartir datos entre empresas con Snowgrid.
Su organización cuenta con ingenieros de datos y científicos de datos expertos en Python, PySpark y Spark SQL. Desarrolla pipelines intensivos de streaming continuo, entrena modelos propios de IA/LLMs con GPUs (Mosaic AI) y exige formatos de tabla abiertos (Delta/Iceberg UniForm) con gobernanza de código abierto (Unity Catalog).
13. Preguntas Frecuentes Técnicas (FAQ)
¿Puede Databricks Serverless SQL sustituir por completo a Snowflake para cuadros de mando de BI?
Sí, pero con matices operativos relevantes. En 2026, los almacenes Databricks Serverless SQL equipados con el motor vectorizado nativo en C++ Photon han alcanzado la paridad de latencia y escalado frente a Snowflake en cargas analíticas TPC-DS estándar. No obstante, la arquitectura multi-clúster con auto-escalado nativo de Snowflake responde entre 3 y 7 segundos más rápido ante ráfagas repentinas de usuarios concurrentes (pasando de 0 a 200 analistas en menos de 2 segundos) sin encolar consultas. Databricks Serverless SQL es plenamente viable para BI corporativo, pero Snowflake retiene una ligera ventaja en simplicidad administrativa para equipos puramente analistas de SQL.
¿Cómo se compara el soporte para Apache Iceberg entre Snowflake y Databricks?
Ambas plataformas han adoptado Apache Iceberg pero mediante estrategias arquitectónicas divergentes. Snowflake lee y escribe de forma nativa tablas Apache Iceberg respaldadas por almacenamiento cloud del cliente (AWS S3, ADLS, GCS) utilizando volúmenes externos y catálogos REST como Snowflake Polaris Catalog o AWS Glue. Databricks promueve Delta Lake pero proporciona Universal Format (UniForm), que escribe los archivos de datos Parquet una sola vez y genera simultáneamente las capas de metadatos de Iceberg y Hudi, permitiendo que motores externos de Iceberg consulten las tablas Delta sin necesidad de copiar ni convertir datos.
¿En qué se diferencian Snowflake Horizon y Databricks Unity Catalog para gobernanza de datos?
Databricks liberó Unity Catalog como código abierto bajo la licencia Apache 2.0, ofreciendo una capa de gobernanza universal y multiplataforma para tablas, volúmenes de archivos no estructurados, modelos de ML y funciones de IA en AWS, Azure y GCP con federación nativa (Lakehouse Federation). Por su parte, Snowflake Horizon es una suite de gobernanza propietaria totalmente integrada en el Data Cloud de Snowflake, que ofrece enmascaramiento dinámico basado en etiquetas, seguridad a nivel de fila, clasificación automática de datos personales y replicación entre nubes mediante Snowgrid. Unity Catalog destaca por su neutralidad e interoperabilidad multiactivo, mientras que Horizon ofrece simplicidad inmediata sin configuración adicional dentro del ecosistema Snowflake.
¿Cuál es la diferencia principal en precios de cómputo entre los Créditos de Snowflake y las DBUs de Databricks?
Snowflake factura a través de una moneda única unificada denominada Créditos ($2,00 USD en edición Standard, $3,00 USD en Enterprise y $4,00 USD en Business Critical por hora de crédito para un almacén X-Small), que incluye las máquinas virtuales cloud, la red inter-nodo y la orquestación en una sola tarifa por segundo. Databricks separa la facturación en dos conceptos para cargas clásicas: las unidades Databricks Units (DBU, que oscilan entre $0,07 y $0,55 USD según el tipo de carga) más el costo de la infraestructura de máquinas virtuales del proveedor cloud (AWS EC2, Azure VM, GCP Compute). En el caso de Databricks Serverless SQL, el cómputo se unifica en una tarifa integral ($0,70 USD/DBU), similar al modelo de Snowflake.
¿Qué plataforma resulta más rentable económicamente para ingeniería de datos pesada y aprendizaje automático (ML)?
Databricks resulta matemáticamente mucho más rentable para transformaciones ETL pesadas y de larga duración, procesamiento de datos no estructurados y entrenamiento de modelos de machine learning distribuidos. La ejecución de tareas Spark en clústeres automáticos de Jobs en Databricks tiene un coste por hora de cómputo significativamente menor que mantener almacenes virtuales de gran tamaño activos en Snowflake. Además, Databricks integra de forma nativa MLflow, Mosaic AI, clústeres con aceleración por GPU y DataFrames distribuidos en PySpark, mientras que Snowflake requiere Snowpark o Snowpark Container Services, que consumen créditos estándar de almacén.