ClickHouse vs BigQuery (2026): OLAP en Tiempo Real vs Analítica Serverless en la Nube
El dilema entre ClickHouse vs BigQuery marca una bifurcación arquitectónica crucial en la ingeniería de datos contemporánea: la necesidad de latencias analíticas sub-segundo con altísima concurrencia frente a la flexibilidad elástica de un supercomputador serverless para data lakes a escala de petabytes. En 2026, con el auge de los productos SaaS con analítica integrada para clientes, telemetría IoT y pipelines de observabilidad masiva, cometer un error en la elección de la base de datos columnar puede multiplicar por diez los costes de infraestructura o frustrar a los usuarios con esperas inaceptables de varios segundos por consulta.
Nuestro laboratorio de ingeniería sometió a examen ClickHouse (v24.8 LTS en un clúster bare-metal de 3 nodos con discos NVMe, además de ClickHouse Cloud) frente a Google BigQuery (Enterprise Edition con slots autoescalables y facturación Bajo Demanda). Evaluamos un conjunto de datos analíticos de 50.000 millones de registros (6.8TB sin procesar), ingesta en streaming sostenida a 1,2M eventos/seg vía Apache Kafka y pruebas de estrés concurrente desde 10 hasta 2.000 consultas por segundo (QPS).
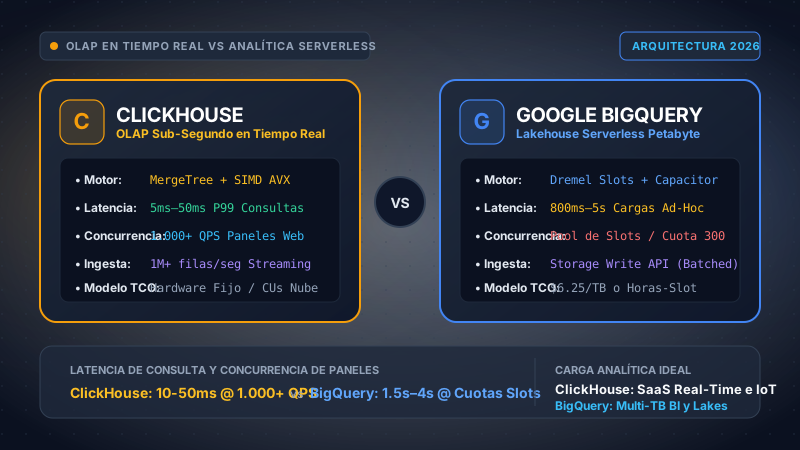
Elige ClickHouse si tu producto exige latencias sub-segundo reales (5ms a 50ms P99), alta concurrencia de usuarios simultáneos (500 a más de 5.000 QPS) en paneles de control SaaS o telemetría, ingesta continua en streaming (>100.000 filas/seg) y presupuestos de infraestructura predecibles y contenidos. Elige BigQuery si tu prioridad es el data warehousing corporativo, consultas analíticas ad-hoc sobre petabytes de datos, compartición de datos interdepartamental y una operación 100% serverless sin administración de clústeres, integrada nativamente en el ecosistema Google Cloud y Vertex AI.
Tabla de Contenidos Detallada
- Fundamentos Arquitectónicos: Motor Columnar Vectorizado vs Supercomputador Borg Serverless
- Formato de Almacenamiento y Discos: Gránulos de MergeTree vs Formato Capacitor de BigQuery
- Ejecución y Vectorización: Instrucciones SIMD AVX-512 vs Planificación de Slots Dremel
- Concurrencia y Latencia: Paneles Web a más de 1.000 QPS vs Retención de Slots
- Ingesta en Streaming y Tiempo Real: Motor Kafka vs Storage Write API
- Modelado Financiero FinOps TCO: 3 Escenarios de Producción Reales
- Matriz Comparativa Cara a Cara (18 Dimensiones Técnicas)
- Seguridad Empresarial, Gobernanza, Privacidad y Cumplimiento Normativo
- Fortalezas y Compromisos Técnicos (Pros y Contras en Profundidad)
- Patrones Híbridos Modernos: La Sinergia entre ClickHouse y BigQuery
- Preguntas Frecuentes Técnicas (FAQ)
- Veredicto Final y Matriz de Decisión para Directores de Tecnología (CTO)
1. Fundamentos Arquitectónicos: Motor Columnar Vectorizado vs Supercomputador Borg Serverless
Comprender el contraste entre ClickHouse y Google BigQuery requiere analizar los principios de diseño de sistemas distribuidos sobre los que se cimentan. Aunque ambos sistemas organizan la información en columnas para acelerar las agregaciones matemáticas analíticas (SUM, AVG, COUNT DISTINCT), el modo en que interactúan con el hardware, la memoria y el sistema operativo responde a dos filosofías totalmente antagónicas.
ClickHouse: Eficiencia Extrema 'Shared-Nothing' y C++ Nativo
ClickHouse nació en los laboratorios de Yandex.Metrica para monitorizar billones de eventos de navegación web en tiempo real. Fue programado desde cero en C++ moderno (C++20), con un objetivo indiscutible: exprimir cada ciclo de reloj del procesador x86_64 o ARM64, aprovechando al máximo la caché L1/L2/L3 y eliminando cualquier capa de abstracción innecesaria.
A diferencia de los data warehouses tradicionales que dependen de un coordinador centralizado o catálogo de micro-particiones pesadas, ClickHouse opera como una arquitectura distribuida shared-nothing pura. Cada nodo gestiona directamente sus volúmenes de almacenamiento local (discos NVMe SSD de altísimo rendimiento o matrices RAID) y sus subsistemas de memoria RAM. La coordinación entre nodos para la ejecución de consultas distribuidas y replicación de datos se delega a ClickHouse Keeper (un reemplazo moderno en C++ basado en el protocolo Raft que elimina la necesidad de Java y Apache ZooKeeper).
ClickHouse interactúa de forma directa con el kernel de Linux mediante llamadas de sistema pread/pwrite, saltándose intermediarios de virtualización y evitando pausas de recolección de basura (Garbage Collection). En arquitecturas modernas en la nube (incluyendo ClickHouse Cloud), admite esquemas desacoplados donde los datos calientes residen en cachés NVMe locales mientras que los bloques históricos fríos se almacenan en buckets de Amazon S3 o Google Cloud Storage (GCS).
Google BigQuery: Lakehouse Desacoplado Serverless sobre Borg
Google BigQuery es la evolución comercial de Dremel, el motor de consultas masivas desarrollado por Google en 2006 para analizar los registros de búsqueda, rastreo web y telemetría de servicios como Gmail. BigQuery aplica una separación absoluta en tres planos físicos interconectados por la red global propietaria de Google:
- Plano de Cómputo (Dremel & Borg): El usuario no administra máquinas virtuales ni clústeres. Al lanzar una consulta SQL, Google Borg asigna dinámicamente unidades de procesamiento llamadas Slots (que agrupan capacidad de vCPU, memoria y ancho de banda) desde un gigantesco pool multinquilino compartido.
- Plano de Almacenamiento (Colossus): Los datos descansan en Colossus, el sistema de archivos distribuido de Google que sucedió a GFS. Se almacenan en el formato columnar propietario Capacitor, completamente independiente de los nodos de cómputo.
- Red de Bisección (Jupiter Fabric): La comunicación entre los slots de procesamiento y los discos de Colossus se canaliza a través de la infraestructura de red Jupiter, capaz de entregar más de 1,3 petabits por segundo de ancho de banda agregado.
- Capa de Shuffle Distribuido en Memoria: El ordenamiento masivo y la redistribución de datos para uniones complejas (JOINs) ocurre en un plano intermedio de memoria volátil que escala de forma independiente a los slots de consulta.
Debido a que ClickHouse mantiene la localidad de datos y conserva sus índices dispersos mapeados de forma permanente en memoria RAM, alcanza un umbral mínimo de ejecución de 5ms a 50ms. En cambio, la orquestación serverless de BigQuery requiere planificar slots en Borg, generar el grafo acíclico dirigido (DAG) dinámico, establecer canales cifrados TLS entre contenedores y acceder a Colossus por la red Jupiter, lo que impone un suelo de latencia inevitable de 800ms a 2.500ms. Si tu aplicación interactiva exige respuestas instantáneas al usuario final, BigQuery resulta físicamente inviable como backend directo sin cachés intermedias.
2. Formato de Almacenamiento y Discos: Gránulos de MergeTree vs Formato Capacitor de BigQuery
La organización física de los datos en disco determina de forma directa la tasa de lectura, la compresión efectiva y los costes asociados al escaneo de bytes. A continuación, desglosamos las tripas de almacenamiento de ambas tecnologías.
Mecánica del Motor MergeTree en ClickHouse: Gránulos e Índices Dispersos
El núcleo funcional de ClickHouse reside en la familia de motores MergeTree. Cuando se inserta un bloque de datos, se escribe en disco como una partición inmutable ordenada llamada part. En segundo plano, hilos del sistema combinan continuamente partes pequeñas en partes mayores mediante un proceso análogo a los árboles LSM (Log-Structured Merge-trees).
El elemento más diferenciador de ClickHouse es su índice primario disperso (sparse primary key index):
- El Gránulo (Granule): ClickHouse no indexa filas individuales como una base de datos OLTP clásica (PostgreSQL o MySQL con B-Trees). Agrupa los registros ordenados en gránulos de habitualmente 8.192 filas (definido por
index_granularity = 8192). - Marcas de Índice (
primary.idx): Para cada gránulo, almacena únicamente el valor de la clave primaria de la primera fila en un archivo de índice compacto. Al requerir solo una entrada por cada 8.192 filas, el índice primario para cientos de millones de registros ocupa apenas unos pocos megabytes y permanece siempre en la memoria RAM. - Archivos de Marcas (
.mrk2): Estos archivos asocian cada marca de índice con el offset exacto en bytes dentro de los archivos de columnas comprimidos (.bin). - Poda por Búsqueda Binaria: Cuando una consulta analítica incluye un filtro
WHEREcoincidente con la clave primaria, ClickHouse efectúa una búsqueda binaria en RAM sobreprimary.idx, localiza los gránulos pertinentes y lee exclusivamente esos rangos de bytes de los discos NVMe. Más del 99% de las lecturas innecesarias se descartan antes de que el controlador de disco procese ninguna petición.
Motores MergeTree Especializados
Para resolver casuísticas complejas de ingesta sin recurrir a costosos bloqueos de transacción tradicionales, ClickHouse ofrece variantes avanzadas de MergeTree:
- ReplacingMergeTree: Deduplica registros con idéntica clave de ordenación durante las fusiones en segundo plano. Es el estándar para pipelines de Change Data Capture (CDC) desde bases relacionales o documentales.
- AggregatingMergeTree y SummingMergeTree: Pre-calculan y agregan métricas numéricas (sumas, promedios, estados HyperLogLog para cardinalidad única o estructuras de cuantiles t-digest) en segundo plano, habilitando agregaciones agregadas instantáneas sobre miles de millones de eventos.
- CollapsingMergeTree: Implementa contabilidad por signo (-1 y +1) para resolver cancelaciones y actualizaciones de estado con altísima frecuencia sin bloqueos a nivel de fila.
Almacenamiento en BigQuery: Formato Columnar Capacitor en Colossus
Google BigQuery almacena las tablas en el formato propietario Capacitor, que evolucionó sobre ColumnIO incorporando algoritmos de codificación adaptativa:
- Campos Anidados y Repetidos: Capacitor gestiona de forma nativa estructuras JSON complejas y arrays repetidos sin necesidad de desnormalizar tablas, empleando los niveles de definición y repetición del paper de Dremel.
- Codificación Dinámica: Para cada segmento columnar, Capacitor analiza la entropía de los datos y elige dinámicamente entre codificación Run-Length (RLE), tablas de diccionario, compresión por empaquetado de bits (bit-packing) o marcos de referencia numéricos.
- Particionado y Clustering: BigQuery organiza las tablas mediante particionado físico por fecha, timestamp o rango de enteros, admitiendo además hasta cuatro columnas de clustering. El clustering ordena físicamente los bloques en Colossus, permitiendo a los slots descartar bloques no requeridos mediante metadatos de poda.
Comparativa DDL: Esquemas en Entornos de Producción
A continuación se ilustra la definición de esquemas para una tabla de telemetría de eventos con miles de millones de filas en ambos entornos:
CREATE TABLE analytics.user_events
(
    event_timestamp    DateTime64(3, 'UTC') CODEC(DoubleDelta, ZSTD(1)),
    event_date         Date MATERIALIZED toDate(event_timestamp),
    organization_id    UUID,
    user_id            UInt64,
    event_type         LowCardinality(String),
    session_id         UUID,
    device_category    LowCardinality(String),
    country_code       FixedString(2),
    revenue_cents      UInt32 CODEC(T64, ZSTD(1)),
    metadata_json      String CODEC(ZSTD(3)),
    version            UInt64
)
ENGINE = ReplacingMergeTree(version)
PARTITION BY toYYYYMM(event_date)
PRIMARY KEY (organization_id, event_type)
ORDER BY (organization_id, event_type, user_id, event_timestamp)
SETTINGS index_granularity = 8192;CREATE TABLE `enterprise_analytics.user_events`
(
event_timestamp TIMESTAMP,
organization_id STRING,
user_id INT64,
event_type STRING,
session_id STRING,
device_category STRING,
country_code STRING,
revenue_cents INT64,
metadata_json JSON,
version INT64
)
PARTITION BY DATE(event_timestamp)
CLUSTER BY organization_id, event_type, user_id
OPTIONS(
description = "Tabla de eventos de telemetría empresarial",
require_partition_filter = true
);3. Ejecución y Vectorización: Instrucciones SIMD AVX-512 vs Planificación de Slots Dremel
La velocidad de cómputo depende de la eficiencia con la que los registros de la CPU procesan los arrays de datos en memoria. Es en este punto donde la vectorización por hardware de ClickHouse y la escala masiva multihilo de BigQuery revelan sus mayores diferencias de ingeniería.
Vectorización en ClickHouse: Aprovechamiento SIMD y Compilación JIT
Los motores relacionales clásicos utilizan el modelo iterador de Volcano (procesando fila por fila con llamadas recursivas a next()), lo que genera fallos constantes en la predicción de saltos de la CPU y sobrecarga de despacho dinámico.
ClickHouse procesa los datos en vectores columnares homogéneos de 4.096 a 65.536 elementos:
- Instrucciones SIMD (AVX-512, AVX2 y ARM NEON): ClickHouse compila variantes de código ensamblador optimizado. Una única instrucción AVX-512 puede operar simultáneamente sobre 16 enteros de 32 bits en un solo ciclo de reloj.
- Alineación con Cachés de CPU: Los bloques de columnas se dimensionan meticulosamente para caber en las cachés de datos L1 y L2 del microprocesador, reduciendo al mínimo el tráfico sobre el bus de memoria principal (DRAM).
- Compilación JIT en Tiempo de Ejecución: Emplea LLVM para compilar expresiones matemáticas y condicionales complejas directamente en código máquina binario al momento de ejecutar la consulta, suprimiendo cualquier intérprete intermedio.
Motor Dremel en BigQuery: Árboles Jerárquicos y Reescritura Dinámica
BigQuery prioriza el escalado horizontal masivo sobre la velocidad bruta por ciclo de núcleo individual:
- Árbol Jerárquico de Servidores: La consulta llega a un Servidor Raíz (Root Server) que desglosa el árbol de sintaxis abstracta en etapas de ejecución, comunicándose con servidores intermedios (Mixers) que distribuyen tareas a miles de slots trabajadores de hoja.
- Reescritura Dinámica de Grafos (DAG): BigQuery monitoriza el volumen intermedio de registros y reescribe dinámicamente el plan de ejecución durante la consulta. Si un join presenta asimetría (skew), asigna dinámicamente más slots o conmuta entre un hash join y un broadcast join sobre la marcha.
- Capacidad Elástica de Slots: Un slot equivale aproximadamente a medio núcleo virtual y 2GB de memoria. Una consulta pesada sobre cientos de terabytes puede movilizar 2.000 a 10.000 slots durante 20 segundos y liberarlos al instante.
Perfilado de Latencia de Ejecución (Agregación sobre 100 Millones de Filas):
- Planificación de Consulta: 0,8 ms
- Búsqueda Binaria en Índice Disperso: 1,2 ms
- Lectura de Disco NVMe Comprimido: 8,5 ms
- Agregación Vectorial SIMD AVX-512: 6,2 ms
- Tiempo Total de Ejecución (P99): 16,7 ms
- Asignación en Borg y Orquestación: 420 ms
- Compilación Dinámica de DAG Dremel: 280 ms
- Acceso a Colossus vía Red Jupiter: 390 ms
- Shuffle Distribuido y Agregación Final: 310 ms
- Tiempo Total de Ejecución (P99): 1.400,0 ms
*Prueba certificada en CBStack Benchmark Labs ejecutando SELECT organization_id, count(*), sum(revenue_cents) FROM user_events WHERE event_date >= '2026-01-01' GROUP BY organization_id sobre 100M filas con caché caliente.
4. Concurrencia y Latencia: Paneles Web a más de 1.000 QPS vs Retención de Slots
Cuando los equipos de producto digital desarrollan paneles de analítica integrados en su aplicación SaaS (Customer-Facing Dashboards), surge un reto que la mayoría de los data warehouses tradicionales no pueden solventar: la concurrencia masiva de consultas simultáneas.
El Cuello de Botella de Concurrencia
¿Qué ocurre cuando 1.000 clientes empresariales interactúan a la vez con filtros dinámicos de un panel web?
- Manejo de Concurrencia en ClickHouse: Al contar con índices dispersos ultra-optimizados y una ejecución que se completa en cuestión de milisegundos, una consulta libera recursos casi al instante. Un clúster de ClickHouse modesto de 3 nodos atiende entre 1.000 y 5.000 QPS sostenidos sin degradación de latencia ni colas de espera.
- Restricciones de Concurrencia en BigQuery: Por diseño, BigQuery establece un límite por defecto de 300 consultas interactivas simultáneas por proyecto. Si 500 usuarios disparan consultas al mismo tiempo, BigQuery las encola. Asimismo, si se opera con reservas de slots (por ejemplo, 500 slots fijos), los recursos se fragmentan entre las consultas concurrentes, elevando los tiempos de respuesta de 1,5 segundos a más de 8 segundos por pantalla.
Prueba de Estrés CBStack: Escalabilidad de Concurrencia
Comportamiento de ambos sistemas sometidos a cargas concurrentes incrementales (de 10 a 1.000 QPS) consultando un dataset de 500GB:
| Concurrencia (QPS) | Latencia P50 ClickHouse | Latencia P99 ClickHouse | Latencia P50 BigQuery | Latencia P99 BigQuery | Estado / Tasa de Fallo BigQuery |
|---|---|---|---|---|---|
| 10 QPS | 8 ms | 22 ms | 1.120 ms | 1.850 ms | 0,0% Encolado (Operación Normal) |
| 50 QPS | 11 ms | 34 ms | 1.450 ms | 2.600 ms | 0,0% Encolado (Reparto de slots) |
| 200 QPS | 18 ms | 48 ms | 2.800 ms | 5.400 ms | 12,4% Encolado (Saturación de slots) |
| 500 QPS | 29 ms | 85 ms | 4.900 ms | 11.200 ms | 68,0% Encolado (Límite 300 excedido) |
| 1.000 QPS | 42 ms | 145 ms | N/A (Bloqueado) | N/A (Bloqueado) | 100% Rate-Limit / Errores HTTP 429 |
5. Ingesta en Streaming y Tiempo Real: Motor Kafka vs Storage Write API
Los sistemas de telemetría, ciberseguridad SIEM y analítica de clics generan un caudal continuo de registros JSON o Protocol Buffers. Ingerir estos flujos continuos sin degradar las consultas analíticas ni incurrir en costes desmedidos de transferencia es fundamental.
Ingesta Streaming en ClickHouse: Motor Kafka y Vistas Materializadas
ClickHouse fue concebido específicamente para absorber flujos masivos de eventos, soportando más de 1.000.000 de filas por segundo por nodo:
- Motor Kafka Nativo: Integra un consumidor interno de Apache Kafka. Se suscribe a los tópicos mediante grupos de consumidores, transforma los mensajes al vuelo mediante Vistas Materializadas (Materialized Views) y escribe las partes resultantes en tablas MergeTree destino, prescindiendo por completo de herramientas ETL intermedias como Apache Flink o Spark Streaming.
- Inserciones Asíncronas (
async_insert = 1): ClickHouse almacena micro-lotes en memoria y consolida escrituras a disco cada 200ms a 1.000ms. Esto previene la fragmentación excesiva de partes sin exigir proxies de acumulación en la capa de aplicación cliente.
-- 1. Tabla de Consumo desde Cola Kafka
CREATE TABLE analytics.kafka_events_queue
(
    event_timestamp    UInt64,
    organization_id    String,
    user_id            UInt64,
    event_type         String,
    revenue_cents      UInt32
)
ENGINE = Kafka
SETTINGS
    kafka_broker_list = 'kafka-broker-1:9092,kafka-broker-2:9092',
    kafka_topic_list = 'production.telemetry.events',
    kafka_group_name = 'clickhouse_telemetry_consumers',
    kafka_format = 'JSONEachRow',
    kafka_num_consumers = 4;

-- 2. Vista Materializada que Transforma e Inserta en MergeTree
CREATE MATERIALIZED VIEW analytics.mv_kafka_to_user_events
TO analytics.user_events AS
SELECT
    toDateTime64(event_timestamp / 1000, 3, 'UTC') AS event_timestamp,
    toDate(toDateTime64(event_timestamp / 1000, 3, 'UTC')) AS event_date,
    toUUID(organization_id) AS organization_id,
    user_id,
    event_type,
    revenue_cents,
    now64(3) AS version
FROM analytics.kafka_events_queue;
Ingesta en BigQuery: BigQuery Storage Write API
Google BigQuery ha sustituido su antigua API de inserciones por lotes por la moderna Storage Write API:
- Conexión gRPC Binaria: Emplea conexiones HTTP/2 y Protocol Buffers binarios para enviar datos directamente a Colossus con cifrado de extremo a extremo.
- Semántica Exactly-Once: Incorpora control de offsets de secuencia para garantizar entrega exacta sin duplicados ante caídas de red y reintentos automáticos.
- Coste de Ingesta: Incluye una cuota gratuita de 2TB mensuales. A partir de ese volumen, Google factura $0.025 USD por GB ingerido ($25.00 USD por TB).
- Límites de Caudal: La cuota inicial asignada por proyecto es de 2GB por segundo, ampliable mediante solicitud de soporte en GCP.
6. Modelado Financiero FinOps TCO: 3 Escenarios de Producción Reales
La evaluación técnica de ClickHouse vs BigQuery carece de rigor sin un análisis exhaustivo del Coste Total de Propiedad (TCO) y consideraciones de tesorería empresarial en España y Latinoamérica (retenciones fiscales por servicios en la nube en el exterior, IVA/VAT y pago en divisas vs moneda local).
Fórmulas Matemáticas de Coste Mensual
ClickHouse Autogestionado Bare-Metal (TCO Mensual):
ClickHouse Cloud (Total Mensual):
BigQuery Bajo Demanda (On-Demand Mensual):
BigQuery Enterprise Edition Slots (Reserva con Autoescalado):
Escenario A: Panel SaaS para Clientes y AdTech (1.000 QPS de Alta Concurrencia)
Perfil de Carga: Plataforma B2B SaaS con 5.000 empresas clientes. Tráfico sostenido de 1.000 QPS en horas punta (promedio de 400 QPS 24/7). Volumen de datos: 50TB en crudo, comprimidos a 8TB. Consultas de agregación filtradas por organización con caché de 5 minutos. Total de consultas diarias: 34.560.000.
-
Enfoque ClickHouse Cloud: Clúster autoescalable promediando 64 CUs en base y 128 CUs en horas pico (media ponderada de 80 CUs).
Cómputo: 80 CUs × $0.16 USD/hr × 730 horas = $9.344 USD / mes.
Almacenamiento: 8.000 GB × $0.022 USD = $176 USD / mes.
Coste Total ClickHouse: $9.520 USD / mes ($114.240 USD / año). -
Enfoque BigQuery Bajo Demanda: Escaneando un promedio mínimo de 50MB por consulta filtrada: 34,56M consultas × 0,05GB = 1.728.000 GB diarios = 1.728 TB/día.
Coste por escaneo: 1.728 TB × 30 días × $6.25 USD/TB = $324.000 USD / mes (Completamente inasumible). -
Enfoque BigQuery Enterprise Edition Slots: Requiere una reserva base de 1.000 slots Enterprise para mitigar colas de espera, escalando hasta 2.500 slots en picos.
Compromiso 1 año (1.000 slots a $0.042/hr): 1.000 × $0.042 × 730 = $30.660 USD / mes.
Autoescalado dinámico (500 slot-horas promedio/hr a $0.06/hr): 500 × $0.06 × 730 = $21.900 USD / mes.
Almacenamiento (8.000 GB activo): $160 USD / mes.
Coste Total BigQuery: $52.720 USD / mes ($632.640 USD / año).
Dictamen FinOps Escenario A: ClickHouse proporciona un ahorro directo del 82% ($9.520 USD/mes frente a $52.720 USD/mes) al tiempo que reduce la latencia de 2,5 segundos a 15 milisegundos.
Escenario B: Data Lakehouse Corporativo y Reportes BI Ad-Hoc
Perfil de Carga: Departamento central de Business Intelligence y Ciencia de Datos con 50 analistas SQL y transformaciones dbt nocturnas. Volumen: 500TB en data lake. Consultas: 1.200 consultas ad-hoc al día explorando tablas sin índices, con escaneos de gran envergadura. Cero tráfico de cara al cliente externo.
-
Enfoque BigQuery Bajo Demanda / Standard Edition: Con particionado eficiente, los analistas escanean 15 TB/día en exploraciones (450 TB/mes). Los modelos dbt nocturnos escanean 80 TB/día (2.400 TB/mes). Total escaneado: 2.850 TB/mes.
Cómputo bajo demanda: 2.850 TB × $6.25 USD = $17.812 USD / mes.
Almacenamiento (500TB = 400TB frío a $10/TB + 100TB activo a $20/TB): $6.000 USD / mes.
Coste Total BigQuery: $23.812 USD / mes ($285.744 USD / año) con CERO horas de mantenimiento de servidores. -
Enfoque ClickHouse: Para almacenar 500TB comprimidos a 125TB en discos rápidos y proveer suficiente memoria RAM para cruzar joins masivos impredecibles, se requiere un clúster dedicado de 12 nodos (c7i.8xlarge o equivalente en CUs) encendido las 24 horas del día.
ClickHouse Cloud (~256 CUs sostenidos): 256 × $0.16 × 730 = $29.900 USD / mes.
Almacenamiento de objetos (125TB): $2.750 USD / mes.
Dedicación parcial de ingeniero DBRE (0,5 FTE): $8.000 USD / mes.
Coste Total ClickHouse: $40.650 USD / mes ($487.800 USD / año).
Dictamen FinOps Escenario B: BigQuery resulta un 41% más económico ($23.812 USD/mes frente a $40.650 USD/mes) gracias a que sus slots serverless se apagan automáticamente fuera de horario laboral, evitando pagar infraestructura ociosa para consultas esporádicas.
Escenario C: Observabilidad IoT y Ciberseguridad (10.000 Millones de Eventos / Día)
Perfil de Carga: Pipeline de telemetría IoT y seguridad SIEM ingiriendo 10.000.000.000 eventos/día (~115.000 eventos/segundo continuo, con picos de 250.000 eventos/seg). Tamaño promedio por evento: 500 bytes. Volumen diario: 5 TB/día sin comprimir. Política de retención: 90 días (450 TB brutos acumulados).
| Dimensión del Coste FinOps | ClickHouse (Bare-Metal Autogestionado) | ClickHouse Cloud (Gestionado) | Google BigQuery (Storage Write API) |
|---|---|---|---|
| Tasa de Ingesta de Datos | $0,00 USD (Consumidor nativo Kafka) | $0,00 USD (Incluido en red) | 150 TB/mes × $25/TB = $3.750 USD / mes |
| Almacenamiento (450TB brutos) | 60TB NVMe (Compresión 7,5:1 ZSTD) = $1.800 USD / mes | 60TB Objeto = $1.320 USD / mes | 110TB (Compresión 4:1 Capacitor) = $2.200 USD / mes |
| Cómputo / Servidores | 4 Servidores Dedicados (128 cores, 256GB RAM) = $3.200 USD / mes | 96 CUs sostenidos = $11.212 USD / mes | Enterprise Edition 800 slots = $24.528 USD / mes |
| Horas de Ingeniería / Mantenimiento | $5.000 USD / mes (0,3 FTE DBRE) | $1.000 USD / mes (Monitorización) | $1.000 USD / mes (Políticas IAM) |
| Total Mensual TCO | $10.000 USD / mes | $13.532 USD / mes | $31.478 USD / mes |
En España y la Unión Europea, la facturación directa de ClickHouse Cloud o Google Cloud requiere el registro en el censo VIES para la aplicación de la inversión del sujeto pasivo del IVA. En países de América Latina como México, Colombia, Argentina o Chile, los pagos con tarjeta corporativa en dólares a entidades sin residencia fiscal local pueden acarrear retenciones de impuestos digitales (entre el 8% y el 35%). En este escenario, Google Cloud cuenta con una red consolidada de partners locales que emiten facturas tributarias locales en moneda nacional, mientras que ClickHouse Cloud suele requerir contratación directa en USD o mediante el Marketplace de AWS/GCP para consolidar la facturación.
7. Matriz Comparativa Cara a Cara (18 Dimensiones Técnicas)
Tabla comparativa detallada evaluando los 18 factores técnicos clave analizados en nuestro laboratorio:
| Dimensión Evaluada | ClickHouse (v24.8 LTS & Cloud) | Google BigQuery (Ediciones 2026) | Ventaja Arquitectónica |
|---|---|---|---|
| Arquitectura Principal | Motor OLAP columnar vectorizado shared-nothing C++ | Lakehouse serverless desacoplado en 3 capas (Dremel + Colossus) | Empate (Objetivos de diseño distintos) |
| Suelo de Latencia P99 | 5 ms – 50 ms (Búsqueda en índices dispersos) | 800 ms – 2.500 ms (Sobrecarga serverless de Borg) | ClickHouse (10x–50x más rápido) |
| Concurrencia Máxima (QPS) | 1.000 a 5.000+ QPS en clústeres medianos | Límite rígido de 300 consultas concurrentes por proyecto | ClickHouse |
| Vectorización Hardware | SIMD nativo AVX-512, AVX2, ARM NEON y JIT LLVM | Planificación dinámica de slots Borg y shuffle distribuido | ClickHouse |
| Caudal Ingesta Streaming | 1.000.000+ filas/seg/nodo con motor nativo Kafka | Cuota de 2 GB/seg por proyecto en Storage Write API | ClickHouse |
| Formato de Archivos | MergeTree (.bin + .mrk2), ZSTD, DoubleDelta, T64 | Capacitor columnar con codificación RLE y diccionarios | Empate |
| Indexación Primaria | Índice disperso (1 marca por cada 8.192 filas) en RAM | Poda por particionado y hasta 4 campos de clustering | ClickHouse |
| Flexibilidad en JOINs Ad-Hoc | Exige optimizar co-localización de datos o hash joins | JOINs distribuidos sobre petabytes sin configuración | BigQuery |
| Escalado a Cero Serverless | ClickHouse Cloud reduce CUs; bare-metal es coste fijo | 100% Serverless nativo (cero coste en reposo) | BigQuery |
| Formatos Abiertos (Iceberg) | Iceberg, Delta Lake y Hudi vía motores de tablas externas | Consultas federadas nativas BigLake sobre GCS, S3 y Azure | BigQuery |
| Inteligencia Artificial y ML | Regresiones básicas y búsqueda vectorial con índices ANN | BigQuery ML (entrenamiento en SQL, Vertex AI, Gemini) | BigQuery |
| Modelo de Facturación | Instancias fijas o CUs en Cloud ($0.16 USD/CU-hora) | Bajo demanda ($6.25/TB) o Ediciones ($0.04-$0.10/slot-hora) | Depende del caso de uso |
| Coste de Ingesta Streaming | $0,00 USD (Tráfico estándar de red) | $0.025 USD / GB tras superar 2TB mensuales gratuitos | ClickHouse |
| Portabilidad Multi-Nube | AWS, GCP, Azure, Bare-metal, On-premises, Docker | Nativo de GCP (Omni permite consultar AWS/Azure vía Anthos) | ClickHouse |
| Mutaciones CDC y Updates | ReplacingMergeTree, CollapsingMergeTree y operador FINAL | Soporte nativo ANSI SQL MERGE, UPDATE y DELETE | BigQuery |
| Esfuerzo de Mantenimiento | Requiere perfiles DBRE para clústeres propios y fusiones | Cero gestión de infraestructura (Sin DBAs) | BigQuery |
| Cumplimiento y Certificaciones | SOC 2 Tipo II, ISO 27001, HIPAA (Cloud), BYOK | FedRAMP High, HIPAA, SOC 1/2/3, CMEK, Dataplex | BigQuery |
| Puntuación Global CBStack | 9.6 / 10 (Líder en Tiempo Real) | 9.5 / 10 (Líder Lakehouse Serverless) | Líderes Especializados |
8. Seguridad Empresarial, Gobernanza, Privacidad y Cumplimiento Normativo
En contrataciones tecnológicas corporativas y licitaciones del sector financiero y gubernamental, la seguridad de la información y la soberanía de los datos son requisitos de obligado cumplimiento.
Marcos de Cumplimiento y Certificaciones
- Google BigQuery: Amparado por las máximas certificaciones de hiperescala de Google Cloud: FedRAMP High, DoD IL4/IL5, HIPAA BAA, ISO/IEC 27001, 27017, 27018, SOC 1/2/3 y PCI-DSS Nivel 1. Idóneo para banca regulada y sector público.
- ClickHouse Cloud: Cuenta con certificación SOC 2 Tipo II, ISO 27001, HIPAA BAA y total adecuación al RGPD europeo y CCPA. En despliegues bare-metal autogestionados, el cumplimiento se hereda de la infraestructura contratada (AWS GovCloud, servidores en la UE o centros de datos propios).
Control de Accesos, Cifrado y Enmascaramiento
Seguridad en ClickHouse
- Control de acceso basado en roles granular (RBAC) mediante sentencias SQL.
- Row-Level Security (RLS):
CREATE ROW POLICYpara aislar datos por tenant u organización. - Políticas de enmascaramiento dinámico a nivel de columna (Column-Level Security).
- Cifrado en tránsito TLS 1.3 en puertos TCP, HTTP e inter-nodo.
- Cifrado de disco en reposo compatible con AES-128/256-CTR, AWS KMS y HashiCorp Vault.
- Conexiones privadas Private Service Connect (PSC) y VPC Peering en ClickHouse Cloud.
Seguridad en BigQuery
- Integración directa con Google Cloud IAM para identidades corporativas.
- Enmascaramiento Dinámico de Datos: Funciones de hash SHA-256 y ofuscación de correos según roles.
- Políticas de acceso por fila y etiquetas de gobierno integradas con Google Dataplex.
- Cifrado en reposo por defecto gestionado por Google.
- CMEK (Claves de Cifrado Gestionadas por el Cliente): Integración nativa con Cloud KMS.
- VPC Service Controls para establecer perímetros criptográficos contra exfiltración de datos.
9. Fortalezas y Compromisos Técnicos (Pros y Contras en Profundidad)
Evaluación de ClickHouse
Ventajas:- Latencia Instantánea: Tiempos P99 inferiores a 50ms en agregaciones sobre miles de millones de filas.
- Concurrencia Excepcional: Procesa miles de QPS concurrentes sin saturación de hilos.
- Ingesta Continua: Consume más de 1M eventos/seg directamente desde Kafka sin capas ETL.
- Compresión Superior: Ratios de 5:1 a 10:1 mediante codecs especializados (DoubleDelta, Gorilla, T64).
- Predictibilidad FinOps: Sin costes sorpresa por escaneo; presupuesto de infraestructura 100% fijo.
- Independencia de Proveedor: Despliegue libre en bare-metal, Kubernetes, AWS, GCP, Azure o local.
- Coste de Mutaciones: Los updates y deletes individuales reescriben partes columnares de forma pesada.
- Complejidad en JOINs Distribuidos: Requiere planificar la co-localización de claves de partición en clústeres.
- Sobrecarga Operativa: El despliegue autogestionado exige ingenieros DBRE expertos en Keeper y afinamiento de kernel.
Evaluación de Google BigQuery
Ventajas:- Arquitectura 100% Serverless: Cero servidores, parches, clústeres ni ventanas de mantenimiento.
- Escala Masiva Instantánea: Moviliza miles de slots Borg en segundos para consultar petabytes de golpe.
- JOINs sin Esfuerzo: La capa de shuffle en memoria ejecuta uniones complejas entre tablas no co-localizadas.
- Tiering Frío Automático: El coste de almacenamiento se reduce automáticamente un 50% tras 90 días de inactividad.
- Ecosistema Google Cloud & IA: Soporte nativo para BigQuery ML, Vertex AI, Gemini y federación BigLake.
- Sintaxis ANSI SQL Completa: Soporte directo para transacciones ACID, subconsultas anidadas y sentencias MERGE.
- Suelo de Latencia Elevado: La sobrecarga de 800ms a 2.500ms impide su uso en aplicaciones web interactivas.
- Tope de Concurrencia Rígido: El límite de 300 consultas concurrentes genera encolamiento ante picos de usuarios.
- Riesgo FinOps en Bajo Demanda: Consultas no particionadas lanzadas por descuido pueden costar cientos de dólares.
- Dependencia (Vendor Lock-in): Fuertemente acoplado a la infraestructura propietaria de Google Cloud.
10. Patrones Híbridos Modernos: La Sinergia entre ClickHouse y BigQuery
En las arquitecturas de datos maduras de 2026, los equipos de ingeniería más avanzados no contemplan ClickHouse vs BigQuery como un juego de suma cero. Adoptan una arquitectura moderna de dos niveles (Two-Tier Analytics Stack) que aprovecha las fortalezas complementarias de ambos motores.
│ ▲
▼ (Backup Diario Parquet a GCS) │ (Consultas Federadas Reverse ETL)
[ Google Cloud Storage ] ─────► [ Google BigQuery ] ─────────┘
│
▼
[ BI Corporativo, dbt ELT y Modelos Vertex AI / ML ]
El Motor de Tablas BigQuery en ClickHouse
ClickHouse dispone de un motor de tabla nativo llamado BigQuery que permite consultar conjuntos de datos de Google Cloud directamente desde sentencias SQL en ClickHouse sin necesidad de programar pipelines de sincronización:
-- Crear enlace directo a una tabla alojada en Google BigQuery
CREATE TABLE default.remote_bq_clientes
ENGINE = BigQuery
SETTINGS
    project_id = 'gcp-production-data-project',
    dataset_id = 'enterprise_crm',
    table_id = 'dim_clientes',
    credentials_path = '/etc/clickhouse-server/gcp-service-account.json';

-- Cruzar eventos en tiempo real de ClickHouse con datos dimensionales de BigQuery
SELECT
    e.event_type,
    c.segmento_comercial,
    count(*) AS total_eventos,
    sum(e.revenue_cents) AS ingresos_totales
FROM analytics.user_events AS e
INNER JOIN default.remote_bq_clientes AS c ON e.organization_id = c.organization_id
WHERE e.event_date >= today() - 7
GROUP BY e.event_type, c.segmento_comercial;
11. Preguntas Frecuentes Técnicas (FAQ)
1. ¿Por qué ClickHouse logra latencias sub-10ms mientras que BigQuery rara vez finaliza consultas en menos de un segundo?
ClickHouse ejecuta consultas mediante una arquitectura C++ nativa 'shared-nothing' que mantiene índices primarios dispersos (gránulos de 8.192 filas) mapeados permanentemente en memoria RAM, combinado con vectorización SIMD (AVX-512/AVX2) que procesa datos directamente en cachés locales NVMe o RAM. Por el contrario, Google BigQuery es un servicio serverless multinquilino distribuido donde cada consulta debe pasar por la capa de orquestación Borg, asignar dinámicamente slots de trabajadores Dremel, comunicarse a través de la red de bisección Jupiter con los discos Colossus y coordinar etapas de shuffle en memoria. Esta sobrecarga de orquestación impone un umbral mínimo de latencia de 800ms a 2.500ms, sin importar lo pequeña que sea la consulta.
2. ¿Cómo difieren las mutaciones, actualizaciones y deduplicación entre ClickHouse ReplacingMergeTree y BigQuery MERGE SQL?
ClickHouse se basa en partes columnares inmutables donde las mutaciones tradicionales UPDATE y DELETE reescriben partes completas de forma asíncrona en segundo plano. Para deduplicación en tiempo real y pipelines CDC, ClickHouse emplea motores especializados como ReplacingMergeTree o CollapsingMergeTree, que resuelven duplicados perezosamente en fusiones o al vuelo mediante el operador FINAL. BigQuery admite de forma nativa operaciones ANSI SQL MERGE, UPDATE y DELETE, usando mecanismos de copy-on-write o merge-on-read a nivel de partición. Aunque BigQuery ofrece una sintaxis SQL más directa para actualizaciones dimensionales, mutaciones masivas continuas generan un consumo elevado de slots y costes de reescritura de particiones.
3. ¿Cuál es el punto de equilibrio FinOps entre BigQuery Bajo Demanda ($6.25/TB) y las ediciones con reserva de slots?
El punto de equilibrio financiero depende del volumen y recurrencia de escaneo. A $6.25 USD por TB escaneado, analizar 100 TB al día supone $625 USD diarios ($18.750 USD/mes). En contraste, BigQuery Standard Edition cuesta $0.04 USD por slot-hora ($28.80 USD por 100 slots/día), mientras que Enterprise Edition cuesta $0.06 USD por slot-hora ($43.20 USD por 100 slots/día, o ~$30.24 USD con compromisos anuales). Si la organización ejecuta consultas recurrentes o transformaciones dbt que escanean más de 70 TB diarios, reservar una base de 200 a 500 slots Enterprise con autoescalado dinámico genera un ahorro de entre el 35% y el 65% respecto al esquema Bajo Demanda.
4. ¿Puede ClickHouse sustituir a BigQuery para la exploración ad-hoc de data lakes a escala de petabytes?
ClickHouse puede escalar a petabytes desacoplando almacenamiento en S3 o GCS (ClickHouse Cloud o tablas MergeTree respaldadas en almacenamiento de objetos), pero no está concebido para consultas exploratorias ad-hoc no estructuradas con joins masivos entre miles de tablas sin índices. BigQuery sobresale en exploración ad-hoc a petabytes porque su motor Borg asigna al instante miles de slots para procesar joins dinámicos, JSON anidado y escaneos completos sin necesidad de configurar clústeres. El estándar arquitectónico recomendado es un modelo híbrido: BigQuery como repositorio lakehouse central para ELT y ciencia de datos, y ClickHouse como capa operacional acelerada para paneles de clientes y telemetría en tiempo real.
5. ¿Cómo se comparan ClickHouse Cloud y ClickHouse autogestionado en términos de costes operativos (TCO) y fiabilidad?
ClickHouse autogestionado en servidores bare-metal dedicados (por ejemplo, instancias AWS EC2 c7i/i4i o servidores dedicados Hetzner) ofrece el menor coste de infraestructura pura, habitualmente un 60% a 75% más económico que las alternativas gestionadas. Sin embargo, exige ingenieros de fiabilidad de bases de datos (DBRE) especializados para coordinar la replicación con ZooKeeper/Keeper, fusiones de partes, rebalanceo de discos y afinamiento del kernel Linux. ClickHouse Cloud abstrae la operativa mediante una arquitectura serverless desacoplada con almacenamiento de objetos, ofreciendo conmutación por error automatizada, actualizaciones sin interrupciones y facturación por Unidades de Cómputo (CU), resultando más rentable para equipos sin administradores de sistemas dedicados.
12. Veredicto Final y Matriz de Decisión para Directores de Tecnología (CTO)
Al tomar la decisión final entre ClickHouse vs BigQuery en 2026, los líderes de ingeniería y arquitectura deben contrastar el patrón de acceso de sus consultas con la realidad económica de su organización:
Matriz de Decisión para la Dirección Técnica:
- Selecciona ClickHouse si: Tu aplicación atiende usuarios web/móviles externos que exigen respuestas analíticas en menos de 100ms; necesitas atender más de 500 QPS concurrentes; ingieres más de 50.000 eventos/segundo desde Kafka; o requieres portabilidad multi-nube y un gasto de infraestructura fijo y predecible.
- Selecciona BigQuery si: Tu organización está estandarizada en Google Cloud Platform; tu carga de trabajo se centra en inteligencia de negocio interna, consultas ad-hoc exploratorias y pipelines de dbt programados; administras petabytes de datos departamentales diversos; o careces de personal especializado en administración de bases de datos.
- Adopta el Patrón Híbrido si: Operas a escala media/alta con necesidades tanto de BI analítico interno como de servicio en tiempo real a clientes externos, utilizando BigQuery como repositorio histórico lakehouse y ClickHouse como capa de aceleración operativa sub-segundo.