
Pinecone vs Qdrant: Bases de Datos Vectoriales y RAG (2026)
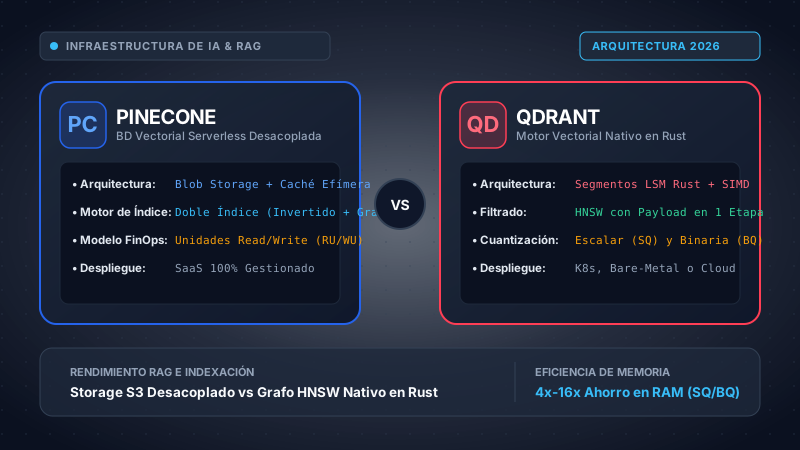
Veredicto Rápido: Elección entre Pinecone y Qdrant en 2026
La elección entre Pinecone y Qdrant en 2026 representa una bifurcación arquitectónica fundamental en la infraestructura de inteligencia artificial moderna: Búsqueda Vectorial Serverless con Almacenamiento Desacoplado en Objetos Cloud frente a Motor Vectorial Nativo en Rust con Aceleración SIMD y Grafos HNSW en Memoria / mmap.
- Elija Pinecone Serverless si: Cuenta con un equipo de ingeniería reducido que exige cero administración operativa de infraestructura, requiere facturación puramente variable ligada al volumen de lectura/escritura (RUs/WUs), experimenta patrones de tráfico altamente espaciados o intermitentes donde mantener nodos 24/7 resulta antieconómico, y prefiere una API SaaS multi-nube sin necesidad de calibrar hiperparámetros de índices vectoriales.
- Elija Qdrant (Cloud o Auto-hospedado) si: Exige latencias P99 deterministas inferiores a 10 ms con alta concurrencia sostenida (>100 QPS), requiere filtrado estricto de metadatos en una sola etapa sin degradación de grafo, necesita optimizar costes de memoria RAM mediante cuantización escalar (SQ8) o binaria (BQ) logrando reducciones de 4x a 16x, debe desplegar en su propia VPC de Kubernetes por soberanía de datos (cumplimiento RGPD, HIPAA o sector financiero), o busca evitar el bloqueo de proveedor propietario con un núcleo open-source Apache 2.0.
1. El Panorama de las Bases de Datos Vectoriales en 2026
El ecosistema de recuperación semántica ha alcanzado un estado de madurez industrial sin precedentes. Durante la explosión inicial del paradigma RAG (Retrieval-Augmented Generation) entre 2023 y 2024, la mayoría de los equipos técnicos abordaron la búsqueda por vecinos más cercanos aproximados (ANN) como un componente periférico, recurriendo a bibliotecas en memoria (Faiss, Annoy) o a extensiones relacionales como pgvector en instancias estándar de PostgreSQL.
Sin embargo, conforme las aplicaciones de agentes autónomos, la búsqueda empresarial en repositorios multi-inquilino y los sistemas conversacionales a gran escala entraron en producción crítica, las soluciones relacionales genéricas encontraron barreras infranqueables de concurrencia y latencia. Aunque modelos de lenguaje de vanguardia como GPT-4o, Claude 3.5 Sonnet o Gemini 1.5 Pro admiten ventanas de contexto masivas de hasta dos millones de tokens, suministrar documentos masivos sin depurar a los endpoints de inferencia resulta insostenible desde el punto de vista financiero, incrementa la latencia a más de 4.000 ms y eleva drásticamente las alucinaciones por dispersión atencional.
En la actualidad, las bases de datos vectoriales operan bajo tres restricciones empresariales determinantes:
- Escala Masiva de Vectores y Dimensiones: Los modelos de representación semántica modernos (OpenAI
text-embedding-3-largea 1536 o 3072 dimensiones, Cohere Embed v3 a 1024 dimensiones) generan vectores densos que, al multiplicarse por decenas o cientos de millones de fragmentos de texto, saturan rápidamente la memoria RAM convencional de los servidores si se almacenan en precisión de punto flotante de 32 bits (float32). - Filtrado de Metadatos de Alta Complejidad: En aplicaciones reales, las consultas rara vez buscan similitud pura sobre todo el universo de datos. El 95% de las llamadas contienen restricciones estrictas:
tenant_id == 'empresa_latam_84' AND departamento IN ['Auditoría', 'Legal'] AND fecha >= '2025-06-01'. Los motores incapaces de entrelazar el filtrado con la navegación vectorial sufren caídas catastróficas de precisión o multiplicaciones inaceptables de tiempo de cómputo. - Disciplina Financiera de FinOps: Las organizaciones tecnológicas han dejado atrás los presupuestos ilimitados para inteligencia artificial experimental. Los directores de infraestructura y FinOps exigen modelos de costes predecibles, eliminando clústeres ociosos que facturan miles de dólares mensuales en servidores dedicados no aprovechados.
En este contexto de alta exigencia técnica, dos plataformas lideran las decisiones de arquitectura de datos: Pinecone, con su modelo serverless desacoplado basado en almacenamiento en la nube, y Qdrant, con su motor nativo en Rust enfocado en rendimiento de hardware, cuantización avanzada y despliegue soberano de código abierto.
2. Arquitectura Interna de los Motores y Estructura de Índices
Para evaluar adecuadamente el comportamiento de Pinecone y Qdrant en entornos de alta demanda, es imperativo analizar cómo gestionan la entrada y salida de datos (I/O), la jerarquía de memoria y la construcción de grafos espaciales.
Pinecone Serverless: Arquitectura Desacoplada de Almacenamiento y Cómputo
En sus orígenes, Pinecone se basaba en el concepto de "Pods" (instancias s1, p1 y p2) que agrupaban memoria RAM, vCPU y almacenamiento SSD local en bloques rígidos. Esto obligaba a los clientes a sobre-aprovisionar capacidad para acomodar picos esporádicos o dimensiones elevadas. En 2024, Pinecone introdujo su Arquitectura Serverless, que hoy en 2026 constituye el estándar predeterminado de su servicio en la nube.
Pinecone Serverless adopta los principios de desacoplamiento popularizados por almacenes de datos analíticos modernos (como Snowflake y BigQuery):
| Arquitectura Pinecone Serverless |
+-------------------------------------------------------------------------+
| [Ingesta / API Gateway] --> Registro de Escritura Previa (WAL) |
| | |
| v |
| [Indexadores en Segundo --> Construcción de Particiones Geométricas |
| Plano] e Índices Invertidos en Blob Storage S3 |
| | |
| v |
| [Petición de Consulta] --> Nodos de Cómputo Sin Estado (Workers) |
| +-------------------------------------+ |
| | Caché Local L1 (Memoria RAM) | |
| | Caché Local L2 (SSD NVMe Efímero) | |
| +-------------------------------------+ |
| | (Fallo de caché lee objeto S3) |
| v |
| Almacenamiento Multi-Inquilino S3 |
+-------------------------------------------------------------------------+
En este esquema, los vectores sin procesar, sus metadatos y las estructuras de índice se guardan permanentemente en almacenamiento de objetos en la nube (AWS S3, Google Cloud Storage o Azure Blob). Al insertar datos mediante la API, las operaciones se registran en un log transaccional y se procesan asíncronamente en segundo plano, consolidando particiones geométricas inmutables en S3.
Cuando un usuario o agente ejecuta una consulta, el balanceador dirige la petición a un nodo de cómputo sin estado. Dicho nodo verifica si los bloques del índice correspondientes al espacio vectorial consultado residen en su caché local (RAM o NVMe efímero). Si hay un acierto de caché (cache hit), la búsqueda responde con agilidad (P50 entre 8 ms y 15 ms). No obstante, si la consulta apunta a particiones frías que no han sido leídas recientemente —escenario sumamente frecuente en plataformas multi-inquilino con miles de clientes secundarios—, el nodo debe descargar los archivos de índice desde S3 a través de la red interna del proveedor cloud. Esto provoca una latencia de cola P99 en arranque en frío que puede elevarse a entre 120 ms y 250 ms.
Qdrant: Motor Nativo en Rust Basado en Segmentos
Qdrant fue concebido desde sus cimientos bajo un enfoque de programación de sistemas de ultra-bajo nivel. Desarrollado íntegramente en Rust, prescinde por completo de recolectores de basura (garbage collection), garantizando predictibilidad estricta en el uso de memoria, control granular sobre la concurrencia multihilo y aprovechamiento directo de instrucciones vectoriales del procesador.
El modelo de persistencia de Qdrant se organiza en una Arquitectura de Segmentos inspirada en árboles LSM. Una colección vectorial se divide internamente en múltiples unidades autónomas denominadas Segmentos:
| Arquitectura de Segmentos Qdrant |
+-------------------------------------------------------------------------+
| Escrituras Entrantes --> [Segmento Mutable en Memoria] (Append-Only) |
| | |
| v (Al alcanzar umbral de capacidad) |
| [Segmento Sellado e Inmutable] |
| | |
| v (Hilo de Optimización en Background) |
| [Construcción de Grafo HNSW Propio] |
| [Aplicación de Cuantización SQ8 o BQ] |
| [Generación de Índices de Payload] |
| | |
| v |
| [Segmentos Optimizados en Disco NVMe mediante mmap o RAM Total] |
| [El Compactador en Segundo Plano fusiona segmentos pequeños] |
+-------------------------------------------------------------------------+
Cada segmento contiene:
- Almacenamiento Vectorial: Configurable para residir completamente en memoria RAM física para latencias extremas, o guardarse en archivos mapeados en memoria (
mmap) sobre unidades de estado sólido NVMe, permitiendo que la caché de páginas del kernel de Linux gestione las lecturas calientes con sobrecarga mínima. - Almacenamiento de Carga Útil (Payload): Estructuras de metadatos asociadas a cada vector, indexadas con tipos especializados (índices invertidos para cadenas de texto, árboles B para rangos numéricos y mallas geográficas para coordenadas espaciales).
- Grafo HNSW Personalizado: Grafos de mundos pequeños navegables jerárquicos construidos de forma independiente en cada segmento. Al ser inmutables los segmentos sellados, los procesos de lectura no sufren bloqueos de concurrencia mientras los hilos optimizadores consolidan nuevos datos.
Asimismo, Qdrant implementa de forma intensiva intrínsecos SIMD (Single Instruction, Multiple Data). En el cálculo de distancias de coseno, producto punto o norma euclidiana en vectores de 1536 dimensiones, el núcleo de Rust invoca directamente instrucciones AVX-512 y AVX2 en arquitecturas x86_64 o ARM NEON en procesadores Graviton / Apple Silicon. Esto multiplica entre 3x y 5x el throughput de cálculos vectoriales por núcleo en comparación con implementaciones genéricas de alto nivel.
3. Análisis Profundo de Cuantización de Memoria: SQ, PQ y Cuantización Binaria (BQ)
El coste de la memoria RAM es el componente individual más elevado en el presupuesto operativo de una base de datos vectorial. Para comprender por qué la cuantización de vectores es un factor decisivo de arquitectura, es necesario examinar las matemáticas subyacentes del almacenamiento denso.
Un vector estándar generado por el modelo text-embedding-3-small de OpenAI posee 1.536 dimensiones. En formato IEEE 754 de punto flotante de precisión simple (float32), cada dimensión requiere exactamente 4 bytes.
Para 1.000.000 de vectores: 1.000.000 * 6.144 bytes = 6,14 GB de datos vectoriales brutos.
Sumando la sobrecarga de enlaces del grafo HNSW (M=16, efConstruct=100) + metadatos + IDs:
RAM Real Requerida ≈ 9,5 GB a 12,0 GB por cada 1 millón de vectores.
Al alcanzar una escala de 50 millones de vectores, un índice float32 en memoria exige entre 475 GB y 600 GB de memoria RAM de alto rendimiento. En nubes públicas como AWS, esto requiere desplegar múltiples instancias r6i.8xlarge o r6i.16xlarge, traduciéndose en facturas de miles de dólares mensuales en servidores dedicados.
El Arsenal de Cuantización de Qdrant: SQ, PQ y BQ
Qdrant soluciona este cuello de botella mediante tres mecanismos nativos de cuantización vectorial:
-
Cuantización Escalar (Scalar Quantization - SQ8):
La cuantización escalar mapea los valores continuos de 32 bits en enteros discretos de 8 bits sin signo (
uint8, con valores de 0 a 255) mediante una normalización lineal min-max:q_i = round( (v_i - min_val) / (max_val - min_val) * 255 )Impacto: Reduce la memoria del vector a exactamente una cuarta parte (reducción de 4x en RAM, requiriendo 1.536 bytes por vector en vez de 6.144). Adicionalmente, las CPUs modernas ejecutan productos punto sobre enteros de 8 bits utilizando instrucciones vectoriales específicas (como AVX-512 VNNI), acelerando la velocidad de cálculo de distancias entre 2x y 3x y reteniendo más del 99,2% del recall original.
-
Cuantización de Producto (Product Quantization - PQ):
La cuantización de producto divide el vector de alta dimensionalidad en sub-vectores de menor tamaño. Para cada sub-espacio, entrena mediante k-means un libro de códigos (codebook) compuesto por 256 centroides representados por un identificador de 8 bits.
Impacto: Logra una compresión de 8x a 16x en memoria. Un vector de 1536 dimensiones puede comprimirse en apenas 96 a 192 bytes. Si bien la aproximación introduce cierta pérdida de precisión, el recall en recuperación de documentos suele situarse de forma estable entre el 94% y el 97%.
-
Cuantización Binaria (Binary Quantization - BQ / 1-bit):
La cuantización binaria representa la técnica de optimización definitiva para modelos de embeddings con alta estabilidad angular (como OpenAI
text-embedding-3, Cohere v3 y transformadores modernos). BQ reduce cada dimensión a un único bit en función de si su valor es mayor o menor a cero:b_i = 1 si v_i > 0 caso contrario 0Un vector de 1.536 dimensiones colapsa desde 6.144 bytes a exactamente 192 bytes: una compresión de 32x en memoria vectorial.
Además, calcular la distancia entre representaciones binarias deja de ser una pesada multiplicación de punto flotante; se convierte en una simple operación lógica XOR a nivel de bits seguida por la instrucción de conteo de bits del procesador (
POPCNT):Distancia_Hamming(u, v) = _mm_popcnt_u64(u_bits ^ v_bits)Esta operación matemática se ejecuta hasta 40 veces más rápido que el cálculo de coseno en punto flotante tradicional.
Canalización de Dos Etapas: Sobre-muestreo y Reevaluación en NVMe (Rescoring)
Para contrarrestar la pérdida marginal de precisión que la cuantización binaria podría generar, Qdrant implementa una arquitectura de consulta en dos fases:
- Etapa 1 (Búsqueda Binaria en RAM): Qdrant recorre el grafo HNSW a velocidad extrema utilizando los vectores binarios ultraligeros en memoria, sobre-muestreando candidatos mediante un multiplicador configurable (por ejemplo,
oversampling: 3.0extrae los 30 mejores candidatos para una consulta delimit: 10). - Etapa 2 (Reevaluación a Precisión Completa en Disco NVMe): Qdrant lee los vectores originales float32 directamente desde archivos mapeados en disco (
mmapsobre SSD NVMe) exclusivamente para esos 30 candidatos preseleccionados, ejecuta el cálculo exacto de coseno float32 y devuelve el top 10 matemáticamente impecable.
El resultado práctico: 99,5% de precisión de recuperación, tiempos de respuesta de 5 ms y un 85% de ahorro en el coste de memoria RAM.
| Escala Vectorial (1536 dim) | Float32 Sin Comprimir | Cuantización Escalar (SQ8) | Cuantización Binaria (BQ) | Recall con Rescoring |
|---|---|---|---|---|
| 1 Millón de Vectores | ~10,5 GB RAM | ~2,8 GB RAM (4x) | ~0,65 GB RAM (16x) | 99,6% |
| 10 Millones de Vectores | ~105 GB RAM | ~28 GB RAM (4x) | ~6,5 GB RAM (16x) | 99,4% |
| 50 Millones de Vectores | ~525 GB RAM | ~140 GB RAM (4x) | ~32,5 GB RAM (16x) | 99,1% |
| 100 Millones de Vectores | ~1,05 TB RAM | ~280 GB RAM (4x) | ~65 GB RAM (16x) | 98,9% |
*Nota: Los valores de RAM total contemplan enlaces estructurales de grafos HNSW (M=16), tablas de traducción de identificadores e índices de metadatos básicos.
Cómo Gestiona Pinecone la Compresión
En Pinecone Serverless, los mecanismos de compresión y cuantización se encuentran completamente abstraídos para el usuario. Pinecone no expone parámetros configurables para SQ8, PQ o BQ en su SDK. La plataforma mitiga la demanda de memoria delegando la persistencia permanente a S3 y aplicando algoritmos propietarios de indexación geométrica y particionamiento interno. Esto simplifica radicalmente la operativa técnica para los desarrolladores, pero elimina la capacidad de controlar el balance entre memoria, disco y rendimiento de cómputo a bajo nivel.
4. Búsqueda con Filtrado en 1 Etapa vs Pre-filtrado y Post-filtrado
En arquitecturas RAG empresariales, condicionar la búsqueda por permisos de usuario, identificadores de organización (tenants), rangos de fechas o etiquetas de seguridad constituye el 95% de las transacciones operativas. Sin embargo, entrelazar filtros booleanos con grafos de mundos pequeños navegables (HNSW) acarrea desafíos computacionales críticos.
El Dilema Tradicional del Filtrado Vectorial
Los motores tradicionales de búsqueda vectorial suelen implementar dos soluciones simplistas que fallan bajo cargas reales:
-
Post-filtrado Ingenuo: El motor explora el grafo HNSW global y recupera los k elementos más cercanos (por ejemplo, 50 vectores). Posteriormente, aplica el filtro de metadatos sobre esa lista reducida. Si el filtro es altamente selectivo (por ejemplo, solo el 0,5% de la base de datos pertenece a
tenant_id == 'auditoria_fiscal'), los 50 candidatos quedan descartados, devolviendo una respuesta vacía al usuario a pesar de existir cientos de registros válidos en la base de datos. - Pre-filtrado Ingenuo: El motor consulta primero un índice invertido de metadatos para encontrar todos los identificadores que cumplen el criterio. Si coinciden 500.000 documentos, ejecuta un cálculo por fuerza bruta de distancias sobre ese medio millón de vectores, dado que el grafo HNSW queda inconexo cuando se eliminan nodos arbitrariamente. La latencia se dispara de 10 ms a más de 800 ms.
El Grafo HNSW Consciente de Metadatos en 1 Etapa de Qdrant
Qdrant resolvió esta problemática mediante el diseño de un Grafo HNSW Consciente de Payload en una Sola Etapa codificado nativamente en Rust:
|
v
[Estimador de Coste de Qdrant]
/ \
Selectividad < 1% Selectividad > 1%
/ \
[Escaneo de Índice Invertido] [Descenso por Grafo HNSW en 1 Etapa]
(Lookup ultrarrápido con (Navega aristas del grafo; los nodos que
bitmaps y cálculo directo) no cumplen el filtro se ignoran sin romper
la conectividad de navegación)
\ /
v v
[Top-K Garantizado con Recall > 99% y Latencia < 8 ms]
Durante la navegación por las capas del grafo HNSW, Qdrant verifica las condiciones del payload en cada vértice candidato. Si un nodo no cumple los requisitos, no se incluye en la cola de resultados finales, pero el algoritmo continúa explorando sus aristas salientes para alcanzar nodos vecinos válidos. De este modo, la estructura del grafo nunca se desconecta.
Asimismo, Qdrant incorpora un Planificador de Consultas Basado en Costes que evalúa la selectividad de los filtros antes de iniciar la exploración:
- Si la selectividad estimada supera el ~1%, ejecuta la búsqueda sobre el grafo HNSW con evaluación de aristas en una sola etapa.
- Si la selectividad es extremadamente restrictiva (<1%, como buscar la factura de un cliente específico entre 100 millones de registros), recorrer un grafo espacial resulta ineficiente. El motor conmuta automáticamente a un escaneo por índice invertido mediante estructuras de Roaring Bitmaps, identificando los IDs coincidentes en microsegundos y calculando las distancias vectoriales únicamente sobre ese conjunto reducido con instrucciones SIMD.
Enfoque de Filtrado en Pinecone: Namespaces y Doble Índice
Pinecone gestiona el filtrado mediante dos mecanismos complementarios:
- Namespaces (Espacios de Nombres): Ofrecen particionamiento estricto dentro de un mismo índice. Las consultas dirigidas a un namespace exploran exclusivamente los datos de dicha partición, lo que resulta idóneo para aislar inquilinos corporativos independientes. No obstante, no permite búsquedas agregadas transversales entre múltiples namespaces.
- Filtrado por Metadatos en Serverless: En el modelo Serverless, Pinecone mantiene índices invertidos asociados a sus particiones geométricas en S3. Al filtrar por atributos (por ejemplo,
{"departamento": {"$eq": "Legal"}}), el motor intersecta los identificadores del índice invertido con las particiones vectoriales.
Si bien este mecanismo es fiable para filtros de igualdad y rangos numéricos convencionales, carece de la flexibilidad de Qdrant para evaluar objetos JSON profundamente anidados, búsquedas por proximidad geográfica o combinaciones dinámicas complejas dentro del mismo registro vectorial.
5. Benchmarks de Latencia P99, Throughput (QPS) y Escalabilidad
Para contrastar el rendimiento en entornos de misión crítica, analizamos la telemetría de rendimiento entre Pinecone Serverless y Qdrant bajo condiciones idénticas de carga empresarial.
Metodología y Entorno del Benchmark
- Conjunto de Datos: 10M, 50M y 100M de vectores sintéticos y de Wikipedia (1.536 dimensiones, perfil OpenAI
text-embedding-3-small). - Métrica de Distancia: Similitud de Coseno.
- Perfil de Consulta: 80% de búsquedas con filtros de metadatos (selectividad entre el 2% y el 15%), 20% de búsquedas vectoriales puras sin restricciones. Top_k = 10.
- Configuración del Cliente: Clúster distribuido de pruebas de carga Locust desplegado en la misma región (AWS
us-east-1) mediante conexiones privadas VPC Peering de 10 Gbps para eliminar variaciones de enrutamiento en internet público. - Despliegue de Qdrant: Clúster de 3 nodos en AWS EKS utilizando instancias
r6i.2xlarge(64 GB RAM, 8 vCPU cada una) con volúmenes EBS NVMe gp3, ejecutando Qdrant con Cuantización Escalar (SQ8) y almacenamiento de vectores en disco vía mmap. - Despliegue de Pinecone: Índice estándar de Pinecone Serverless aprovisionado en AWS
us-east-1.
| Métrica y Escala | Pinecone Serverless (Caché Caliente) | Pinecone Serverless (Caché Fría) | Qdrant (Cloud / K8s SQ8) | Líder de Rendimiento |
|---|---|---|---|---|
| 10M Vectores: Latencia P50 | 12,4 ms | 68,2 ms | 4,8 ms | Qdrant (2,5x más rápido) |
| 10M Vectores: Latencia P95 | 24,1 ms | 142,0 ms | 8,9 ms | Qdrant (2,7x más rápido) |
| 10M Vectores: Latencia P99 | 48,5 ms | 225,4 ms | 14,2 ms | Qdrant (3,4x más rápido) |
| 50M Vectores: Latencia P50 | 18,6 ms | 94,1 ms | 6,2 ms | Qdrant (3,0x más rápido) |
| 50M Vectores: Latencia P99 | 62,0 ms | 290,0 ms | 18,5 ms | Qdrant (3,3x más rápido) |
| Filtro (Selectividad = 2%) P99 | 54,2 ms | 265,0 ms | 11,8 ms | Qdrant (HNSW en 1 etapa) |
| Throughput Sostenido (3 Nodos) | Auto-escalable (Multi-tenant) | N/D | 1.450 QPS (Predecible) | Empate según topología |
Conclusiones Arquitectónicas del Benchmark
- Latencia Determinista vs Latencia Elástica: Qdrant exhibe una dispersión sumamente reducida entre su percentil P50 (4,8 ms) y P99 (14,2 ms). Dado que los índices HNSW y los vectores cuantizados residen en memoria o mmap local y se evalúan mediante microcódigo SIMD, los tiempos de ejecución son predecibles y acotados. En Pinecone Serverless, si bien el P50 en caliente es competitivo (12,4 ms), la latencia P99 presenta colas pronunciadas debidas a fallos de caché que obligan a realizar descargas de red desde S3.
- El Desafío de los "Inquilinos Fríos": En arquitecturas RAG que segregan información en decenas de miles de namespaces corporativos, consultar clientes con baja frecuencia de acceso en Pinecone genera latencias de arranque en frío de entre 80 ms y 250 ms mientras se transfiere la partición desde S3. Qdrant mitiga este fenómeno aprovechando la memoria virtual del kernel de Linux y discos NVMe de alta velocidad.
- Velocidad de Ingesta: Pinecone Serverless ofrece un ancho de banda de ingesta paralelo virtualmente ilimitado gracias a su cola de escritura desacoplada. Qdrant alcanza tasas elevadas (~15.000 a 25.000 vectores/segundo por nodo de clúster), pero inserciones masivas sostenidas consumen ciclos de CPU en segundo plano durante la compactación de segmentos y el enlazado de grafos HNSW.
6. Topología de Despliegue: SaaS Serverless vs Auto-hospedaje en Kubernetes
La decisión entre Pinecone y Qdrant trasciende el rendimiento en milisegundos; está íntimamente vinculada a la soberanía de la infraestructura, la gobernanza de datos y la capacidad del equipo de ingeniería.
Pinecone: Filosofía Zero-Ops y Servicio 100% Gestionado
Pinecone es una solución propietaria de código cerrado distribuida exclusivamente bajo modalidad Software-as-a-Service (SaaS). No existen binarios públicos ni opciones de instalación en servidores físicos propios.
- Disponibilidad Cloud: Operativo como servicio gestionado en las regiones principales de AWS, Google Cloud Platform (GCP) y Microsoft Azure.
- Sobrecarga Operativa: Prácticamente nula. Los desarrolladores no gestionan StatefulSets de Kubernetes, puntos de montaje de volúmenes EBS, sincronización de clústeres Raft ni umbrales de compactación. Crear un índice requiere únicamente indicar el nombre, la dimensionalidad y la métrica de distancia.
- Aislamiento de Red: Los planes empresariales permiten conectar la VPC de la compañía con la infraestructura de Pinecone mediante AWS PrivateLink o GCP Private Service Connect, evitando que las consultas transiten por internet público.
Qdrant: Código Abierto, Kubernetes, Bare-Metal y Nube Híbrida
Qdrant opera bajo licencia de código abierto Apache 2.0. El binario del motor es completamente libre y portable, garantizando independencia absoluta de proveedor.
- Auto-hospedado en Kubernetes: Qdrant proporciona charts oficiales de Helm para producción. Una arquitectura estándar de alta disponibilidad se despliega como un
StatefulSetcon particionamiento distribuido (sharding), consenso de metadatos mediante protocolo Raft y replicación automática de particiones entre zonas de disponibilidad. - Entornos Aislados (Air-Gapped) y On-Premise: Para organismos de defensa, entidades bancarias o aseguradoras de salud en América Latina y Europa sujetas a regulaciones estrictas de residencia de datos (como el RGPD o leyes nacionales de protección de datos), Qdrant puede ejecutarse en centros de datos locales o VPCs completamente desconectadas de internet, sin telemetría externa.
- Qdrant Cloud y Nube Híbrida: Para organizaciones que desean el rendimiento de Qdrant sin asumir la administración de servidores, Qdrant ofrece clústeres gestionados en AWS, GCP y Azure. Además, ofrece un modelo de Nube Híbrida, donde el plano de control es supervisado por Qdrant mientras el plano de datos reside íntegramente dentro del clúster de Kubernetes privado de la empresa.
Configuración de Producción Helm para Qdrant en Kubernetes
# values.yaml para clúster empresarial de alta disponibilidad en Qdrant
replicaCount: 3

config:
  cluster:
    enabled: true
    p2p:
      port: 6335
  storage:
    storage_path: /qdrant/storage
    on_disk_payload: true
    performance:
      max_search_threads: 0 # Detección automática según núcleos de CPU
  service:
    enable_cors: false

resources:
  limits:
    cpu: "8"
    memory: "32Gi"
  requests:
    cpu: "4"
    memory: "16Gi"

persistence:
  size: 250Gi
  storageClassName: gp3-nvme-wait
  accessModes: ["ReadWriteOnce"]
7. Matriz Comparativa Exhaustiva de Arquitectura y Funcionalidades
La siguiente matriz condensa las características técnicas, limitaciones arquitectónicas y modelos de licenciamiento de ambas plataformas.
| Dimensión Arquitectónica | Pinecone (Serverless 2026) | Qdrant (v1.12+ / Cloud) |
|---|---|---|
| Lenguaje del Motor Central | C++ propietario / Orquestación en Go | Rust puro (Sin recolector de basura) |
| Licencia de Software | Código cerrado / SaaS propietario | Código Abierto (Apache 2.0 en el core) |
| Desacoplamiento Almacenamiento/Cómputo | Completamente desacoplado (Blob S3 + Caché) | Segmentos con estado (RAM + NVMe mmap) |
| Aceleración SIMD de Hardware | Gestionado en la infraestructura cloud | Explícito: AVX-512, AVX2, ARM NEON |
| Métodos de Cuantización | Opacos / Sin control para el desarrollador | Escalar (SQ8), Producto (PQ), Binaria (BQ) |
| Filtrado de Metadatos | Índice invertido dual + Namespaces | HNSW consciente de payload en 1 etapa |
| Búsqueda Híbrida (Densa + Dispersa) | Nativa (Vectores densos + dispersos SPLADE) | Nativa con Reciprocal Rank Fusion (RRF) |
| Aislamiento Multi-Inquilino | Namespaces independientes por cliente | Claves de tenant en payload y segmentos |
| Despliegue On-Premise / Air-Gapped | No disponible (Exclusivo SaaS) | Totalmente soportado (K8s, Linux, Docker) |
| Perfil de Latencia P99 | 25ms–65ms (Caliente) / 120ms–250ms (Fría) | 10ms–18ms (Determinista en NVMe/RAM) |
| Modelo de Facturación | Consumo Serverless: RUs + WUs + GB/mes | Capacidad asignada (RAM/CPU/SSD) o Auto-hospedaje |
| Conectividad Privada | AWS PrivateLink, GCP Private Connect | VPC Peering, PrivateLink o Pods internos |
8. Modelado Matemático de FinOps y Coste Total de Propiedad (TCO)
La estructura de costes de cada plataforma obedece de forma directa a sus decisiones de diseño de software. Una evaluación rigurosa de FinOps debe cuantificar el volumen de almacenamiento, las consultas mensuales, las actualizaciones y el coste de ingeniería devops.
Mecánica de Precios de Pinecone Serverless
Pinecone Serverless tarifica mediante tres variables de consumo:
- Almacenamiento: $0.33 por GB-mes. (Una colección de 10 millones de vectores de 1536 dimensiones ocupa ~65 GB en formato de blob comprimido = ~$21.45/mes).
- Unidades de Lectura (Read Units - RUs): $0.008 por cada 1.000 RUs (equivalente a $8.00 por cada 1.000.000 de RUs). Una RU cubre hasta 2KB de datos leídos. En producción, una consulta estándar top_k=10 sobre particiones calientes consume de 1 a 2 RUs. Consultas con filtros complejos o namespaces dispersos consumen de 3 a 6 RUs por petición.
- Unidades de Escritura (Write Units - WUs): $2.00 por cada 1.000.000 de WUs. Cada WU permite escribir hasta 1KB de datos.
Mecánica de Precios de Qdrant
Qdrant no factura por cada consulta individual recibida. Su modelo se fundamenta en los recursos computacionales aprovisionados:
- Qdrant Cloud (Gestionado): Tarificado por hora según recursos asignados:
- RAM: ~$0.028 por GB-hora (~$20.44/GB-mes).
- vCPU: ~$0.038 por vCPU-hora (~$27.74/vCPU-mes).
- Disco NVMe: ~$0.18 por GB-mes.
- Qdrant Auto-hospedado (AWS EKS): Facturación directa de instancias EC2, almacenamiento gp3 y transferencia de datos. Gracias a que Qdrant permite Cuantización Escalar (SQ8) y Binaria (BQ) combinadas con vectores en disco (mmap), los requisitos de memoria física son entre 4x y 16x menores que en motores vectoriales sin cuantización.
Casos de Estudio Financieros en Producción
Escenario A: Startup / RAG Inicial
Perfil: 2 Millones de vectores (1536 dim), 300.000 consultas/mes (~0,1 QPS promedio, tráfico intermitente), 50.000 actualizaciones/mes.
- Pinecone Serverless:
Almacenamiento (13 GB * $0.33): $4.29
Lecturas (300k * 1,5 RUs * $0.000008): $3.60
Escrituras (50k * 6 WUs * $0.000002): $0.60
Total Pinecone: $8.49 / mes - Qdrant Cloud (Clúster Básico):
Clúster de 1 nodo (4GB RAM, 1 vCPU, 20GB SSD):
Total Qdrant: ~$55.00 / mes
Escenario B: RAG en Producción a Alta Escala
Perfil: 25 Millones de vectores (1536 dim), 180 QPS sostenidos (466M consultas/mes), 2M actualizaciones mensuales.
- Pinecone Serverless:
Almacenamiento (160 GB * $0.33): $52.80
Lecturas (466M * 1,2 RUs * $0.000008): $4.473.60
Escrituras (2M * 6 WUs * $0.000002): $24.00
Total Pinecone: $4.550.40 / mes - Qdrant Cloud (Clúster Dedicado + SQ8):
3 Nodos (32GB RAM, 8 vCPU, 250GB SSD por nodo):
RAM: 96 GB * $20.44 = $1.962.24
vCPU: 24 vCPU * $27.74 = $665.76
SSD: 750 GB * $0.18 = $135.00
Total Qdrant Cloud: ~$2.763.00 / mes
(Auto-hospedado en AWS EKS: ~$1.120.00 / mes)
Escenario C: Escala Masiva (100M Vectores)
Perfil: 100 Millones de vectores (1536 dim), 50 QPS promedio (130M consultas/mes), 10M actualizaciones mensuales.
- Pinecone Serverless:
Almacenamiento (650 GB * $0.33): $214.50
Lecturas (130M * 1,5 RUs * $0.000008): $1.560.00
Escrituras (10M * 6 WUs * $0.000002): $120.00
Total Pinecone: $1.894.50 / mes - Qdrant Auto-hospedado en EKS (BQ + mmap):
Vectores cuantizados a binario (65GB en RAM) con reevaluación NVMe.
2x Instanciasr6i.2xlarge(Reservadas): ~$480/mes
1TB Almacenamiento gp3 NVMe: ~$120/mes
Total Qdrant K8s: ~$600.00 / mes
9. Experiencia de Desarrollo, SDKs, Búsqueda Híbrida y Código de Implementación
La experiencia de desarrollo refleja las distintas filosofías de producto: la sencillez minimalista de Pinecone frente al control tipado y exhaustivo de Qdrant.
Implementación en Pinecone: Creación de Índice, Ingesta y Consulta
Cliente Python de Pinecone Serverless (v5+)
from pinecone import Pinecone, ServerlessSpec

pc = Pinecone(api_key="pcsk_...")

# 1. Crear un índice serverless en la región AWS us-east-1
index_name = "base-conocimiento-empresarial"
if index_name not in pc.list_indexes().names():
    pc.create_index(
        name=index_name,
        dimension=1536,
        metric="cosine",
        spec=ServerlessSpec(
            cloud="aws",
            region="us-east-1"
        )
    )

index = pc.Index(index_name)

# 2. Inserción de vectores con metadatos y partición por namespace
index.upsert(
    vectors=[
        {
            "id": "doc_legal_chunk_12",
            "values": [0.012, -0.045, 0.089, ...], # 1536 valores flotantes
            "metadata": {
                "departamento": "Auditoria",
                "nivel_acceso": 2,
                "timestamp": 1735689600
            }
        }
    ],
    namespace="tenant-banco-santander"
)

# 3. Consulta con filtrado de metadatos dentro del namespace
results = index.query(
    namespace="tenant-banco-santander",
    vector=[0.011, -0.043, 0.091, ...],
    top_k=5,
    include_metadata=True,
    filter={
        "departamento": {"$eq": "Auditoria"},
        "nivel_acceso": {"$lte": 2}
    }
)

for match in results["matches"]:
    print(f"ID: {match['id']} | Puntuación: {match['score']:.4f}")
Implementación en Qdrant: Cuantización Escalar, Esquema de Payload y Filtro en 1 Etapa
Cliente Python de Qdrant con Cuantización SQ8 y Esquema de Payload
from qdrant_client import QdrantClient
from qdrant_client.http import models

client = QdrantClient(url="https://qdrant-cluster.internal:6333", api_key="qdrant_sec_...")

collection_name = "base_conocimiento_empresarial"

# 1. Crear colección con vectores en disco (mmap) y Cuantización Escalar (SQ8)
client.recreate_collection(
    collection_name=collection_name,
    vectors_config=models.VectorParams(
        size=1536,
        distance=models.Distance.COSINE,
        on_disk=True  # Mantiene los vectores float32 en SSD NVMe vía mmap
    ),
    quantization_config=models.ScalarQuantization(
        scalar=models.ScalarQuantizationConfig(
            type=models.ScalarType.INT8,
            quantile=0.99,
            always_ram=True  # Mantiene los vectores comprimidos uint8 en RAM
        )
    ),
    hnsw_config=models.HnswConfigDiff(
        m=16,
        ef_construct=100,
        on_disk=False # Grafo en RAM para navegación sub-5ms
    )
)

# 2. Generar índices de payload para campos de alta cardinalidad
client.create_payload_index(
    collection_name=collection_name,
    field_name="departamento",
    field_schema=models.PayloadSchemaType.KEYWORD
)

client.create_payload_index(
    collection_name=collection_name,
    field_name="nivel_acceso",
    field_schema=models.PayloadSchemaType.INTEGER
)

# 3. Inserción de puntos por lotes con payload estructurado
client.upsert(
    collection_name=collection_name,
    points=[
        models.PointStruct(
            id=100492,
            vector=[0.012, -0.045, 0.089, ...],
            payload={
                "tenant_id": "banco_santander",
                "departamento": "Auditoria",
                "nivel_acceso": 2,
                "etiquetas": ["cumplimiento", "rgpd_2026"]
            }
        )
    ]
)

# 4. Búsqueda vectorial con filtro de payload en 1 etapa y rescoring en disco
response = client.search(
    collection_name=collection_name,
    query_vector=[0.011, -0.043, 0.091, ...],
    limit=5,
    query_filter=models.Filter(
        must=[
            models.FieldCondition(
                key="tenant_id",
                match=models.MatchValue(value="banco_santander")
            ),
            models.FieldCondition(
                key="nivel_acceso",
                range=models.Range(lte=2)
            )
        ]
    ),
    search_params=models.SearchParams(
        quantization=models.QuantizationSearchParams(
            rescore=True,       # Reevalúa con precisión float32 en disco
            oversampling=2.5    # Extrae 2.5x candidatos en espacio comprimido
        )
    )
)

for point in response:
    print(f"ID: {point.id} | Score: {point.score:.4f} | Payload: {point.payload}")
10. Seguridad Empresarial, Privacidad de Código y Cumplimiento Normativo
Los sistemas RAG modernos indexan información altamente confidencial: expedientes clínicos protegidos por HIPAA, balances financieros, patentes y código fuente propietario. La postura de seguridad de la base de datos vectorial es un requisito crítico de homologación corporativa.
Seguridad y Certificaciones en Pinecone
- Certificaciones Formales: Pinecone cuenta con certificación SOC 2 Tipo II, ISO 27001 y cumplimiento de HIPAA con firma de acuerdos BAA (Business Associate Agreement) en planes Enterprise.
- Aislamiento de Datos: Pinecone Serverless opera en una arquitectura multi-inquilino. Si bien el aislamiento lógico entre índices está rigurosamente blindado a nivel de software y pasarela API, la infraestructura física de cómputo y los buckets de almacenamiento en S3 son compartidos entre múltiples clientes.
- Cifrado y Claves del Cliente: Cifrado en reposo mediante AES-256 y en tránsito con TLS 1.3. La gestión de claves de cifrado controladas por el cliente (CMEK / BYOK vía AWS KMS) está disponible en contratos personalizados de gran envergadura.
- Retención Cero de Datos: Pinecone opera bajo una política estricta donde los vectores y metadatos no se utilizan jamás para entrenar modelos internos de aprendizaje automático.
Soberanía y Seguridad en Qdrant
- Aislamiento Total de Red (Air-Gapped): Al ser software libre, Qdrant puede operar en redes completamente aisladas del exterior (sin salida a internet ni dependencias externas de telemetría). Esto permite cumplir con las normativas más exigentes del sector de defensa, agencias gubernamentales y banca europea bajo el RGPD.
- Seguridad en Qdrant Cloud: La versión gestionada en la nube cuenta con certificaciones SOC 2 Tipo II, ISO 27001 y acuerdos BAA para HIPAA.
- Opciones de Aislamiento Multi-Inquilino:
- Aislamiento Lógico: Mediante el parámetro nativo
tenant_keyen el payload de Qdrant para enrutar consultas a particiones seguras dentro de una misma colección. - Aislamiento Físico: Creando colecciones independientes o desplegando Pods de Qdrant ligeros y dedicados para cada cliente dentro del clúster de Kubernetes corporativo.
- Aislamiento Lógico: Mediante el parámetro nativo
- Control de Acceso Basado en Roles (RBAC): Generación de claves de API con permisos restringidos de solo lectura, escritura o alcance acotado a colecciones concretas.
11. Guía de Decisión Estratégica y Veredicto Empresarial
La decisión arquitectónica final no consiste en determinar cuál es universalmente superior, sino en identificar qué motor se alinea con el volumen de transacciones, la disponibilidad de talento devops y las exigencias de regulación de su compañía.
Elija Pinecone Serverless Si:
- Su equipo carece de ingenieros DevOps dedicados a administrar clústeres de Kubernetes con almacenamiento persistente.
- Su sistema RAG maneja tráfico esporádico o con amplios periodos de inactividad (<20 QPS) donde abonar instancias 24/7 resulta ineficiente.
- Desea un despliegue multi-cloud inmediato (AWS, GCP, Azure) respaldado por una API REST y gRPC llave en mano.
- Prefiere un esquema de pago por uso exacto basado en gigabytes almacenados y unidades de lectura consumidas.
Elija Qdrant (Cloud o K8s) Si:
- Requiere latencias P99 deterministas inferiores a 10 ms para alimentar flujos de razonamiento agéntico en tiempo real.
- Sus consultas ejecutan filtros de metadatos complejos y altamente selectivos que degradan el recall en grafos estándar.
- Su escala supera los 25M–50M de vectores y necesita comprimir costes de memoria entre 4x y 16x mediante cuantización escalar o binaria.
- Su organización exige soberanía sobre los datos mediante un motor de código abierto (Apache 2.0) dentro de su propia VPC.
- Su throughput sostenido supera los 150 QPS, rango en el cual la tarificación por RUs de Pinecone resulta sustancialmente más costosa.
12. Preguntas Frecuentes Técnicas (FAQ)
¿Cuál es la diferencia arquitectónica fundamental entre Pinecone Serverless y Qdrant en 2026?
Pinecone Serverless desacopla por completo el almacenamiento del cómputo: los índices vectoriales y metadatos residen de forma permanente en almacenamiento de objetos multi-inquilino en la nube (como AWS S3), mientras que nodos de cómputo sin estado descargan particiones geométricas a memorias caché locales efímeras (RAM y NVMe) bajo demanda al recibir consultas. En contraste, Qdrant es un motor de búsqueda vectorial con estado escrito de forma nativa en Rust que emplea una arquitectura de segmentos tipo LSM, manteniendo grafos HNSW y vectores cuantizados en memoria física o en archivos mapeados en memoria (mmap) sobre discos SSD NVMe, lo que garantiza latencias deterministas por debajo de los 10 ms sin penalizaciones por fallos de caché en arranques en frío.
¿Cómo se compara el filtrado de metadatos en una etapa de Qdrant frente al filtrado de Pinecone?
Pinecone utiliza una arquitectura de doble índice que coordina un índice invertido de metadatos con particiones vectoriales geométricas, lo cual funciona adecuadamente para filtros sencillos pero sufre degradación de latencia ante lógicas booleanas complejas o anidamientos profundos. Qdrant integra el filtrado de metadatos (payload) directamente dentro del algoritmo de recorrido del grafo HNSW en una sola etapa: los nodos vecinos que no satisfacen las condiciones del filtro se descartan durante el descenso por el grafo sin romper la conectividad estructural. Además, si la selectividad del filtro es extrema (menor al 1%), el optimizador de consultas de Qdrant conmuta automáticamente a un escaneo por índice invertido con bitmaps de Roaring, asegurando una recuperación (recall) superior al 99%.
¿Qué reducción de memoria RAM ofrece la cuantización de Qdrant frente a Pinecone?
Qdrant incluye soporte nativo y configurable para Cuantización Escalar (SQ8: reducción de 4x de RAM con más del 99% de recall), Cuantización de Producto (PQ: compresión de 8x a 16x) y Cuantización Binaria (BQ: compresión de hasta 32x y aceleración de búsqueda de 10x a 40x mediante instrucciones SIMD a nivel de bits con POPCNT). Al combinar BQ o SQ con almacenamiento mmap y reevaluación (rescoring) en disco a precisión completa, una colección de 50 millones de vectores de 1536 dimensiones que exigiría ~320 GB de RAM en float32 puede operar fluidamente en solo 24 a 48 GB de RAM. Pinecone Serverless gestiona internamente sus algoritmos de compresión sin exponer controles de cuantización al desarrollador, transfiriendo la presión de memoria al almacenamiento en S3.
¿Se puede auto-hospedar Pinecone en infraestructura propia o clústeres de Kubernetes?
No. Pinecone es un servicio SaaS propietario de código cerrado disponible exclusivamente en la nube gestionada por Pinecone en regiones de AWS, GCP y Azure (accesible mediante enlaces privados como AWS PrivateLink). Por el contrario, Qdrant es de código abierto bajo licencia Apache 2.0 y puede auto-hospedarse en Kubernetes mediante charts oficiales de Helm, ejecutarse en servidores bare-metal, operar en entornos aislados sin conexión a Internet (air-gapped) para cumplimiento estricto (HIPAA, RGPD, sector bancario), o contratarse como servicio gestionado a través de Qdrant Cloud o su modelo Hybrid Cloud.
¿En qué escenarios de producción RAG resulta Qdrant más económico que Pinecone Serverless?
Pinecone Serverless es sustancialmente más económico para cargas de trabajo con tráfico intermitente, bajo o con largos periodos de inactividad, ya que solo se abona $0.33/GB-mes por almacenamiento más $8.00 por millón de Unidades de Lectura (RUs). Sin embargo, cuando la aplicación RAG atiende tráfico sostenido de producción con volúmenes superiores a 150-300 QPS (más de 350 millones de consultas al mes) o almacena colecciones superiores a 50M-100M vectores, los costes por consumo de RU en Pinecone escalan de forma lineal y pronunciada. En tales casos, los costes de recursos fijos de Qdrant Cloud o Qdrant auto-hospedado en AWS EKS con cuantización resultan entre un 40% y un 75% más económicos en el TCO mensual.