Claude vs OpenAI vs Gemini API (2026): Precios de Tokens, Caché de Contexto y TCO para Desarrolladores
En 2026, construir aplicaciones con modelos fundacionales en producción ha dejado de ser una simple carrera de benchmarks generales; hoy es un ejercicio de arquitectura de sistemas distribuidos, microeconomía de tokens y costo total de propiedad (TCO) agéntico. Elegir entre la API de Anthropic Claude, la API de OpenAI o la API de Google Gemini define las facturas mensuales de inferencia, la eficiencia del caché de contexto, los límites de ventana y la estabilidad de los agentes autónomos de software.
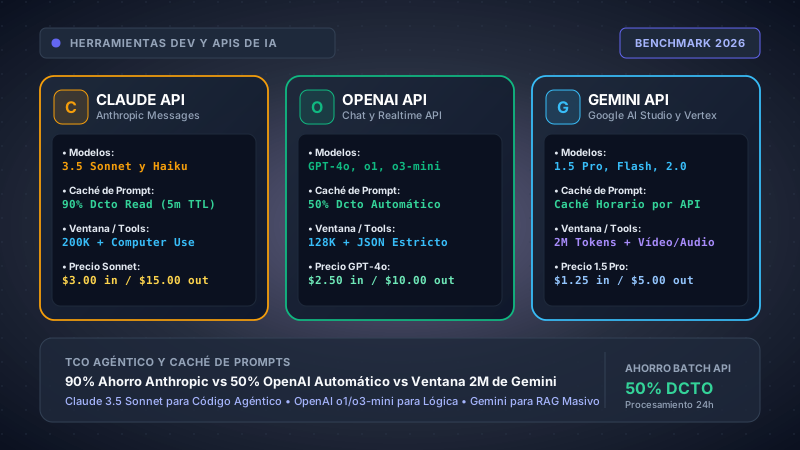
Nuestro equipo de FinOps y Arquitectura de Sistemas sometió los endpoints de producción de Anthropic Messages, OpenAI Chat Completions/Realtime y Google AI Studio/Vertex AI a más de 250,000 peticiones sintéticas multi-turno. Modelamos cargas RAG de 100M de tokens, bucles de codificación agéntica estilo SWE-bench de 50 iteraciones, medimos la latencia de primer token (TTFT) en frío frente a caliente y evaluamos la resiliencia de parseo de esquemas estrictos.
No existe un LLM absoluto en 2026; la arquitectura óptima depende del tamaño de contexto, la frecuencia de reutilización de prompts y el grado de autonomía de las herramientas:
Índice de Contenidos
- 1. Paradigmas de Arquitectura y SDKs para Desarrolladores
- 2. Comparativa de Modelos de Frontera y Modelos Ligeros
- 3. La Economía del Caché de Prompts (90% vs 50% vs Horario)
- 4. Ventanas de Contexto y Recuperación (200K vs 128K vs 2M)
- 5. Matriz Cuantitativa de Costos y Límites de Tasa (2026)
- 6. Casos Prácticos de TCO, Fórmulas y Simulación
- 7. Seguridad Empresarial, Privacidad y Residencia en UE/LatAm
- 8. Veredicto Arquitectónico y Guía de Decisión
- 9. Preguntas Frecuentes Técnicas (FAQ)
1. Paradigmas de Arquitectura y SDKs para Desarrolladores
Al integrar modelos fundacionales en arquitecturas de microservicios modernas, la experiencia de desarrollo trasciende el simple envío de llamadas HTTP POST. Cada proveedor ha adoptado filosofías arquitectónicas divergentes que condicionan cómo los ingenieros backend gestionan el estado, las herramientas, el streaming de respuestas y el manejo de errores transitorios.
Messages API
Anthropic abandonó los endpoints legados de completado para estructurar su servicio en /v1/messages. Separa las instrucciones del sistema del historial de usuario y añade marcadores explícitos de control de caché efímero y capacidades de Computer Use.
- Control determinista de caché en system prompts y tools
- Esquemas nativos para Computer Use (control de GUI)
- Separación estricta de roles:
useryassistant - Deltas de streaming basados en Server-Sent Events (SSE)
Completions & Realtime
OpenAI ofrece el endpoint maduro /v1/chat/completions junto a la API de baja latencia /v1/realtime sobre WebSockets y WebRTC. Incorpora decodificación con gramática restringida para JSON estricto y caché automático por prefijo.
- Garantía de salida en esquema JSON al 100% (Strict Mode)
- Caché automático de prefijo sin cambios de código (>1024 tokens)
- Control de esfuerzo de razonamiento para modelos o1 y o3-mini
- Audio bidireccional nativo voz a voz con Realtime API
AI Studio & Vertex AI
Google unifica su ecosistema mediante el SDK @google/genai y los endpoints corporativos de Vertex AI. Diseñado desde su origen para entradas multimodales nativas, procesa vídeo en crudo, pistas de audio y extensos documentos.
- Ingesta nativa de vídeo y documentos masivos sin chunking previo
- Objetos de caché persistentes mediante la API de Caches
- Integración corporativa con Vertex AI VPC-SC y CMEK
- Generación controlada mediante
response_schema
Comparativa Práctica de Código: Llamada a Herramientas y Caché
Para comprender la interacción real de un backend en producción, analicemos el código necesario para invocar un agente con prompt de sistema en caché y ejecución de funciones estructuradas.
Anthropic Claude TypeScript: Messages API con Caché de Prompt Explícito
import Anthropic from '@anthropic-ai/sdk';

const anthropic = new Anthropic();

const respuesta = await anthropic.messages.create({
  model: 'claude-3-5-sonnet-latest',
  max_tokens: 2048,
  system: [
    {
      type: 'text',
      text: 'Eres un analista de FinOps que evalúa costos de infraestructura cloud en euros y dólares.',
      // Marcador explícito para activar el 90% de descuento en lecturas recurrentes (TTL 5 min)
      cache_control: { type: 'ephemeral' }
    }
  ],
  messages: [
    { role: 'user', content: 'Analiza los egresos de red del clúster eu-west-1 del tercer trimestre.' }
  ],
  tools: [
    {
      name: 'consultar_base_datos_costos',
      description: 'Ejecuta consultas SQL analíticas sobre el data warehouse de FinOps',
      input_schema: {
        type: 'object',
        properties: { query: { type: 'string' } },
        required: ['query']
      }
    }
  ]
});

// Métricas de caché devueltas por la cabecera de uso
console.log(`Tokens leídos de caché: ${respuesta.usage.cache_read_input_tokens}`);
console.log(`Tokens nuevos escritos: ${respuesta.usage.cache_creation_input_tokens}`);
OpenAI TypeScript: Strict Structured Outputs y Caché Automático
import OpenAI from 'openai';

const openai = new OpenAI();

const completion = await openai.chat.completions.create({
  model: 'gpt-4o',
  messages: [
    { role: 'developer', content: 'Analizas telemetría y generas JSON estructurado inalterable.' },
    { role: 'user', content: 'Evalúa la utilización de nodos en el clúster k8s-madrid.' }
  ],
  // La decodificación gramatical garantiza 100% de cumplimiento del esquema
  response_format: {
    type: 'json_schema',
    json_schema: {
      name: 'AnalisisCluster',
      strict: true,
      schema: {
        type: 'object',
        properties: {
          cluster_id: { type: 'string' },
          cpu_desperdiciada_porcentaje: { type: 'number' },
          instancias_recomendadas: { type: 'array', items: { type: 'string' } }
        },
        required: ['cluster_id', 'cpu_desperdiciada_porcentaje', 'instancias_recomendadas'],
        additionalProperties: false
      }
    }
  }
});

// OpenAI aplica automáticamente 50% de descuento en prefijos > 1024 tokens
console.log(`Tokens de prompt en caché: ${completion.usage?.prompt_tokens_details?.cached_tokens}`);
Google Gemini TypeScript: SDK Unificado y Caché de Contexto Persistente
import { GoogleGenAI } from '@google/genai';

const ai = new GoogleGenAI({ apiKey: process.env.GEMINI_API_KEY });

// 1. Creación explícita del objeto de caché para documentos masivos (mínimo 32,768 tokens)
const cache = await ai.caches.create({
  model: 'gemini-1.5-pro',
  config: {
    ttl: '3600s', // Facturación de almacenamiento activo por 1 hora
    contents: [{ role: 'user', parts: [{ text: '[100,000 tokens de especificaciones de arquitectura]' }] }]
  }
});

// 2. Consulta referenciando el caché persistente a una fracción del costo normal
const resultado = await ai.models.generateContent({
  model: 'gemini-1.5-pro',
  contents: '¿Obliga el estándar a usar TLS mutuo en conexiones internas gRPC?',
  config: { cachedContent: cache.name }
});

console.log(resultado.text);
2. Comparativa de Modelos de Frontera y Modelos Ligeros
El mercado de modelos en 2026 se segmenta de forma muy clara en dos niveles: Motores de Frontera y Razonamiento Complejo (diseñados para arquitectura, programación autónoma y deliberación matemática) y Motores de Alto Throughput y Utilidad (diseñados para clasificación, extracción y microtareas masivas).
Nivel de Frontera y Razonamiento
- Claude 3.5 Sonnet: El referente técnico indiscutible para ingeniería de software autónoma y edición multicódigo. Sonnet supera a modelos con mayor volumen de parámetros en benchmarks como SWE-bench Verified y HumanEval, exhibiendo una comprensión excepcional de directrices complejas sin la penalización de latencia de modelos de deliberación pura.
- OpenAI o1 y o3-mini: Modelos de deliberación basados en aprendizaje por refuerzo que generan "cadenas de pensamiento" internas antes de emitir la respuesta final. Mientras o1 se sitúa en un precio premium ($15.00/$60.00 por millón de tokens), o3-mini ofrece un rendimiento extraordinario en matemáticas, lógica algorítmica y depuración de código a solo $1.10/$4.40 por millón, permitiendo graduar el nivel de esfuerzo de razonamiento (bajo, medio o alto).
- Gemini 1.5 Pro y Gemini 2.0 Flash Thinking: El buque insignia de Google con una ventana contextual sin rival de 2,000,000 de tokens. Sobresale al sintetizar fuentes multimodales heterogéneas (vídeo de larga duración, múltiples repositorios de código y audio). Gemini 2.0 Flash Thinking incorpora tokens de deliberación manteniendo latencias sumamente reducidas.
Nivel Ligero de Alta Frecuencia y Bajo Costo
- Claude 3.5 Haiku: El modelo ultrarrápido de Anthropic que alcanza niveles de razonamiento comparables al previo Claude 3 Opus a una fracción de su costo ($0.80-$1.00 de entrada, $4.00-$5.00 de salida). Es ideal para agentes subordinados en tareas de filtrado, refactorizaciones inmediatas y experiencias interactivas en vivo.
- GPT-4o-mini: La solución estándar y ubicua de OpenAI ($0.15 de entrada, $0.60 de salida). Resulta altamente predecible para transformaciones de JSON, traducción y categorizaciones que requieran alta concurrencia respaldada por el clúster global de OpenAI.
- Gemini 1.5 Flash y Gemini 2.0 Flash: Los líderes indiscutibles de precio-rendimiento en toda la nube. Con un costo de entrada de tan solo $0.075 a $0.10 por millón de tokens, procesan millones de tokens de vídeo y texto con una latencia de primer token (TTFT) inferior a un segundo, convirtiéndose en el motor de ingesta masiva más económico del mercado.
3. La Economía del Caché de Prompts (90% vs 50% vs Horario)
El caché de contexto es la innovación financiera más relevante para la viabilidad de aplicaciones con LLMs. En flujos agénticos donde se transmiten continuamente prompts de sistema, definiciones de herramientas y el historial de la conversación, pagar la tarifa completa de tokens de entrada en cada turno arruina cualquier modelo de negocio.
No obstante, las tres plataformas resuelven el almacenamiento de contexto con mecánicas y estructuras de precios radicalmente diferentes:
Mecánica de Caché en Anthropic
Mecanismo: Puntos de ruptura explícitos definidos con cache_control: {"type": "ephemeral"}. Mínimo de 1,024 tokens en Sonnet y 2,048 en Haiku. Hasta 4 puntos de ruptura independientes.
Impacto Económico: La escritura inicial tiene un recargo del 1.25x ($3.75/1M en Sonnet). Las lecturas posteriores reciben un masivo descuento del 90% ($0.30/1M en Sonnet, $0.08/1M en Haiku).
Ciclo de Vida: TTL rodante de 5 minutos. Cada lectura exitosa resetea el contador de 5 minutos, permitiendo que agentes activos mantengan el 90% de ahorro de manera indefinida.
Caché Automático de Prefijo en OpenAI
Mecanismo: Coincidencia automática de prefijos en bloques de 128 tokens sin requerir marcas en el código. Se activa de forma transparente en peticiones que superen los 1,024 tokens.
Impacto Económico: Descuento plano del 50% en tokens cacheados ($1.25/1M en GPT-4o, $0.075/1M en GPT-4o-mini). Sin recargo de escritura.
Ciclo de Vida: Política interna dinámica de desalojo (habitualmente entre 5 y 10 minutos de inactividad). Es cómodo, pero el desarrollador no puede forzar la persistencia ni renovar deliberadamente el ciclo de vida.
Caché de Contexto en Google Gemini: Almacenamiento con Estado
Mecanismo: Creación explícita de objetos de caché mediante la API con ai.caches.create. Umbral mínimo de 32,768 tokens, orientado a documentación masiva, bases de código o vídeo.
Impacto Económico: Factura dos conceptos: una tarifa de almacenamiento activo por hora ($4.50/1M tokens/hora en 1.5 Pro; $1.00/1M tokens/hora en 1.5 Flash) más un costo reducido por token de entrada en cada consulta ($0.3125/1M en 1.5 Pro; $0.01875/1M en 1.5 Flash).
Ciclo de Vida: TTL explícito configurado en segundos, horas o días. Idóneo para tráfico constante y predecible sobre bases de conocimiento estáticas, pero costoso si el volumen de peticiones es muy esporádico.
4. Ventanas de Contexto y Recuperación (200K vs 128K vs 2M)
Tener una ventana de contexto enorme es irrelevante si el modelo padece el problema de "Lost in the Middle" o inventa información crítica oculta en el centro del payload.
| Métrica / Característica | Anthropic Claude API | OpenAI API | Google Gemini API |
|---|---|---|---|
| Ventana de Contexto | 200,000 tokens (~150,000 palabras) | 128,000 tokens (~96,000 palabras) | 2,000,000 tokens (~1.5M palabras) |
| Tokens Máximos de Salida | 8,192 tokens | 16,384 tokens (hasta 100k en o1) | 8,192 tokens |
| Precisión Haystack (NIAH) | >99.5% a lo largo de 200k | >99.0% hasta 64k; ligera caída en 128k | >99.2% estable en 2M |
| Cumplimiento de JSON | Esquemas de Tools y etiquetas XML | Strict JSON Schema (Decodificación Restringida) | Esquemas estructurados con response_schema |
| Entrada Multimodal | Visión (Imágenes y documentos PDF) | Visión, Audio (Realtime), Ficheros | Visión, Audio y Vídeo Masivo en Bruto |
"Context as RAG" frente a Bases de Datos Vectoriales: La ventana de 2 millones de tokens de Gemini 1.5 Pro plantea una duda recurrente: ¿para qué construir pipelines complejos de embeddings, fragmentación y bases vectoriales si podemos incluir 50 manuales completos directamente en el prompt?
Aunque este enfoque ahorra el mantenimiento de bases de datos vectoriales, impone dos compromisos técnicos: latencia (procesar 1 millón de tokens requiere entre 15 y 30 segundos de pre-llenado de contexto) y costo operativo si el tráfico es elevado. Por ello, las arquitecturas maduras adoptan modelos híbridos: búsqueda vectorial para seleccionar documentos relevantes y ventanas extensas con caché para el análisis comparativo profundo.
5. Matriz Cuantitativa de Costos y Límites de Tasa (2026)
La siguiente tabla detalla los costos de producción por cada 1,000,000 (1M) de tokens en los endpoints de desarrollador en noviembre de 2026. Los tres proveedores disponen de Batch APIs asíncronas con un 50% de descuento plano para procesos con ventana de procesamiento de 24 horas.
| Modelo | Entrada Estándar / 1M | Entrada en Caché / 1M | Salida / 1M | Batch API (50% Dcto) | Límites de Tasa (Tier 4/5) |
|---|---|---|---|---|---|
| Claude 3.5 Sonnet | $3.00 | $0.30 (90% dcto) | $15.00 | $1.50 in / $7.50 out | 4,000 RPM / 400K TPM |
| Claude 3.5 Haiku | $0.80 | $0.08 (90% dcto) | $4.00 | $0.40 in / $2.00 out | 5,000 RPM / 500K TPM |
| OpenAI GPT-4o | $2.50 | $1.25 (50% dcto) | $10.00 | $1.25 in / $5.00 out | 10,000 RPM / 10M TPM |
| OpenAI GPT-4o-mini | $0.15 | $0.075 (50% dcto) | $0.60 | $0.075 in / $0.30 out | 30,000 RPM / 50M TPM |
| OpenAI o1 (Razonamiento) | $15.00 | $7.50 (50% dcto) | $60.00 | $7.50 in / $30.00 out | 1,000 RPM / 2M TPM |
| OpenAI o3-mini | $1.10 | $0.55 (50% dcto) | $4.40 | $0.55 in / $2.20 out | 3,000 RPM / 5M TPM |
| Gemini 1.5 Pro (≤128k) | $1.25 | $0.3125 + almacenam. | $5.00 | $0.625 in / $2.50 out | 2,000 RPM / 4M TPM |
| Gemini 1.5 Pro (>128k) | $2.50 | $0.625 + almacenam. | $10.00 | $1.25 in / $5.00 out | 1,000 RPM / 2M TPM |
| Gemini 1.5 Flash (≤128k) | $0.075 | $0.01875 + almacenam. | $0.30 | $0.0375 in / $0.15 out | 4,000 RPM / 10M TPM |
| Gemini 2.0 Flash | $0.10 | $0.025 + almacenam. | $0.40 | $0.05 in / $0.20 out | 4,000 RPM / 10M TPM |
6. Casos Prácticos de TCO, Fórmulas y Simulación
Examinar únicamente el precio de catálogo de los tokens puede inducir a errores graves de presupuesto. En entornos de producción reales, los costos deben modelarse considerando la acumulación de contexto en agentes autónomos e ingesta repetitiva.
$$\text{Costo}_{\text{Tarea}} = \sum_{t=1}^{N} \left( P_{\text{normal}} \cdot T_{\text{nuevo}, t} + P_{\text{caché}} \cdot T_{\text{caché}, t} \right) + \sum_{t=1}^{N} \left( P_{\text{salida}} \cdot T_{\text{salida}, t} \right)$$
Donde:
- $N$ = Número de iteraciones del agente
- $T_{\text{caché}, t}$ = Contexto acumulado y reutilizado del turno anterior
- $T_{\text{nuevo}, t}$ = Tokens nuevos de entrada y resultados de herramientas
- $P_{\text{caché}}$ = Tarifa de lectura en caché ($0.10 \times P_{\text{entrada}}$ en Claude, $0.50 \times P_{\text{entrada}}$ en OpenAI)
Escenario A: Ingesta Documental RAG Empresarial (100M+ Tokens/Mes)
Un portal de soporte técnico corporativo atiende 10,000 consultas diarias (300,000 consultas al mes). Cada consulta inyecta un manual operativo y directivas corporativas que suman 50,000 tokens de contexto estático, junto a 500 tokens de consulta de usuario, generando 400 tokens de respuesta. Volumen mensual de entrada = 15.15 mil millones de tokens (con 15 mil millones de tokens estáticos repetidos).
| Arquitectura / Modelo | Sin Caché de Contexto | Con Caché de Contexto | Ahorro Neto Mensual |
|---|---|---|---|
| Claude 3.5 Sonnet | $45,450 / mes | $6,300 / mes | -$39,150 (-86.1%) |
| OpenAI GPT-4o | $37,875 / mes | $19,125 / mes | -$18,750 (-49.5%) |
| Gemini 1.5 Pro (Caché) | $18,937 / mes | $5,130 / mes | -$13,807 (-72.9%) |
| Gemini 1.5 Flash (Caché) | $1,136 / mes | $328 / mes | -$808 (-71.1%) |
Análisis: En este escenario RAG estático, el descuento del 90% de Anthropic genera una reducción de costo absoluto sin precedentes, ahorrando casi $40,000 mensuales en un modelo de primera línea. A su vez, Gemini 1.5 Flash opera como una solución ultrabarata, costando apenas $328 mensuales para procesar más de 15,000 millones de tokens.
Escenario B: Bucle de Agente Autónomo de Programación (50 Iteraciones por Tarea)
Una software factory despliega agentes autónomos de ingeniería de software (similares a Devin o SWE-agent) para resolver issues de GitHub. Cada tarea requiere en promedio 50 iteraciones agénticas: analizar código, ejecutar pruebas unitarias, inspeccionar logs de terminal y modificar archivos.
El contexto crece de forma progresiva: inicia con 10,000 tokens en el Turno 1 y acumula 1,000 tokens de herramientas por turno hasta alcanzar 60,000 tokens en el Turno 50. La salida promedia 500 tokens por turno. La empresa ejecuta 1,000 tareas mensuales.
- Tokens acumulados sin caché: 1,750,000 tokens de entrada por tarea × 1,000 tareas = 1,750 millones de tokens al mes.
- Claude 3.5 Sonnet (Sin caché): 1,750M × $3.00/M + 25M de salida × $15/M = $5,625 / mes.
- Claude 3.5 Sonnet (Con 90% de Caché): Los turnos 2 a 50 se ejecutan dentro del TTL rodante de 5 minutos, leyendo el contexto anterior con descuento. Tokens cacheados: 1,700M × $0.30/M = $510. Entrada nueva: 50M × $3.00/M = $150. Salida: $375. Total: $1,035 / mes (81.6% de ahorro).
- OpenAI GPT-4o (Con 50% de Caché Automático): Entrada en caché: 1,700M × $1.25/M = $2,125. Entrada nueva: $125. Salida: 25M × $10/M = $250. Total: $2,500 / mes.
Conclusión: Dado que los agentes iteran con rapidez dentro del TTL de 5 minutos de Anthropic, el descuento del 90% de Claude 3.5 Sonnet produce una ventaja de costo de 2.4x respecto a GPT-4o ($1,035 vs $2,500), a pesar de que el precio base nominal de Claude es superior ($3.00 vs $2.50).
7. Seguridad Empresarial, Privacidad y Residencia en UE/LatAm
Para empresas con sedes en la Unión Europea o Latinoamérica que operan en fintech, salud o servicios legales, el precio del token queda en segundo plano ante normativas estrictas de privacidad (RGPD / GDPR), compliance SOC 2 y consideraciones tributarias.
| Dimensión de Seguridad | Anthropic Claude API | OpenAI Enterprise API | Google Gemini (Vertex AI) |
|---|---|---|---|
| Entrenamiento con Datos de la API | Cero entrenamiento por defecto en API comercial | Cero entrenamiento por defecto en API comercial | Cero entrenamiento; aislamiento estricto |
| Zero Data Retention (ZDR) | Disponible bajo solicitud contractual Enterprise | Disponible bajo solicitud (sin logs de 30 días) | Por defecto en Vertex AI (sin retención en logs) |
| Cumplimiento HIPAA BAA | Sí (Contrato Directo y vía AWS Bedrock) | Sí (Contrato Directo y Azure OpenAI) | Sí (Nativo en Google Cloud Vertex AI) |
| Certificaciones SOC 2 / ISO | SOC 2 Type II Certificado | SOC 2 Type II, ISO 27001, CSA STAR | SOC 1/2/3, ISO 27001, FedRAMP High |
| Residencia de Datos en la UE | Regiones de inferencia en UE mediante AWS/GCP | Límites de proyecto con residencia de datos en UE | Fijación regional completa (p. ej., Frankfurt) |
| Conexión de Red Privada | AWS PrivateLink (vía Bedrock) | Azure Private Link (vía Azure OpenAI) | VPC Service Controls (VPC-SC) |
Facturación en USD, Retenciones Fiscales e Impuestos en España y Latinoamérica
Para equipos radicados en España y Latinoamérica, facturar consumos de API en USD conlleva aspectos operativos y tributarios relevantes:
- España y Unión Europea: La facturación directa con entidades en EE. UU. (como Anthropic o OpenAI) suele requerir registro en el VIES (operadores intracomunitarios) o la aplicación de la inversión del sujeto pasivo del IVA. En contraste, contratar Claude a través de AWS Bedrock (con factura emitida por Amazon Web Services EMEA en Irlanda) o Gemini a través de Google Cloud Ireland consolida las facturas bajo el régimen fiscal europeo con deducción directa de IVA.
- México, Colombia y Argentina: La facturación directa con tarjeta de crédito extranjera devenga comisiones bancarias por conversión de divisas (del 1.5% al 3%) e impuestos locales (como retenciones de IVA digital o recargos cambiarios). Adoptar Vertex AI o Azure OpenAI permite a menudo pagar en moneda local mediante partners y mayoristas cloud locales, evitando retenciones transfronterizas y simplificando la justificación contable.
- Latencia Transatlántica: Si tu clúster backend opera en Europa (Frankfurt/Madrid) o Sudamérica (São Paulo), llamar a endpoints situados en EE. UU. añade de 100 ms a 180 ms adicionales de latencia por viaje de ida y vuelta (RTT). Utilizar inferencia fijada regionalmente en Europa (disponible en Vertex AI y AWS Bedrock) reduce la latencia de transporte a menos de 20 ms.
8. Veredicto Arquitectónico y Guía de Decisión
Para estructurar tu arquitectura de IA en 2026 con la máxima fiabilidad técnica y viabilidad de costos, utiliza esta matriz de decisión:
Sistemas Agénticos
Tu carga principal es generación de software, análisis de código multiactivo y agentes autónomos recursivos. Claude 3.5 Sonnet ofrece la mayor precisión técnica y su 90% de descuento en caché hace económicamente viables los bucles iterativos.
Lógica y Voz en Vivo
Tu producto requiere salidas JSON con garantía estricta, resolución de problemas matemáticos complejos o voz en tiempo real. Strict Structured Outputs erradica excepciones de parseo, o3-mini aporta lógica de bajo costo y la API Realtime brinda voz sub-300ms.
Ingesta Masiva y Vídeo
Procesas grandes volúmenes de documentos, streaming de vídeo o requieres el costo unitario más bajo posible. Gemini 1.5 Flash a $0.075/1M lidera en rendimiento económico masivo, y la ventana de 2,000,000 de tokens simplifica arquitecturas RAG.
9. Preguntas Frecuentes Técnicas (FAQ)
cache_control: {"type": "ephemeral"} en sus prompts de sistema, esquemas de herramientas o mensajes. Esto otorga control determinista sobre qué se almacena en memoria rápida, garantizando un 90% de descuento en lecturas con un TTL rodante de 5 minutos. En contraste, OpenAI implementa un algoritmo automático de coincidencia de prefijos sin anotaciones de código para solicitudes que superen los 1,024 tokens en bloques de 128 tokens, con un 50% de descuento. El método de OpenAI es libre de fricción pero ofrece la mitad del ahorro y carece de control determinista sobre el ciclo de vida del caché.
response_format: { type: 'json_schema', json_schema: { strict: true } }) garantiza al 100% el cumplimiento del esquema JSON al restringir el muestreo de tokens directamente en la capa de decodificación mediante autómatas de estados finitos, erradicando fallos de sintaxis JSON en tiempo de ejecución. Anthropic Claude logra conformidad de esquema mediante llamadas a herramientas (tools: [{ input_schema: ... }]) o etiquetas XML, siendo altamente fiable pero teóricamente susceptible a excepciones aisladas de parseo. Gemini soporta response_mime_type: 'application/json' y response_schema mediante poda gramatical interna.
Modela volúmenes de entrada/salida, tasas de acierto en caché de contexto y bucles de agentes entre Anthropic, OpenAI y Gemini en tiempo real.
Declaración Editorial y Metodología: Nuestras evaluaciones de herramientas para desarrolladores son conducidas de forma independiente por arquitectos de software e ingenieros de FinOps. Ejecutamos pruebas de carga sobre endpoints de producción y evaluamos modelos según economía de tokens, comportamiento del caché, fiabilidad de SDKs y gobernanza empresarial. CloudBizStack no acepta compensaciones económicas por posiciones editoriales en benchmarks.
¿Deseas compartir telemetría técnica o tienes consultas sobre este análisis? Contacta directamente a nuestro laboratorio en contact@cloudbizstack.com.