
CrewAI vs AutoGen (2026): Comparativa de Frameworks Multi-Agente y Orquestación Autónoma
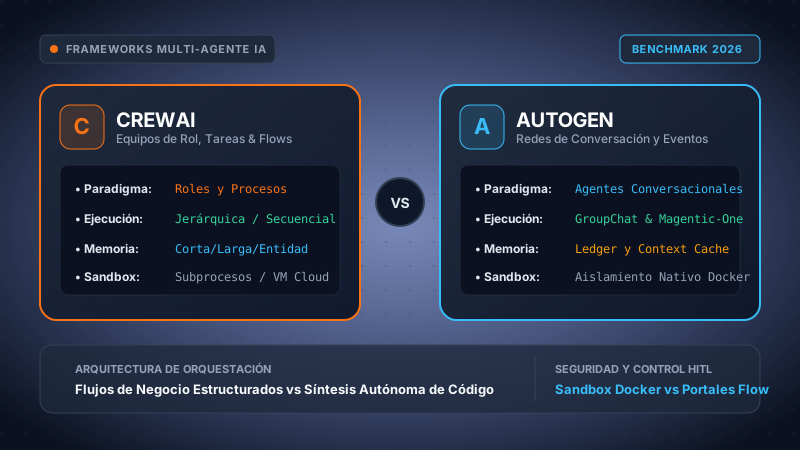
Veredicto Rápido: ¿Qué Framework Multi-Agente Desplegar en 2026?
Elige CrewAI si tu objetivo es implementar flujos de negocio corporativos deterministas y estructurados, donde agentes autónomos reproduzcan la operativa de departamentos funcionales (por ejemplo: analista financiero → investigador de datos → editor de cumplimiento). Gracias a sus abstracciones de Crews, Tareas y Flows, la validación nativa con esquemas Pydantic y su subsistema de memoria multinivel, CrewAI minimiza el tiempo de desarrollo y erradica las desviaciones conversacionales impredecibles.
Elige Microsoft AutoGen (v0.4+ / Magentic-One) si tus sistemas requieren síntesis autónoma de código, resolución algorítmica iterativa con auto-corrección o investigación experimental abierta. La arquitectura de actores asíncronos de AutoGen, su aislamiento nativo mediante DockerCommandLineCodeExecutor y su enrutamiento conversacional dinámico lo convierten en el referente técnico absoluto para ejecutar código generado por modelos de lenguaje de forma 100% aislada y segura.
Tabla de Contenidos
- 1. Paradigmas Arquitectónicos: Equipos de Rol vs Redes de Eventos Conversacionales
- 2. Orquestación y Ejecución: Delegación Jerárquica vs Mensajería GroupChat
- 3. Ejecución de Código y Aislamiento: Contenedores Docker Nativos vs Seguridad en Subprocesos
- 4. Control Humano en el Bucle (HITL), Puntos de Interrupción y Cumplimiento Normativo
- 5. Sistemas de Memoria y Compactación de Contexto: Base Vectorial Multinivel vs Libros de Tareas
- 6. Matriz Técnica Comparativa Detallada
- 7. TCO en Producción y Economía de Tokens: Fórmulas Matemáticas y Riesgo de Explosión de Facturación
- 8. Arquitectura de Código en Producción: CrewAI Flow vs AutoGen Docker GroupChat
- 9. Preguntas Frecuentes (FAQ)
1. Paradigmas Arquitectónicos: Equipos de Rol vs Redes de Eventos Conversacionales
La transición desde canalizaciones RAG tradicionales basadas en una única llamada LLM hacia enjambres autónomos multi-agente representa el salto evolutivo más relevante en la ingeniería de software con inteligencia artificial. No obstante, CrewAI y Microsoft AutoGen abordan la colaboración autónoma desde posturas técnicas diametralmente opuestas.
CrewAI: La Jerarquía Organizativa Basada en Roles
Creado por João Moura, CrewAI concibe a los enjambres de agentes bajo el modelo de un organigrama empresarial humano. Sus abstracciones nucleares reflejan los patrones de trabajo corporativos:
- Agentes (Agents): Entidades discretas dotadas de un rol funcional (
role), un objetivo explícito (goal) y un trasfondo biográfico (backstory). El trasfondo funciona como un ancla cognitiva de ingeniería de prompts, restringiendo el alcance semántico, el tono y las premisas de razonamiento del modelo subyacente. - Tareas (Tasks): Asignaciones operativas unívocas entregadas a agentes designados. Cada tarea declara sus salidas esperadas, entradas requeridas, dependencias previas y esquemas de validación estricta mediante clases de Pydantic.
- Equipos y Procesos (Crews & Processes): El entorno contenedor de ejecución. Los equipos procesan tareas mediante una secuencia estrictamente lineal (
Process.sequential) o mediante una estructura de supervisión dinámica (Process.hierarchical), donde un Agente Gerente (Manager) descompone la meta general, delega sub-tareas y consolida los resultados. - CrewAI Flows (2025–2026): Capa superior de orquestación orientada a eventos que combina código procedural determinista con enjambres agénticos. Utilizando decoradores como
@start,@listeny@router, los ingenieros pueden diseñar máquinas de estados donde la lógica tradicional de Python activa agentes autónomos únicamente cuando se requiere juicio probabilístico no determinista.
Microsoft AutoGen: Agentes Conversables y el Modelo de Actores Asíncronos
Desarrollado originalmente por Microsoft Research y reestructurado de manera integral en AutoGen v0.4, AutoGen concibe el sistema como una red distribuida de diálogo. En lugar de forzar jerarquías organizativas estáticas, AutoGen modela cada componente como un ConversableAgent que interactúa a través del intercambio asíncrono de mensajes.
- Arquitectura Basada en Actores: En AutoGen v0.4, los agentes se desacoplan como actores asíncronos ligeros que se comunican a través de un bus de eventos distribuido. Esto permite publicar, suscribirse y enrutar mensajes de forma independiente, facilitando el escalado horizontal sobre pods de Kubernetes.
- GroupChat y GroupChatManager: Hilos de conversación multiactor en los que un modelo de lenguaje gestor evalúa el historial conversacional y selecciona dinámicamente cuál debe ser el siguiente agente en intervenir, basándose en grafos de transición configurables o en el contexto del diálogo.
- Magentic-One (Patrón Orquestador): El sistema multi-agente insignia de Microsoft implementado para entornos de misión crítica. Magentic-One cuenta con un Orquestador central que mantiene un Libro de Tareas (Task Ledger) y un Libro de Progreso (Progress Ledger) externos, coordinando a agentes especializados (WebSurfer, FileSurfer, Coder y Terminal) para resolver objetivos de ingeniería complejos y no lineales.
Síntesis Comparativa de Paradigmas
CrewAI optimiza para entregables de negocio predecibles: se especifica quién ejecuta cada paso, en qué secuencia y qué formato debe cumplir el objeto final. AutoGen optimiza para iteración conversacional emergente: se provee una meta y un conjunto de herramientas de sistema (terminal, intérprete, navegador), y los agentes negocian, compilan, ejecutan pruebas, capturan trazas de error y refactorizan autónomamente hasta cumplir la condición de parada.
2. Orquestación y Ejecución: Delegación Jerárquica vs Mensajería GroupChat
El modelo mediante el cual se transmiten las instrucciones y se propagan los mensajes a lo largo del grafo agéntico define de manera directa la latencia global, el volumen de tokens consumidos y la propensión a bucles infinitos.
Mecanismos de Ejecución en CrewAI
CrewAI implementa dos modalidades fundamentales de orquestación:
-
Orquestación Secuencial: Las tareas se procesan siguiendo el orden del array de entrada. El resultado emitido por la tarea $i$ se concatena de manera automática en la ventana de contexto de la tarea $i+1$. Dado que no existe charla cruzada no planificada entre agentes, el consumo de tokens presenta un crecimiento lineal predecible:
Tokens_{secuencial} = \sum_{i=1}^{T} \left( Prompt_i + Contexto(Salida_{i-1}) + Salida_i \right) - Orquestación Jerárquica: Un Agente Gerente (respaldado por un modelo de razonamiento superior como Claude 3.5 Sonnet o GPT-4o) analiza el objetivo general, formula subtareas, las delega a los agentes operativos correspondientes, revisa la calidad técnica de las entregas y solicita correcciones si los criterios no se satisfacen. Los agentes ejecutores nunca conversan entre sí; el flujo de contexto converge en el nodo gestor.
Mecánica de GroupChat en AutoGen y la Explosión Cuadrática de Tokens
En la sala de chat grupal clásica de AutoGen (GroupChat), los agentes comparten un hilo unificado. Cuando el Agente $A$ emite una respuesta, dicho contenido se replica a todos los participantes y se almacena en el historial común. Si bien este enfoque posibilita debates técnicos exhaustivos y revisiones cruzadas de código, acarrea una grave penalización de ingeniería: el inflado cuadrático del contexto.
En una sala de GroupChat no compactada con $N$ agentes a lo largo de $K$ rondas conversacionales, la suma acumulada de tokens de entrada transmitidos a la API escala según la siguiente relación:
Donde $\bar{L}_M$ representa la longitud promedio en tokens de cada mensaje. Si cuatro o cinco agentes intercambian fragmentos extensos de código durante 25 rondas, la ventana de contexto puede rebasar con facilidad los 400.000 tokens por corrida, generando costos desmedidos si no se implementan directivas de podado (TransformChat) o los libros de tareas de Magentic-One.
3. Ejecución de Código y Aislamiento: Contenedores Docker Nativos vs Seguridad en Subprocesos
Al operar enjambres autónomos en entornos empresariales, permitir que los modelos de lenguaje escriban y ejecuten scripts es fundamental para el procesamiento analítico, pero constituye un vector crítico de ciberseguridad. Una inyección de prompt inadvertida o un comando mal formulado podría comprometer variables de entorno, destruir volúmenes persistentes o provocar una ejecución remota de código (RCE) en el host.
AutoGen: Aislamiento Nativo en Contenedores Docker
Microsoft AutoGen fue concebido desde sus cimientos para mitigar los peligros del código no confiable. Integra de forma nativa la clase DockerCommandLineCodeExecutor.
- Aislamiento en Contenedor: Al inicializarse el ejecutor, AutoGen levanta un contenedor Docker securizado (ej.
python:3.11-slim). Los scripts generados por los agentes se transfieren al interior del contenedor, se ejecutan en un espacio de usuario sin privilegios y se capturan las salidas destdoutystderrvía Docker SDK. - Políticas de Seguridad Estrictas: Los administradores de sistemas pueden parametrizar límites estrictos de CPU (
nano_cpus), topes de memoria RAM (mem_limit="1g"), sistemas de archivos de solo lectura y deshabilitar por completo el tráfico de red del contenedor (network_disabled=True), neutralizando fugas de datos hacia el exterior. - Montaje Efímero de Directorios: Los archivos generados durante el ciclo de vida residen en un volumen temporal montado en el host, garantizando una limpieza automatizada al finalizar la sesión.
CrewAI: Modelo de Subprocesos y Sandboxes Externos en la Nube
CrewAI articula la ejecución de herramientas mediante funciones de Python marcadas con el decorador @tool o integradas a través de la librería oficial crewai-tools.
- Riesgo en el Espacio del Host: De manera predeterminada, las herramientas personalizadas y los intérpretes de código en configuraciones estándar de CrewAI se ejecutan dentro del mismo proceso del host o runner de Python. Sin medidas adicionales, un script tiene los mismos privilegios de lectura, escritura y red que la aplicación madre.
- Hardening Corporativo con E2B o Modal: Para obtener aislamiento de grado bancario en CrewAI, los equipos de arquitectura deben integrar micro-máquinas virtuales externas basadas en Firecracker como E2B Sandboxes o workers contenerizados en Celery. Aunque esta solución es altamente efectiva, demanda un esfuerzo adicional de diseño de infraestructura en comparación con el soporte nativo de Docker en AutoGen.
4. Control Humano en el Bucle (HITL), Puntos de Interrupción y Cumplimiento Normativo
Los enjambres autónomos que operan sin supervisión pueden provocar incidentes operacionales severos, desde el despacho de comunicaciones erróneas a clientes hasta migraciones destructivas de bases de datos. Los entornos productivos exigen compuertas deterministas de revisión humana.
Gobernanza HITL en CrewAI
CrewAI incorpora la supervisión humana directamente en la especificación de cada Task mediante la propiedad human_input=True.
- Compuertas de Validación: Al culminar una tarea asignada, el agente detiene su flujo y expone el borrador obtenido en la terminal o mediante webhooks hacia una aplicación web.
- Retroalimentación Iterativa: El operador humano puede dar el visto bueno o ingresar instrucciones en lenguaje natural, obligando al agente a re-ejecutar el trabajo con nuevos parámetros.
- Plataforma CrewAI Enterprise: Las ediciones empresariales ofrecen un portal visual donde los auditores revisan y aprueban acciones críticas antes de que impacten los sistemas de producción.
Control Conversacional en AutoGen
AutoGen modela la supervisión humana a través de la directiva human_input_mode en los agentes UserProxyAgent.
- Tres Modos Operativos:
"ALWAYS"(solicita entrada tras cada turno),"NEVER"(autonomía absoluta) o"TERMINATE"(interviene solo cuando se detecta un error crítico o la señal de finalización). - Intervención Conversacional: El operador humano se sienta en la mesa de debate como un agente conversacional con capacidad de orientar el razonamiento en caliente.
- WebSockets en AutoGen Studio: Soporta flujos asíncronos de pausa y reanudación, permitiendo que un servicio backend suspenda la ejecución a la espera de un callback de aprobación externa.
5. Sistemas de Memoria y Compactación de Contexto: Base Vectorial Multinivel vs Libros de Tareas
El razonamiento agéntico se deteriora con rapidez cuando las ventanas de contexto se saturan de logs extensos, salidas redundantes de terminal y cortesías conversacionales. El manejo estructurado de la memoria es imperativo para la estabilidad en producción.
El Motor de Memoria Tripartito de CrewAI
CrewAI incorpora de forma nativa un subsistema de memoria multinivel respaldado por ChromaDB, SQLite y modelos de incrustación (embeddings):
- Memoria a Corto Plazo (Short-Term Memory): Conserva el contexto dinámico durante la ejecución activa del equipo. Cuando un agente consulta información pasada, una búsqueda semántica recupera los fragmentos pertinentes generados en tareas previas de la misma sesión.
- Memoria a Largo Plazo (Long-Term Memory): Almacena el historial y los aprendizajes de ejecuciones anteriores en bases de datos SQLite o PostgreSQL. Si un agente resolvió una consulta de análisis hace dos semanas, consulta esa experiencia previa para evitar caminos fallidos.
- Memoria de Entidades (Entity Memory): Extrae y clasifica automáticamente conceptos clave del dominio (organizaciones, personas, directivas de cumplimiento, cifras) construyendo un grafo semántico dinámico del negocio.
Libros de Tareas y Podado de Contexto en AutoGen
AutoGen gestiona el volumen del contexto mediante filtros de transformación y libros mayores de estado:
- Filtros de Contexto (TransformChat): AutoGen ofrece capas intermedias como
MessageHistoryLimiter(retención mediante ventana deslizante) yMessageTokenLimiter(truncamiento de mensajes intermedios preservando las instrucciones del sistema). - Libros de Tareas y Progreso en Magentic-One: En lugar de sobrecargar a los agentes con cientos de líneas de conversación desestructurada, el Orquestador de Magentic-One mantiene dos registros estructurados en Markdown:
- Task Ledger: Define el objetivo global, subtareas pendientes, hechos confirmados e hipótesis bajo análisis.
- Progress Ledger: Registra los pasos culminados con éxito, los bloqueos activos y el siguiente comando operacional.
6. Matriz Técnica Comparativa Detallada
La siguiente tabla sintetiza la comparativa técnica entre CrewAI y Microsoft AutoGen bajo parámetros de ingeniería de 2026:
| Dimensión de Evaluación | CrewAI (v0.80+) | Microsoft AutoGen (v0.4+ / Magentic-One) | Impacto en Arquitectura |
|---|---|---|---|
| Paradigma Arquitectónico | Equipos estructurados basados en roles; Tareas, Crews y Flows orientados a eventos. | Redes conversacionales multiactor; modelo de actores asíncronos y libros mayores. | CrewAI modela organigramas de negocio; AutoGen fomenta debate iterativo. |
| Motor Principal de Orquestación | Procesos Secuenciales o Delegación Jerárquica supervisada por un Agente Gerente. | GroupChatManager, grafos de transición o el Orquestador central de Magentic-One. | CrewAI previene dispersión temática; AutoGen domina la resolución de problemas no lineales. |
| Ejecución Segura de Código (Sandbox) | Subproceso de Python en el host (defecto); requiere micro-VMs cloud (E2B/Modal). | Aislamiento nativo de fábrica en Docker (DockerCommandLineCodeExecutor). |
AutoGen brinda protección Zero-Trust inmediata frente a scripts no confiables. |
| Eficiencia en Consumo de Tokens | Alta ($O(T)$ contexto lineal acotado en ejecución secuencial y Flows). | Variable ($O(K^2)$ riesgo de inflación cuadrática en GroupChats abiertos). | CrewAI ofrece costos sustancialmente más predecibles en canalizaciones SaaS. |
| Validación Estructurada de Datos | Esquemas Pydantic nativos aplicados directamente a las salidas de cada tarea. | Llamadas a funciones estructuradas (Function Calling) o integración con Instructor. | CrewAI garantiza objetos tipados listos para su consumo en bases de datos relacionales. |
| Arquitectura de Memoria | Tripartita lista para usar (Corto plazo, Largo plazo SQLite y Entidades RAG). | Filtros de transformación de contexto, caché en disco y libros estructurados. | CrewAI no requiere configuración manual para persistir conocimiento entre sesiones. |
| Supervisión Humana (HITL) | Puntos de revisión por tarea (human_input=True) y portal CrewAI Enterprise. |
Intervención como agente proxy (ALWAYS, TERMINATE) y WebSockets en Studio. |
CrewAI facilita compuertas de firma; AutoGen permite co-programación interactiva. |
| Ergonomía de Desarrollo | Excepcional: sintaxis declarativa limpia en Python, mínima fricción y CLI moderna. | Pronunciada: conceptos avanzados de actores asíncronos y eventos distribuidos en v0.4. | Equipos junior/mid despliegan CrewAI en 24h; AutoGen exige diseñadores de sistemas sénior. |
| Observabilidad y Trazabilidad | Soporte nativo de OpenTelemetry, Langfuse y CrewAI Enterprise AMP. | OpenTelemetry, trazas en AutoGen Studio y conectores de Azure AI Studio. | Ambos proporcionan métricas precisas de costo por llamada, latencia y bifurcaciones. |
7. TCO en Producción y Economía de Tokens: Fórmulas Matemáticas y Riesgo de Explosión de Facturación
El riesgo financiero más crítico al operar enjambres multi-agente en producción es la denominada Explosión de Facturación Agéntica. En arquitecturas RAG convencionales de llamada única, los costos son altamente deterministas. En enjambres autónomos, el gasto se multiplica por la cantidad de turnos iterativos, llamadas a herramientas, bucles conversacionales y rondas de supervisión.
La Ecuación de Costo de Enjambres en Producción
El costo total operativo $C_{\text{enjambre}}$ de procesar una solicitud mediante un sistema multi-agente se formaliza como:
Donde:
- $T$: Número total de rondas o pasos de ejecución hasta alcanzar el objetivo o la parada.
- $N_a$: Cantidad de agentes activados en el paso temporal $t$.
- $I_{a,t}, O_{a,t}$: Tokens de entrada (prompt) y salida (completion) consumidos por el agente $a$ en el turno $t$.
- $P_{\text{in}}, P_{\text{out}}$: Tarifa por token del modelo de lenguaje empleado (ejemplo: GPT-4o a $2,50/$10,00 USD por millón, Claude 3.5 Sonnet a $3,00/$15,00 USD por millón).
- $C_{\text{sandbox}}$: Costo de cómputo derivado del ciclo de vida de los contenedores Docker o micro-máquinas virtuales.
Estudio de Caso Real: 10.000 Auditorías Mensuales de Cumplimiento Normativo
Imaginemos un proceso automatizado que analiza cuestionarios de seguridad de proveedores de 50 páginas frente a normativas SOC 2 y RGPD, audita repositorios de código en busca de patrones vulnerables y emite un dictamen firmado de remediación. Evaluamos los costos para 10.000 ejecuciones mensuales:
| Estrategia y Arquitectura | Tokens Medios / Corrida | Costo LLM / Corrida | Cómputo Sandbox / Corrida | Costo Mensual Total (10k Corridas) |
|---|---|---|---|---|
| CrewAI Flow (Modelos Escalonados: Sonnet Gerente + Haiku Operativos) | 42.000 tokens | $0,142 USD | $0,015 USD (Subproceso en contenedor) | $1.570 USD / mes |
| CrewAI Jerárquico (Modelo Uniforme de Frontera: GPT-4o) | 78.000 tokens | $0,395 USD | $0,015 USD | $4.100 USD / mes |
| AutoGen Magentic-One (Libros de Estado + Docker Sandbox) | 65.000 tokens | $0,312 USD | $0,045 USD (Instancias Docker efímeras) | $3.570 USD / mes |
| AutoGen GroupChat Abierto (Enjambre ingenuo sin podado GPT-4o) | 280.000 tokens | $1,480 USD | $0,045 USD | $15.250 USD / mes |
Alerta Crítica de FinOps
Un GroupChat de AutoGen configurado sin límites de rondas (max_round) ni compactación de contexto cuesta 9,7 veces más que un Flow de CrewAI con modelos escalonados realizando la misma tarea. En entornos de producción, fije siempre topes de rondas estrictos, aproveche el almacenamiento en caché de prompts (prompt caching) y delegue tareas operativas a modelos económicos de baja latencia como Claude 3.5 Haiku o GPT-4o-mini.
8. Arquitectura de Código en Producción: CrewAI Flow vs AutoGen Docker GroupChat
Para comprender las diferencias operativas y la ergonomía de desarrollo en la práctica, examinemos las implementaciones recomendadas para 2026 en ambos entornos.
Implementación en CrewAI (Flow + Crew Jerárquico + Esquema Pydantic)
El siguiente fragmento ilustra cómo implementar un Flow en CrewAI que orquesta un enjambre de análisis de seguridad con salidas estrictamente tipadas:
from pydantic import BaseModel, Field
from typing import List
from crewai import Agent, Crew, Process, Task, LLM
from crewai.flow.flow import Flow, listen, start

# 1. Definición de Esquemas Estructurados mediante Pydantic
class HallazgoVulnerabilidad(BaseModel):
    cve_id: str = Field(description="Identificador CVE o categoría CWE detectada")
    severidad: str = Field(description="CRITICA, ALTA, MEDIA o BAJA")
    comando_remediacion: str = Field(description="Comando Shell exacto para mitigar el riesgo")

class InformeAuditoriaSeguridad(BaseModel):
    nombre_repo: str
    puntuacion_riesgo: float = Field(ge=0.0, le=10.0)
    hallazgos: List[HallazgoVulnerabilidad]
    resumen_ejecutivo: str

# 2. Máquina de Estados Basada en Eventos con CrewAI Flow
class FlujoAuditoriaSeguridad(Flow):
    @start()
    def inicializar_auditoria(self):
        print("[FLOW] Inicializando contexto de seguridad corporativa...")
        return {"repo": "empresa/pasarela-pagos", "branch": "main"}

    @listen(inicializar_auditoria)
    def ejecutar_enjambre_agentes(self, contexto):
        llm_frontera = LLM(model="anthropic/claude-3-5-sonnet-20241022", temperature=0.1)
        llm_rapido = LLM(model="anthropic/claude-3-5-haiku-20241022", temperature=0.2)

        # Agente Operativo (Económico, especializado en escaneo)
        auditor_codigo = Agent(
            role="Auditor de Análisis Estático de Código",
            goal="Identificar regresiones de seguridad y CVEs en dependencias del repositorio",
            backstory="Especialista en AppSec centrado en detectar inyecciones y deserializaciones inseguras.",
            llm=llm_rapido,
            verbose=True
        )

        # Agente Gerente (Razonamiento de frontera y gobernanza)
        director_seguridad = Agent(
            role="Líder AppSec & Director de Cumplimiento",
            goal="Consolidar hallazgos y emitir el dictamen formal de certificación SOC 2",
            backstory="CISO sénior responsable de la certificación y eliminación de falsos positivos.",
            llm=llm_frontera,
            verbose=True
        )

        tarea_escaneo = Task(
            description="Inspeccionar manifiestos y controladores de rutas en {repo}.",
            expected_output="Lista sin procesar de CVEs detectados y fragmentos de código afectados.",
            agent=auditor_codigo
        )

        tarea_auditoria = Task(
            description="Evaluar hallazgos, calcular riesgo global y generar el plan de remediación.",
            expected_output="Esquema Pydantic certificado InformeAuditoriaSeguridad.",
            output_pydantic=InformeAuditoriaSeguridad,
            agent=director_seguridad
        )

        equipo = Crew(
            agents=[auditor_codigo, director_seguridad],
            tasks=[tarea_escaneo, tarea_auditoria],
            process=Process.hierarchical,
            manager_llm=llm_frontera,
            memory=True, # Memoria persistente SQLite + ChromaDB
            verbose=True
        )

        resultado = equipo.kickoff(inputs={"repo": contexto["repo"]})
        return resultado.pydantic

# Ejecución del flujo
# flujo = FlujoAuditoriaSeguridad()
# reporte_final = flujo.kickoff()
Implementación en AutoGen (GroupChat Aislado en Docker con Turnos Regulados)
El siguiente ejemplo demuestra cómo estructurar un enjambre de depuración de software en AutoGen v0.4 protegido por un contenedor Docker efímero:
import os
from pathlib import Path
from autogen import ConversableAgent, GroupChat, GroupChatManager, UserProxyAgent
from autogen.coding.docker_commandline_code_executor import DockerCommandLineCodeExecutor

# 1. Creación del Entorno Aislado Efímero en Docker
directorio_trabajo = Path("/tmp/autogen_sandbox")
directorio_trabajo.mkdir(parents=True, exist_ok=True)

ejecutor_docker = DockerCommandLineCodeExecutor(
    image="python:3.11-slim",
    timeout=60, # Límite estricto de ejecución de 60 segundos
    work_dir=directorio_trabajo,
    stop_container=True # Apagar y destruir el contenedor al concluir la sesión
)

config_llm = {
    "config_list": [{"model": "gpt-4o", "api_key": os.environ["OPENAI_API_KEY"]}],
    "temperature": 0.0,
    "cache_seed": 42 # Cachear prompts para evitar sobrecostes en re-ejecuciones
}

# 2. Agente Desarrollador Autónomo
ingeniero_software = ConversableAgent(
    name="Ingeniero_Software_Senior",
    system_message="Escribes código Python idiomático, eficiente y libre de fallos. "
                   "Envuelve siempre el código en bloques ```python ... ```. "
                   "Emite 'TERMINATE' únicamente cuando el script pase todas las pruebas sin errores.",
    llm_config=config_llm
)

# 3. Proxy de Ejecución en Sandbox Docker
ejecutor_seguro = UserProxyAgent(
    name="Ejecutor_Docker_Seguro",
    system_message="Ejecuta código Python y scripts Shell dentro del sandbox aislado en Docker.",
    code_execution_config={"executor": ejecutor_docker},
    human_input_mode="NEVER" # Bucle de ejecución completamente automatizado
)

# 4. Sala GroupChat con Disyuntor de Rondas
chat_grupal = GroupChat(
    agents=[ingeniero_software, ejecutor_seguro],
    messages=[],
    max_round=10, # Disyuntor estricto para evitar ciclos de iteración infinitos
    speaker_selection_method="auto"
)

gestor_chat = GroupChatManager(
    groupchat=chat_grupal,
    llm_config=config_llm
)

# 5. Inicio de la Tarea Autónoma
# ejecutor_seguro.initiate_chat(
#     gestor_chat,
#     message="Consulta la API del BCE, calcula la volatilidad EUR/USD de los últimos 30 días y genera un gráfico PNG."
# )
9. Preguntas Frecuentes (FAQ)
¿Cuál es la diferencia arquitectónica fundamental entre CrewAI y Microsoft AutoGen?
CrewAI está diseñado en torno a equipos estructurados que asumen roles funcionales concretos (rol, meta, trasfondo) y ejecutan especificaciones de tareas deterministas mediante procesos secuenciales o jerárquicos (y máquinas de estado denominadas Flows). Por el contrario, Microsoft AutoGen se fundamenta en redes de agentes conversacionales e impulsados por eventos (modelo de actores asíncronos en AutoGen v0.4 y Magentic-One), donde la coordinación surge de forma emergente a través de intercambios dinámicos de mensajes en salas de chat grupales (GroupChat).
¿Qué framework ofrece un entorno más seguro para la ejecución de código generado por IA?
Microsoft AutoGen proporciona un aislamiento superior de fábrica gracias a su ejecutor nativo DockerCommandLineCodeExecutor, el cual levanta contenedores Docker efímeros con límites de CPU, memoria y aislamiento de red para ejecutar código de forma segura. CrewAI ejecuta código por defecto en subprocesos locales de Python o delega el aislamiento a micro-máquinas virtuales externas (como E2B o Modal), requiriendo configuración adicional para alcanzar garantías equivalentes de seguridad corporativa.
¿Por qué las salas de chat grupales (GroupChat) en AutoGen pueden sufrir una explosión cuadrática de tokens?
En un GroupChat no podado de AutoGen, cada mensaje emitido por un agente se transmite a todos los participantes y se concatena al historial conversacional común. Al alcanzar el turno k con N agentes, la cantidad de tokens de entrada escala con complejidad O(k^2), provocando un incremento exponencial de costos en facturación de APIs a menos que se activen filtros de compactación de contexto (TransformChat) o libros mayores de tareas estructurados.
¿Cuándo conviene a una empresa elegir CrewAI sobre AutoGen en 2026?
Una empresa debe elegir CrewAI para automatizar procesos de negocio repetibles y estructurados (como informes de cumplimiento normativo, investigación financiera, flujos editoriales y soporte al cliente jerárquico), donde los roles definidos, la validación estricta de esquemas Pydantic y una curva de desarrollo veloz son prioritarios sobre la improvisación libre.
¿En qué casos de uso resulta AutoGen claramente superior a CrewAI?
AutoGen resulta superior al construir agentes de ingeniería de software autónomos, asistentes de investigación científica experimental, pipelines de depuración de código con bucles de auto-corrección o sistemas complejos de resolución de problemas donde los agentes requieren iterar dinámicamente, ejecutar código dentro de contenedores seguros y debatir en grafos de conversación no lineales.
¿Cómo gestionan CrewAI y AutoGen la validación humana en el bucle (Human-in-the-Loop)?
CrewAI implementa puertas de revisión a nivel de tarea mediante el parámetro human_input=True, pausando la ejecución para requerir la aprobación humana antes de activar tareas dependientes, con soporte en el panel de control de CrewAI Enterprise. AutoGen gestiona el control humano mediante human_input_mode (ALWAYS, TERMINATE, NEVER), integrando al operador como un agente conversacional más dentro de la sala o mediante interrupciones asíncronas vía WebSockets en AutoGen Studio.