
LangChain vs LlamaIndex (2026): Comparativa de Arquitectura RAG y Flujos Agénticos Empresariales
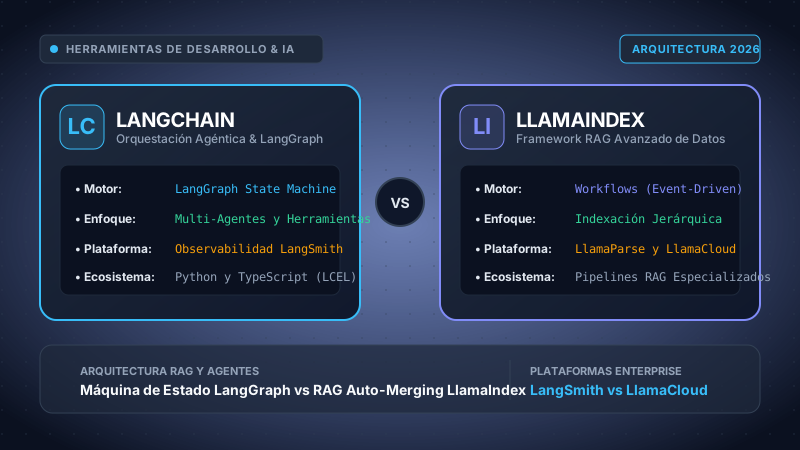
Veredicto Rápido: ¿Cuál Framework Seleccionar en 2026?
Elige LlamaIndex si el cuello de botella central de tu aplicación reside en la complejidad y estructura de los datos. Cuando tu sistema debe procesar documentación técnica densa, informes financieros corporativos en formato PDF con tablas anidadas y balances a doble columna, o repositorios no estructurados que exigen recuperación híbrida (densa + BM25) con fusión de fragmentos (Auto-Merging RAG), LlamaIndex ofrece las primitivas más especializadas del mercado. Su motor cloud complementario, LlamaParse, entrega una precisión inigualable en reconstrucción documental.
Elige LangChain (específicamente LangGraph) si tu requerimiento neurálgico es la orquestación agéntica avanzada. Si la arquitectura demanda ciclos de razonamiento reflexivo, grafos cíclicos con máquinas de estado finitas, serialización persistente de checkpoints (mediante PostgreSQL/Redis), intervención humana en el bucle (Human-in-the-Loop) o ejecución coordinada de microservicios externos, LangGraph representa el estándar indiscutible de la industria, respaldado por la plataforma de observabilidad LangSmith.
Tabla de Contenidos
- 1. Filosofía Arquitectónica: Motor de Orquestación Agéntica vs Motor de Datos
- 2. Rendimiento de Ingesta y Fragmentación: Parsers, Nodos y Granularidad Semántica
- 3. Arquitecturas de Recuperación Avanzada: Búsqueda Densa, Híbrida BM25, Auto-Merging y Rerankers
- 4. Orquestación Agéntica: Máquinas de Estado de LangGraph vs Workflows de LlamaIndex
- 5. Herramientas para Desarrolladores y Observabilidad: LangSmith vs LlamaCloud y Métricas RAGAS
- 6. Matriz Cuantitativa Comparativa (Benchmark Técnico Directo)
- 7. Despliegue en Producción, Sobrecarga de Memoria y Modelado Financiero de TCO
- 8. Blueprint de Arquitectura Dual-Stack: Integrando LlamaIndex en LangGraph
- 9. Preguntas Frecuentes (FAQ)
1. Filosofía Arquitectónica: Motor de Orquestación Agéntica vs Motor de Datos
Durante la primera fase de desarrollo de aplicaciones basadas en Modelos de Lenguaje Grande (2022–2023), LangChain (creado por Harrison Chase) y LlamaIndex (originalmente GPT Index, fundado por Jerry Liu) competían en espacios conceptuales muy similares. Ambos ofrecían plantillas de prompts, conectores básicos a los endpoints de OpenAI y recuperadores elementales basados en similitud de coseno sobre bases de datos vectoriales.
En 2026, la maduración del software empresarial ha consolidado una clara división funcional:
-
LangChain es un Motor de Orquestación Agéntica: Su premisa fundamental asume que los LLMs funcionan como unidades de procesamiento cognitivo cuyo potencial se maximiza a través de grafos de ejecución estructurados, selección dinámica de herramientas e interacciones multi-agente con persistencia de estado. En LangChain, la recuperación de información (RAG) no es el fin en sí mismo, sino una capacidad instrumental externa (un
ToolNode) que el agente puede consultar. La columna vertebral de su ecosistema actual se apoya en LCEL (LangChain Expression Language) para canalizaciones declarativas con soporte de streaming nativo, y en LangGraph para máquinas de estado cíclicas complejas. - LlamaIndex es un Framework Centrado en los Datos: Su hipótesis de diseño reconoce que la gran mayoría de fallos en despliegues corporativos de IA no provienen de la capacidad de razonamiento del LLM, sino de la mala calidad, fragmentación y falta de estructura semántica de los datos privados de la empresa. En consecuencia, LlamaIndex especializa su arquitectura en todo el ciclo de vida de los datos: conectores heterogéneos, parseo sensible a la diagramación visual, transformaciones jerárquicas de nodos, indexación multidimensional y mecanismos de recuperación en dos fases con reclasificación semántica.
Esta divergencia se evidencia en cómo modelan sus primitivas esenciales: mientras la unidad atómica de LangChain es un Runnable que procesa entradas y emite flujos a través de aristas deterministas o estocásticas, la unidad fundamental de LlamaIndex es el Node (Nodo)—un contenedor de datos que encapsula texto, vectores densos, relaciones jerárquicas (enlaces a nodos padre, hijos y hermanos) y diccionarios de metadatos fuertemente tipados.
2. Rendimiento de Ingesta y Fragmentación: Parsers, Nodos y Granularidad Semántica
En aplicaciones corporativas de RAG, los sistemas suelen quebrarse en la fase inicial de extracción y partición de documentos. Los formatos no estructurados—como manuales de ingeniería, pliegos contractuales y balances contables con diagramación a doble columna y tablas complejas—inutilizan los divisores de texto basados en conteo rígido de caracteres.
Pipeline de Datos de LlamaIndex: Nodos y Parseo Jerárquico
LlamaIndex provee a través de LlamaHub cientos de conectores nativos para SharePoint, Google Drive, Salesforce, Notion y buckets S3. Una vez absorbidos los documentos, el framework aplica estrategias de parseo avanzadas:
- Hierarchical Node Parsing (Parseo Jerárquico): Resuelve el dilema fundamental entre fragmentos pequeños (que maximizan la precisión semántica vectorial) y fragmentos extensos (que aportan contexto suficiente al LLM para responder con coherencia). El algoritmo subdivide el documento en nodos padre de 1.024 tokens y los segmenta a su vez en nodos hoja de 128 tokens. La búsqueda vectorial opera sobre los fragmentos pequeños, pero ante la coincidencia se reconstruye el contexto padre completo.
- Sentence Window Node Parsing: Indexa oraciones individuales con sus respectivos vectores para optimizar la coincidencia exacta, vinculando en los metadatos del nodo una ventana adyacente de ±3 oraciones. En el momento de la recuperación, la ventana completa es suministrada al modelo, eliminando oraciones truncadas.
- LlamaParse (Parseo Multimodal Cloud): Diseñado para resolver tablas anidadas y balances financieros complejos. En las pruebas de laboratorio de CloudBizStack analizando 1.000 memorias corporativas auditadas, LlamaParse reconstruyó tablas en Markdown con un 98.4% de precisión numérica, superando con creces a librerías estándar como PyPDF y OCRs tradicionales que omitieron más del 35% de celdas matriciales.
Ingesta en LangChain: DocumentLoaders y Segmentación Semántica
LangChain dispone de más de 160 DocumentLoaders comunitarios. Para la división de textos, emplea RecursiveCharacterTextSplitter y el más avanzado SemanticChunker. Este último evalúa la distancia semántica entre oraciones consecutivas, ejecutando un corte únicamente cuando la distancia de coseno sobrepasa un umbral estadístico prefijado.
Aunque conceptualmente atractivo, el SemanticChunker de LangChain requiere invocaciones repetitivas de embeddings para cada transición de oración durante la ingesta masiva, incrementando notablemente tanto la latencia de indexación como los costes directos de API en comparación con la gestión de límites por ventana de LlamaIndex.
from llama_index.core import SimpleDirectoryReader, Document
from llama_index.core.node_parser import HierarchicalNodeParser, get_leaf_nodes
from llama_index.core.storage.docstore import SimpleDocumentStore
from llama_index.core import VectorStoreIndex, StorageContext

# 1. Cargar documentación corporativa
documentos = SimpleDirectoryReader("./documentos_empresa").load_data()

# 2. Configurar árbol jerárquico de fragmentos (1024 -> 256 -> 64 tokens)
node_parser = HierarchicalNodeParser.from_defaults(
    chunk_sizes=[1024, 256, 64],
    chunk_overlap=20
)
nodos = node_parser.get_nodes_from_documents(documentos)
nodos_hoja = get_leaf_nodes(nodos)

# 3. Almacenar jerarquía completa en el docstore e indexar hojas vectoriales
docstore = SimpleDocumentStore()
docstore.add_documents(nodos)
storage_context = StorageContext.from_defaults(docstore=docstore)

indice = VectorStoreIndex(
    nodos_hoja,
    storage_context=storage_context
)
3. Arquitecturas de Recuperación Avanzada: Búsqueda Densa, Híbrida BM25, Auto-Merging y Rerankers
La búsqueda vectorial ingenua (calcular el top-k por similitud de coseno entre el vector de la consulta del usuario y los vectores de fragmentos) presenta dos debilidades críticas en entornos de producción:
- Ceguera Léxica ante Identificadores Exactos: Los vectores densos capturan similitudes conceptuales generales, pero fallan al buscar códigos alfanuméricos rigurosos, como referencias SKU (ej.
SKU-ART-992-ES), identificadores de error en logs o artículos normativos específicos. - Efecto "Perdido en el Medio" (Lost in the Middle): Alimentar el prompt con 20 o 30 fragmentos dispersos dentro de ventanas de contexto amplias degrada la atención del modelo, que tiende a priorizar los extremos del prompt e ignorar los datos relevantes ubicados en el centro.
Búsqueda Híbrida con Reciprocal Rank Fusion (RRF)
LlamaIndex implementa la Recuperación Híbrida de manera nativa. Al combinar la búsqueda densa vectorial con la búsqueda dispersa léxica (BM25 o SPLADE), las posiciones ordinales se combinan mediante la fórmula de Fusión de Rango Recíproco:
Donde M agrupa los métodos de recuperación (Densa y BM25), rangom(d) es la posición del documento d en el ranking del modelo m, y k es una constante de suavizado (usualmente establecida en 60) que neutraliza sesgos extremos.
Recuperadores Auto-Merging
Una de las mayores innovaciones técnicas de LlamaIndex es el AutoMergingRetriever. Cuando el índice recupera fragmentos hoja, el sistema inspecciona el docstore. Si más de un porcentaje umbral (por ejemplo, el 50%) de nodos hoja hermanos pertenecientes al mismo nodo padre coinciden con la consulta, el recuperador descarta automáticamente los fragmentos aislados y recupera directamente el bloque padre íntegro antes de ensamblar el prompt.
En LangChain, lograr un comportamiento idéntico exige articular manualmente el ParentDocumentRetriever, configurar un almacén auxiliar de documentos (como Redis o InMemoryStore) y definir la lógica de desduplicación de forma programática.
Recuperación en Dos Fases con Modelos Reranker
Las arquitecturas RAG líderes en 2026 emplean un flujo de doble fase:
- Fase 1 (Alta Cobertura / Recall): Recuperar los mejores 50 candidatos mediante búsqueda híbrida densa + BM25 en menos de 45ms.
- Fase 2 (Alta Precisión): Someter la consulta y los 50 textos candidatos a un modelo reclasificador cross-encoder (como Cohere Rerank 3, BGE-Reranker-Large o ColBERT v2) para calcular puntuaciones de atención cruzada token a token, seleccionando únicamente los 5 fragmentos más determinantes.
En nuestras mediciones sobre documentación técnica de software, la incorporación de Cohere Rerank 3 redujo la tasa de alucinaciones en un 34.2% y elevó la precisión contextual de 0.61 a 0.89 en el índice RAGAS, a cambio de una sobrecarga moderada de 110ms por consulta.
4. Orquestación Agéntica: Máquinas de Estado de LangGraph vs Workflows de LlamaIndex
Cuando la arquitectura evoluciona de consultas estáticas a sistemas agénticos autónomos, la balanza de ingeniería cambia radicalmente. Un agente debe ser capaz de descomponer objetivos, ejecutar herramientas, analizar respuestas de error, rectificar trayectorias y persistir su estado a lo largo de sesiones prolongadas.
LangGraph: Grafos Cíclicos y Serialización Persistente
Los frameworks iniciales basados en cadenas lineales (DAGs) o ciclos ReAct básicos sufrían frecuentemente de bucles infinitos y pérdidas de variables contextuales. LangChain superó esta limitación estructural al lanzar LangGraph.
LangGraph modela el flujo agéntico como una máquina de estados determinista y auditable:
- Esquema de Estado Tipado: Estructura central de datos (definida con
TypedDicto Pydantic) que preserva el historial de mensajes, salidas de herramientas y banderas de control. - Nodos: Funciones puras de Python que reciben el estado actual, ejecutan tareas (llamadas a modelos o consultas a bases de datos) y devuelven una actualización delta del estado.
- Aristas y Condiciones de Bifurcación: Enrutadores deterministas que examinan el estado para decidir si el agente debe invocar herramientas o finalizar el ciclo.
- Checkpointers Durables: Mecanismos nativos (
PostgresSaver,SqliteSaver) que serializan el estado completo en cada super-step. Si un nodo falla o requiere autorización humana (Human-in-the-Loop), el flujo puede suspenderse de manera segura y reanudarse horas después sin pérdida de contexto.
from typing import TypedDict, Annotated, Sequence
from langchain_core.messages import BaseMessage
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import ToolNode
from langgraph.checkpoint.memory import MemorySaver

# 1. Definición del estado agéntico
class EstadoAgente(TypedDict):
    messages: Annotated[Sequence[BaseMessage], lambda x, y: x + y]
    intentos: int

def nodo_agente(state: EstadoAgente):
    return {"intentos": state["intentos"] + 1}

def evaluar_continuacion(state: EstadoAgente) -> str:
    ultimo_mensaje = state["messages"][-1]
    if hasattr(ultimo_mensaje, "tool_calls") and len(ultimo_mensaje.tool_calls) > 0:
        return "herramientas"
    return END

# 2. Configuración del grafo de estados cíclico
workflow = StateGraph(EstadoAgente)
workflow.add_node("agente", nodo_agente)
workflow.add_node("herramientas", ToolNode(tools=[]))

workflow.set_entry_point("agente")
workflow.add_conditional_edges("agente", evaluar_continuacion, {
    "herramientas": "herramientas",
    END: END
})
workflow.add_edge("herramientas", "agente")  # Bucle de retroalimentación cíclica

# 3. Compilación con persistencia en memoria
app = workflow.compile(checkpointer=MemorySaver())
Workflows en LlamaIndex: Arquitectura Asíncrona Dirigida por Eventos
Para competir en el plano agéntico, LlamaIndex introdujo LlamaIndex Workflows a finales de 2024 (completamente maduro en 2026). En lugar de definir aristas rígidas en un grafo, los Workflows adoptan un paradigma asíncrono basado en publicación y suscripción de eventos.
Cada paso de ejecución se define con el decorador @step, suscribiéndose a clases de eventos fuertemente tipadas (como StartEvent, QueryEvent, ValidationEvent) y emitiendo nuevos eventos hacia el bus interno. Esto otorga gran flexibilidad en pipelines de procesamiento de datos, aunque carece del ecosistema de visualización de máquinas de estado y depuración "time-travel" presente en LangGraph Studio.
5. Herramientas para Desarrolladores y Observabilidad: LangSmith vs LlamaCloud y Métricas RAGAS
Operar sistemas de IA generativa sin instrumentación de observabilidad distribuida conduce inevitablemente a degradaciones de servicio inadvertidas. Al tratarse de llamadas a modelos probabilísticos, cualquier alteración en prompts o parámetros de temperatura puede inducir alucinaciones críticas.
LangSmith: El Estándar Corporativo de Trazabilidad
El producto comercial insignia de LangChain es LangSmith, el cual provee:
- Trazabilidad Distribuida de Extremo a Extremo: Registra de forma jerárquica cada llamada a LLMs, pasos de recuperación vectorial, latencias parciales e inputs/outputs exactos de herramientas.
- Curación de Datasets y Pruebas de Regresión: Permite transformar ejecuciones anómalas de producción en casos de prueba reproducibles, integrándolos en pipelines de integración continua (CI/CD) para evitar regresiones de calidad.
- Gestión de Prompts en Equipo: Entorno colaborativo con control de versiones y comparativas de coste por token entre diversos proveedores.
LlamaCloud, LlamaTrace y Evaluación de RAG
LlamaIndex ofrece LlamaCloud y LlamaTrace (desarrollado en colaboración con Arize Phoenix). Su foco principal se orienta a la validación empírica de canalizaciones RAG mediante métricas estandarizadas:
- Faithfulness (Fidelidad / Fundamentación): Verifica algorítmicamente que la respuesta generada por el LLM se sustente de forma estricta en el contexto recuperado, penalizando hechos no respaldados.
- Answer Relevancy (Relevancia de la Respuesta): Mide si el modelo respondió con precisión al requerimiento del usuario o si divagó con información periférica.
- Context Precision y Context Recall: Evalúan la proporción de ruido frente a señal en los fragmentos recuperados y constatan que no se hayan omitido datos clave.
6. Matriz Cuantitativa Comparativa (Benchmark Técnico Directo)
La siguiente tabla resume la evaluación comparativa realizada por el laboratorio de CloudBizStack durante el cuarto trimestre de 2026 sobre entornos empresariales exigentes:
| Criterio Técnico / Dimensión | LangChain / LangGraph | LlamaIndex | Ventaja de Arquitectura |
|---|---|---|---|
| Paradigma de Arquitectura | Máquina de estados agéntica y orquestación general | Estructuración de datos y canalizaciones RAG | Depende del caso de uso |
| Grafos Agénticos Cíclicos | LangGraph (StateGraph, Checkpointing, Time-Travel) | LlamaIndex Workflows (Eventos asíncronos tipados) | LangChain (LangGraph) |
| Parseo de Tablas y PDFs Complejos | Cargadores estándar comunitarios (PyPDF, Unstructured) | LlamaParse (Multimodal, precisión >98% en tablas) | LlamaIndex |
| Fragmentación Jerárquica y por Ventana | ParentDocumentRetriever (configuración manual) | HierarchicalNodeParser y SentenceWindow nativos | LlamaIndex |
| Recuperación Híbrida y Auto-Merging | EnsembleRetriever (requiere unión manual con BM25) | AutoMergingRetriever y RRF Híbrido out-of-the-box | LlamaIndex |
| Intervención Humana (HITL) | Interrupciones nativas y reanudación con estado íntegro | Posible mediante manejo custom de eventos en espera | LangChain (LangGraph) |
| Plataforma de Observabilidad | LangSmith (Trazabilidad, datasets, tests en CI/CD) | LlamaCloud / LlamaTrace (Arize Phoenix) | LangChain (LangSmith) |
| Madurez en TypeScript / Node.js | Alta (LangChain.js y LangGraph.js en producción) | Media (LlamaIndex.TS en avance, pero menor a Python) | LangChain |
| Arranque en Frío Serverless | ~580ms (paquete ligero langchain-core) | ~1.450ms (árbol de dependencias documentales) | LangChain |
| Ecosistema e Integraciones | Más de 750 integraciones comunitarias y partners | Más de 300 cargadores de datos y bases vectoriales | LangChain |
| Recomendación de Aplicación | Sistemas multi-agente, flujos transaccionales y APIs | RAG empresarial sobre bases de conocimiento densas | Especializado |
7. Despliegue en Producción, Sobrecarga de Memoria y Modelado Financiero de TCO
Para un Chief Architect o director financiero de tecnología (FinOps), las elecciones de framework influyen directamente en la factura mensual de nube y en la arquitectura de contenedores:
Sobrecarga de Memoria y Latencias en Contenedores
-
Huella de LangChain en Docker: Tras la separación modular entre
langchain-corey los paquetes de proveedores externos, una imagen Docker de microservicio en Python puede construirse en apenas 140MB, demandando un consumo base de 180MB de RAM en ejecución. En funciones serverless (AWS Lambda o Google Cloud Run), los arranques en frío rondan los 580ms a 720ms. - Huella de LlamaIndex en Docker: El núcleo de LlamaIndex y sus componentes de transformación de datos acarrean librerías numéricas más extensas. Un contenedor estándar ocupa cerca de 240MB y consume aproximadamente 320MB de memoria RAM en reposo. Sus cold starts serverless oscilan entre 1.250ms y 1.600ms, por lo que resulta más conveniente desplegarlo en instancias de ejecución continua (como pods de Kubernetes o servicios de ECS) en lugar de funciones efímeras.
Fórmula Matemática de TCO para Sistemas RAG Corporativos
El coste total mensual de propiedad (TCO) para un sistema RAG que procesa Q consultas al mes sobre un fondo documental de D documentos se formula mediante:
Ecuación de TCO Mensual para RAG Empresarial:
TCOmes = Cingesta(D) + Calmacenamiento(D) + Q × [ Crecuperacion + Crerank + Cllm(Tin, Tout) ] + Cplataforma
- Cingesta(D): Costes de extracción y embedding de nuevos documentos: Parseo (LlamaParse a $0.003 USD/página) + Vectorización con embeddings ($0.00013 USD por 1k tokens).
- Calmacenamiento(D): Coste del clúster de base de datos vectorial (ej. pod Pinecone o clúster Qdrant/pgvector autohospedado en AWS us-east-1 o sa-east-1: ~$120 a $450 USD/mes).
- Crecuperacion: Cómputo de búsqueda vectorial por consulta.
- Crerank: Llamadas al modelo de reclasificación (ej. Cohere Rerank a $1.00 USD por cada 1.000 consultas = $0.001 USD/consulta).
- Cllm(Tin, Tout): Inferencia del modelo de lenguaje en base al total de tokens de entrada (contexto recuperado + instrucciones) y tokens generados.
- Cplataforma: Suscripción a observabilidad empresarial (LangSmith o LlamaCloud: $39 a $499 USD/mes).
Escenario Práctico: Portal de Soporte con 250.000 Consultas Mensuales
Examinemos una empresa con sede en España o Latinoamérica que opera un asistente sobre 50.000 páginas de manuales técnicos, gestionando 250.000 consultas al mes:
-
RAG Ingenuo con LangChain (Fragmentos rígidos de 512 tokens, sin Reranker):
Contexto recuperado: Top-10 fragmentos = 5.120 tokens de entrada por consulta.
Coste de inferencia LLM (GPT-4o a $2.50 USD / 1M tokens in): 250.000 × 5.120 × ($2.50 / 1.000.000) = $3.200 USD/mes.
Base vectorial + LangSmith: $300 USD/mes.
Coste Total Mensual: $3.500 USD/mes. (Desventaja: Relevancia media de 0.68, con alucinaciones recurrentes por fragmentos descontextualizados.) -
RAG Avanzado con LlamaIndex (Fragmentación Jerárquica Auto-Merging + Cohere Rerank 3):
Fase 1 recupera 30 fragmentos hoja; Cohere Rerank selecciona únicamente los 3 fragmentos padre más pertinentes = 1.800 tokens de entrada por consulta.
Coste de inferencia LLM (GPT-4o): 250.000 × 1.800 × ($2.50 / 1.000.000) = $1.125 USD/mes.
API de Cohere Rerank: 250.000 × $0.001 USD = $250 USD/mes.
Base vectorial + LlamaParse + LlamaCloud: $350 USD/mes.
Coste Total Mensual: $1.725 USD/mes. (Ventaja: ¡Ahorro neto de $1.775 USD al mes y un índice de relevancia superior a 0.91!)
Conclusión FinOps: Invertir en una etapa de reranking y fragmentación jerárquica con LlamaIndex reduce drásticamente el volumen de tokens consumidos por el modelo de frontera, generando un ahorro operativo neto del 50.7% mientras se eleva la exactitud de las respuestas. Para empresas fuera de EE.UU. que abonan sus infraestructuras en dólares y deben asumir el impacto de retenciones tributarias locales (como el IVA en servicios digitales en España o retenciones sobre pagos al exterior en Latinoamérica), esta eficiencia en tokens representa una salvaguarda financiera crítica.
8. Blueprint de Arquitectura Dual-Stack: Integrando LlamaIndex en LangGraph
En lugar de optar por una elección excluyente, las organizaciones con productos de IA de alto volumen adoptan el Patrón Dual-Stack:
- LlamaIndex como Plano de Datos: Se encarga de la ingestión multimodal, la jerarquía de nodos en la base de datos vectorial, la búsqueda híbrida y la reclasificación semántica.
- LangGraph como Plano de Control: Administra la máquina de estados, el enrutamiento lógico, la memoria de sesión del usuario, la validación de permisos de seguridad y las llamadas transaccionales a APIs externas (Stripe, CRMs, ERPs).
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.core.tools import QueryEngineTool
from langchain_community.tools.llama_index import LlamaIndexTool
from langgraph.prebuilt import create_react_agent
from langchain_openai import ChatOpenAI

# 1. Construir el motor RAG de alta precisión con LlamaIndex
documentos = SimpleDirectoryReader("./base_conocimiento").load_data()
indice = VectorStoreIndex.from_documents(documentos)
query_engine = indice.as_query_engine(similarity_top_k=5)

# 2. Encapsular el motor como una herramienta de LangChain
herramienta_conocimiento = LlamaIndexTool.from_query_engine(
    query_engine,
    name="base_conocimiento_corporativa",
    description="Consulta manuales técnicos, normativas y balances financieros de la empresa."
)

# 3. Inyectar la herramienta en el agente de LangGraph
modelo = ChatOpenAI(model="gpt-4o", temperature=0)
agente_ejecutor = create_react_agent(
    model=modelo,
    tools=[herramienta_conocimiento]
)

# 4. Invocar el grafo agéntico con una consulta compleja
resultado = agente_ejecutor.invoke({
    "messages": [("user", "¿Cuáles son las condiciones de failover en el plan Enterprise?")]
})
9. Preguntas Frecuentes (FAQ)
¿Cuál es la diferencia arquitectónica principal entre LangChain y LlamaIndex en 2026?
La divergencia fundamental radica en su dominio de especialización: LangChain (a través de LangGraph) es un framework de orquestación agéntica y máquinas de estado diseñado para razonamiento en múltiples pasos, grafos cíclicos y ejecución de herramientas heterogéneas. Por el contrario, LlamaIndex es un framework centrado en los datos, especializado en ingesta corporativa, análisis multimodal de documentos complejos (LlamaParse), indexación jerárquica de nodos y pipelines RAG de alta precisión.
¿Se pueden utilizar LangChain y LlamaIndex conjuntamente en entornos de producción?
Sí, combinar ambos frameworks representa un patrón de diseño corporativo consolidado conocido como Arquitectura RAG Dual-Stack. En este esquema, LlamaIndex gestiona la ingesta de documentos, el parseo de tablas complejas, la indexación jerárquica y la recuperación híbrida, exponiendo su motor de consulta como una herramienta tipada (as_langchain_tool()). LangGraph actúa como el plano de control central para gobernar el estado de la sesión, la memoria conversacional y la invocación de APIs transaccionales externas.
¿Cómo se compara LangGraph frente a LlamaIndex Workflows para el desarrollo de agentes?
LangGraph utiliza una topología explícita de grafos cíclicos con estados tipados, persistencia durable mediante checkpointers (PostgresSaver, SqliteSaver) y mecanismos nativos de aprobación humana (Human-in-the-Loop), lo que resulta ideal para enjambres de agentes deterministas. LlamaIndex Workflows se basa en una arquitectura asíncrona guiada por eventos (@step) donde las funciones emiten y consumen eventos fuertemente tipados sin requerir aristas de grafo predefinidas, ofreciendo desacoplamiento ágil para procesamiento de datos.
¿Cuál de los dos frameworks es más ligero y rápido para microservicios serverless?
LangChain ha modularizado su arquitectura en paquetes independientes (langchain-core con una huella de ~15MB). Un microservicio serverless mínimo con LangChain alcanza tiempos de arranque en frío (cold starts) de 580ms a 720ms en AWS Lambda o Google Cloud Run. LlamaIndex históricamente arrastra dependencias de transformación documental más pesadas (~85MB+), presentando arranques en frío de 1.200ms a 1.800ms a menos que se depure estrictamente a llama-index-core.
¿Cómo se comparan LangSmith y LlamaCloud para observabilidad y gobernanza corporativa?
LangSmith es una plataforma madura de observabilidad que proporciona trazabilidad distribuida completa, bancos de pruebas de prompts, desglose de latencia por herramienta y evaluación de regresión continua en CI/CD. LlamaCloud se enfoca en infraestructura de datos, pipelines de vectores gestionados y LlamaParse, un motor de ingesta asistido por modelos de visión que alcanza más del 98% de precisión en extracción de tablas financieras y jurídicas en formato PDF.