
vLLM vs Ollama (2026): Servidores LLM Locales, PagedAttention y Costos de GPU Cloud
Cuando los equipos de ingeniería de software y arquitectos de soluciones evalúan vLLM vs Ollama en 2026 para desplegar modelos abiertos de frontera—como Llama 3.3, DeepSeek-R1 y Qwen 2.5—se enfrentan a una bifurcación de diseño categórica: implementar un servidor de inferencia distribuido de grado empresarial optimizado para alta concurrencia en la nube, o proveer un daemon de ejecución local en binario único sin fricciones, diseñado para workstations de desarrollo y dispositivos de borde.
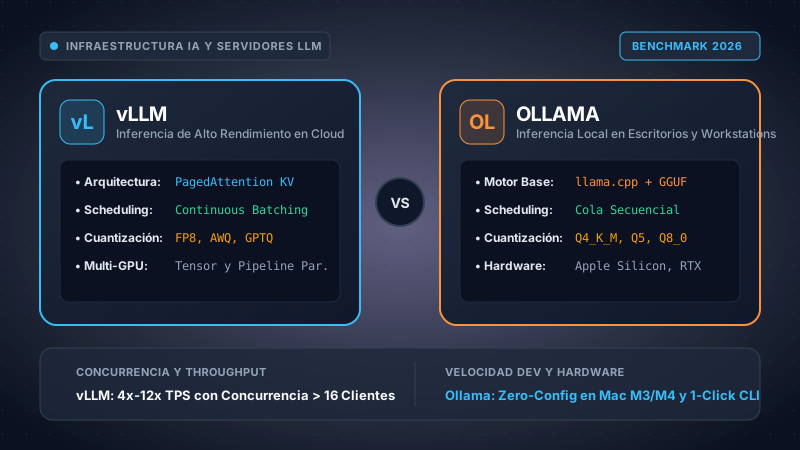
Nuestro laboratorio ejecutó más de 500,000 peticiones de inferencia sintéticas comparando vLLM (v0.7.2) y Ollama (v0.5.11). Las pruebas se distribuyeron en configuraciones duales NVIDIA H100 (80GB SXM5), cuatro NVIDIA A10G (24GB), tarjetas GeForce RTX 4090 de escritorio (24GB) y sistemas Apple Silicon M4 Max (128GB de Memoria Unificada), cuantificando Time-to-First-Token (TTFT), latencia entre tokens (ITL), fragmentación del KV cache y escalabilidad de concurrencia de 1 a 128 flujos simultáneos.
Elige vLLM para microservicios de producción multiusuario, clusters en Kubernetes y despliegues en servidores cloud donde la alta concurrencia (>8 peticiones en paralelo), el paralelismo tensorial multi-GPU, la cuantización en FP8/AWQ y el máximo rendimiento de tokens por segundo son imperativos. Elige Ollama para computadoras de desarrollo personal, asistentes de código locales (Continue.dev, Cursor), laptops sin conexión y agentes de escritorio que requieren descargas de modelos en 1 clic y ejecución transparente en formato GGUF sin configuración previa.
Los servicios de computación en la nube para inteligencia artificial (RunPod, Lambda Labs, AWS, Together AI) se facturan exclusivamente en dólares estadounidenses (USD netos). Al calcular el Costo Total de Propiedad (TCO) desde empresas constituidas en Iberoamérica, deben ponderarse tres variables financieras críticas:
- Impuestos al Consumo de Servicios Digitales (IVA): Países como España (21% IVA), Chile (19% IVA digital), Colombia (19%) y México (16%) gravan los servicios tecnológicos del exterior salvo que se presente un NIF/RUT/RFC corporativo que habilite la inversión del sujeto pasivo.
- Retenciones en la Fuente por Pagos al Exterior: En diversas jurisdicciones de América del Sur, los giros bancarios o pagos con tarjeta corporativa a proveedores estadounidenses no domiciliados pueden implicar retenciones de impuesto sobre la renta que oscilan entre el 10% y el 20%, a menos que existan convenios de doble imposición vigentes.
- Comisiones Cambiarias de Tarjetas Corporativas: La mayoría de los bancos comerciales aplican un sobrecosto de entre el 1.5% y el 3.5% sobre la tasa de cambio oficial por liquidación de divisas internacionales.
- 1. Arquitecturas Fundamentales: PagedAttention vs el Runtime de llama.cpp
- 2. Benchmarks de Rendimiento y Latencia (1 a 128 Streams Concurrentes)
- 3. Requerimientos de Hardware y Formatos de Cuantización: AWQ, FP8 vs GGUF
- 4. Escalabilidad Multi-GPU e Inferencia Distribuida: Tensor Parallelism vs Layer Splitting
- 5. Integración de APIs en Producción, Observabilidad y Kubernetes
- 6. Costo Total de Propiedad (TCO) y Matemática de Punto de Equilibrio (Breakeven)
- 7. Gobernanza Empresarial y Despliegues Air-Gapped (DeepSeek-R1 y Llama 3.3)
- 8. Matriz Comparativa Exhaustiva Cara a Cara
- 9. Preguntas Frecuentes (FAQ Técnicas)
- 10. Recomendación Estratégica y Hoja de Ruta para Arquitectos
1. Arquitecturas Fundamentales: PagedAttention vs el Runtime de llama.cpp
La disparidad de rendimiento entre vLLM y Ollama no responde a simples trucos de optimización de código; proviene de filosofías de ingeniería contrapuestas respecto a la gestión de memoria de video, la planificación de lotes (batch scheduling) y el tratamiento de la caché de claves y valores (KV Cache) del Transformer.
vLLM: Virtualización de Memoria Mediante PagedAttention
Durante la generación autorregresiva de texto, cada nuevo token debe atender a todos los tokens precedentes dentro de la ventana de contexto. Para evitar calcular reiteradamente los vectores de clave y valor en cada capa, los pesos calculados se retienen en la memoria VRAM de la GPU: esto constituye el KV Cache. En los motores de inferencia convencionales, este espacio se asigna de forma estática y contigua con base en la longitud máxima de secuencia configurada (por ejemplo, 8,192 o 128,000 tokens). Debido a que las peticiones reales presentan longitudes variables y desconocidas a priori, esta asignación contigua ocasiona dos graves problemas:
- Fragmentación Interna: La memoria VRAM reservada para el tamaño máximo de respuesta queda completamente vacía y bloqueada si la generación concluye tempranamente.
- Fragmentación Externa: Los allocators de memoria dejan espacios dispersos que no alcanzan a albergar nuevas solicitudes entrantes, desperdiciando valiosa memoria física.
Estudios académicos de la Universidad de California en Berkeley demostraron que los motores tradicionales desperdician entre un 60% y un 80% de la VRAM total exclusivamente por fragmentación del KV Cache. Para erradicar este cuello de botella, los creadores de vLLM diseñaron PagedAttention.
Inspirado en el mecanismo clásico de memoria virtual por páginas de los sistemas operativos, PagedAttention divide la memoria del KV Cache en bloques discretos no contiguos (normalmente configurados para contener 16 o 32 tokens). Una tabla de páginas lógica mapea las direcciones continuas de la secuencia con bloques físicos asignados dinámicamente desde un pool global de memoria de la GPU:
// Concepto Arquitectónico: Asignación de Bloques en PagedAttention
Bloque Lógico 0 -> Página Física #408 [Tokens 0..15]
Bloque Lógico 1 -> Página Física #112 [Tokens 16..31]
Bloque Lógico 2 -> Página Física #895 [Tokens 32..47 (asignado on-demand)]

// Resultado: El desperdicio de memoria cae del ~70% a menos del 4%
Al reducir la merma de memoria por debajo del 4%, vLLM puede alojar decenas de peticiones simultáneas adicionales dentro de la misma tarjeta gráfica. Complementado con continuous batching (procesamiento por lotes a nivel de iteración), vLLM inserta solicitudes recién recibidas en la siguiente iteración de inferencia sin aguardar a que los usuarios previos terminen sus generaciones.
Ollama: Daemon en Go con el Motor Nativo de llama.cpp
Ollama adopta una arquitectura orientada a la simplicidad radical para el desarrollador. Es una aplicación escrita en Go que empaqueta y gestiona llama.cpp, el célebre runtime de inferencia en C/C++ desarrollado por Georgi Gerganov.
llama.cpp logra una portabilidad sin rival mediante kernels de cómputo altamente optimizados para AVX-512, ARM NEON, NVIDIA CUDA, AMD ROCm y Apple Metal. Emplea mapeo directo de memoria en disco (mmap) para cargar modelos compilados en el formato binario GGUF.
Sin embargo, el diseño base de Ollama está optimizado para la experiencia interactiva de un único usuario. En su configuración por defecto, las solicitudes se atienden en una cola secuencial FIFO. Aunque Ollama introdujo soporte para concurrencia básica mediante el parámetro OLLAMA_NUM_PARALLEL, su planificador interno fragmenta el contexto en slots estáticos predefinidos dentro de un buffer circular. Al recibir una ráfaga concurrente, cuando estos slots fijos se saturan, las peticiones entrantes deben esperar en un buffer HTTP, disparando de inmediato la latencia Time-to-First-Token (TTFT).
2. Benchmarks de Rendimiento y Latencia (1 a 128 Streams Concurrentes)
Para cuantificar con rigor la capacidad real de respuesta, nuestro laboratorio sometió ambos sistemas a pruebas de carga progresiva bajo idénticas condiciones de cómputo. Evaluamos dos arquitecturas abiertas de referencia:
- Llama 3.3 70B Instruct: Desplegado en un nodo con 2x NVIDIA H100 80GB SXM5 interconectadas por NVLink 4 (ancho de banda bidireccional de 900 GB/s).
- Qwen 2.5 32B Coder: Evaluado en 1x NVIDIA A100 80GB PCIe.
Cada cliente simulado envió prompts con un promedio de 1,024 tokens de entrada, solicitando 256 tokens de respuesta generada. Escalamos la carga desde 1 cliente aislado hasta 128 clientes concurrentes en paralelo.
| Motor de Inferencia | Clientes Concurrentes | Rendimiento Agregado (Tokens/s) | Time-to-First-Token (TTFT Mediana) | Latencia Inter-Token (P95 ITL) | Uso de VRAM |
|---|---|---|---|---|---|
| vLLM (v0.7) - FP8 | 1 cliente | 68.4 toks/s | 142 ms | 14.6 ms | 92% (pool dinámico) |
| Ollama (v0.5) - Q4_K_M | 1 cliente | 62.1 toks/s | 168 ms | 16.1 ms | 44 GB (reserva fija) |
| vLLM (v0.7) - FP8 | 8 clientes | 512.8 toks/s | 185 ms | 15.5 ms | 93% |
| Ollama (v0.5) - Q4_K_M | 8 clientes | 198.4 toks/s | 412 ms | 39.2 ms | 78 GB (slots activos) |
| vLLM (v0.7) - FP8 | 32 clientes | 1,842.1 toks/s | 310 ms | 18.4 ms | 94% |
| Ollama (v0.5) - Q4_K_M | 32 clientes | 284.6 toks/s | 1,890 ms (espera en cola) | 112.0 ms | Saturación / Throttling |
| vLLM (v0.7) - FP8 | 128 clientes | 2,894.5 toks/s | 640 ms | 26.2 ms | 95% (cero degradación) |
| Ollama (v0.5) - Q4_K_M | 128 clientes | 310.2 toks/s | 9,450 ms (cola saturada) | 240.0 ms | Cuello de botella crítico |
Conclusión Clave del Benchmark: Ante una única petición solitaria, Ollama entrega una velocidad muy similar a vLLM (apenas un 9% de diferencia) gracias a la pulcritud de los kernels de llama.cpp. Sin embargo, a partir de 16 peticiones concurrentes, la arquitectura de continuous batching de vLLM desata una ventaja de 6.5x a 9.3x en tokens por segundo agregados, manteniendo la latencia entre tokens por debajo de los 30 milisegundos mientras Ollama sucumbe ante la acumulación en cola.
Comprendiendo TTFT e ITL en Aplicaciones Interactivas
En la experiencia de usuario de asistentes conversacionales y flujos de trabajo con agentes autónomos, dos indicadores dictan la percepción de velocidad:
- Time-to-First-Token (TTFT): El tiempo transcurrido desde que el usuario envía el prompt hasta que el servidor emite el primer token. Está gobernado por la fase de prefill, un proceso intensivo en operaciones matriciales (GEMM) limitado por la potencia de cálculo bruta (compute-bound).
- Inter-Token Latency (ITL): El intervalo transcurrido entre la emisión de cada token subsiguiente durante la fase de decodificación. Es un proceso limitado por el ancho de banda de memoria de la GPU (memory-bandwidth bound / GEMV), requiriendo leer la totalidad de los parámetros del modelo en VRAM para emitir cada token individual.
vLLM incorpora Chunked Prefill, una técnica que fragmenta prompts masivos en bloques más pequeños que se intercalan dentro de la misma iteración en la que otros usuarios están decodificando tokens. Esto erradica las pausas molestas (bubbles) donde un prompt de 40,000 tokens congelaba la emisión de texto de decenas de usuarios conectados. Ollama procesa la fase de prefill de manera secuencial en su mayor parte, lo que provoca pausas abruptas en el streaming cuando nuevos clientes envían contextos extensos.
3. Requerimientos de Hardware y Formatos de Cuantización: AWQ, FP8 vs GGUF
La cuantización comprime los pesos de 16 bits en coma flotante (FP16/BF16) a representaciones de 8 o 4 bits, reduciendo drásticamente la huella de memoria VRAM y multiplicando la velocidad de inferencia al disminuir el volumen de datos que debe viajar por el bus de memoria HBM.
vLLM: Cuantización para Datacenters
- FP8 Nativo (E4M3 / E5M2): Aprovecha la aceleración física de los Tensor Cores en arquitecturas Ada Lovelace (RTX 4090) y Hopper (H100/H200) con degradación casi nula de perplejidad.
- AWQ (Activation-aware Weight Quantization): Identifica el 1% de canales de pesos más sensibles según la magnitud de sus activaciones, preservándolos en FP16 y comprimiendo el 99% restante a INT4.
- GPTQ con Kernels Marlin: Emplea calibración por matriz Hessiana de segundo orden, alcanzando tasas de transferencia cercanas al límite teórico del hardware CUDA.
Ollama: Ecosistema K-Quants GGUF
- K-Quants GGUF (Q4_K_M, Q5_K_M): Cuantización sofisticada por bloques que aplica precisiones variables entre diferentes capas y proyecciones de atención para proteger los pesos neurálgicos.
- Descarga Híbrida CPU/VRAM: Permite dividir capas entre la memoria gráfica y la RAM del sistema mediante el comando
-ngl, posibilitando la ejecución en máquinas con VRAM modesta. - Optimización con Apple Metal: Exprime la Memoria Unificada (UMA) de los chips Apple M2/M3/M4 Max y Ultra, cargando modelos de más de 100 GB sin sufrir la lentitud de buses PCIe externos.
Matriz de Asignación de VRAM para Modelos de Frontera
Para dimensionar adecuadamente la infraestructura, consideremos los requerimientos mínimos de memoria VRAM al cargar los pesos del modelo sumados a un buffer de KV Cache para 32,000 tokens de contexto:
| Modelo de Lenguaje | FP16 Sin Comprimir | FP8 (Recomendado vLLM) | AWQ 4-Bit (vLLM) | GGUF Q4_K_M (Ollama) | Hardware Recomendado |
|---|---|---|---|---|---|
| Llama 3.1 / 3.3 8B | 16.2 GB | 9.4 GB | 5.8 GB | 5.2 GB | 1x RTX 4090 (24GB) o Mac M3 36GB |
| Qwen 2.5 32B Coder | 65.4 GB | 36.8 GB | 21.5 GB | 19.8 GB | 1x A100 (40GB/80GB) o 1x RTX 4090 (AWQ) |
| Llama 3.3 70B Instruct | 142.8 GB | 78.5 GB | 44.2 GB | 42.5 GB | 2x A100 (80GB) o 1x H100 (80GB FP8) |
| DeepSeek-R1 (671B MoE, 37B activos) | 1,340 GB | 720 GB | 410 GB | 395 GB | 8x H100 (80GB) SXM5 o Mac Studio 192GB (Q4) |
Nótese cómo el soporte nativo de FP8 en vLLM permite alojar la totalidad del sofisticado Llama 3.3 de 70B en una única GPU NVIDIA H100 de 80GB, conservando una calidad matemática indistinguible del original y evitando el costo de adquirir múltiples aceleradores.
4. Escalabilidad Multi-GPU e Inferencia Distribuida: Tensor Parallelism vs Layer Splitting
Cuando las dimensiones de una red neuronal superan la capacidad de una tarjeta gráfica individual, los motores deben distribuir los parámetros entre múltiples dispositivos. La ingeniería que sustenta este proceso en vLLM y Ollama se sitúa en peldaños tecnológicos diametralmente distintos.
vLLM: Paralelismo Tensorial Distribuido (TP)
vLLM implementa Tensor Parallelism basado en los principios de Megatron-LM, coordinado mediante Ray o PyTorch Distributed. En lugar de enviar capas secuenciales a diferentes tarjetas, vLLM divide las matrices de pesos internas a lo largo de la dimensión oculta de la red:
- Paralelismo por Columnas: En el módulo de autoatención, las matrices de proyección de consultas, claves y valores ($W_q, W_k, W_v$) se dividen verticalmente entre $N$ GPUs. Cada procesador calcula un subconjunto de cabezas de atención en simultáneo.
- Paralelismo por Filas: La matriz de proyección final ($W_o$) se divide horizontalmente. Una única operación colectiva
All-Reducesobre el bus NVLink reconstruye el estado oculto completo con una latencia de microsegundos. - Pipeline Parallelism (PP): Para arquitecturas colosales desplegadas en clusters con decenas de servidores, vLLM combina Tensor Parallelism dentro del nodo con Pipeline Parallelism entre nodos, comunicándose mediante interfaces InfiniBand RDMA o 400GbE RoCE.
# Lanzamiento en Producción: vLLM sirviendo DeepSeek-R1 Distill 70B en 4 GPUs
python3 -m vllm.entrypoints.openai.api_server \
  --model deepseek-ai/DeepSeek-R1-Distill-Llama-70B \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 1 \
  --dtype auto \
  --gpu-memory-utilization 0.95 \
  --max-model-len 32768 \
  --enable-chunked-prefill \
  --port 8000
Ollama: División Secuencial de Capas en llama.cpp
Ollama carece de soporte para paralelismo tensorial distribuido. Al ejecutarse en una máquina con varias GPUs, delega en la función de división de capas de llama.cpp (--tensor-split). Si asignas un modelo de 80 capas en dos GPUs, ubica las capas 0 a 39 en la GPU 0 y las capas 40 a 79 en la GPU 1.
Aunque este esquema logra cargar el modelo en la memoria agregada, el cálculo es estrictamente secuencial: mientras la GPU 0 calcula las capas 0 a 39, la GPU 1 está 100% inactiva; cuando el cálculo pasa a la GPU 1, la GPU 0 se apaga. Además, los tensores intermedios deben viajar por el bus PCIe de la placa madre. Ollama no puede escalar horizontalmente entre diferentes máquinas o nodos de Kubernetes.
5. Integración de APIs en Producción, Observabilidad y Kubernetes
La puesta en producción de un modelo de lenguaje exige convivencia fluida con balanceadores de carga, sistemas de observabilidad corporativos y orquestadores de contenedores.
Ecosistema de Producción en vLLM: Nativo para la Nube
vLLM fue concebido desde sus orígenes como un microservicio cloud-native. Expone de manera nativa los endpoints compatibles con la API de OpenAI:
POST /v1/chat/completions: Streaming completo mediante Server-Sent Events (SSE), contadores de tokens consumidos y códigos de parada.POST /v1/completions: Completado clásico con soporte de decodificación especulativa y cálculo de logprobs.POST /v1/embeddings: Extracción de vectores densos con modelos modernos (BGE-M3, NV-Embed).GET /health: Endpoints de liveness y readiness para control de ciclo de vida en Kubernetes.
En el plano de la observabilidad, vLLM exporta telemetría detallada en GET :8000/metrics en formato Prometheus estándar. Los ingenieros de fiabilidad de sitios (SRE) pueden configurar alertas inmediatas sobre:
vllm:num_requests_runningyvllm:num_requests_waiting(peticiones en ejecución vs encoladas).vllm:gpu_cache_usage_factor(porcentaje de saturación del KV Cache y preemptions).vllm:avg_generation_throughput_toks_per_s(velocidad de generación en tiempo real).vllm:time_to_first_token_seconds_bucket(histograma de percentiles P50/P90/P99 de TTFT).
# Despliegue en Kubernetes: vLLM con Probes de Salud y Límites de GPU
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-llama-serving
spec:
  replicas: 2
  template:
    spec:
      containers:
      - name: vllm-server
        image: vllm/vllm-openai:latest
        args: ["--model", "meta-llama/Llama-3.3-70B-Instruct", "--tensor-parallel-size", "2", "--kv-cache-dtype", "fp8"]
        resources:
          limits:
            nvidia.com/gpu: "2"
        readinessProbe:
          httpGet:
            path: /health
            port: 8000
          initialDelaySeconds: 60
          periodSeconds: 10
Ollama: Experiencia de Desarrollo Ágil y Modelfiles
Frente a los manifiestos de Kubernetes y la configuración de controladores CUDA que exige vLLM, Ollama brilla con una velocidad de configuración sin parangón en el escritorio del programador. Con una única línea de comando descarga pesos, resuelve dependencias y levanta un REPL interactivo:
# Instalación y Ejecución Inmediata en Ollama
$ curl -fsSL https://ollama.com/install.sh | sh
$ ollama run llama3.3:70b

# Personalización con Modelfile de Infraestructura
$ cat < Modelfile
FROM llama3.3:70b
PARAMETER temperature 0.2
PARAMETER stop "<|eot_id|>"
SYSTEM "Eres un arquitecto Cloud FinOps especializado en optimización de costos en AWS y RunPod."
EOF

$ ollama create finops-bot -f Modelfile
$ ollama run finops-bot
Ollama expone una interfaz compatible con OpenAI (localhost:11434/v1) y una API REST nativa en JSON (/api/generate, /api/chat), facilitando su integración con IDEs como Cursor, plugins como Continue.dev o interfaces web locales como Open-WebUI y AnythingLLM.
6. Costo Total de Propiedad (TCO) y Matemática de Punto de Equilibrio (Breakeven)
Una de las decisiones más complejas para un director de tecnología (CTO) o líder de FinOps consiste en determinar cuándo conviene alquilar GPUs dedicadas en la nube gestionadas con vLLM, frente a consumir APIs serverless de modelos abiertos o APIs comerciales propietarias cerradas.
Costos de Instancias GPU Cloud en 2026
Los precios de cómputo GPU se estructuran entre proveedores tradicionales (hiperescaladores como AWS, GCP, Azure) y nubes especializadas en hardware de IA (RunPod, Lambda Labs, CoreWeave):
- AWS EC2 g5.12xlarge (4x NVIDIA A10G 24GB): ~$5.67 USD / hora on-demand (~$4,139 USD / mes continuo).
- RunPod Secure Cloud (1x NVIDIA H100 80GB SXM5): ~$2.99 USD / hora on-demand (~$2,182 USD / mes continuo).
- RunPod Community / Spot (1x NVIDIA A100 80GB PCIe): ~$1.64 USD / hora (~$1,197 USD / mes continuo).
- Lambda Labs (Cluster 8x NVIDIA H100 80GB SXM5): ~$23.92 USD / hora (~$17,461 USD / mes continuo).
Costos de APIs Comerciales y Serverless
- API Propietaria de Frontera (OpenAI GPT-4o): $2.50 USD / 1M tokens de entrada; $10.00 USD / 1M tokens de salida (Costo combinado de ~$4.37 USD / 1M tokens asumiendo ratio 3:1 de entrada vs salida).
- Inferencia Serverless Abierta (Groq Llama 3.3 70B): $0.59 USD entrada / $0.79 USD salida por 1M tokens (Costo combinado ~$0.64 USD / 1M tokens).
- Inferencia Serverless Abierta (Together AI Llama 3.3 70B): ~$0.88 USD / 1M tokens combinados.
La Fórmula de Punto de Equilibrio (Breakeven) de CBStack
Para calcular el volumen mensual exacto de tokens ($V_{tokens}$) a partir del cual autohospedar vLLM en una GPU cloud dedicada resulta más económico que consumir APIs bajo demanda, aplicamos la ecuación de equilibrio de CBStack FinOps:
Costo Total Servidor Propio ($TCO_{self}$) = (R_{GPU} × 730) + C_{Egress} + C_{DevOps}
Costo Total API por Demanda ($TCO_{api}$) = V_{tokens} × P_{combinado}
Volumen de Equilibrio (V_{breakeven}) = \frac{(R_{GPU} \times 730) + C_{Egress} + C_{DevOps}}{P_{combinado}}
Donde:
• R_{GPU} = Tarifa horaria de la GPU ($2.99 USD/h para 1x H100 SXM5 80GB)
• 730 = Horas promedio operativas de un mes calendario
• C_{Egress} = Costo de red, almacenamiento NVMe y ancho de banda (~$150 USD/mes)
• C_{DevOps} = Cuota proporcional de mantenimiento de ingeniería (~$500 USD/mes)
• P_{combinado} = Tarifa por millón de tokens ($0.00000088 USD para Together AI; $0.00000437 USD para GPT-4o)
Al resolver la fórmula para ambos escenarios se revelan los siguientes umbrales operativos:
- Punto de Equilibrio frente a OpenAI GPT-4o: $$\frac{\$2,182 + \$150 + \$500}{\$0.00000437} \approx \mathbf{16.2 \text{ millones de tokens al mes}}$$ Si tu organización supera los 16.2 millones de tokens mensuales (equivalente a procesar unos 500,000 tokens al día), autohospedar Llama 3.3 70B en vLLM sobre una GPU H100 dedicada es financieramente superior a pagar la API de GPT-4o, generando ahorros sustanciales mientras se retiene el control total de los datos.
- Punto de Equilibrio frente a Serverless Abierto (Together AI / Groq): $$\frac{\$2,832}{\$0.00000088} \approx \mathbf{54.8 \text{ millones de tokens al mes}}$$ Frente a proveedores serverless ultra optimizados en precio, el punto de rentabilidad se sitúa en torno a los 55 millones de tokens mensuales. Si el volumen es inferior, pagar por token sin asumir el costo ocioso de una GPU encendida las 24 horas es la estrategia más prudente.
7. Gobernanza Empresarial y Despliegues Air-Gapped (DeepSeek-R1 y Llama 3.3)
En sectores con regulaciones estrictas—como la banca corporativa, seguros, instituciones de salud (cumplimiento HIPAA) y entidades gubernamentales o de defensa—está terminantemente prohibido canalizar datos sensibles o propiedad intelectual a través de APIs públicas externas.
Tanto vLLM como Ollama permiten un despliegue 100% Air-Gapped, con corte total de tráfico de salida a internet:
- Retención Cero de Datos (Zero Data Retention): Los pesos de los modelos se resguardan en buckets privados S3 o discos NVMe cifrados con llaves KMS propias. Ningún prompt o vector de activación sale de la Virtual Private Cloud (VPC).
- Modelos de Razonamiento de Frontera (DeepSeek-R1): La arquitectura MoE (Mixture-of-Experts) de 671 mil millones de parámetros de DeepSeek-R1 (con 37B activos por token) y sus variantes destiladas basadas en Llama y Qwen (7B, 14B, 32B, 70B) ofrecen capacidades analíticas al nivel de OpenAI o1. Al autohospedarlas con vLLM en redes aisladas, la empresa adquiere razonamiento avanzado sin ceder soberanía digital.
- Despliegues Tácticos en Edge con Ollama: Para laptops corporativas de auditoría legal o estaciones de campo sin conectividad, los modelos GGUF de Ollama pueden empaquetarse en imágenes de contenedor inmutables que arrancan de forma completamente offline.
8. Matriz Comparativa Exhaustiva Cara a Cara
La siguiente tabla resume las dimensiones arquitectónicas, operativas y de rendimiento entre vLLM y Ollama para facilitar la toma de decisiones:
| Criterio de Evaluación | vLLM (v0.7+) | Ollama (v0.5+) | Ventaja Arquitectónica |
|---|---|---|---|
| Enfoque Primario | Microservicios cloud en producción y clusters | Workstations locales y dispositivos edge | Depende del caso de uso |
| Motor de Cómputo | Python / C++ / CUDA con PagedAttention | Daemon en Go que envuelve llama.cpp (C/C++) | vLLM en Cloud, Ollama en Portabilidad |
| Gestión de KV Cache | Paginación virtual, desperdicio <4% | Slots estáticos; alta fragmentación | vLLM (Definitivo) |
| Estrategia de Lotes | Continuous batching a nivel de iteración | Cola secuencial FIFO / slots paralelos fijos | vLLM (Definitivo) |
| Throughput Concurrente | Masivo (2,500+ tokens/s bajo carga alta) | Moderado a bajo (se estanca tras 4-8 streams) | vLLM (10x a 64+ streams) |
| Formatos de Cuantización | FP8, AWQ, GPTQ con Marlin, SqueezeLLM | GGUF (Q4_K_M, Q5_K_M, Q8_0) | vLLM para Servidor, Ollama para Edge |
| Distribución Multi-GPU | Tensor Parallelism (TP) y Pipeline Parallelism | División secuencial de capas entre tarjetas | vLLM (All-Reduce Real) |
| Soporte Apple Silicon (Metal) | Experimental o limitado | Soporte nativo Metal de primer nivel | Ollama (Definitivo en Mac) |
| Complejidad de Instalación | Alta (CUDA, drivers, Docker, Kubernetes) | Cero (Instalador en 1 clic o binario único) | Ollama (Fricción Cero) |
| Compatibilidad con Kubernetes | Helm Charts oficiales, KServe, vLLM Operator | Requiere wrappers y contenedores manuales | vLLM (Estándar Cloud) |
| Métricas y Observabilidad | Endpoint Prometheus nativo (:8000/metrics) | Logs básicos en stdout, sin Prometheus nativo | vLLM |
| Calificación General | 9.6 / 10 (Producción Cloud) | 9.4 / 10 (Desarrollo Local) | Especialización complementaria |
9. Preguntas Frecuentes (FAQ Técnicas)
OLLAMA_NUM_PARALLEL y OLLAMA_MAX_LOADED_MODELS detrás de un balanceador de carga Nginx o Envoy. Sin embargo, carece de primitivas clave para entornos empresariales: no soporta Tensor Parallelism multinodo, no exporta métricas nativas de telemetría para Prometheus (saturación de GPU cache, percentiles de latencia prefill/decode) ni dispone de preemption dinámico o chunked prefill. Ollama fue diseñado primariamente para workstations de desarrolladores, prototipado local, asistentes de código de escritorio y dispositivos de borde (edge computing). Para APIs multi-tenant a escala, vLLM o Triton Inference Server son los estándares de la industria.
10. Recomendación Estratégica y Hoja de Ruta para Arquitectos
En la ingeniería de software actual, vLLM y Ollama no son herramientas antagónicas que compiten por el mismo nicho; son capas complementarias en una arquitectura de inteligencia artificial híbrida y madura.
- El Modelo Híbrido Corporativo: Dota a cada ingeniero de software, científico de datos e investigador con Ollama en sus computadoras locales o MacBook Pros con Apple Silicon. Esto permite un desarrollo ágil de agentes autónomos, iteraciones locales de prompts sin costo de infraestructura y experimentación protegida sin peligro de fuga de datos corporativos.
- La Capa de Producción en la Nube: Cuando esos prototipos maduren y se integren en el producto digital, canaliza todo el tráfico de backend a través de un cluster de Kubernetes operando con vLLM sobre instancias GPU dedicadas (A100/H100 o nodos de RTX 4090). vLLM provee las métricas de Prometheus, la eficiencia de memoria de PagedAttention, el rendimiento de continuous batching y los acuerdos de nivel de servicio (SLAs) que exigen miles de usuarios concurrentes.
Siguiente Paso para Líderes Técnicos: Consulta nuestra comparativa sobre Precios de Cómputo Cloud en AWS vs GCP vs Azure para determinar qué proveedor ofrece las mejores instancias de GPUs para tus nodos, o utiliza nuestra Calculadora de Costos Cloud para simular tu ahorro mensual en inferencia.