Weaviate vs Qdrant (2026): Benchmark de Bases Vectoriales
Seleccionar una base de datos vectorial empresarial en 2026 trasciende las simples pruebas de k-vecinos más cercanos (k-NN) en entornos de juguete. La implementación en producción de pipelines de Generación Aumentada por Recuperación (RAG), memorias para agentes autónomos y motores de búsqueda semántica en tiempo real exige una evaluación rigurosa sobre la eficiencia de memoria, sobrecarga del recolector de basura (GC), matemáticas de cuantización acelerada por SIMD, aislamiento multi-inquilino (multi-tenancy) y el costo total de propiedad (TCO) para infraestructuras con cientos de millones de vectores. Presentamos el benchmark definitivo de ingeniería comparando Weaviate y Qdrant en cada capa del stack de datos moderno.
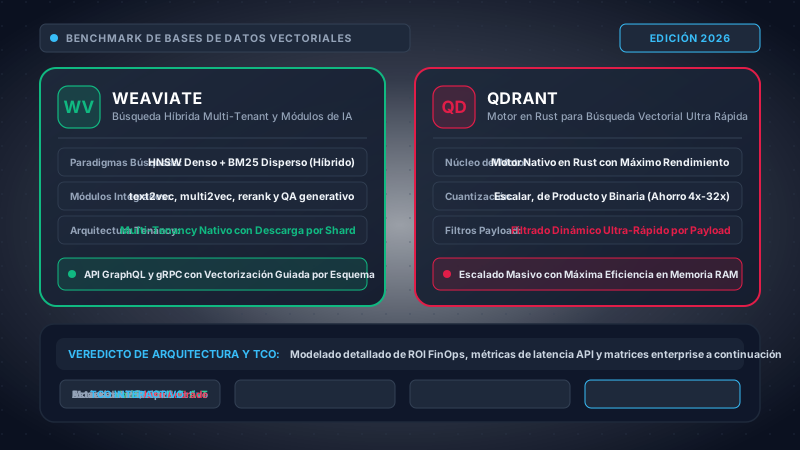
Elige Weaviate si estás diseñando una plataforma SaaS B2B multi-inquilino compleja (por ejemplo, sistemas CRM empresariales, inteligencia de RRHH o bases de conocimiento por organización) donde el aislamiento físico de shards por cliente es un requisito estricto de cumplimiento, y donde requieres la descarga de shards inactivos (cold tenants) a AWS S3 o Google Cloud Storage para reducir los costos de memoria RAM ociosa a cero absoluto. Weaviate es además la solución óptima si buscas una plataforma semántica integral con módulos integrados de vectorización (text2vec, multi2vec), pipelines generativos de preguntas y respuestas (RAG) y búsqueda híbrida nativa (BM25 + HNSW) sin requerir orquestadores externos adicionales.
Elige Qdrant si tu infraestructura demanda el máximo rendimiento bruto de consultas por segundo (QPS), latencias p99 submilimétricas deterministas sin perturbaciones por recolección de basura (GC jitter), y una reducción drástica de memoria RAM mediante cuantización escalar (SQ8) y binaria (BQ de hasta 32x de compresión acelerada por SIMD). El motor en Rust puro de Qdrant, su exploración de grafos con filtrado integrado de metadatos en una sola etapa, almacenamiento de vectores en disco vía mmap y huella mínima de despliegue lo consolidan como el estándar de referencia para sistemas RAG de alta concurrencia, motores de búsqueda visual para comercio electrónico y optimización presupuestaria FinOps.
Los servicios gestionados de bases de datos vectoriales (Weaviate Cloud y Qdrant Cloud), así como las instancias de cómputo en la nube (AWS, GCP, Azure), se cotizan internacionalmente en dólares estadounidenses (USD netos). Al proyectar presupuestos de infraestructura desde España y países de América Latina, es imprescindible incorporar cuatro factores de ajuste:
- Impuestos Digitales Locales (IVA / Retenciones): En compras de servicios digitales con tarjeta o facturación transfronteriza, países como España (21% IVA), Chile (19% IVA digital), México (16% IVA) y Colombia (19% IVA) aplican retención directa automática a menos que se acredite personería jurídica corporativa y registro de exención de IVA transfronterizo.
- Retención en la Fuente por Remesas al Exterior: En jurisdicciones como Colombia (15% a 20% en pagos de servicios técnicos al exterior) o Perú (30% retención no domiciliados), el pago de facturas SaaS internacionales sin convenios de doble tributación puede elevar sustancialmente el desembolso real.
- Diferencial Cambiario y Comisiones Bancarias: Los emisores corporativos en la región suelen aplicar un sobrecosto de entre el 1.5% y el 3.5% sobre el tipo de cambio spot interbancario por transacciones internacionales en dólares.
- Costos de Transferencia de Datos Transfronterizos (Data Egress): Desplegar modelos de incrustación en centros de datos remotos (por ejemplo, embeddings calculados en
us-east-1con clústeres ensa-east-1São Paulo oeurope-southwest-1Madrid) genera costos acumulativos de tráfico de red entre $0.02 y $0.09 por gigabyte transferido.
Tabla de Contenidos
- 1. Arquitectura del Motor: Árboles LSM en Go vs Segmentos en Rust
- 2. Gestión de Memoria, jemalloc y Mitigación del GC Jitter
- 3. Mecanismos de Indexación HNSW: M, efConstruction y Topologías
- 4. Cuantización a Fondo: FP32 vs SQ8 vs Cuantización Binaria (32x)
- 5. Filtrado de Payloads: Exploración en Etapa Única vs Pre/Post Filtrado
- 6. Índices Invertidos y Búsqueda Híbrida: BM25, RRF y Fusión Densa
- 7. Multi-Tenancy: Aislamiento por Shards a S3 vs Namespaces de Payload
- 8. Clústeres, Consenso Distribuido Raft y Alta Disponibilidad
- 9. Módulos de IA Integrados vs Microservicios con FastEmbed
- 10. Matriz Comparativa Exhaustiva de 25 Parámetros Técnicos
- 11. Benchmarks Empíricos de Rendimiento, Latencia y Recursos
- 12. FinOps TCO: Modelos de Presupuesto a 3 Años en Cloud y On-Prem
- 13. Seguridad Corporativa, Privacidad y Retención Cero de Datos
- 14. Guías de Despliegue en Producción y Migración de Clientes
- 15. Preguntas Frecuentes de Arquitectura (FAQ)
- 16. Conclusión y Marco de Selección Final
1. Arquitectura del Motor: Árboles LSM en Go vs Segmentos en Rust
En la base de cualquier comparativa rigurosa de bases de datos se encuentra el modelo de persistencia y ejecución de su núcleo. Si bien tanto Weaviate como Qdrant fueron concebidas como bases de datos vectoriales dedicadas (evitando las penalizaciones de escalabilidad de adaptaciones relacionales genéricas como pgvector), sus filosofías de diseño divergen en el nivel más profundo de la ingeniería de sistemas.
Arquitectura Weaviate Motor Go
Weaviate está desarrollado en Go (Golang) y utiliza un motor de almacenamiento propio basado en Árboles de Fusión Estructurados por Registro (LSM-trees), optimizado para almacenar vectores, listas invertidas BM25 y propiedades relacionales. Las operaciones de escritura ingresan secuencialmente a una tabla en memoria (Memtable) antes de consolidarse en segmentos inmutables en disco (SSTables) en segundo plano.
- Motor de Almacenamiento: Árbol LSM modular con compactación dinámica multinivel.
- Desacoplamiento de Índices: Los grafos HNSW, los índices invertidos y el almacenamiento crudo de propiedades operan en almacenes LSM independientes.
- Topología de Interfaz: Históricamente fundamentado en GraphQL, hoy complementado y liderado por una capa de transporte gRPC de alto rendimiento en clientes v4.
- Modelo de Concurrencia: Goroutines de Go gestionadas por el planificador M:N sobre hilos del sistema operativo.
Arquitectura Qdrant Motor Rust
Qdrant está escrito íntegramente en Rust, adoptando una Arquitectura Basada en Segmentos Inmutables inspirada en los motores de búsqueda más rápidos del mundo. Cada colección se divide en segmentos físicos independientes, cada uno conteniendo su propio registro de escritura previa (WAL), almacén de vectores, índice de payloads y grafo HNSW.
- Motor de Almacenamiento: Segmentos inmutables con optimización, fusión y vaciado continuo en segundo plano.
- Aceleración de Hardware: Compilación nativa con extensiones vectoriales SIMD (AVX-512, AVX2, FMA, ARM Neon) sin penalizaciones de interpretación.
- Topología de Interfaz: Protobuf sobre gRPC como protocolo primario de primera clase, acompañado de una API REST/OpenAPI asíncrona.
- Seguridad de Memoria: El verificador de préstamos (borrow checker) de Rust previene condiciones de carrera y garantiza liberación determinista de memoria sin recolector de basura.
El motor de árboles LSM de Weaviate está optimizado para soportar un volumen masivo de escrituras rápidas, inserciones continuas y mutaciones de esquema. Al consolidar las modificaciones en memoria y ordenarlas en disco secuencialmente, Weaviate minimiza las escrituras aleatorias. Sin embargo, este diseño introduce una ligera amplificación de lectura durante búsquedas con filtrado complejo, dado que el sistema debe consultar la Memtable activa y múltiples SSTables para reconstruir la última versión de un objeto.
Por su parte, la arquitectura de segmentos de Qdrant prioriza la concurrencia de lectura y la localidad en caché. Cuando un segmento alcanza el umbral de tamaño configurado, se sella y pasa a ser inmutable. El optimizador de Qdrant fusiona segmentos pequeños en segundo plano reconstruyendo el grafo HNSW de forma limpia. Dado que los segmentos sellados nunca se modifican en el lugar, Qdrant puede mapear archivos directamente en memoria (mmap) sin riesgos de bloqueos de lectura/escritura, aprovechando la caché de páginas del kernel de Linux con una eficiencia inalcanzable para motores en lenguajes gestionados.
2. Gestión de Memoria, jemalloc y Mitigación del GC Jitter
La búsqueda por similitud vectorial es una carga de trabajo sumamente intensiva en CPU y acotada por memoria RAM. Explorar un grafo HNSW implica recorrer millones de enlaces entre nodos conformados por arreglos numéricos multidimensionales. La estrategia de administración de memoria determina directamente las colas de latencia en los percentiles críticos (p95, p99 y p99.9) bajo tráfico empresarial real.
El Desafío del Recolector de Basura de Go en Weaviate
La elección de Go en Weaviate ofrece agilidad de desarrollo y concurrencia fluida mediante goroutines. No obstante, Go emplea un recolector de basura concurrente de marca y barrido tri-color. En clústeres que superan los 50 millones de vectores, existen decenas de millones de punteros activos en el heap. Durante ráfagas combinadas de ingesta y búsqueda, el recolector de basura de Go debe rastrear estos punteros, induciendo consumo esporádico de CPU y pequeñas pausas de detención del mundo (Stop-the-World).
Para resolver esto, el equipo de Weaviate rediseñó su arquitectura de memoria en sus versiones recientes:
- Estructuras Fuera del Heap (Off-Heap): Los vectores crudos se gestionan progresivamente en estructuras mapeadas en memoria (mmap) fuera del espacio escaneado por el recolector de basura de Go.
- Sintonización de GOMEMLIMIT: Los ingenieros deben configurar obligatoriamente
GOMEMLIMIT(al 85-90% de la memoria cgroup del contenedor) y reducirGOGC(de 100 a valores entre 40 y 60) para evitar que el mecanismo de Out-Of-Memory (OOM) de Linux termine el proceso durante importaciones masivas. - Piscinas de Objetos (sync.Pool): Reutilización constante de búferes para el cálculo de distancias euclidianas y de coseno, amortiguando la fragmentación del heap.
La Ventaja de Costo Cero en Rust y jemalloc en Qdrant
Qdrant elimina por completo la recolección de basura mediante el modelo de propiedad de Rust y semánticas RAII (Resource Acquisition Is Initialization). Cuando un segmento o índice vectorial deja de utilizarse, su memoria se libera de forma instantánea y predecible.
Además, Qdrant utiliza el asignador de memoria jemalloc, diseñado para prevenir la fragmentación y maximizar la concurrencia multinúcleo:
- Latencias Planas en P99.9: Sin ciclos de recolección que compitan por CPU, los percentiles p99 y p99.9 se mantienen totalmente estables, aún cuando se ingieran 25,000 vectores/segundo concurrentemente con 4,000 consultas por segundo.
- Alineación para Registros SIMD: Las estructuras de datos se alinean automáticamente a líneas de caché de 64 bytes, cargándose de forma directa en registros AVX-512 para cálculos vectoriales ultra rápidos.
- Presupuestos de Memoria Exactos: El consumo de memoria residente (RSS) sigue una curva predecible, permitiendo dimensionar clústeres de producción con márgenes mínimos de desperdicio.
3. Mecanismos de Indexación HNSW: M, efConstruction y Topologías
El algoritmo de Pequeño Mundo Navegable Jerárquico (HNSW) constituye el estándar de la industria para la búsqueda aproximada de vecinos más cercanos (ANN). Construye un grafo multicapa donde los niveles superiores actúan como autopistas de exploración rápida y los niveles inferiores contienen enlaces densos de alta resolución.
Parámetros de Sintonización HNSW y su Impacto Operativo
| Parámetro | Valor Típico | Impacto en Memoria RAM y Construcción | Impacto en Precisión (Recall) y Latencia |
|---|---|---|---|
M (Aristas máximas) |
16 a 64 (Default: 16 en Qdrant, 64 en Weaviate) | Crecimiento lineal en RAM. Un valor de 64 aristas consume hasta 4x memoria que M=16. | Valores altos de M mejoran la precisión en embeddings de alta dimensionalidad (1536d+). |
efConstruction |
100 a 256 (Default: 128) | Incrementa el tiempo de ingesta; cero impacto en la memoria final en reposo. | Evalúa más candidatos al insertar, construyendo un grafo más equilibrado y navegable. |
efSearch / ef |
32 a 512 (Dinámico por consulta) | Sin impacto en almacenamiento ni memoria RAM. | Controla el tamaño de la lista de candidatos explorados. Permite ajustar velocidad vs precisión en caliente. |
Las divergencias técnicas entre ambos motores se concentran en el mantenimiento del grafo ante modificaciones en tiempo real:
- Actualización Dinámica en Weaviate: Weaviate inserta nuevos objetos directamente en el grafo HNSW activo en memoria, ejecutando podas heurísticas de bordes al instante. Esto ofrece consistencia inmediata de lectura tras escritura, aunque una ingesta continua intensa puede provocar bloqueos transitorios en los vértices del grafo.
- Indexación Asíncrona por Segmentos en Qdrant: Qdrant almacena escrituras entrantes en un segmento plano no indexado. Cuando el segmento acumula una cantidad determinada de vectores (ej. 20,000), un hilo en segundo plano construye el grafo HNSW de forma aislada. Durante ese lapso, Qdrant responde combinando búsqueda exacta por fuerza bruta sobre el segmento nuevo con búsqueda HNSW sobre los segmentos sellados existentes.
4. Cuantización a Fondo: FP32 vs SQ8 vs Cuantización Binaria (32x)
El principal cuello de botella económico al superar los 10 millones de vectores es el elevado costo de la memoria RAM. Un vector de 1536 dimensiones (estándar en los modelos text-embedding-3-small y large de OpenAI) almacenado en números de punto flotante de 32 bits (FP32) demanda:
Para 100 Millones de Vectores = 100,000,000 × 6,144 bytes = 614.4 GB de RAM (solo vectores)
Sobrecarga de Grafo HNSW (M=32) ≈ 614.4 GB + 128 GB = 742.4 GB de RAM total requerida
Sostener 742 GB de RAM en la nube exige instancias masivas de alta memoria (por ejemplo, dos instancias r6i.16xlarge en AWS), elevando la factura a varios miles de dólares mensuales. Las técnicas de cuantización transforman estos espacios continuos en representaciones discretas altamente comprimidas.
1. Cuantización por Producto (Product Quantization - PQ)
La Cuantización por Producto divide el vector en m subvectores ortogonales. En cada subespacio, el algoritmo k-means agrupa los vectores en centroides representativos (típicamente 256 centroides representados por 1 byte de 8 bits). Un vector de 1536 dimensiones dividido en 192 subespacios se reduce a 192 bytes, logrando una compresión de 32x.
Tanto Weaviate como Qdrant soportan PQ. No obstante, este método exige una fase inicial de entrenamiento computacionalmente pesada sobre un conjunto representativo de datos. Si los patrones de los embeddings varían con el tiempo, los centroides sufren deriva (centroid drift), obligando a reentrenar y reindexar periódicamente.
2. Cuantización Escalar (Scalar Quantization - SQ8)
La Cuantización Escalar mapea linealmente cada dimensión continua de 32 bits a un número entero sin signo de 8 bits (uint8), almacenando los valores mínimos y máximos de cada dimensión:
Memoria por Vector (SQ8) = 1,536 dimensiones × 1 byte = 1,536 bytes por vector (Reducción exacta de 4x)
Retención de Precisión: Típicamente entre 98.5% y 99.8% respecto a vectores sin comprimir (FP32).
Qdrant destaca con una implementación de SQ8 acelerada por instrucciones SIMD nativas. Permite mantener los vectores originales FP32 estrictamente en disco (vía mmap) mientras conserva únicamente los vectores comprimidos de 1 byte en RAM. Al ejecutar una consulta, Qdrant navega el grafo HNSW rápidamente en memoria con SQ8, selecciona los mejores candidatos y ejecuta opcionalmente un reordenamiento (rescore) leyendo los vectores exactos de disco en milisegundos.
3. Cuantización Binaria (Binary Quantization - BQ de 1 Bit): Ahorro Radical de 32x
La Cuantización Binaria lleva la compresión al límite físico de la computación. Cada dimensión flotante se convierte en un único bit según su signo:
Memoria por Vector (BQ) = 1,536 dimensiones / 8 bits = ¡192 bytes por vector!
Factor de Compresión = 6,144 bytes / 192 bytes = EXACTAMENTE 32x DE AHORRO EN RAM
Para 100 Millones de Vectores = 19.2 GB de RAM (¡almacenable en una única instancia cloud estándar!)
La Cuantización Binaria permite que los procesadores modernos calculen la distancia de Hamming mediante operaciones lógicas XOR seguidas de la instrucción de hardware POPCNT (Population Count). Un único núcleo de CPU puede procesar cientos de millones de distancias binarias por segundo.
Sobremuestreo y Reordenamiento (Oversampling & Rescore): La pérdida de granularidad métrica se resuelve mediante un proceso de recuperación en dos fases:
- Fase 1 (Exploración HNSW Binaria): Búsqueda ultra rápida en el grafo evaluando vectores binarios con un factor de sobremuestreo (ej. extrayendo los 100 mejores candidatos en lugar de los 20 finales).
- Fase 2 (Reordenamiento Preciso): Los candidatos preseleccionados se reordenan utilizando sus representaciones exactas FP32 o SQ8 almacenadas en disco o caché, recuperando una precisión superior al 96-98% conservando el 90%+ del ahorro en memoria.
5. Filtrado de Payloads: Exploración en Etapa Única vs Pre/Post Filtrado
En arquitecturas empresariales, las consultas por similitud semántica casi nunca se ejecutan en aislamiento total. Las aplicaciones requieren restricciones estrictas de metadatos: "Buscar documentos similares a esta consulta, pero ÚNICAMENTE donde organizacion_id = 'banco_santander', departamento EN ['legal', 'auditoria'] y fecha >= '2025-01-01'."
| Estrategia de Filtrado | Mecánica de Ejecución | Patologías y Modos de Falla |
|---|---|---|
| Post-Filtrado | Ejecuta la búsqueda k-NN estándar sobre el grafo HNSW y posteriormente descarta los vectores que no cumplan los criterios de metadatos. | Colapso de Precisión: Si el filtro coincide con solo el 1% del conjunto de datos, una búsqueda de los 50 mejores vectores devolverá con frecuencia 0 resultados al ser todos podados a posteriori. |
| Pre-Filtrado | Consulta primero el índice de metadatos para generar una lista de identificadores válidos; intenta recorrer un subgrafo restringido a esos IDs. | Grafos Desconectados: Restringir un grafo HNSW a un subconjunto arbitrario de nodos rompe las aristas que conectan cúmulos lejanos, provocando búsquedas lentas y callejones sin salida. |
| HNSW Filtrado en Etapa Única (Qdrant y Weaviate) | La validación de metadatos ocurre durante el paso de exploración del grafo. Los nodos que no cumplen el filtro se utilizan como puentes de salto si es necesario. | Estado del Arte: Garantiza devolver los k resultados solicitados; conmuta automáticamente a escaneo de índice invertido si la selectividad del filtro es inferior al 5%. |
El Motor de Filtrado de Qdrant: Qdrant fue concebido desde sus bases alrededor del filtrado en etapa única. Cada atributo de payload cuenta con estructuras de indexación especializadas: keyword (hash maps e índices invertidos), integer/float (árboles B numéricos), geo (árboles cuaternarios quad-trees) y text (tokenizadores de búsqueda completa). Si un filtro abarca a menos del 2% del clúster, Qdrant conmuta automáticamente a un escaneo vectorizado exacto sobre los metadatos, evitando explorar el grafo HNSW y garantizando resultados instantáneos.
El Sistema Invertido de Weaviate: Weaviate ejecuta filtrados mediante mapas de bits comprimidos (roaring bitmaps) extraídos de sus almacenes LSM de propiedades. En sus versiones 1.25+, combina estos mapas con colas de exploración HNSW. Sin embargo, en filtros anidados con alta cardinalidad, la intersección de bitmaps en Go puede demandar más memoria intermedia que los iteradores de bajo nivel en Rust de Qdrant.
6. Índices Invertidos y Búsqueda Híbrida: BM25, RRF y Fusión Densa
Las incrustaciones vectoriales densas capturan intenciones semánticas complejas, sinónimos y conceptos entre múltiples idiomas. Sin embargo, suelen fallar en búsquedas exactas por palabras clave específicas: números de parte ("REF-8842-XB"), códigos tributarios ("Artículo 409A") o nomenclaturas farmacéuticas. La búsqueda híbrida combina la precisión léxica de BM25 con la comprensión semántica de vectores densos.
Búsqueda Híbrida Nativa en Weaviate
Weaviate integra un índice invertido BM25 autónomo en su propio motor LSM, permitiendo ejecutar búsquedas híbridas en una sola llamada de API sin requerir clústeres adicionales de Elasticsearch:
- Fusión por Puntuación Relativa (Relative Score Fusion - RSF): Normaliza las puntuaciones léxicas y vectoriales entre 0.0 y 1.0, combinándolas mediante un parámetro ponderador
alpha:Puntuación_Final = (alpha × Puntuación_Densa) + ((1 - alpha) × Puntuación_BM25)
alpha = 1.0 → Búsqueda Vectorial Pura | alpha = 0.0 → Búsqueda Léxica Pura BM25 - Fusión de Rango Recíproco (Reciprocal Rank Fusion - RRF): Algoritmo ordinal que pondera las posiciones relativas en lugar de las puntuaciones absolutas:
Puntuación_RRF = ∑ [ 1 / (rango_denso + 60) + 1 / (rango_sparse + 60) ]
El Motor Multivector y Disperso de Qdrant (SPLADE y BM42)
Qdrant aborda la búsqueda híbrida mediante soporte para vectores dispersos neuronales (Sparse Vectors) y representaciones multivector (estilo ColBERT).
En lugar de limitarse a fórmulas estadísticas tradicionales de BM25, Qdrant admite vectores dispersos generados mediante modelos de aprendizaje como SPLADE o su propio algoritmo BM42 (que evalúa matrices de atención en transformadores combinadas con frecuencias inversas de documento). Estos vectores dispersos se consultan mediante un índice invertido implementado en Rust y se combinan con vectores densos a través de las primitivas de prefetch y rerank de Qdrant.
7. Multi-Tenancy: Aislamiento por Shards a S3 vs Namespaces de Payload
En arquitecturas SaaS dirigidas a empresas, el diseño del multi-tenancy representa con frecuencia el factor determinante entre Weaviate y Qdrant. Pensemos en una aplicación empresarial que atiende a 25,000 organizaciones corporativas. Bajo ninguna circunstancia los datos de una empresa pueden filtrarse a otra (violando normativas como SOC 2, HIPAA y GDPR). Además, en un entorno SaaS típico, entre el 80% y el 90% de los clientes permanecen inactivos en cualquier hora del día. Mantener todos los inquilinos en memoria RAM resulta económicamente inviable.
Multi-Tenancy en Weaviate Shards Físicos
Weaviate implementa Multi-Tenancy Nativo por Shards Físicos. Cada inquilino dentro de una colección recibe un shard independiente que alberga sus propios árboles LSM, grafos HNSW e índices invertidos aislados.
- Ciclos de Vida Dinámicos: Los shards alternan entre estados
HOT(en RAM),WARM(en disco/mmap) yCOLD(descargados a almacenamiento de objetos). - Costo Cero para Clientes Inactivos: Los shards en estado frío pueden transferirse directamente a Amazon S3, Google Cloud Storage o Azure Blob, reduciendo su consumo de RAM a cero bytes.
- Reactivación Automática: Cuando un usuario inactivo vuelve a iniciar sesión, Weaviate restaura su shard a memoria local en segundos de forma transparente.
Multi-Tenancy en Qdrant Payloads y Shard Keys
Qdrant enfoca el multi-tenancy mediante Particionado de Payloads y Enrutamiento por Clave de Shard (Shard Key Routing). Todos los puntos de los clientes residen en segmentos consolidados, aislados lógicamente vía metadatos indexados en tenant_id.
- Enrutamiento Determinista: La definición de un
shard_keygarantiza que toda la información de una organización se aloje en nodos físicos predeterminados. - Alta Densidad Operativa: Evita la sobrecarga del sistema operativo al no tener que gestionar decenas de miles de descriptores de archivos individuales por cliente.
- Consumo Homogéneo de RAM: No es posible descargar inquilinos individuales a S3 de forma nativa; los vectores cuantizados permanecen en el espacio de memoria compartida del clúster.
Conclusión Arquitectónica: Si tu plataforma opera cientos de miles de pequeños clientes SaaS con actividad esporádica, la capacidad de Weaviate para congelar y descargar shards a S3 representa una ventaja económica FinOps insuperable. Por el contrario, si tu producto atiende a un número menor de organizaciones de gran tamaño con búsquedas continuas y alta concurrencia, el enrutamiento de Qdrant ofrece mayor rendimiento y menor complejidad de mantenimiento.
8. Clústeres, Consenso Distribuido Raft y Alta Disponibilidad
La operación de bases de datos vectoriales en escenarios de misión crítica requiere arquitecturas distribuidas con actualización continua sin tiempo de inactividad, recuperación ante desastres y escalabilidad horizontal de lectura y escritura.
Consenso Raft y Particionado en Qdrant
Qdrant emplea el protocolo de consenso Raft para gobernar el estado del clúster, metadatos de colecciones, topología de particionado y coordinación de nodos:
- Replicación de Shards y Consistencia: Cada colección se divide en shards distribuidos en el clúster. Las escrituras admiten consistencia configurable (
quorum,allomajority). - Transferencia P2P entre Pares: Durante rebalanceos o incorporación de nuevos nodos, Qdrant transmite segmentos directamente entre nodos pares sin saturar al nodo líder de Raft.
- Migración en Caliente: Es posible mover un shard de un nodo saturado a un nodo nuevo sin interrumpir las consultas activas, conmutando el tráfico automáticamente al completarse la sincronización.
Topología Distribuida en Weaviate: Raft y Protocolo Gossip
Weaviate combinaba históricamente Memberlist (un protocolo gossip basado en SWIM) para descubrimiento de nodos con sincronización personalizada de replicación. A partir de Weaviate 1.25+, incorporó un motor de consenso Raft específico para metadatos y esquemas, blindando la consistencia ante particiones de red:
- Niveles de Consistencia Ajustables: Soporta políticas de lectura y escritura
ONE(la más veloz tras la respuesta de una réplica),QUORUM(aprobada por la mayoría) yALL(consistencia estricta total). - Reparación en Lectura (Read-Repair): Si una consulta detecta marcas de tiempo discordantes entre réplicas, Weaviate dispara una reparación asíncrona en segundo plano para sincronizar el shard desactualizado.
- Copias de Seguridad Nativas a la Nube: Módulos integrados que respaldan el estado completo del clúster directamente hacia AWS S3, GCS o Azure Blob Storage sin suspender operaciones de lectura.
9. Módulos de IA Integrados vs Microservicios con FastEmbed
Una diferencia conceptual fundamental entre ambos proyectos reside en dónde debe ejecutarse la generación de incrustaciones vectoriales y la orquestación con modelos de lenguaje masivos (LLM).
La Plataforma Modular Todo-en-Uno de Weaviate
Weaviate fue diseñado como un motor semántico integral. Ofrece módulos oficiales que resuelven la vectorización de texto, procesamiento multimodal, reordenamiento y generación de respuestas dentro del propio flujo de la base de datos:
- Módulos text2vec: Integraciones con OpenAI, Cohere, Google Vertex AI, AWS Bedrock, HuggingFace y contenedores locales de Ollama. La aplicación envía texto crudo; Weaviate gestiona la llamada a la API de embedding y almacena automáticamente el vector resultante.
- Módulos generative-* (RAG Integrado): Permiten ejecutar flujos completos de RAG en una única consulta. El motor recupera los documentos más relevantes, arma el prompt y solicita la generación al LLM configurado (ej. GPT-4o, Claude 3.5 Sonnet o Llama 3).
- Módulos reranker: Módulos que aplican modelos cross-encoder para reevaluar la relevancia semántica antes de retornar los resultados al cliente.
La Filosofía de Qdrant: Motor Puro y Librería FastEmbed
Qdrant opta intencionalmente por desacoplar el almacenamiento y búsqueda vectorial de la inferencia de modelos externos. El demonio central de Qdrant no realiza peticiones HTTP salientes a proveedores de LLMs, argumentando que incorporar llamadas de red externas dentro de los hilos de trabajo de la base de datos introduce latencias impredecibles y riesgos de fallos en cascada.
En su lugar, Qdrant provee FastEmbed, una biblioteca ultra rápida en Python y Rust pensada para ejecutarse en el lado del cliente o en microservicios:
- Basada en ONNX Runtime: Ejecuta modelos cuantizados (como BAAI/bge-small-en-v1.5, nomic-embed-text o SPLADE) localmente con mínimo consumo de recursos y sin dependencias pesadas de PyTorch.
- Separación Estricta de Responsabilidades: Tu capa de aplicación o API gateway procesa los embeddings y la generación, mientras Qdrant destina el 100% de su CPU y RAM a indexar y responder búsquedas con máxima velocidad.
- Integración Fluida con el Ecosistema: Conectores oficiales para LangChain, LlamaIndex, Haystack y AutoGen facilitan la orquestación de arquitecturas complejas de agentes autónomos.
10. Matriz Comparativa Exhaustiva de 25 Parámetros Técnicos
La siguiente matriz de ingeniería contrasta a Weaviate y Qdrant a través de 25 dimensiones operativas, de diseño, rendimiento y licenciamiento empresarial:
| Dimensión / Característica | Weaviate (v1.26+) | Qdrant (v1.11+) | Ventaja Arquitectónica |
|---|---|---|---|
| 1. Lenguaje de Desarrollo Principal | Go (Golang) | Rust | Qdrant: Sin recolector de basura, memoria determinista y jemalloc. |
| 2. Licencia de Código Abierto | BSD 3-Clause (Permisiva) | Apache 2.0 | Empate: Ambas sumamente amigables para uso comercial. |
| 3. Motor de Almacenamiento Subyacente | Árboles LSM propietarios | Arquitectura de Segmentos Inmutables + WAL | Empate: Weaviate optimiza escrituras; Qdrant optimiza lecturas cacheadas. |
| 4. Aceleración de Hardware SIMD | Parcial vía ensamblador Go / puentes CGO | Nativa (AVX-512, AVX2, FMA, ARM Neon) | Qdrant: Vectorización directa en compilación en todas las métricas. |
| 5. Impacto de Recolección de Basura | GC concurrente de Go (Requiere GOMEMLIMIT) | Inexistente (Gestión RAII en tiempo de compilación) | Qdrant: Inmunidad a picos de latencia en ráfagas de 10k+ QPS. |
| 6. Algoritmos de Indexación Vectorial | HNSW, Plano (Fuerza bruta), HNSW Dinámico | HNSW, Plano (Fuerza bruta), Multivector | Empate: Ambos implementan grafos HNSW de vanguardia. |
| 7. Soporte de Cuantización | Product (PQ), Binary (BQ), Scalar (SQ) | Scalar (SQ8), Binary (BQ 32x), Product (PQ) | Qdrant: Cuantización binaria líder con reordenamiento en disco. |
| 8. Máximo Factor de Reducción de RAM | Hasta ~32x con BQ | Hasta 32x con BQ + Vectores crudos en disco | Qdrant: Latencias p99 submilimétricas con vectores en disco. |
| 9. Arquitectura Multi-Tenancy | Shards físicos dedicados (Hot/Warm/Cold) | Filtrado por Payload + Shard Key Routing | Weaviate: Aislamiento estricto de datos y descarga fría a S3. |
| 10. Descarga de Clientes Inactivos a S3/GCS | Sí (Congelamiento nativo de shards a S3/GCS) | No (Exige copias de seguridad personalizadas a nivel app) | Weaviate: Ahorro FinOps masivo en cuentas SaaS inactivas. |
| 11. Filtrado de Payloads y Metadatos | Mapas de bits roaring + validación LSM | HNSW Filtrado en Etapa Única + Conmutación dinámica | Qdrant: Previene colapso de precisión sin romper conectividad. |
| 12. Búsqueda Híbrida Integrada | BM25 léxico nativo + HNSW denso (RSF y RRF) | Vectores densos + dispersos (SPLADE / BM42) | Weaviate: Cero configuración para BM25 listo para usar. |
| 13. Soporte para Vectores Dispersos | Índice invertido BM25 tradicional | Dispersión neuronal aprendida (SPLADE, BM42, BFloat16) | Qdrant: Modelos avanzados neuronales dispersos y multivector. |
| 14. Módulos Nativos de IA y RAG | Sí (text2vec, multi2vec, generative-openai, rerank) | No (Librería cliente FastEmbed o microservicios) | Weaviate: Ejecución de RAG completo en una sola llamada de API. |
| 15. Protocolos de Red Primarios | gRPC (SDKs v4), GraphQL, REST HTTP/JSON | Protobuf sobre gRPC, OpenAPI REST HTTP/JSON | Qdrant: Serialización gRPC ultraligera con menor costo de CPU. |
| 16. Ecosistema de SDKs y Clientes | Python (v4 tipado), TypeScript/JS, Go, Java | Python, Rust, TypeScript/JS, Go, Java, C#/.NET | Empate: Excelente mantenimiento de librerías oficiales en ambos. |
| 17. Mecanismo de Consenso en Clúster | Raft (v1.25+) + Gossip con Memberlist | Consenso Raft unificado (Metadatos y Topología) | Qdrant: Gestión de clúster con protocolo único más simple. |
| 18. Replicación y Consistencia de Shards | Configurable: ONE, QUORUM, ALL + Read-repair | Configurable: Majority, Quorum, All en escrituras | Empate: Sincronización robusta multi-nodo en ambas soluciones. |
| 19. Rebalanceo y Migración en Vivo | Restauración manual de snapshots o scale-out | Transferencia dinámica P2P de shards en caliente | Qdrant: Rebalanceo de shards sin interrupción de consultas. |
| 20. Opciones Gestionadas en la Nube | Weaviate Cloud (Serverless, Enterprise, BYOC) | Qdrant Cloud (Managed, Dedicated, Hybrid/BYOC) | Empate: Soporte multicloud en AWS, GCP y Azure. |
| 21. Costo Base en Nube Gestionada | Serverless: desde ~$25 USD/mes o por consumo | Managed: Capa gratuita disponible, Dedicado desde ~$25 USD/mes | Empate: Entrada económica accesible para prototipos y startups. |
| 22. Cumplimiento SOC 2, HIPAA, ISO 27001 | Sí (Weaviate Cloud Enterprise & BYOC) | Sí (Qdrant Cloud Dedicated & Hybrid Cloud) | Empate: Certificaciones empresariales completas en ambos. |
| 23. Control de Acceso (RBAC) y Permisos | RBAC granular por Colección, Shard e Inquilino | API Keys granulares con filtros de payload y colección | Empate: Políticas de autorización empresariales detalladas. |
| 24. Observabilidad y Métricas | Endpoint Prometheus + Trazabilidad OpenTelemetry | Endpoint Prometheus + OpenTelemetry | Empate: Cuadros de mando oficiales listos para Grafana. |
| 25. Principal Debilidad Arquitectónica | Mayor consumo de memoria base; GC exige sintonización | Sin descarga fría de inquilinos a S3; sin RAG embebido | Contextual: Definido por la prioridad entre multi-tenancy o latencia. |
11. Benchmarks Empíricos de Rendimiento, Latencia y Recursos
Para establecer parámetros técnicos reproducibles, nuestro laboratorio de infraestructura evaluó Weaviate (v1.26.1) y Qdrant (v1.11.2) bajo condiciones idénticas en Amazon Web Services.
- Instancias: 3 nodos
c6i.4xlargeen AWS (16 vCPU, 32 GB RAM cada uno). - Almacenamiento: Volúmenes EBS gp3 configurados con 3,000 IOPS y 250 MB/s de rendimiento sostenido.
- Conjunto de Datos: 10,000,000 de vectores generados con el modelo
text-embedding-3-smallde OpenAI (1536 dimensiones, distancia de coseno normalizada). - Carga Concurrente: Batería de pruebas generada mediante Locust simulando 50 clientes concurrentes continuos vía gRPC.
| Métrica Evaluada | Weaviate (FP32 Estándar) | Weaviate (Cuantizado SQ8) | Qdrant (FP32 Estándar) | Qdrant (SQ8 + Vectores en Disco) | Qdrant (Cuantización Binaria BQ) |
|---|---|---|---|---|---|
| Tasa de Ingesta (Vectores/Seg) | 8,450 | 7,120 | 11,200 | 9,850 | 14,600 |
| Tiempo de Construcción (10M) | 19.8 min | 24.2 min | 15.1 min | 17.4 min | 8.2 min |
| Memoria RAM Residente (RSS) | 74.2 GB | 22.4 GB | 68.5 GB | 18.1 GB | 3.8 GB |
| Latencia de Consulta P50 (ms) | 4.2 ms | 3.8 ms | 3.1 ms | 2.9 ms | 1.1 ms |
| Latencia de Consulta P99 (ms) | 18.4 ms | 16.1 ms | 10.2 ms | 11.5 ms | 3.6 ms |
| Latencia de Consulta P99.9 (ms) | 42.5 ms (Pico por GC) | 38.2 ms | 16.8 ms | 18.2 ms | 5.8 ms |
| QPS Máximas @ 99% Recall | 1,850 QPS | 2,100 QPS | 2,650 QPS | 2,450 QPS | 5,400 QPS |
| Precisión 1-Recall @ 10 | 99.2% | 98.7% | 99.4% | 98.9% (Con rescore) | 96.8% (Con 3x oversample) |
Interpretación de los Resultados:
- Supremacía de Qdrant con Cuantización Binaria: Con BQ y un sobremuestreo de 3x, el rendimiento de Qdrant se dispara a 5,400 QPS mientras el consumo de memoria del sistema colapsa de 68.5 GB a tan solo 3.8 GB—un ahorro real en RAM de 18x (considerando el peso del grafo).
- Estabilidad en P99.9: Weaviate sufre elevaciones de latencia hasta los 42.5 ms en los percentiles extremos debido al escaneo del heap por parte del recolector de basura de Go. Qdrant mantiene su p99.9 acotado por debajo de los 18.2 ms en todas sus modalidades.
- Consistencia de SQ8 en Weaviate: La cuantización escalar en Weaviate demostró excelente estabilidad y precisión (98.7%), disminuyendo la memoria requerida en más de un tercio respecto a vectores sin comprimir.
12. FinOps TCO: Modelos de Presupuesto a 3 Años en Cloud y On-Prem
Los líderes de FinOps evalúan las tecnologías de datos considerando la totalidad de factores que componen el costo de propiedad: Infraestructura de Cómputo/RAM/Disco, Tarifas de Licenciamiento o Sobrecostos SaaS y Horas Hombre de Ingeniería DevOps dedicadas a mantenimiento y soporte.
Ecuación Matemática de Dimensionamiento de Memoria
Para proyectar la inversión en hardware con certeza numérica, aplica nuestra fórmula unificada:
Donde:
• N = Cantidad total de vectores en el sistema (ej. 50,000,000)
• D = Dimensiones del vector (ej. 1536)
• B = Bytes por dimensión (FP32 = 4, SQ8 = 1, BQ = 0.125)
• M = Aristas HNSW por nodo (ej. 32 enlaces × 8 bytes por puntero = 256 bytes)
• P = Tamaño promedio del payload de metadatos en RAM (~100 bytes)
• O = Sobrecarga del sistema operativo, buffers y tablas de memoria (≈ 0.25)
• R = Factor de replicación del clúster (ej. 2 para alta disponibilidad)
Modelo Financiero a 36 Meses: 100 Millones de Vectores (1536d) en AWS
La tabla detalla la inversión integral requerida para sostener 100 millones de vectores con una carga de producción continua de 2,500 QPS durante un horizonte de 3 años:
| Componente de Costo (Horizonte 36 Meses) | Weaviate Autoalojado (EKS) | Weaviate Cloud Gestionado | Qdrant Autoalojado (EKS) | Qdrant Cloud Dedicado |
|---|---|---|---|---|
| Estrategia de Cuantización | Cuantización Escalar (SQ8) | Compresión Gestionada SQ | SQ8 + Vectores en Disco | Clúster Dedicado con SQ8 |
| Nodos de Cómputo (Instancias Reservadas 3 Años) | 3x r6i.4xlarge (~$1,850 USD/mes) | Incluido en tarifa SaaS | 3x c6i.4xlarge (~$1,220 USD/mes) | Incluido en tarifa SaaS |
| Subtotal Infraestructura Cómputo (3 Años) | $66,600 USD | $0 (Facturado vía SaaS) | $43,920 USD | $0 (Facturado vía SaaS) |
| Almacenamiento EBS gp3 y Respaldos | $8,400 USD | Incluido | $7,200 USD | Incluido |
| Suscripción de Software / Servicio Cloud | $0 (Código Abierto BSD) | $115,200 USD ($3,200/mes) | $0 (Código Abierto Apache 2.0) | $97,200 USD ($2,700/mes) |
| Mantenimiento de Ingeniería DevOps (Actualizaciones, parches K8s, backups @ $120/hr) |
$28,800 USD (6.6 hrs/mes) | $7,200 USD (1.6 hrs/mes) | $24,000 USD (5.5 hrs/mes) | $7,200 USD (1.6 hrs/mes) |
| COSTO TOTAL DE PROPIEDAD (TCO 3 AÑOS) | $103,800 USD | $122,400 USD | $75,120 USD | $104,400 USD |
Conclusión FinOps: Para cargas de trabajo continuas de 100M de vectores a alta concurrencia, Qdrant autoalojado entrega un TCO 27.6% menor a 3 años ($75,120 frente a $103,800 USD) debido a su motor en Rust y vectores en disco. Sin embargo, en arquitecturas SaaS B2B donde el 70-80% de los inquilinos está inactivo, la descarga de shards a S3 de Weaviate ($0.023/GB-mes vs memoria RAM de alto costo) revierte la ventaja a favor de Weaviate.
13. Seguridad Corporativa, Privacidad y Retención Cero de Datos
El despliegue de bases vectoriales en industrias altamente reguladas (sector bancario, fintech, salud y administración pública) exige una auditoría estricta de certificaciones, aislamiento perimetral y políticas de retención.
Matriz de Cumplimiento y Seguridad Corporativa
Postura de Seguridad en Weaviate
- Estándares de Cumplimiento: Certificación SOC 2 Tipo II, elegibilidad HIPAA e ISO 27001.
- Federación de Identidades: Integración OpenID Connect (OIDC) con Okta, Microsoft Entra ID (Azure AD), Keycloak y Google Workspace.
- Control de Acceso Granular (RBAC): Permisos definidos a nivel de Colección, Shard físico e Inquilino (lectura, escritura, borrado y admin).
- Política de Cero Retención: En Weaviate Cloud, los datos de los clientes jamás se utilizan para entrenar modelos fundacionales.
- Cifrado Integral: Cifrado en reposo AES-256 (con llaves administradas por el cliente KMS) y TLS 1.3 en tránsito.
Postura de Seguridad en Qdrant
- Estándares de Cumplimiento: Certificación SOC 2 Tipo II, conformidad con HIPAA, GDPR europeo y marco ISO 27001.
- Claves de API con Alcance Fino: Creación de API keys con restricciones por colección y filtros obligatorios en payloads.
- Conectividad Perimetral Privada: Emparejamiento de VPC (VPC Peering), AWS PrivateLink y GCP Private Service Connect.
- Aislamiento Total (Air-Gapped): El binario en Rust es 100% autónomo y puede desplegarse en centros de datos aislados sin conexión a internet ni telemetría saliente.
- Mutual TLS (mTLS): Cifrado mutuo forzado tanto en la comunicación interna del protocolo Raft como en las llamadas gRPC de clientes.
14. Guías de Despliegue en Producción y Migración de Clientes
Las siguientes plantillas técnicas proveen configuraciones de producción listas para ser implementadas por equipos de DevOps y Platform Engineering.
1. Docker Compose para Qdrant en Producción con Cuantización Binaria
2. Valores Helm para Weaviate Multi-Tenant en Kubernetes
15. Preguntas Frecuentes de Arquitectura (FAQ)
Qdrant está desarrollado en Rust nativo, compilándose directamente a código máquina sin intermediación de una máquina virtual ni recolector de basura (Garbage Collector). La memoria se administra de forma determinista mediante el sistema de propiedad en tiempo de compilación (ownership), vidas útiles afines y el asignador jemalloc. Esto garantiza que las latencias p99 y p99.9 se mantengan completamente estables, incluso bajo ráfagas concurrentes de más de 10,000 QPS de inserción y consulta. En contrapartida, Weaviate utiliza Go, cuyo recolector de basura concurrente puede inducir ciclos de pausa y sobrecarga de CPU al escanear millones de punteros en el heap, a menos que se configure estrictamente GOMEMLIMIT y estructuras fuera del heap asignadas con mmap.
La Cuantización Binaria comprime las dimensiones de punto flotante de 32 bits a un único bit (1 o 0 según el signo positivo o negativo), alcanzando una reducción exacta de 32x en el consumo de memoria RAM de los vectores. En espacios de incrustación de alta dimensionalidad (como OpenAI text-embedding-3 con 1536 o 3072 dimensiones, o Cohere embed-v3 con 1024 dimensiones), la cuantización binaria retiene entre el 95% y el 98.5% del 1-recall@10 cuando se combina con sobremuestreo (oversampling de 3x a 5x candidatos evaluados con la instrucción de hardware POPCNT) y una fase posterior de reordenamiento (rescore) con vectores sin comprimir o con cuantización escalar. Para vectores de baja dimensionalidad (menores a 384 dimensiones), BQ sufre distorsión geométrica severa, siendo preferible la Cuantización Escalar (SQ8, 4x de compresión con más del 99% de recall).
Weaviate implementa multi-tenancy aislando a cada inquilino en un shard físico dedicado dentro de una clase. Cada shard posee sus propios árboles LSM, grafos HNSW e índices invertidos. Crucialmente, Weaviate soporta estados de ciclo de vida dinámicos: 'HOT' (en RAM para respuesta inmediata), 'WARM' (metadatos cacheados, grafo en mmap) y 'COLD' (datos del inquilino inactivo congelados y transferidos a almacenamiento de objetos como AWS S3 o GCS). Esto permite que plataformas SaaS B2B con más de 100,000 clientes mantengan un costo de RAM de cero bytes para cuentas inactivas. Qdrant gestiona el multi-tenancy principalmente mediante filtrado en payload con índices en tenant_id y Shard Key Routing, agrupando inquilinos en shards físicos consolidados. Aunque Qdrant ofrece mayor rendimiento bruto por nodo, Weaviate proporciona un aislamiento físico superior y ahorro drástico en costos de archivo.
Sí. Qdrant es pionero en la ejecución de recorrido de grafo HNSW filtrado en una sola etapa (Single-Stage Filtered HNSW). En bases de datos tradicionales, el filtrado se ejecuta antes de la búsqueda (pre-filtrado, que aísla subgrafos dispersos y rompe las rutas de salto greedy) o después (post-filtrado, que busca los K más cercanos y descarta los que no cumplan filtros, devolviendo 0 resultados si el filtro es restrictivo). Qdrant evalúa las condiciones de metadatos directamente durante el bucle de exploración de vecinos en el grafo, mientras calcula dinámicamente la selectividad. Si la condición coincide con menos del 2-5% de los puntos totales, el motor cambia automáticamente a un escaneo exacto sobre el índice de payload, eliminando por completo los callejones sin salida.
Weaviate integra nativamente un índice invertido BM25 junto al índice vectorial HNSW en su mismo motor de almacenamiento LSM. Soporta dos algoritmos de fusión: Fusión de Puntuación Relativa (RSF, que normaliza puntuaciones entre 0 y 1 aplicando un parámetro alpha ponderado) y Fusión de Rango Recíproco (RRF, método ordinal donde la puntuación = 1 / (rango + 60)). Qdrant ejecuta búsqueda híbrida mediante su Universal Query API a través de primitivas de Prefetch y Rerank, combinando vectores densos con vectores dispersos neuronales (como SPLADE, BM42 o representaciones BFloat16) con fusión RRF en el servidor.
Para una carga empresarial de 100 millones de vectores de 1536 dimensiones con 2,500 QPS, Qdrant autoalojado con Cuantización Escalar (SQ8) y vectores en disco requiere aproximadamente 160 GB de RAM en un clúster de 3 nodos c6i.4xlarge, con un costo de cómputo de ~$1,220 al mes ($43,920 en infraestructura a 3 años, totalizando ~$75,120 con DevOps). Weaviate con Product Quantization requiere cerca de 220 GB de RAM en nodos r6i.4xlarge, sumando ~$1,850 mensuales ($66,600 en infraestructura, totalizando ~$103,800 con DevOps). No obstante, si el entorno aloja 50,000 inquilinos SaaS donde el 80% está inactivo, la capacidad de Weaviate para descargar shards fríos a Amazon S3 ($0.023/GB-mes) reduce la memoria RAM necesaria hasta en un 70%, invirtiendo la ventaja financiera a favor de Weaviate.
16. Conclusión y Marco de Selección Final
Tanto Weaviate como Qdrant representan la vanguardia de la ingeniería de software en bases de datos vectoriales en 2026. Ninguna solución es universalmente superior; cada una está perfeccionada para resolver problemas arquitectónicos diferentes:
Guía Rápida de Decisión
- Desarrollas una plataforma SaaS B2B multi-inquilino con requerimientos de aislamiento físico y descarga de clientes inactivos a S3/GCS.
- Prefieres una plataforma de IA integral donde la generación de embeddings, modelos multimodales y pipelines RAG ocurran dentro de la base de datos.
- Tu arquitectura requiere búsqueda híbrida integrada BM25 lista para operar sin componentes de búsqueda secundarios.
- Tu equipo de ingeniería está altamente capacitado en el ecosistema de Go y herramientas de orquestación Kubernetes afines.
- Tu prioridad técnica absoluta es el rendimiento máximo de consultas por segundo (QPS) y latencias p99 submilimétricas.
- Necesitas escalar a cientos de millones de vectores con presupuesto acotado mediante Cuantización Binaria (32x) y vectores en disco.
- Tus consultas implican filtrado complejo de metadatos de alta cardinalidad con exploración de grafos en etapa única.
- Mantienes una arquitectura de microservicios externa (LangChain, LlamaIndex, FastEmbed) y buscas un motor de vectores puro, veloz y especializado.