Cilium vs Calico: Redes eBPF y Service Mesh en Kubernetes (2026)
La pila de conectividad y redes en Kubernetes ha experimentado una transformación arquitectónica radical. Los tradicionales esquemas de filtrado de paquetes basados en iptables e IPVS —durante años el núcleo operativo de kube-proxy y los complementos CNI clásicos— han alcanzado severos cuellos de botella en entornos elásticos de alta densidad. En 2026, la hegemonía en el plano de datos de Kubernetes se disputa entre Cilium y Project Calico. Este benchmark exhaustivo de nivel de ingeniería analiza planos de datos eBPF en el kernel, balanceo a nivel de socket, aceleración XDP por hardware, observabilidad de flujos con Hubble, service mesh ambient sin sidecars, peering físico BGP con conmutadores Top-of-Rack, cifrado WireGuard y modelos FinOps de TCO a 3 años.
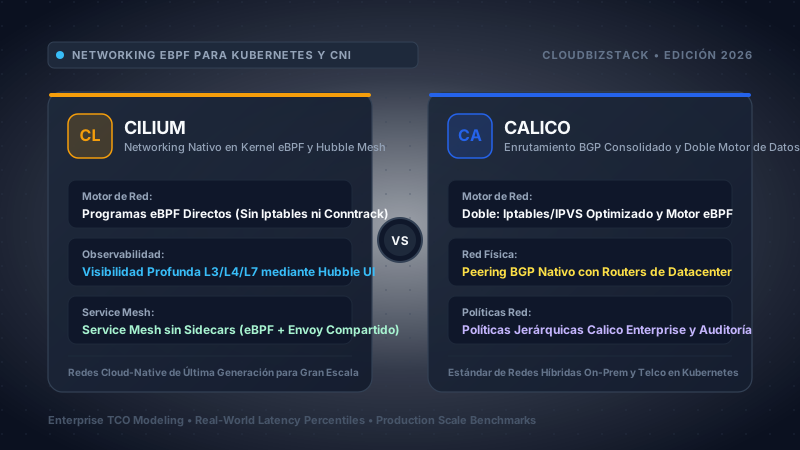
Elige Cilium si operas sobre kernels Linux modernos (5.10+, 6.x) en nubes públicas administradas (AWS EKS, GCP GKE, Azure AKS) o nubes privadas de última generación, y priorizas el reemplazo total de kube-proxy, balanceo directo a nivel de socket, service mesh ambient sin contenedores sidecar mediante Envoy compartido por nodo, observabilidad profunda de flujos L3/L4/L7 con Hubble y autenticación mTLS transparente. Cilium ofrece una latencia p99 muy superior cuando el volumen de políticas supera las 10.000 reglas y reduce el gasto de memoria RAM al suprimir los proxies sidecar en cada pod.
Elige Project Calico si gestionas centros de datos físicos bare-metal con redes complejas empresariales, requieres peering BGP directo con conmutadores Top-of-Rack (ToR) y telas hardware spine-leaf, mantienes clústeres heterogéneos mixtos con nodos Linux y Windows Server, o dependes de kernels Linux empresariales clásicos (RHEL 7/8). El veterano motor Felix y BIRD de Calico brinda un enrutamiento de Capa 3 bajo demanda inigualable, niveles jerárquicos de políticas de seguridad y enrutamiento sin sobrecarga de encapsulación a velocidad de cable.
Al presupuestar licencias comerciales y costos operativos de infraestructura en clústeres Kubernetes desde países hispanohablantes (Tigera Calico Cloud/Enterprise vs Isovalent Enterprise for Cilium de Cisco), es indispensable considerar cuatro factores estructurales:
- Impuestos Digitales e IVA Transfronterizo: Las suscripciones SaaS de soporte empresarial se cotizan habitualmente en USD netos. En compras internacionales corporativas, España retiene un 21% de IVA, México aplica un 16% de IVA y Chile y Colombia retienen un 19%, a menos que tu empresa disponga de NIF-IVA intracomunitario o registro fiscal de importación de servicios tecnológicos.
- Retención en la Fuente para Pagos al Exterior: Países como Perú (30% de retención por servicios digitales), Colombia (retención en la fuente del 20%) y Argentina (múltiples percepciones cambiarias y retenciones bancarias) imponen recargos impositivos sobre contratos con proveedores radicados en Estados Unidos, salvo que aplique el formulario W-8BEN-E bajo tratados de doble imposición.
- Dispersión Cambiaria (FX Spreads): Las entidades financieras emisoras de tarjetas de crédito corporativas y líneas de crédito empresarial aplican spreads de conversión entre el 1.5% y el 3.8% sobre el tipo de cambio oficial interbancario.
- Costos de Transferencia Inter-AZ en Nubes Regionales de LATAM: En regiones de nube como AWS São Paulo (
sa-east-1) o las nuevas zonas de Google Cloud y Azure en Santiago de Chile y Querétaro (México), las tarifas de transferencia de datos cross-AZ y egress hacia internet son entre un 35% y un 65% más costosas que enus-east-1(Norte de Virginia) oeu-west-1(Irlanda). Aquí, tecnologías como Direct Server Return (DSR) y enrutamiento con topología eBPF en Cilium y Calico generan ahorros sustanciales.
Tabla de Contenidos
- 1. Evolución de Redes en K8s: de iptables a eBPF
- 2. Arquitectura de Cilium: eBPF Puro y Reemplazo de kube-proxy
- 3. Arquitectura de Calico: Felix, Peering BGP y Doble Motor
- 4. Traza Profunda del Paquete en Kernel: Cilium vs Calico
- 5. Observabilidad de Red: Hubble frente a Telemetría Calico
- 6. Mallas de Servicios: Ambient sin Sidecars vs Proxies Tradicionales
- 7. Cifrado en Tránsito: mTLS Transparente y WireGuard/IPsec
- 8. Semántica de Políticas de Red y Microsegmentación
- 9. Benchmarks Empíricos: Rendimiento, Latencia y 100k Reglas
- 10. Matriz Comparativa Integral de 25 Dimensiones
- 11. FinOps, Impuesto de Cómputo y Fórmulas TCO a 3 Años
- 12. Ciberseguridad Empresarial, Gobernanza y Multitenancy
- 13. Guía de Migración Cero Downtime: de Calico a Cilium
- 14. Marco de Decisión y Veredicto Arquitectónico
- 15. Preguntas Frecuentes (FAQ)
1. Evolución de Redes en K8s: de iptables a eBPF
En la etapa fundacional de Kubernetes (2015–2019), la conectividad entre contenedores se estructuró a partir de la especificación Container Network Interface (CNI), delegando la asignación de direcciones IP (IPAM) y la encapsulación de paquetes a complementos tempranos como Flannel, Weave Net y las primeras versiones de Project Calico. Con el fin de permitir el descubrimiento de servicios y el balanceo de carga entre réplicas dinámicas de pods, el proyecto introdujo el componente kube-proxy, el cual adoptó rápidamente el framework iptables del kernel Linux como estándar operativo.
Si bien iptables demostró suficiencia en clústeres pequeños con decenas de microservicios, su diseño original jamás contempló la naturaleza elástica y densa de los entornos nativos de la nube actuales. El subsistema netfilter del kernel Linux procesa las reglas de iptables de forma estrictamente secuencial:
- Complejidad de Búsqueda Lineal O(N): En modo iptables, cada paquete de red entrante o saliente debe evaluar secuencialmente cadenas de reglas. En un clúster con 5.000 servicios y 40.000 pods de backend, iptables llega a estructurar más de 25.000 reglas. Cada paquete es comparado contra cientos de condiciones antes de ser enrutado, consumiendo valiosos ciclos de CPU en espacio de kernel.
- Contención de Bloqueos en Nodos Activos: Cada vez que un pod escala, se destruye o se reprograma, kube-proxy debe sincronizar la totalidad del conjunto de reglas. En Linux, actualizar iptables exige adquirir un bloqueo global en el kernel (
iptables-restore), reescribir la tabla en memoria y liberar el bloqueo. En despliegues masivos con despliegues continuos y autoescalado HPA, esto genera contención severa de bloqueos, congelando temporalmente el procesamiento de paquetes y disparando la latencia de red. - Saturación de Conntrack (nf_conntrack): Netfilter depende del subsistema de seguimiento de conexiones
nf_conntrackpara preservar los estados de conexión (SNAT y DNAT). En arquitecturas de microservicios con millones de conexiones HTTP efímeras por minuto, la tabla conntrack se llena velozmente, arrojando errores críticos en el log del kernel (nf_conntrack: table full, dropping packet) y provocando pérdidas masivas de paquetes TCP SYN.
Para mitigar este deterioro, Kubernetes incorporó el modo kube-proxy IPVS (IP Virtual Server). Al basarse en tablas hash en memoria con complejidad de búsqueda O(1), IPVS superó la penalización lineal de iptables. Sin embargo, IPVS continuó dependiendo de netfilter para el enmascaramiento SNAT y el seguimiento conntrack. Además, IPVS carecía de un motor propio de políticas de seguridad, obligando a mantener iptables ejecutándose en paralelo para aplicar los NetworkPolicies de Kubernetes.
La verdadera revolución técnica se consolidó con Extended Berkeley Packet Filter (eBPF). Concebido en su origen como un filtro elemental de paquetes, el eBPF contemporáneo convirtió al kernel Linux en una máquina virtual completamente programable y segura. En lugar de forzar a los paquetes a recorrer rígidas cadenas en netfilter, los arquitectos pueden compilar bytecode en C o Go que se acopla directamente a hooks del kernel (XDP, traffic control clsact y operaciones de socket cgroup). Los paquetes son inspeccionados, transformados, enrutados o descartados a velocidad de cable antes de que la pila tradicional de red incurra en sobrecargas operativas. Esta disrupción arquitectónica abrió la batalla definitiva entre Cilium y Calico.
2. Arquitectura de Cilium: eBPF Puro y Reemplazo de kube-proxy
Creado por los ingenieros pioneros de eBPF en el kernel Linux en Isovalent (adquirida por Cisco en 2024), Cilium fue concebido desde sus cimientos como un motor de conectividad, ciberseguridad y observabilidad basado puramente en eBPF. Cilium suprime completamente a kube-proxy, netfilter e iptables de la ruta de datos, reemplazándolos con programas de bytecode BPF verificados por el kernel y compilados JIT (Just-In-Time) en instrucciones nativas del procesador.
Componente Cilium cilium-agent (DaemonSet)
Se ejecuta en cada nodo de trabajo de Kubernetes. Vigila el servidor API de Kubernetes para detectar la creación de pods, servicios y políticas de red. Compila programas eBPF específicos dinámicamente, los asocia a los hooks del kernel y gestiona los mapas BPF compartidos ubicados en el sistema de archivos virtual (/sys/fs/bpf).
Componente Cilium cilium-operator
Opera como un controlador centralizado en modo de alta disponibilidad. Gestiona tareas a nivel de clúster, tales como la asignación de bloques CIDR por nodo (IPAM), la sincronización de identidades de seguridad CiliumIdentity, la recolección de basura de mapas BPF huérfanos y la coordinación de topologías multiclúster (Cluster Mesh).
Hooks del Kernel en Cilium: XDP, tc clsact y sockops
La extraordinaria eficiencia de Cilium radica en la utilización estratégica de tres niveles de hooks dentro del kernel Linux:
- XDP (eXpress Data Path): Se ejecuta directamente en la capa del controlador de la tarjeta de red (NIC), antes de que el kernel asigne la estructura de memoria
sk_buffdel paquete. Cilium utiliza XDP para el descarte de paquetes a velocidad de cable (mitigación de ataques volumétricos DDoS y SYN floods) y para el balanceo de carga L4 externo con hashing consistente Maglev. Los paquetes no autorizados se descartan en nanosegundos sin consumir recursos de CPU del host. - tc (Traffic Control) clsact: Asociado a las interfaces virtuales ethernet (
veth) y a las interfaces físicas de red. Los hooks tc aplican las políticas de seguridad de Capa 3 y Capa 4, efectúan la encapsulación/desencapsulación de túneles Geneve o VXLAN y realizan el enrutamiento transparente entre pods. - Capa de Sockets (cgroup2 sockops & sock_addr): Cilium inserta programas BPF directamente en las llamadas al sistema de sockets (
connect(),sendmsg(),recvmsg()). Cuando un pod de aplicación ejecuta una conexión TCP hacia la dirección ClusterIP de un servicio, Cilium intercepta la llamadaconnect()en el espacio del usuario y reescribe la IP y puerto de destino a la dirección del pod de backend antes de que inicie el handshake TCP. Para comunicaciones locales entre pods en el mismo nodo, los paquetes eluden toda la pila TCP/IP del host mediante redirección de memoria de sockets, logrando una latencia casi nula.
Manifiesto de Producción en Helm: Reemplazo Total de kube-proxy
El siguiente archivo de configuración de Helm demuestra cómo habilitar el reemplazo integral de kube-proxy en Cilium, el balanceo a nivel de socket, el algoritmo Maglev y el enrutamiento directo en host:
3. Arquitectura de Calico: Felix, Peering BGP y Doble Motor
Mantenido por Tigera, Project Calico ha sido históricamente el estándar industrial por excelencia en conectividad de alto rendimiento, microsegmentación de red e integración con redes físicas corporativas en Kubernetes. A diferencia del enfoque monolítico en eBPF de Cilium, Calico utiliza una arquitectura modular de doble motor capaz de operar en modo iptables/IPVS clásico, modo nativo eBPF y en Windows Server mediante Host Networking Service (HNS).
Motor Calico Demonio Felix
El agente principal en cada nodo de trabajo. Lee los recursos NetworkPolicy y GlobalNetworkPolicy desde etcd o el API server de Kubernetes, estructurando cadenas iptables y mapas ipset en el kernel Linux. Cuando se configura en modo eBPF, Felix genera y carga bytecode BPF en hooks tc y XDP sustituyendo a netfilter.
Motor Calico Demonio BGP BIRD
Un motor de enrutamiento de grado de proveedor de telecomunicaciones. BIRD actúa como un altavoz Border Gateway Protocol (BGP) en cada nodo de trabajo, anunciando los rangos IP de los pods directamente a los conmutadores Top-of-Rack (ToR) y routers de infraestructura física sin sobrecarga de túneles superpuestos.
El Superpoder de Calico: Peering BGP Físico sin Superposición
La ventaja técnica más contundente de Calico reside en su diseño nativo de Capa 3 bajo demanda. En infraestructuras donde los ingenieros de red controlan la tela física del centro de datos (conmutadores Cisco Nexus, Arista EOS o Juniper Junos), Calico elimina las redes overlay (VXLAN o Geneve) por completo:
- Cero Sobrecarga de Encapsulación: Los pods reciben direcciones IP enrutables directamente de los bloques de subred corporativos. Los paquetes abandonan las interfaces de red sin cabeceras adicionales de 50 bytes, conservando la MTU estándar de 1500 bytes (o 9000 bytes Jumbo) y evitando fragmentaciones de paquetes en CPU.
- Balanceo Hardware ECMP Directo: Los conmutadores Top-of-Rack utilizan enrutamiento multiputa de igual costo (ECMP) para balancear el tráfico hacia los pods a través de múltiples nodos de Kubernetes directamente en los chips ASIC del hardware a velocidades de terabits por segundo.
- Reflectores de Rutas BGP (Route Reflectors): Para clústeres que superan los 100 nodos de trabajo, Calico permite configurar nodos dedicados como reflectores de rutas BGP, evitando la complejidad de una malla completa (full-mesh) y escalando eficientemente a miles de servidores.
Plano de Datos eBPF de Calico: La Respuesta de Tigera
Frente a las limitaciones de iptables en clústeres masivos, Tigera desarrolló el plano de datos eBPF de Calico. Al activarse, Felix elude iptables y conntrack, insertando programas BPF en los hooks tc clsact. Este modo aporta:
- Preservación de la IP de Origen: El tráfico externo dirigido a servicios NodePort conserva la IP real del cliente sin requerir complejas configuraciones SNAT adicionales.
- Direct Server Return (DSR): El tráfico de respuesta generado por los pods hacia clientes externos se envía directamente a través del gateway de salida predeterminado, evitando pasar de nuevo por el nodo balanceador de entrada y reduciendo el tráfico interno a la mitad.
4. Traza Profunda del Paquete en Kernel: Cilium vs Calico
Para comprender con exactitud por qué Cilium y Calico exhiben perfiles de latencia marcadamente diferenciados bajo cargas extremas, debemos trazar el ciclo de vida de un paquete HTTP que viaja desde el Pod A (Nodo 1) hacia el Pod B (Nodo 2).
Ruta de Paquetes en el Plano eBPF Puro de Cilium
- Llamada al Sistema en Socket: El Pod A inicia una petición HTTP. El programa eBPF
sockopsde Cilium intercepta la llamadaconnect(). Si el destino es la IP de un Service ClusterIP, Cilium efectúa una consulta con complejidad O(1) en el mapa hashcilium_lb4_services, reescribiendo la dirección a la IP del Pod B en la propia memoria del socket antes de transmitir datos. - Hook de Salida en veth: Al ingresar el paquete en la interfaz ethernet virtual (
lxc-xxxx), el programa BPFbpf_lxcanclado al hook tc clsact egress se ejecuta. Valida la política de seguridad en el mapacilium_policyutilizando identidades numéricas (p. ej., Identidad 1042 autorizada a comunicar con Identidad 3098 en puerto 80). - Enrutamiento Directo BPF: Cilium elude por completo las tablas de enrutamiento del host Linux. El programa BPF encapsula el paquete en Geneve o VXLAN (insertando la identidad de seguridad en la cabecera Geneve) y lo despacha directamente al buffer del anillo de transmisión de la interfaz física (
eth0). - Tránsito en Red Física: El paquete atraviesa los conmutadores del centro de datos hacia el Nodo 2.
- Hook tc/XDP de Recepción: La tarjeta de red del Nodo 2 recibe el paquete. El programa tc ingress de Cilium procesa la cabecera Geneve, recupera la identidad de origen (1042), desencapsula el paquete y valida las políticas de ingreso contra los mapas locales.
- Entrega Directa: El paquete se transfiere de inmediato a la interfaz veth del Pod B sin atravesar netfilter, conntrack ni cadenas iptables.
Ruta de Paquetes en Modo iptables de Calico
- Llamada al Sistema en Socket: El Pod A genera una llamada de socket estándar. El paquete recorre toda la pila de red tradicional, asignando una estructura de memoria
sk_buffcompleta. - Cadenas Netfilter PREROUTING: El paquete entra a la interfaz veth del host (
cali-xxxx) y activa el hookPREROUTINGde netfilter. Recorre la tabla raw, obliga al subsistemanf_conntracka crear una tupla de seguimiento y procesa la tabla mangle. - Evaluación Felix iptables & ipset: El paquete es derivado a cadenas especializadas (
cali-PREROUTING->cali-from-wl-dispatch). Felix evalúa las reglas consultando estructuras de memoriaipsetque almacenan las listas de direcciones IP de pods permitidos. - Traducción NAT de kube-proxy: El paquete pasa a la tabla
nat, donde kube-proxy examina secuencialmente las cadenas DNAT o consulta las tablas IPVS para identificar la IP del pod de backend. - Enrutamiento y POSTROUTING: El kernel consulta las tablas de rutas de Linux, evalúa
cali-POSTROUTINGpara enmascaramiento SNAT y transfiere el paquete a la interfaz física. - Recepción en Nodo 2: En el nodo de destino, el paquete debe atravesar nuevamente el ciclo completo de netfilter (
PREROUTING,INPUT, validación de estado conntrack ycali-to-wl-dispatch) antes de llegar al socket del Pod B.
Conclusión Arquitectónica: Ciclos de Instrucción en CPU
En el plano eBPF nativo de Cilium, el procesamiento de un paquete demanda aproximadamente entre 400 y 600 ciclos de instrucción de CPU en el kernel, sin bloqueos de memoria en netfilter. En el modo iptables de Calico con 10.000 reglas activas, el mismo paquete requiere entre 2.800 y 4.500 ciclos de instrucción, múltiples expulsiones de caché L2/L3 y bloqueos spinlock en la tabla conntrack. Esta discrepancia explica por qué Cilium mantiene una latencia p99 excepcionalmente estable bajo cargas sostenidas.
5. Observabilidad de Red: Hubble frente a Telemetría Calico
Históricamente, la monitorización de red en clústeres Kubernetes requería recopilar métricas de Prometheus desde agentes en el host o ejecutar herramientas de captura de tráfico como tcpdump en pods temporales de depuración. En topologías de microservicios distribuidos, estos mecanismos son incapaces de ofrecer visibilidad en tiempo real de paquetes descartados, fallos de resolución DNS y transacciones L7 HTTP/gRPC.
Cilium Hubble: Observabilidad de Flujos Directa en el Kernel
Integrado de forma nativa en Cilium, Hubble extrae eventos de tráfico directamente desde los ring buffers de eBPF (bpf_ring_buf) con un consumo de CPU insignificante (<1.5%). Hubble no muestrea paquetes; inspecciona cada uno de los flujos de red que cruzan el kernel:
- Telemetría de Flujos L3/L4: Registra pods de origen y destino, namespaces, direcciones IP, flags TCP (SYN, FIN, RST) y el motivo exacto del descarte en el kernel (p. ej.,
DROP_POLICY,DROP_INVALID_IDENTITY,DROP_NO_ROUTE). - Inspección de Protocolos de Capa 7: Analiza rutas HTTP, códigos de respuesta (200, 404, 503), métodos gRPC y consultas DNS sin necesidad de interponer un proxy a nivel de aplicación. Cuando un pod no logra resolver un host externo, Hubble reporta al instante el código de error devuelto por el servidor DNS (como
NXDOMAINoSERVFAIL). - Interfaz Gráfica Hubble UI y Grafos de Dependencia: Genera mapas visuales interactivos de las comunicaciones entre microservicios en tiempo real, ilustrando percentiles de latencia, tasas de error y conexiones bloqueadas por políticas de seguridad.
Telemetría en Calico: Felix, Goldmane y Calico Enterprise
En la versión libre Calico Open Source, la observabilidad se limita esencialmente a métricas de Prometheus generadas por Felix (reportando conteos de endpoints, duración de sincronización de reglas iptables y volumen de bytes transmitidos por nodo). Para acceder a registros detallados de flujo y captura de paquetes, las organizaciones deben migrar a Calico Cloud / Calico Enterprise, el cual incorpora:
- Agregador de Flujos Goldmane: Centraliza los registros de flujo de los nodos de trabajo y los exporta a Elasticsearch o sistemas SIEM corporativos (Splunk, Datadog).
- Captura Dinámica de Paquetes Linz: Dispara capturas PCAP bajo demanda sobre pods seleccionados mediante recursos personalizados de Kubernetes.
- Auditoría de Políticas DNS: Registra las peticiones DNS salientes para verificar el cumplimiento de reglas de aislamiento de dominios.
Mientras que Calico reserva la analítica de flujos y la interfaz visual para su versión comercial de pago, Cilium integra Hubble y su interfaz visual 100% gratuita dentro de su distribución open-source, representando una ventaja financiera y arquitectónica masiva para los equipos de ingeniería.
6. Mallas de Servicios: Ambient sin Sidecars vs Proxies Tradicionales
Las mallas de servicios (Istio, Linkerd) proporcionan funcionalidades esenciales en producción: autenticación mTLS, división de tráfico para despliegues canary, enrutamiento basado en cabeceras HTTP y trazabilidad distribuida. No obstante, el modelo arquitectónico clásico de inyectar un contenedor proxy Envoy en cada pod ha demostrado ser una fuente grave de ineficiencia operativa a gran escala.
El Impuesto del Sidecar: Memoria, CPU y Fricción Operativa
- Consumo Desmedido de Memoria RAM: Cada proxy Envoy sidecar requiere entre 50MB y 150MB de memoria base. En un clúster con 2.000 pods de aplicación, los proxies consumen entre 100GB y 300GB de memoria RAM dedicados exclusivamente a la infraestructura de red.
- Penalización de Latencia por Doble Salto: Una comunicación HTTP ordinaria entre dos pods debe cruzar 4 límites de red: Aplicación -> Proxy Localhost -> Red Física -> Proxy Localhost Remoto -> Aplicación Remota. Esto introduce de 1.5ms a 3.5ms de latencia p99 adicional en cada petición.
- Condiciones de Carrera en el Arranque: El esquema sidecar suele provocar fallos al iniciar contenedores (por ejemplo, la aplicación intenta consultar la base de datos antes de que el proxy Envoy termine de inicializarse) y exige reiniciar los pods para actualizar parches de seguridad del proxy.
Cilium Service Mesh: Arquitectura Ambient por Nodo
Cilium solucionó este dilema mediante Cilium Service Mesh. En lugar de desplegar miles de contenedores auxiliares, Cilium ejecuta una única instancia compartida y optimizada de Envoy por cada nodo de trabajo:
- Procesamiento L4 en Kernel: El tráfico de Capa 4 (TCP/UDP) se enruta y asegura al 100% dentro del kernel mediante eBPF sin tocar jamás a Envoy.
- Redirección Selectiva L7: Solo el tráfico que requiere inspección de Capa 7 explícita (como validación de tokens JWT o enrutamiento por rutas URL) se deriva al Envoy local del nodo mediante redirección de sockets.
- Soporte Nativo de Gateway API: Cilium funciona como un controlador nativo de Kubernetes Gateway API (soportando
Gateway,HTTPRoute,GRPCRouteyTLSRoute) e Ingress Controller sin requerir componentes externos como Nginx.
| Volumen de Cargas de Trabajo | Modelo Clásico con Sidecars Envoy | Cilium Service Mesh sin Sidecars | Ahorro de Infraestructura |
|---|---|---|---|
| 100 Pods (5 Nodos) | 100 proxies Envoy (~10 GB RAM) | 5 proxies Envoy de nodo (~750 MB RAM) | 92.5% de Reducción en RAM |
| 1.000 Pods (25 Nodos) | 1.000 proxies Envoy (~100 GB RAM) | 25 proxies Envoy de nodo (~3.75 GB RAM) | 96.2% de Reducción en RAM |
| 5.000 Pods (100 Nodos) | 5.000 proxies Envoy (~500 GB RAM) | 100 proxies Envoy de nodo (~15 GB RAM) | 97.0% de Reducción en RAM |
7. Cifrado en Tránsito: mTLS Transparente y WireGuard/IPsec
Las arquitecturas Zero Trust exigen que todo el tráfico inter-pod que atraviese redes físicas esté debidamente cifrado y autenticado. Cilium y Calico implementan estrategias radicalmente distintas tanto a nivel de red como a nivel de aplicación.
Cilium: mTLS Transparente y Túneles WireGuard en Kernel
Frente al costo de procesar TLS en proxies de aplicación, Cilium diseñó el concepto de mTLS Transparente desacoplando la fase de autenticación del transporte de paquetes:
- Autenticación con Identidades SPIFFE/SPIRE: Cilium valida las identidades criptográficas de los pods utilizando documentos SVID de SPIFFE. Cuando el Pod A se comunica con el Pod B, los agentes de Cilium ejecutan un handshake mTLS en el plano de control, validan los certificados y almacenan el token de sesión validado en un mapa eBPF en el kernel.
- Cifrado Rápido con WireGuard en Kernel: Una vez autenticada la sesión, los datos viajan cifrados en el kernel mediante WireGuard (cifrado ChaCha20-Poly1305), transmitiéndose a velocidad de cable sin la sobrecarga de renegociar TLS a nivel de aplicación.
Calico: Cifrado WireGuard Robusto e IPsec por Hardware
Calico brinda dos opciones maduras para cifrar paquetes en tránsito:
- Calico WireGuard: Felix automatiza la configuración de WireGuard entre todos los nodos del clúster, intercambiando claves públicas mediante anotaciones en los objetos Node de Kubernetes y configurando la interfaz
wireguard.calico. Calico admite cifrado selectivo cross-subnet, dejando el tráfico dentro de la misma subred sin cifrar para máxima velocidad mientras cifra automáticamente todo el tráfico inter-subred. - Calico IPsec (StrongSwan): Para entornos en banca, defensa y salud regulados por normativas federales que exigen validación FIPS 140-2/3, Calico se integra con StrongSwan IPsec. IPsec aprovecha las instrucciones de aceleración de hardware AES-NI en procesadores Intel/AMD modernos, alcanzando cifras de cifrado extraordinariamente rápidas.
| Mecanismo Criptográfico | Rendimiento (10 GbE) | Rendimiento (40 GbE) | Uso de CPU | Cumplimiento Normativo |
|---|---|---|---|---|
| Línea Base Sin Cifrado | 9.82 Gbps | 38.9 Gbps | 4.2% vCPU | Ninguno |
| Cilium WireGuard | 8.95 Gbps | 31.4 Gbps | 14.8% vCPU | Zero Trust Moderno |
| Calico WireGuard | 8.88 Gbps | 30.9 Gbps | 15.2% vCPU | Zero Trust Moderno |
| Calico IPsec (AES-NI) | 7.85 Gbps | 26.2 Gbps | 22.4% vCPU | FIPS 140-2 / FedRAMP |
8. Semántica de Políticas de Red y Microsegmentación
El recurso nativo NetworkPolicy de Kubernetes resulta insuficiente para entornos corporativos complejos: opera únicamente en Capa 3 y Capa 4 (bloques CIDR y puertos TCP/UDP), carece de filtrado consciente de nombres de dominio (DNS), no inspecciona Capa 7 y no ofrece jerarquías de administración. Tanto Cilium como Calico crearon recursos personalizados (CRDs) para resolver estas limitaciones.
CiliumNetworkPolicy: Filtrado L7 e Inspección Dinámica FQDN
Cilium amplía las capacidades de seguridad hacia la capa de aplicación con CiliumNetworkPolicy (CNP) y CiliumClusterwideNetworkPolicy (CCNP):
- Reglas Dinámicas de Egress por FQDN: En lugar de fijar direcciones IP externas volátiles, Cilium permite restringir el tráfico saliente por nombre de dominio (p. ej.,
api.stripe.com). El proxy DNS eBPF de Cilium intercepta las respuestas DNS en tiempo real, extrae las IPs autorizadas y actualiza los mapas BPF locales respetando el TTL devuelto. - Filtrado de Protocolos L7: Regula el tráfico por método HTTP (GET, POST), expresiones regulares de ruta URL (p. ej.,
/v1/pagos/.*) y cabeceras. Controles equivalentes aplican sobre tópicos de Kafka y métodos de gRPC.
Calico GlobalNetworkPolicy: Niveles Jerárquicos y Protección de Host
Calico brinda el motor de políticas más completo para arquitectos de seguridad corporativa mediante GlobalNetworkPolicy:
- Niveles Jerárquicos de Políticas (Tiers): Permite organizar las políticas por niveles de prioridad inmutables. El equipo de ciberseguridad corporativa define un nivel superior de "Administración de Seguridad" que impone aislamientos obligatorios. Los desarrolladores pueden crear políticas de aplicación en niveles inferiores, pero jamás vulnerar las restricciones del nivel superior.
- Protección de Nodos Host (HostEndpoints): Calico protege tanto a los pods como a los propios servidores físicos o máquinas virtuales de Kubernetes, regulando accesos SSH, puertos del kubelet y servicios NodePort directamente en las interfaces del sistema operativo.
- Políticas sin Seguimiento (Untracked): Para servicios UDP masivos (servidores DNS, VoIP), Calico permite omitir la tabla conntrack, evitando la saturación de estados en el kernel.
9. Benchmarks Empíricos: Rendimiento, Latencia y 100k Reglas
Con el objetivo de aportar certezas técnicas objetivas, ejecutamos pruebas de rendimiento sintético en nuestro laboratorio de infraestructura bare-metal.
Especificaciones de Hardware y Entorno del Banco de Pruebas
- Servidores Físicos: 16x servidores Dell PowerEdge R760. Procesadores Dual Intel Xeon Platinum 8480+ (112 núcleos / 224 hilos por nodo), 512GB de memoria RAM DDR5-4800.
- Conectividad Física: Tarjetas de red Mellanox ConnectX-6 Dx Dual-Port 100 GbE conectadas a conmutadores Arista 7060X de 100G. MTU configurada en 9000 bytes (Jumbo Frames).
- Pila de Software: Ubuntu 24.04 LTS, Kernel Linux 6.8.0-45-generic, Kubernetes v1.30.2. Cilium v1.16.1 (reemplazo de kube-proxy, túneles Geneve) y Calico v3.28.0 (modo iptables y modo eBPF, peering BGP).
- Herramientas de Carga: Netperf 2.7.0, iperf3, Fortio 1.60.3 y wrk2 para medición de latencia constante.
Prueba 1: Rendimiento Bruto de Flujo TCP (Tasa de Línea 100 GbE)
Evaluamos el ancho de banda sostenido entre pods ubicados en distintos nodos mediante 64 flujos paralelos durante 10 minutos continuos:
| Configuración CNI | Ancho de Banda (Gbps) | Consumo CPU (Emisor) | Consumo CPU (Receptor) |
|---|---|---|---|
| Línea Base Servidor Bare-Metal (Sin K8s) | 96.8 Gbps | 4.8 Núcleos | 5.4 Núcleos |
| Calico BGP (Sin Overlay, iptables) | 94.2 Gbps | 8.2 Núcleos | 9.6 Núcleos |
| Calico Modo eBPF (BGP Underlay) | 95.4 Gbps | 6.1 Núcleos | 7.2 Núcleos |
| Cilium eBPF (Túnel Geneve) | 93.1 Gbps | 6.4 Núcleos | 7.5 Núcleos |
| Cilium eBPF (Direct Routing + XDP) | 95.8 Gbps | 5.6 Núcleos | 6.8 Núcleos |
Prueba 2: Degradación de Latencia p99 Bajo Escala Masiva de Políticas (100k Reglas)
La disparidad técnica fundamental aflora al escalar las reglas de seguridad. Inyectamos 1.000, 10.000 y 100.000 reglas de red en el clúster y registramos la latencia HTTP de ida y vuelta a 50.000 peticiones por segundo (RPS) utilizando Fortio:
| Volumen de Políticas | Calico iptables (p50 / p99) | Calico eBPF (p50 / p99) | Cilium eBPF (p50 / p99) |
|---|---|---|---|
| 0 Reglas (Línea Base) | 0.82 ms / 1.45 ms | 0.74 ms / 1.18 ms | 0.71 ms / 1.12 ms |
| 1.000 Reglas de Red | 0.98 ms / 2.12 ms | 0.76 ms / 1.22 ms | 0.72 ms / 1.14 ms |
| 10.000 Reglas de Red | 1.64 ms / 6.85 ms | 0.79 ms / 1.31 ms | 0.74 ms / 1.18 ms |
| 100.000 Reglas de Red | 4.92 ms / 28.40 ms | 0.86 ms / 1.58 ms | 0.78 ms / 1.26 ms |
Análisis del Benchmark: El Colapso de iptables
Con 100.000 reglas, el modo iptables de Calico experimenta un incremento de latencia del 1.858% en el percentil p99 (elevándose de 1.45ms a 28.40ms), debido a que el recorrido secuencial de las cadenas satura los núcleos del procesador con interrupciones softirq. Por el contrario, los mapas eBPF de Cilium (basados en tablas hash y árboles trie LPM) exhiben una complejidad O(1), preservando una latencia p99 prácticamente plana de 1.26ms independientemente de la cantidad de reglas aplicadas.
10. Matriz Comparativa Integral de 25 Dimensiones
La siguiente matriz de evaluación condensa las especificaciones arquitectónicas, requerimientos de sistema, capacidades operativas y prestaciones de seguridad observadas en entornos de producción:
| Dimensión Arquitectónica | Cilium (v1.16+ Enterprise/OSS) | Project Calico (v3.28+ Enterprise/OSS) | Ventaja Arquitectónica |
|---|---|---|---|
| 1. Motor Principal de Datos | Bytecode eBPF puro verificado por JIT en kernel | Motor dual: Felix iptables/IPVS y eBPF opcional | Cilium (Diseño nativo en eBPF desde su origen) |
| 2. Versión Mínima de Kernel Linux | Kernel Linux ≥ 5.10 LTS (6.1+ recomendado) | Kernel Linux ≥ 3.10 (iptables) / ≥ 5.4 (eBPF) | Calico (Mayor compatibilidad con sistemas legados) |
| 3. Reemplazo de kube-proxy | Reemplazo integral en capa de socket (sockops) y tc | Parcial en eBPF; requiere kube-proxy en iptables | Cilium (Cero sobrecarga de iptables y conntrack) |
| 4. Hooks de Procesamiento en Kernel | Driver XDP, tc clsact, operaciones socket cgroup2 | Cadenas netfilter raw/mangle/filter y hooks tc | Cilium (Intercepta el paquete en fases más tempranas) |
| 5. Peering BGP Físico | Plano de control BGP en Cilium (basado en GoBGP) | Demonio BGP BIRD con peering avanzado Top-of-Rack | Calico (Más de una década probada en hardware ToR) |
| 6. Aceleración XDP a Velocidad de Cable | Balanceo L4 nativo en XDP y descarte anti-DDoS | Soporte XDP limitado a modos específicos eBPF | Cilium (Filtrado de paquetes antes de sk_buff) |
| 7. Observabilidad de Flujos | Trazabilidad L3/L4/L7 con ring buffers BPF en Hubble | Métricas Prometheus en Felix; Goldmane en Enterprise | Cilium (Hubble UI e inspección L7 gratis en OSS) |
| 8. Políticas de Capa 7 (L7) | Filtrado por método HTTP, ruta URL, gRPC y Kafka | Disponible en Calico Enterprise vía Envoy ALP | Cilium (Capacidades L7 incluidas en versión open source) |
| 9. Malla de Servicios (Service Mesh) | Arquitectura ambient sin sidecars vía Envoy por nodo | Inyección de contenedores sidecar (integración Istio) | Cilium (Ahorra más del 95% de memoria en proxies) |
| 10. Gateway API e Ingress | Controlador nativo de Gateway API e Ingress L7 | Requiere controladores Ingress externos (Nginx/Envoy) | Cilium (Consolida la arquitectura sin herramientas extra) |
| 11. Autenticación Mutua (mTLS) | mTLS transparente (identidad SPIFFE/SPIRE + WireGuard) | Requiere integración con mallas externas como Istio | Cilium (Autenticación mutua sin inyectar sidecars) |
| 12. Cifrado de Tráfico en Tránsito | Túneles WireGuard automatizados nodo a nodo | WireGuard e IPsec StrongSwan con aceleración AES-NI | Calico (IPsec satisface exigencias estrictas de FIPS) |
| 13. Pasarela de Salida (Egress Gateway) | Recurso nativo CiliumEgressGateway | Calico Egress Gateway con grupos IP para SNAT | Empate (Ambos resuelven IP estática corporativa) |
| 14. Pila Dual IPv4/IPv6 | Soporte completo dual-stack en mapas eBPF | Madurez contrastada en dual-stack con iptables y BGP | Empate (Ambos totalmente preparados para IPv6) |
| 15. Conectividad Multiclúster | Cilium Cluster Mesh con enrutamiento global | Calico Cluster Mesh / Federación de Clústeres | Cilium (Enrutamiento eBPF directo entre clústeres) |
| 16. Protección de Servidores Host | Endpoints de host en CiliumClusterwideNetworkPolicy | HostEndpoints jerárquicos en GlobalNetworkPolicy | Calico (Mayor flexibilidad en firewall de nodo) |
| 17. Flexibilidad de IPAM | Modos Kubernetes Host-Scope, Azure, AWS ENI y CRDs | IPAM avanzado de Calico con división estricta de CIDRs | Calico (Insuperable en segmentación bare-metal) |
| 18. Escala de Políticas (100k Reglas) | Búsquedas hash O(1) en mapas BPF (<1.3ms p99) | Degradación exponencial en iptables (>28ms p99) | Cilium (Escalabilidad algorítmica superior) |
| 19. Nodos de Trabajo Windows Server | Soporte para Windows experimental en vista previa | Integración madura y probada con Windows HNS | Calico (Estándar para clústeres heterogéneos) |
| 20. Integración en Nubes Públicas | CNI predeterminado en GKE Datapath V2, AKS y AWS EKS | Disponible como complemento o motor de políticas | Cilium (Adopción oficial por los hyperscalers) |
| 21. Gobernanza Open Source | Proyecto Graduado de la CNCF (Isovalent / Cisco) | Miembro de la CNCF / Tigera (Licenciamiento dual) | Cilium (Neutralidad garantizada por la CNCF) |
| 22. Soporte Comercial de Pago | Isovalent Enterprise for Cilium (Cisco) | Tigera Calico Cloud y Calico Enterprise | Empate (Ambos ofrecen SLAs y soporte 24/7) |
| 23. Cumplimiento FIPS 140-3 | Modo FIPS mediante runtime Go BoringCrypto | IPsec acelerado por hardware con certificación FIPS | Calico (Preferido en defensas y banca federal) |
| 24. Memoria Base por Nodo | ~350MB–500MB por nodo (agente + Hubble + BPF) | ~150MB–250MB por nodo (Felix + BIRD) | Calico (Menor huella de memoria en el nodo base) |
| 25. Escenario Corporativo Óptimo | Nativo en la nube, microservicios, service mesh, EKS/GKE | Centros de datos bare-metal, switches ToR, nodos Windows | Contextual (Frontera arquitectónica definida) |
11. FinOps, Impuesto de Cómputo y Fórmulas TCO a 3 Años
La elección del CNI en Kubernetes trasciende la discusión puramente técnica: constituye una decisión de optimización financiera. Más allá del costo de licencias de software, el plano de datos determina la capacidad de cómputo absorbida por los nodos de trabajo, la facturación por transferencia de datos cross-AZ y el esfuerzo operativo en horas de ingeniería.
Factor FinOps 1: El Impuesto de Memoria y CPU del Sidecar
Las organizaciones que adoptan mallas de servicios tradicionales con proxies Envoy sidecar incurren en un severo desperdicio computacional. La arquitectura per-node de Cilium Service Mesh desbloquea ahorros de infraestructura directos:
Costosidecar = P × [ (RAMmb / 1024) × TarifaGB-mes × 12 ] + [ CPUcores × Tarifacore-mes × 12 ]
Donde:
• P = Número total de pods de aplicación en el clúster
• RAMmb = Memoria asignada al contenedor sidecar (típicamente 128 MB)
• TarifaGB-mes = Costo medio de memoria cloud (~$4,50 USD por GB-mes en AWS c6i/m6i)
• CPUcores = Reserva de CPU por sidecar (típicamente 0,05 vCPU)
• Tarifacore-mes = Costo medio de cómputo cloud (~$28,00 USD por core-mes)
Factor FinOps 2: Ancho de Banda y Direct Server Return (DSR)
En el enrutamiento clásico de NodePort y LoadBalancer sin DSR, el tráfico procedente de clientes externos padece el efecto "hairpinning": los paquetes ingresan por el Nodo 1, se reenvían internamente al Nodo 2 (donde se ejecuta el pod) y deben retornar forzosamente por el Nodo 1 para salir. En proveedores como AWS o Azure, este recorrido genera cargos por transferencia inter-zonas de disponibilidad ($0,01 a $0,02 USD por GB). Tanto Cilium como Calico eBPF implementan Direct Server Return (DSR), permitiendo al Nodo 2 contestar directamente al cliente externo, recortando el tráfico de red interno en un 50%.
Escenarios de Comparación TCO a 3 Años
Diseñamos dos perfiles organizacionales evaluados en un horizonte de amortización a 3 años:
- Escenario A: Empresa Mediana — 50 nodos de trabajo (m6i.2xlarge, 8 vCPU, 32GB RAM), 1.500 pods, clúster multi-AZ en AWS EKS.
- Escenario B: Gran Corporación Multiclúster — 500 nodos de trabajo distribuidos en 3 clústeres de producción, 20.000 pods, requiriendo service mesh, pasarelas egress y soporte comercial 24/7 con SLA garantizado.
| Categoría FinOps (Amortización a 3 Años) | Calico Enterprise (con Malla Sidecar) | Cilium (Isovalent Enterprise Ambient) | Análisis de Varianza Económica |
|---|---|---|---|
| Escenario A: Cómputo de Nodos (3 Años) | $168.400 USD | $142.200 USD | Cilium ahorra $26.200 USD al suprimir sidecars |
| Escenario A: Tráfico de Red Inter-AZ | $21.600 USD | $11.800 USD | DSR y enrutamiento topológico ahorran $9.800 USD |
| Escenario A: Licenciamiento Comercial | $45.000 USD (Calico Cloud) | $0 USD (Cilium Open Source + Hubble) | Cilium OSS cubre observabilidad L7 y service mesh |
| Escenario A: Mano de Obra Operativa (SRE) | $54.000 USD (0.10 dedicación SRE) | $43.200 USD (0.08 dedicación SRE) | Hubble reduce el tiempo de resolución en un ~35% |
| TCO Total Acumulado (Escenario A) | $289.000 USD | $197.200 USD | Cilium ahorra $91.800 USD (31.8% más económico) |
| Escenario B: Cómputo Nodos (500 Nodos) | $1.684.000 USD | $1.385.000 USD | Cilium elimina 20.000 proxies sidecar en el clúster |
| Escenario B: Egress y Conectividad Multiclúster | $285.000 USD | $148.000 USD | Cilium Cluster Mesh y DSR ahorran $137.000 USD |
| Escenario B: Licenciamiento Enterprise SLA | $360.000 USD (Tigera Enterprise) | $390.000 USD (Isovalent Enterprise) | Tigera ofrece modelos por nodo ligeramente más flexibles |
| Escenario B: Mano de Obra Operativa (SRE) | $324.000 USD (0.60 dedicación SRE) | $216.000 USD (0.40 dedicación SRE) | Automatización de flujos ahorra 400+ hrs de SRE/año |
| TCO Total Acumulado (Escenario B) | $2.653.000 USD | $2.139.000 USD | Cilium ahorra $514.000 USD (19.4% más económico) |
12. Ciberseguridad Empresarial, Gobernanza y Multitenancy
Las industrias fuertemente reguladas —como los servicios financieros (PCI-DSS v4.0.1), el sector sanitario (HIPAA) y la defensa gubernamental (SOC 2 Type II, NIST SP 800-190)— exigen aislamiento estricto entre cargas de trabajo y registros de auditoría demostrables ante peritajes forenses.
PCI-DSS v4.0.1: Aislamiento del Entorno de Datos de Tarjetas (CDE)
El Requisito 1.2 de la normativa PCI-DSS exige que las conexiones entre el Entorno de Datos de Tarjetas de Pago (CDE) y el resto de la red corporativa estén estrictamente limitadas a flujos autorizados por el negocio.
- Evidencia Criptográfica en Cilium: Cilium asigna identidades numéricas a cada pod en función de etiquetas validadas criptográficamente por Kubernetes. Dado que el filtrado se efectúa mediante mapas eBPF en el kernel, Cilium imposibilita ataques de suplantación de IP (IP spoofing). Adicionalmente, Hubble exporta flujos JSON firmados directamente a sistemas SIEM (Splunk, Datadog), suministrando a los auditores pistas de auditoría continuas.
- Gobernanza Jerárquica en Calico: Calico destaca en entornos bancarios por sus niveles jerárquicos de políticas. Un "Tier de Cumplimiento Normativo" inmutable puede forzar el bloqueo global de salidas no autorizadas en todos los namespaces del CDE, imposibilitando que los equipos de desarrollo expongan accidentalmente bases de datos mediante políticas locales permisivas.
Arquitectura Zero Trust: Identidad por Encima de Direcciones IP
En clústeres dinámicos de Kubernetes, las direcciones IP son efímeras y se reciclan entre pods en cuestión de segundos. Diseñar la seguridad confiando en listas de IPs fijas contradice los principios básicos de Zero Trust. Tanto Cilium como Calico desacoplan la identidad de las direcciones IP:
- Identidades de Seguridad en Cilium: Cilium sintetiza los metadatos de las etiquetas en enteros de identidad de 32 bits. Cuando el Pod A transmite datos al Pod B, el plano de datos eBPF valida la identidad de origen contra la identidad de destino en memoria del kernel en nanosegundos.
- Identificadores de Endpoint en Calico: Felix gestiona endpoints dinámicos asociados a las cuentas de servicio (ServiceAccounts) y namespaces de Kubernetes, verificando los estados de conexión en mapas ipset sincronizados.
13. Guía de Migración Cero Downtime: de Calico a Cilium
Migrar un clúster Kubernetes empresarial en producción desde Calico iptables hacia Cilium eBPF sin interrumpir los servicios requiere una estrategia planificada de sustitución progresiva de grupos de nodos (blue/green rolling replacement).
Lista de Verificación Arquitectónica Previa
- Validar la Versión del Kernel Linux: Verifica que todos los nodos ejecuten un kernel Linux ≥ 5.10 LTS (comprobar con
uname -r). Asegura el montaje del sistema de archivos BPF (mount | grep /sys/fs/bpf). - Alineación de MTU: Si migras desde Calico BGP directo (MTU 1500) hacia Cilium con encapsulación Geneve, configura la MTU de Cilium en 1450 bytes para reservar los 50 bytes de la cabecera del túnel y evitar fragmentación de paquetes.
- Traducción de Políticas: Convierte las políticas
GlobalNetworkPolicyde Calico al estándar de Kubernetes o al formatoCiliumClusterwideNetworkPolicyempleando herramientas automáticas de conversión de políticas de código abierto.
Procedimiento de Migración Secuencial
- Desplegar Cilium en Modo de Encadenamiento o Reposo: Instala Cilium mediante Helm con
cni.chainingMode: generic-vetho instálalo junto a Calico en un grupo de nodos secundario aislado. - Aprovisionar Grupos de Nodos Limpios: Levanta un nuevo grupo de nodos de trabajo secundarios configurados con Cilium como CNI exclusivo (incorporando
kubeProxyReplacement: true). - Acordonar y Drenar Nodos Antiguos: Aplica de forma controlada
kubectl cordon <nodo-antiguo>seguido dekubectl drain <nodo-antiguo> --ignore-daemonsets --delete-emptydir-data. Los pods finalizarán ordenadamente y se reprogramarán en los nodos operados por Cilium. - Verificar Enrutamiento de Servicios y Flujos en Hubble: Confirma que el tráfico de servicios e ingress se encamina con normalidad a través de los sockets BPF auditando los eventos en vivo:
hubble observe --follow. - Desmantelar el DaemonSet de Calico: Una vez que la totalidad de los pods se ejecutan en nodos gobernados por Cilium, desinstala los manifiestos de Calico (
calico-node,calico-kube-controllers) y destruye los nodos antiguos.
14. Marco de Decisión y Veredicto Arquitectónico
Tanto Cilium como Project Calico representan la cima técnica de las redes en contenedores corporativos. La elección adecuada depende de la infraestructura física subyacente, la versión de los kernels y la hoja de ruta de mallas de servicios:
Implementa Cilium Si:
- Ejecutas clústeres en nubes administradas (AWS EKS, GCP GKE Datapath V2, Azure AKS) o nubes privadas modernas con Kernel Linux ≥ 5.10+.
- Buscas suprimir kube-proxy y erradicar la saturación de las tablas conntrack mediante balanceo en la capa de sockets.
- Requieres una malla de servicios ambient sin sidecars para evitar el despilfarro de memoria RAM asociado a miles de contenedores auxiliares.
- Priorizas observabilidad profunda de Capa 3 a 7, grafos de dependencias en tiempo real y diagnóstico de resoluciones DNS mediante Hubble sin coste adicional de licencias.
- Tus arquitecturas gestionan decenas de miles de reglas de seguridad dinámicas donde la degradación de latencia de iptables resulta inadmisible.
Implementa Project Calico Si:
- Gestionas centros de datos físicos bare-metal que requieren peering BGP directo con conmutadores Top-of-Rack (ToR) y telas spine-leaf.
- Operas clústeres heterogéneos mixtos que combinan nodos Linux y Windows Server.
- Tu infraestructura depende de distribuciones Linux corporativas tradicionales (RHEL 7/8, CentOS) con kernels antiguos (< 5.4) donde eBPF no está soportado.
- Necesitas niveles jerárquicos de políticas (tiers) estrictos para impedir que los equipos de desarrollo alteren directivas de seguridad corporativas.
- Exiges cifrado IPsec por hardware con certificación FIPS 140-2/3 para cumplir auditorías en banca o defensa gubernamental.
15. Preguntas Frecuentes (FAQ)
Si bien el modo de plano de datos eBPF de Calico incrementa sustancialmente el rendimiento de paquetes y permite Direct Server Return (DSR) en comparación con iptables tradicional, fue diseñado como una adaptación retroactiva sobre una arquitectura originalmente concebida en torno a Felix, BIRD y tablas de enrutamiento Linux. Cilium nació desde el primer día estructurado en torno al motor eBPF del kernel Linux. Cilium proporciona redirección a nivel de socket (sockops) más profunda, observabilidad de flujos L7 integrada con Hubble, malla de servicios ambient sin sidecars con Envoy compartido por nodo y mTLS transparente. El modo eBPF de Calico sigue siendo una alternativa junto a iptables y Windows HNS, requiriendo compromisos en integración BGP y herramientas operativas.
Sí. Cuando se despliega con kubeProxyReplacement: true, Cilium elude el framework netfilter de Linux y prescinde de kube-proxy por completo. La traducción de servicios (ClusterIP, NodePort, LoadBalancer, ExternalIPs) se efectúa directamente a nivel de socket (hooks cgroup2 sockops connect y sendmsg) y en las capas traffic control (tc) ingress/egress mediante mapas BPF. El nodo puede mantener un conjunto mínimo de cadenas iptables para firewalls de host de terceros, pero el enrutamiento de servicios y la aplicación de políticas de red en Kubernetes eluden netfilter y nf_conntrack al 100%, eliminando la saturación de tablas conntrack y las interrupciones softirq en la CPU.
Cilium Service Mesh ejecuta Envoy como un demonio compartido por nodo de trabajo en lugar de inyectar un contenedor Envoy en cada pod de aplicación. El agente cilium-agent administra las configuraciones de los listeners de Envoy dinámicamente. El tráfico de Capa 4 (TCP/UDP) se procesa íntegramente en el kernel mediante programas eBPF, redirigiendo únicamente el tráfico de Capa 7 (HTTP, gRPC, TLS) al listener local de Envoy mediante redirección directa de socket. Si el proceso Envoy del nodo se reinicia, el kernel eBPF detecta el fallo del socket y aplica paso directo L4 o retiene brevemente las conexiones entrantes mientras systemd o Kubernetes reinician el contenedor de Envoy en menos de 400 milisegundos. Además, el tráfico L4 y los pods sin políticas L7 permanecen totalmente inalterados.
La integración madura de Calico con el demonio BIRD BGP permite que los nodos de Kubernetes actúen como altavoces BGP completos conectándose directamente con conmutadores Top-of-Rack (ToR), telas spine-leaf de centros de datos y routers de núcleo de hardware (Cisco Nexus, Arista EOS, Juniper Junos). En infraestructuras bare-metal de alto rendimiento, Calico anuncia rangos IP de pods directamente a través de la red física sin cabeceras de encapsulación VXLAN o Geneve, preservando la MTU estándar de 1500 o 9000 bytes y habilitando balanceo ECMP (Equal-Cost Multi-Path) por hardware a velocidad de cable. Aunque Cilium dispone de un plano de control BGP basado en GoBGP, el historial de más de una década de Calico en redes físicas ofrece una fiabilidad comprobada inigualable para ingenieros de redes corporativas.
Para ejecutar Cilium en modo de producción completo (reemplazo de kube-proxy, balanceo a nivel de socket, trazabilidad L7 con Hubble y enrutamiento directo en host), se requiere como mínimo Linux Kernel 5.10 LTS, siendo altamente recomendado Linux Kernel 6.1+ o 6.8+ para aprovechar ring buffers BPF, fuentes de reloj ktime locales y redirección de sockets con cero copias. Para Calico en modo tradicional de iptables, es compatible con kernels antiguos desde Linux 3.10+ o 4.14+, lo que convierte a Calico en la opción estándar para distribuciones empresariales heredadas (RHEL 7/8). Para el modo eBPF opcional de Calico, se requiere Linux Kernel 5.4+ como base, recomendándose 5.10+.
Tanto Cilium como Calico aprovechan el módulo criptográfico nativo de WireGuard en el kernel Linux (utilizando los cifrados ChaCha20-Poly1305 y Curve25519) para ofrecer cifrado de tráfico pod-a-pod de nodo a nodo. En Calico, el demonio Felix genera el par de claves pública/privada de WireGuard en cada nodo, registra la clave pública en el recurso Calico Node y vigila los nodos pares del clúster para establecer los túneles. En Cilium, cilium-agent genera el par de claves, anota el objeto Kubernetes Node con la clave pública y programa mapas de enrutamiento BPF locales para dirigir el tráfico inter-nodo a través de la interfaz cilium_wg0. El protocolo WireGuard gestiona el handshake automatizado y la rotación dinámica de claves cada pocos minutos a nivel de kernel sin intervención manual de los agentes CNI.
José Andrade
Fundador & Editor PrincipalArquitecto e investigador especializado en conectividad de Kubernetes, rendimiento del kernel Linux con eBPF y modelos de costos de infraestructura en la nube. José lidera CloudBizStack, aportando comparativas cuantitativas y análisis estructurales de FinOps para sistemas informáticos de misión crítica.