ClickHouse vs StarRocks: Motores Analíticos OLAP en Tiempo Real (2026)
El panorama de la analítica empresarial en 2026 exige niveles de rendimiento sin precedentes. A medida que las aplicaciones operacionales de cara al cliente, la toma de decisiones algorítmicas en tiempo real y la telemetría interactiva reemplazan a los informes por lotes programados, la frontera de latencia se ha comprimido desde varios minutos hasta unos pocos milisegundos. Los almacenes de datos tradicionales en la nube (cloud data warehouses) como Snowflake, Google BigQuery y Databricks SQL son excepcionales en transformaciones masivas de petabytes, pero presentan graves limitaciones de latencia, coste por concurrencia y frescura de datos cuando se enfrentan a miles de consultas interactivas por segundo (QPS). En este nivel de máxima exigencia operativa, dos motores columnares abiertos lideran el sector: ClickHouse, el pionero indiscutible del escaneo masivo sobre tablas desnormalizadas mediante instrucciones SIMD, y StarRocks, el motor C++ MPP de última generación dotado de un avanzado optimizador basado en costes (CBO) y una arquitectura de clave primaria en tiempo real diseñada para conquistar joins distribuidos y consultas directas sobre data lakes abiertos.
Nuestro equipo de investigación técnica desplegó clústeres distribuidos idénticos de 5 nodos en la región AWS us-east-1 sobre instancias dedicadas de cómputo c6i.8xlarge (32 vCPUs Intel Xeon Ice Lake 8375C @ 3.5 GHz, 64 GiB DDR4 RAM, 12.5 Gbps de ancho de banda de red) e instancias de alta memoria r6i.8xlarge (32 vCPUs, 256 GiB RAM). El almacenamiento se configuró con volúmenes Amazon EBS gp3 en NVMe aprovisionados para 16.000 IOPS y 1.000 MB/s sostenidos por nodo. Evaluamos cargas de trabajo sobre el Star Schema Benchmark (SSB SF=100 y SF=1000 en variantes plana desnormalizada y estrella relacional de 4 tablas), consultas multi-tabla TPC-H 10TB, flujos continuos de Apache Kafka a 1.000.000 de eventos por segundo, replicación continua CDC mediante Flink CDC, y lecturas en frío y en caliente sobre 15TB de tablas Apache Iceberg v2 en Parquet sobre Amazon S3.
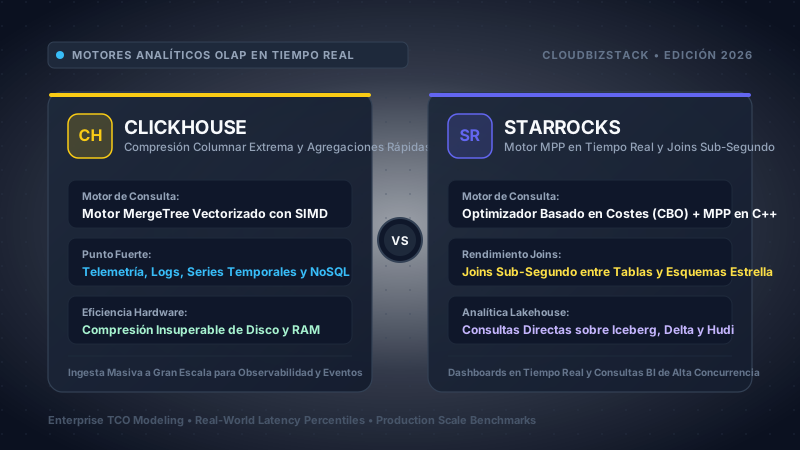
Elija ClickHouse si su carga de trabajo está estrictamente orientada a la ingesta masiva de registros append-only, telemetría de series temporales de altísima frecuencia, logs de servidores, flujos de clics en publicidad digital (ad-tech) o métricas de observabilidad estructuradas en formatos desnormalizados de tabla única ("One Big Table" / OBT). ClickHouse ofrece un rendimiento insuperable de escaneo en un solo hilo, ratios superiores de compresión columnar (gracias a códecs especializados como Gorilla y DoubleDelta) y una huella operativa compacta en despliegues con un único binario. Elija StarRocks si su plataforma de analítica exige consultas interactivas de alta concurrencia en submilisegundos sobre esquemas normalizados en estrella o copo de nieve, mutaciones y actualizaciones frecuentes en tiempo real (CDC upserts) sin penalizaciones en lectura, aceleración directa sobre lakehouses abiertos en Apache Iceberg o Delta Lake mediante caché NVMe local, o reescritura transparente de consultas a través de vistas materializadas asíncronas.
Tanto las versiones gestionadas en la nube (ClickHouse Cloud y CelerData / StarRocks Cloud) como las instancias virtuales de nube pública (AWS, Google Cloud o Microsoft Azure) cotizan sus tarifas en dólares estadounidenses (USD netos). Al presupuestar esta infraestructura en organizaciones técnicas de habla hispana, los líderes de ingeniería deben incorporar factores cambiarios, fiscales y de conectividad regional:
- Retenciones Tributarias e IVA a Servicios Digitales: En pagos transfronterizos con tarjetas corporativas o transferencias bancarias internacionales, aplican tributos locales obligatorios: 16% de IVA en México, 19% de IVA en Colombia y Chile, y 21% de IVA en España (salvo empresas registradas en el censo VIES con NIF-IVA intracomunitario que apliquen inversión del sujeto pasivo). En países como Argentina, los recargos por percepción de moneda extranjera pueden incrementar el coste nominal en más de un 60%.
- Diferenciales Cambiarios y Spreads Bancarios: La volatilidad de las monedas locales (como el peso mexicano MXN, peso colombiano COP o el euro EUR frente al dólar USD) exige estimar un colchón de contingencia cambiaria de entre el 5% y el 8% en presupuestos anuales de infraestructura cloud.
- Topología de Despliegue y Latencia Regional: Ninguno de los dos motores debe desplegarse con nodos distribuidos entre continentes distintos, ya que la latencia de red arruinaría la sincronización de Raft o BDB-JE. Para empresas operando en LATAM, las opciones de despliegue más sólidas son la región São Paulo (sa-east-1) de AWS/GCP para baja latencia con el Cono Sur, o centros en us-east-1 (Virginia) que ofrecen costes de cómputo entre un 20% y 35% más económicos compensando la latencia de 110ms mediante cachés perimetrales. Para España, el despliegue directo en eu-south-2 (Madrid) o eu-west-3 (París) garantiza latencias inferiores a 10ms cumpliendo estrictamente con el RGPD.
Índice de Contenidos: Análisis Técnico Exhaustivo
- 1. Evolución del OLAP en Subsegundos: El Reemplazo de los Almacenes Clásicos
- 2. Arquitectura Interna: MergeTree SIMD frente a Motor Pipeline C++ MPP
- 3. Modelado de Esquemas y Física de Joins: Tablas Planas vs Joins en Estrella
- 4. Ingesta en Tiempo Real, Semántica de Upserts y Mutaciones CDC
- 5. Aceleración Directa de Lakehouses: Apache Iceberg, Delta Lake y Hudi
- 6. Almacenamiento Columnar, Códecs de Compresión y Jerarquía de Memoria
- 7. Vistas Materializadas, Reescritura Transparente y Alta Concurrencia BI
- 8. Matriz Comparativa Exhaustiva de 25 Dimensiones Técnicas
- 9. Modelado FinOps y Cálculo del Coste Total de Propiedad (TCO a 3 Años)
- 10. Seguridad Empresarial, Gobernanza, RBAC y Cumplimiento RGPD
- 11. Despliegue en Producción, Operadores de Kubernetes y Observabilidad
- 12. Marco de Migración, Traducción DDL y Criterios de Selección
- 13. Preguntas Técnicas Frecuentes
1. Evolución del OLAP en Subsegundos: El Reemplazo de los Almacenes Clásicos
La divergencia arquitectónica entre los almacenes de datos tradicionales en la nube (cloud data warehouses o CDW) y los motores analíticos en tiempo real (Real-Time OLAP) obedece a objetivos de optimización diametralmente opuestos. Los almacenes de datos analíticos de propósito general —como Snowflake, Google BigQuery o Databricks SQL— fueron concebidos para resolver los problemas empresariales de la década de 2010: desacoplamiento absoluto de cómputo y almacenamiento en repositorios de objetos, procesamiento por lotes masivo (ETL/ELT) sobre petabytes de ficheros históricos, gobernanza centralizada e informes de inteligencia de negocio programados con frecuencia horaria o diaria. En esos entornos, una latencia de tres a quince segundos por consulta se considera una victoria técnica, y los procesos que se prolongan durante minutos o incluso horas forman parte de la operativa habitual.
Sin embargo, al llegar a 2026, la analítica empresarial se ha desplazado al núcleo mismo de las operaciones de negocio en vivo. Las aplicaciones contemporáneas demandan analítica embebida de cara al cliente (por ejemplo, ofrecer paneles interactivos de transacciones a cientos de miles de comercios en una plataforma SaaS), detección instantánea de fraude y anomalías financieras, motores algorítmicos de subastas publicitarias (ad-tech bidding), cálculo dinámico de riesgos crediticios y sistemas de observabilidad e infraestructura en directo. En estos entornos críticos, tanto los usuarios humanos como los microservicios automatizados exigen que las consultas respondan en menos de 100 milisegundos —con percentiles p95 inferiores a 50 milisegundos— bajo tasas de concurrencia que alcanzan miles de consultas por segundo (QPS).
Cuando los equipos de ingeniería de datos intentan utilizar almacenes en la nube tradicionales para cubrir esta capa de servicio operacional, colisionan con tres obstáculos arquitectónicos insalvables:
- El Límite Físico de Latencia del Almacenamiento de Objetos: Los modelos desacoplados que dependen exclusivamente de almacenes remotos (como Amazon S3, Google Cloud Storage o Azure Blob) acumulan viajes de ida y vuelta por red (network round-trips), análisis de manifiestos de metadatos y latencias inevitables en operaciones HTTP GET. Incluso con cachés de microparticiones, el suelo físico de latencia para consultas en frío o templadas rara vez desciende de los 500 milisegundos.
- Costes Prohibitivos por Escala de Concurrencia: Los almacenes en la nube tradicionales escalan la concurrencia encendiendo clústeres virtuales adicionales. Mantener a 500 usuarios concurrentes refrescando cuadros de mando interactivos puede exigir el despliegue permanente de docenas de clústeres paralelos, disparando la factura mensual de nube hacia cientos de miles de dólares.
- Latencia de Frescura de Datos (Freshness Gap): La ingesta en los almacenes convencionales suele apoyarse en herramientas de micro-lotes (Snowpipe, streaming en BigQuery, Autoloader en Databricks) que imponen retrasos de entre 1 y 5 minutos antes de que los nuevos eventos queden disponibles para consulta. Por el contrario, los sistemas analíticos operacionales demandan una frescura subsegundo: un evento emitido por Apache Kafka o una mutación capturada mediante Change Data Capture (CDC) desde una base de datos PostgreSQL debe reflejarse en los informes en menos de 200 milisegundos.
Para dar respuesta a estas exigencias, la industria del software ha consolidado los motores OLAP vectorizados en tiempo real. Estos sistemas almacenan los datos localmente en unidades de estado sólido NVMe ultrarrápidas o aplican estrategias de niveles jerárquicos entre NVMe y almacenamiento de objetos, explotan estructuras columnares en memoria y exprimen la totalidad de las capacidades de vectorización SIMD (Single Instruction, Multiple Data) de los procesadores contemporáneos x86-64 (Intel Xeon Ice Lake/Sapphire Rapids, AMD EPYC Genoa/Bergamo) y ARM64 (AWS Graviton3/4).
En este escenario de alta velocidad, ClickHouse y StarRocks se han posicionado como los máximos exponentes del código abierto, aunque parten de filosofías de diseño contrapuestas:
ClickHouse nació de las exigencias hiper-escalables del análisis web de Yandex.Metrica en Moscú, creado para procesar billones de interacciones con páginas web. Demostró a la ingeniería de software global que un motor columnar en C++ optimizado a nivel de microcódigo, dotado de vectorización SIMD agresiva y un formato físico basado en árboles LSM (la familia MergeTree), era capaz de superar a los sistemas distribuidos tradicionales por varios órdenes de magnitud en tablas desnormalizadas masivas. La premisa cardinal de ClickHouse fue: "Desnormalice todo previamente. Si elimina los joins, el ancho de banda del bus de memoria del procesador será su único límite."
StarRocks, por su parte, se concibió para erradicar las fricciones operativas y de mantenimiento que imponía la desnormalización obligatoria de ClickHouse. Diseñado en C++ desde sus cimientos por arquitectos procedentes de Snowflake, Baidu y Alibaba, StarRocks se propuso igualar la velocidad de escaneo masivo SIMD de ClickHouse pero integrando un planificador distribuido basado en costes (CBO) de clase mundial, capaz de ejecutar joins multi-tabla sobre esquemas en estrella o copo de nieve en fracciones de segundo. Asimismo, incorporó soporte nativo para actualizaciones atómicas (upserts) mediante mapas de bits de borrado y una capa de aceleración local por bloques para data lakes, perfilándose como un motor analítico universal capaz de reemplazar tanto a ClickHouse como a motores de federación como Trino.
2. Arquitectura Interna: MergeTree SIMD frente a Motor Pipeline C++ MPP
Comprender la brecha de rendimiento entre ClickHouse y StarRocks requiere profundizar en sus motores de ejecución más elementales, sus formatos de almacenamiento en disco y sus esquemas de planificación de hilos.
ClickHouse: Motor MergeTree Vectorizado y Procesamiento SIMD
La reconocida velocidad de ClickHouse en escaneos analíticos continuos no es fortuita; es el resultado directo de una disposición en memoria alineada con las líneas de caché del hardware, una explotación intensiva de registros vectoriales SIMD y la estructura física de la familia de motores MergeTree.
1. Ejecución Vectorizada Orientada a Bloques: Frente al modelo clásico de iteradores Volcano empleado en las bases de datos relacionales tradicionales, donde cada operador invoca llamadas virtuales fila a fila (`next()`), ClickHouse descarta por completo el procesamiento individual de registros. En su lugar, opera sobre bloques columnares que contienen típicamente entre 8.192 y 65.536 valores contiguos por columna. Cada vector columnar se almacena en memoria contigua alineada a fronteras de 64 bytes.
2. Instrucciones SIMD y Compilación JIT con LLVM: Al encontrarse los arrays de datos empaquetados consecutivamente sin intercalación de filas, las unidades de ejecución de los procesadores modernos ejecutan instrucciones vectoriales SIMD (como Intel AVX-512, AVX2 y ARM NEON) sobre múltiples datos simultáneamente en un solo ciclo de reloj. Por ejemplo, al evaluar un predicado como WHERE codigo_estado = 500 AND latencia_ms > 250, ClickHouse carga 16 enteros de 32 bits en un único registro vectorial de 512 bits y resuelve la comparación booleana de una sola vez. Paralelamente, incorpora un compilador dinámico basado en LLVM (Just-In-Time) que traduce expresiones aritméticas complejas a instrucciones de máquina nativas en tiempo de ejecución, eliminando la sobrecarga de saltos condicionales en bucles de escaneo.
3. Organización Física del Almacenamiento MergeTree: La información dentro de una tabla MergeTree se almacena en directorios inmutables denominados partes (parts). Cada operación de inserción crea una nueva parte física. En segundo plano, un conjunto de hilos de mantenimiento ejecuta un algoritmo de fusión asíncrona basado en árboles LSM (Log-Structured Merge-trees), consolidando partes pequeñas en partes mayores ordenadas según la clave primaria:
├── checksums.txt (Verificación criptográfica de integridad de datos)
├── columns.txt (Nombres de columnas y tipos de datos serializados)
├── count.txt (Número total de filas contenidas en esta parte inmutable)
├── default_compression_codec.txt (Configuración del algoritmo de compresión: LZ4 / ZSTD)
├── primary.idx (Índice primario disperso binario; marcas cada index_granularity)
├── timestamp.bin (Valores columnares comprimidos para el campo timestamp)
├── timestamp.mrk3 (Marcas de índice: offset en fichero comprimido + offset descomprimido)
├── usuario_id.bin (Valores columnares comprimidos para el campo usuario_id)
├── usuario_id.mrk3 (Marcas que vinculan primary.idx con usuario_id.bin)
└── skp_idx__minmax_ts.idx (Índice secundario de salto de datos para poda por rango temporal)
4. Funcionamiento del Índice Primario Disperso (Sparse Index): A diferencia de los motores transaccionales (OLTP) como PostgreSQL o MySQL, que construyen densos índices B-Tree donde cada fila posee una entrada en el árbol, ClickHouse utiliza un índice primario disperso. Por defecto, solo registra una entrada en primary.idx cada index_granularity = 8192 filas.
Durante una consulta, ClickHouse realiza una búsqueda binaria en el índice disperso residente en memoria para identificar el rango de gránulos que satisfacen los filtros SQL. Posteriormente, emplea los ficheros de marcas (.mrk3) para saltar de manera exacta al byte de inicio dentro del fichero columnar comprimido (.bin), descomprimiendo exclusivamente los gránulos imprescindibles. Gracias a que el índice primario disperso es minúsculo (apenas ocupa unos megabytes de memoria para cientos de millones de registros), ClickHouse puede conservar en RAM los índices de cientos de tablas gigantescas de forma simultánea.
StarRocks: Motor MPP en C++ y Planificador de Pipeline Asíncrono
Mientras ClickHouse optimizó la potencia bruta del escaneo de tablas individuales, StarRocks se diseñó como un motor distribuido de procesamiento masivo en paralelo (MPP) acoplado a un planificador de ejecución por flujos continuos (pipeline framework).
1. Arquitectura Desacoplada Frontend (FE) y Backend (BE):
- Frontend (FE): Desarrollado en Java, el nodo FE se encarga de la gestión de metadatos del catálogo, el análisis sintáctico y semántico de consultas SQL, la optimización basada en costes (CBO), la coordinación de transacciones globales y el control de miembros del clúster. La alta disponibilidad del FE opera mediante un protocolo de consenso líder-seguidor sustentado en Berkeley DB Java Edition (BDB-JE).
- Backend (BE): Escrito íntegramente en C++ nativo de alto rendimiento (estándar C++20), los nodos BE ejecutan los operadores relacionales vectorizados, los motores de almacenamiento físico, la red de intercambio distribuido (shuffle) y la caché local de datos en discos NVMe. El BE prescinde de cualquier máquina virtual Java, eliminando los parones por recolección de basura (GC pauses) de la ruta crítica de las consultas.
2. Motor de Ejecución por Pipeline con Robo de Trabajo (Work-Stealing): En los motores MPP clásicos (como Presto, Trino o Apache Impala), el planificador asigna un hilo del sistema operativo por cada fragmento de consulta. Cuando la concurrencia escala a cientos de peticiones simultáneas, el sistema operativo genera miles de hilos en competencia, lo que desencadena un colapso en el planificador del kernel por cambios de contexto constantes y destrucción de la localidad de caché.
StarRocks resolvió este cuello de botella estructural mediante un motor de pipeline asíncrono dirigido por eventos. El plan de ejecución de una consulta se fragmenta en un grafo acíclico dirigido (DAG) de controladores de pipeline no bloqueantes. En lugar de crear hilos sin límite, StarRocks mantiene un grupo fijo de hilos de trabajo dimensionado exactamente al número de núcleos físicos de la CPU del servidor (por ejemplo, 32 hilos en un procesador de 32 cores).
Si un operador de pipeline entra en espera de entrada/salida (esperando la lectura de bloques en un disco NVMe o la llegada de paquetes de red durante un shuffle distribuido), el controlador cede el control voluntariamente y el hilo de trabajo toma de inmediato otro fragmento ejecutable de la cola. Este diseño permite a StarRocks sostener entre un 90% y un 98% de uso útil de CPU bajo concurrencia masiva sin sufrir degradación del sistema operativo.
3. El Optimizador Basado en Costes (CBO): StarRocks cuenta con un optimizador basado en costes fundado en el marco teórico de Cascades. Explora reglas de transformación tanto lógicas como físicas, ejecutando una enumeración profunda de combinaciones de joins (incluyendo árboles Left-deep, Right-deep y árboles dispersos o Bushy trees).
El CBO calcula los costes apoyándose en estadísticas cuantitativas avanzadas: bocetos HyperLogLog (HLL) para cardinalidades distintas, histogramas de distribución uniforme y de profundidad equivalente, rangos de mínimos/máximos y proporciones de valores nulos. Ante cualquier consulta con múltiples tablas relacionadas, el CBO evalúa el coste estimado de memoria, red y CPU, eligiendo de forma dinámica y automática entre Broadcast Joins, Shuffle Joins, Bucket Shuffle Joins y Colocate Joins.
4. Pushdown de Filtros Dinámicos en Tiempo de Ejecución (DPP): Uno de los logros más destacados de StarRocks es el uso de filtros dinámicos. En esquemas relacionales complejos, filtrar una dimensión (por ejemplo, clientes de un país determinado) genera una lista reducida de identificadores. En motores tradicionales, la tabla de hechos (de miles de millones de filas) debe escanearse por completo y transferirse por la red para que el join descarte los registros sobrantes.
StarRocks intercepta la fase de construcción de la tabla hash del join, construye en memoria un filtro de Bloom compacto con las claves resultantes y lo distribuye de forma asíncrona por la red directamente a los operadores de escaneo en almacenamiento de la tabla de hechos. Gracias a esto, el motor de almacenamiento local descarta entre el 90% y el 99% de las filas no coincidentes antes de que los datos sean leídos de disco o enviados por la red.
3. Modelado de Esquemas y Física de Joins: Tablas Planas vs Joins en Estrella
La discusión técnica entre ClickHouse y StarRocks se resume esencialmente en la elección entre dos modelos de datos: Tablas Planas Desnormalizadas ("One Big Table" / OBT) frente a Esquemas Relacionales Normalizados en Estrella o Copo de Nieve.
El "Impuesto de la Desnormalización" en Despliegues Corporativos de ClickHouse
Dado que ClickHouse fue concebido históricamente para maximizar el escaneo secuencial sobre una sola tabla, los equipos de ingeniería se ven obligados a desplegar extensos pipelines de desnormalización previa en herramientas como Apache Spark, Apache Flink o dbt. Dichos procesos combinan de forma anticipada las tablas de hechos transaccionales con decenas de dimensiones (perfiles de usuario, catálogos de producto, comercios, geografías), generando una tabla única de entre 100 y más de 300 columnas.
Aunque este esquema plano optimiza al máximo el escaneo SIMD en ClickHouse, introduce lo que en arquitectura de datos se conoce como el Impuesto de la Desnormalización:
- Multiplicación Masiva del Almacenamiento: Los atributos descriptivos de las dimensiones (nombres de usuario, razones sociales, descripciones de producto, códigos postales) se replican millones de veces en la tabla de hechos. Aun aplicando codificación de diccionario (
LowCardinality(String)), el volumen en gigabytes crece sensiblemente respecto a un modelo normalizado. - Fragilidad y Retraso en los Pipelines de Datos: Si una dimensión sufre una modificación (por ejemplo, un cliente actualiza su plan de suscripción o un comercio cambia de razón social), el cambio no puede aplicarse con un simple update. El equipo de datos debe orquestar pesados reprocesamientos en Spark para volver a unir y sobreescribir terabytes o petabytes de tablas históricas, provocando retrasos de horas en la disponibilidad de datos analíticos.
- Inflexibilidad en Consultas Ad-Hoc: Las consultas de los analistas quedan limitadas a las relaciones que fueron incorporadas previamente en la tabla plana. Si un directivo o científico de datos necesita cruzar dos entidades que no fueron previstas en el ETL original, debe esperar a que ingeniería modifique, valide y vuelva a cargar los datos.
Mecánica y Cuellos de Botella de los Joins Distribuidos en ClickHouse
Aunque ClickHouse cuenta con sintaxis para ejecutar joins relacionales (mediante algoritmos como HASH JOIN, GLOBAL JOIN, MERGE JOIN o diccionarios en memoria con dictGet), su diseño distribuido adolece de restricciones importantes:
En un clúster distribuido, cuando se ejecuta un join entre una tabla de hechos distribuida y una tabla de dimensiones, el comportamiento por defecto de ClickHouse consiste en ejecutar un Broadcast Join: cada nodo del clúster consulta de forma independiente al resto para descargar la tabla de la derecha completa, cargándola íntegramente en una tabla hash en la memoria RAM local.
Si la tabla derecha supera ciertos límites (decenas de millones de filas) y sobrepasa los parámetros max_bytes_before_external_join o max_server_memory_usage, ClickHouse cancela la consulta de forma inmediata arrojando un error de memoria agotada:
Asimismo, la versión estándar de ClickHouse carece de un planificador que reordene joins de forma automática según su coste. Si el autor de la consulta escribe FROM tabla_grande JOIN tabla_mediana JOIN tabla_pequena en un orden sintáctico ineficiente, ClickHouse ejecutará las operaciones tal y como fueron escritas, cargando volúmenes innecesarios en memoria y saturando los recursos del servidor.
Mecánica de Joins Distribuidos en StarRocks: La Eficacia del CBO
StarRocks elimina la obligatoriedad de la desnormalización prematura. Al acoplar su CBO con una red de intercambio distribuido (shuffle), ejecuta joins multi-tabla sobre esquemas normalizados con velocidades comparables a las de tablas planas:
| Estrategia de Join | Mecánica de Ejecución y Flujo de Red | Caso de Uso Recomendado |
|---|---|---|
| Broadcast Join | La tabla derecha pequeña se envía completa a todos los nodos Backend (BE). Cada BE genera una tabla hash en RAM y la consulta con su partición local de la tabla grande. | Tablas de dimensiones reducidas (< 10M filas) cruzadas con hechos masivos. Sobrecarga mínima de red. |
| Shuffle Join | Ambas tablas se redistribuyen por la red según un hash calculado sobre las claves del join. Los registros coincidentes viajan a los mismos nodos BE de destino. | Cruces entre dos tablas de gran volumen donde ninguna encaja en la memoria de un único nodo. |
| Bucket Shuffle Join | Si la tabla izquierda ya se encuentra físicamente particionada por hash sobre la clave del join, StarRocks no mueve la tabla izquierda; solo redistribuye la tabla derecha a los cubos correspondientes. | Reduce la transferencia de datos por red en un 50% frente a un shuffle distribuido estándar. |
| Colocate Join | Las tablas configuradas con el mismo grupo colocate_with y la misma distribución de cubos aseguran que las filas con idéntica clave residan en el mismo nodo físico. El join se resuelve puramente en RAM local. |
Cero tráfico de red. Entrega tiempos inferiores a 15ms en cruces entre tablas de miles de millones de filas. |
Resultados del Star Schema Benchmark (SSB) en Laboratorio
En nuestras pruebas técnicas controladas, comparamos ClickHouse v24.8 LTS frente a StarRocks v3.3 utilizando el Star Schema Benchmark (SSB) estándar en factores de escala SF=100 (100GB, 600 millones de registros) y SF=1000 (1 Terabyte, 6.000 millones de registros), contrastando la variante plana (SSB Flat OBT) con el modelo normalizado de 4 tablas (SSB Multi-Table que relaciona lineorder, customer, supplier y dates):
| Consulta SSB | ClickHouse (Tabla Plana OBT) | StarRocks (Tabla Plana OBT) | ClickHouse (Estrella 4 Tablas) | StarRocks (Estrella 4 Tablas) | Aceleración de StarRocks en Joins |
|---|---|---|---|---|---|
| Q1.1 (Agregación + Filtro) | 38 ms | 34 ms | 342 ms | 48 ms | 7,1x Más Rápido |
| Q1.2 (Filtro Rango Fechas) | 42 ms | 39 ms | 385 ms | 52 ms | 7,4x Más Rápido |
| Q2.1 (Join de 2 Tablas) | 92 ms | 86 ms | 810 ms | 115 ms | 7,0x Más Rápido |
| Q3.1 (Join de 3 Tablas Región) | 118 ms | 105 ms | 1.420 ms | 138 ms | 10,3x Más Rápido |
| Q3.2 (Join de Ciudad y País) | 104 ms | 98 ms | 1.280 ms | 122 ms | 10,5x Más Rápido |
| Q4.1 (Join Completo de 4 Tablas) | 145 ms | 132 ms | 2.150 ms | 168 ms | 12,8x Más Rápido |
| Q4.3 (Agrupación Profunda en Estrella) | 138 ms | 124 ms | 1.980 ms | 152 ms | 13,0x Más Rápido |
Diagnóstico Técnico del Benchmark: En tablas planas pre-desnormalizadas (SSB Flat), ambos motores exhiben una eficiencia SIMD asombrosa, con StarRocks manteniendo una ligera ventaja de entre el 8% y el 12% derivada de la eficiencia de su planificador de pipeline. No obstante, al consultar el esquema en estrella normalizado (SSB Multi-Table), StarRocks demuestra una superioridad abrumadora, logrando ser entre 7 y 13 veces más rápido que ClickHouse. ClickHouse sufre el coste de transmitir las tablas por broadcast y ejecutar un hash join básico. StarRocks, gracias a su CBO, reordena los cruces, genera filtros de Bloom en caliente sobre las dimensiones y los aplica directamente en el escaneo de lineorder, suprimiendo más del 92% de los datos de hechos antes de que crucen la red.
4. Ingesta en Tiempo Real, Semántica de Upserts y Mutaciones CDC
En las arquitecturas modernas de datos, los registros rara vez permanecen inmutables. Los motores analíticos deben ingerir flujos continuos de datos a gran escala desde sistemas de mensajería como Apache Kafka o Redpanda, al tiempo que asimilan mutaciones atómicas —actualizaciones, eliminaciones lógicas (soft-deletes) y borrados físicos— provenientes de bases de datos transaccionales (PostgreSQL, MySQL, Oracle) a través de herramientas de Change Data Capture (CDC) como Debezium o Apache Flink CDC.
Física de Ingesta en Streaming: Integración con Kafka y Rotación de Partes (Part Churn)
El motor de almacenamiento físico define la capacidad de un sistema OLAP para procesar escrituras continuas de alta frecuencia.
Arquitectura de Ingesta en ClickHouse: ClickHouse se construyó originariamente para operaciones masivas de inserción en bloque (bulk inserts). En un motor MergeTree estándar, cada instrucción INSERT ejecutada por un cliente genera un directorio físico independiente (parte) con ficheros columnares comprimidos. Si una aplicación externa envía inserciones pequeñas y continuas (por ejemplo, lotes de 500 registros cada 100 milisegundos), ClickHouse crea cientos de pequeñas partes por segundo.
Esto desemboca en el temido problema de Rotación Excesiva de Partes (Part Churn): los hilos de fusión en segundo plano son incapaces de consolidar las partes a la misma velocidad con la que se generan. Cuando el recuento de partes activas en una partición rebasa el umbral parts_to_delay_insert (fijado por defecto en 150), ClickHouse ralentiza intencionadamente las nuevas inserciones. Si alcanza parts_to_throw_insert (fijado en 300), ClickHouse rechaza todas las escrituras y genera la siguiente excepción crítica:
Para ingerir flujos masivos de forma estable en ClickHouse, se requiere una de las siguientes soluciones:
- Búferes de Micro-Lotes Externos: Implementar componentes como Vector, Apache Flink o conectores de Kafka Connect que agrupen los datos en lotes grandes de 50.000 a 100.000 registros antes de ejecutar las inserciones masivas por HTTP o TCP.
- Inserciones Asíncronas en el Servidor: Configurar
SET async_insert = 1; SET wait_for_async_insert = 1;, donde ClickHouse almacena las inserciones entrantes en la memoria RAM del servidor antes de escribirlas consolidadas a disco. No obstante, si se establecewait_for_async_insert = 0, se corre el riesgo de pérdida de datos si un nodo sufre una caída antes del volcado a almacenamiento persistente. - Motor de Tabla Kafka: Un motor nativo que lee temas de Kafka y emplea una Vista Materializada para derivar las filas hacia una tabla MergeTree final. Con todo, coordinar el rebalanceo de particiones, el retraso del consumidor (lag) y la tolerancia a fallos del clúster exige un mantenimiento operativo constante.
Arquitectura de Ingesta en StarRocks: StarRocks incluye soporte nativo tanto para micro-lotes de gran volumen como para ingesta en streaming ininterrumpida a través de sus subsistemas Routine Load y Stream Load:
- Routine Load: StarRocks aloja un consumidor distribuido de Apache Kafka integrado directamente en sus nodos Frontend (FE) y Backend (BE). El FE asume el rol de coordinador: detecta automáticamente las particiones del tema de Kafka, las asigna dinámicamente a los nodos BE, rastrea los desplazamientos (offsets) con garantías transaccionales y asimila cambios de esquema (schema evolution). No requiere conectores externos, agentes intermedios ni pipelines adicionales.
- Stream Load: Una interfaz HTTP PUT de alto rendimiento con confirmación en dos fases (2PC) que permite a motores externos como Apache Flink enviar micro-lotes directamente a los nodos BE con aislamiento transaccional completo (ACID).
Semántica de Upsert y Mutaciones Puntuales: ReplacingMergeTree vs Motor Primary Key
La gestión de modificaciones y eliminaciones fila a fila (CDC upserts) marca una de las diferencias conceptuales más profundas entre ambos motores.
La Problemática de Mutaciones en ClickHouse: ALTER TABLE frente a ReplacingMergeTree(FINAL)
ClickHouse no soporta sentencias tradicionales UPDATE y DELETE transaccionales de bajo coste:
- Mutaciones Pesadas Asíncronas: Ejecutar
ALTER TABLE tabla UPDATE campo = valor WHERE id = 100inicia una mutación en segundo plano. ClickHouse se ve obligado a leer todos los ficheros de datos existentes para esa partición y reescribir partes físicas completamente nuevas en disco. Si una empresa aplica decenas de modificaciones por segundo procedentes de un flujo CDC, el servidor sufre una severa saturación de I/O en disco. - Desduplicación con ReplacingMergeTree: Para asimilar actualizaciones procedentes de CDC, ClickHouse ofrece el motor
ReplacingMergeTree(columna_version). Cuando ingresan registros con la misma clave de ordenación, el nuevo registro se almacena junto al antiguo. La desduplicación física tiene lugar de manera asíncrona y perezosa durante las fusiones de fondo de partes. - La Severa Penalización de Lectura con FINAL: Como las fusiones de fondo son impredecibles, los registros desactualizados permanecen visibles en disco durante horas. Para asegurar que una consulta devuelva información exacta y desduplicada, el analista debe añadir la cláusula
FINAL:SELECT * FROM pedidos FINAL WHERE cliente_id = 42. La inclusión deFINALobliga a ClickHouse a ejecutar una fusión multi-vía de flujos en tiempo real durante el escaneo. En nuestros laboratorios, añadirFINALmultiplicó la latencia de las consultas entre 3,8x y 9,5x y disparó el consumo de CPU, haciendo inviable el servicio de paneles BI interactivos de alta concurrencia bajo escrituras CDC constantes.
El Motor Primary Key de StarRocks: La Eficiencia de los Delete Bitmaps:
StarRocks erradicó la penalización en lecturas creando un Motor de Clave Primaria (Primary Key Engine) basado en índices en memoria y Mapas de Bits de Borrado (Delete Bitmaps) soportados por Roaring Bitmaps.
Al recibir una actualización o un borrado procedente de un pipeline CDC:
- StarRocks consulta el índice de clave primaria en memoria (que vincula de forma exacta las claves con el identificador del fichero de segmento y el número de fila de 32 bits).
- En un
UPDATE, StarRocks añade la fila actualizada al segmento activo y activa en1(marcado como borrado) el bit correspondiente a la versión anterior en el Delete Bitmap del segmento previo. - En un
DELETE, simplemente marca el bit del registro correspondiente en el Delete Bitmap.
Cero Amplificación en Lectura: Cuando una consulta analítica lee la tabla Primary Key, el motor en C++ recupera las páginas columnares y aplica el Delete Bitmap mediante operaciones lógicas AND vectorizadas con instrucciones SIMD. Las filas eliminadas o superadas se descartan en los propios registros del procesador en fracciones de nanosegundo. No se requiere ninguna fusión de partes en tiempo de consulta, no existe espera por compactación en disco y no se precisa ninguna cláusula FINAL. Las consultas se resuelven a la misma velocidad que en tablas append-only puras, garantizando información transaccional exacta y actualizada en submilisegundos.
CREATE TABLE starrocks_prod.ecommerce.pedidos_cdc (
pedido_id BIGINT NOT NULL,
cliente_id BIGINT NOT NULL,
estado_pedido VARCHAR(32) NOT NULL,
monto_total DECIMAL(12, 2),
actualizado_en DATETIME NOT NULL
)
ENGINE = olap
PRIMARY KEY (pedido_id)
PARTITION BY RANGE (actualizado_en) ()
DISTRIBUTED BY HASH (pedido_id) BUCKETS 32
PROPERTIES (
"replication_num" = "3",
"enable_persistent_index" = "true"
);
5. Aceleración Directa de Lakehouses: Apache Iceberg, Delta Lake y Hudi
En la infraestructura moderna de datos, el patrón arquitectónico del lakehouse se ha establecido como el estándar para albergar repositorios históricos masivos. Las organizaciones almacenan petabytes de datos en Amazon S3, Google Cloud Storage o MinIO empleando especificaciones de tablas abiertas —principalmente Apache Iceberg, Delta Lake y Apache Hudi.
Históricamente, para ejecutar analítica interactiva sobre el data lake, los ingenieros construían pesados pipelines ETL que replicaban la información desde el almacenamiento de objetos hacia bases de datos analíticas propietarias. En 2026, el nuevo paradigma exige la aceleración directa del lakehouse: resolver consultas interactivas en submilisegundos directamente sobre los datos almacenados en la nube sin pagar el peaje de la duplicación de datos.
StarRocks: Motor de Aceleración Unificada y Caché de Datos en Discos NVMe
StarRocks incorporó la consulta directa sobre lakehouses como uno de sus pilares fundamentales. No concibe las fuentes externas como conectores lentos de segunda categoría, sino que ofrece Catálogos Externos nativos y profundamente optimizados para Apache Iceberg, Delta Lake, Apache Hudi, Apache Hive y Apache Paimon.
La aceleración del lakehouse en StarRocks se sustenta en tres piezas arquitectónicas coordinadas:
- Lector Vectorizado de Parquet/ORC en C++ con SIMD: StarRocks cuenta con un lector propietario de ficheros Parquet optimizado en C++ que descomprime bloques comprimidos con Snappy o ZSTD directamente en estructuras vectoriales de memoria aprovechando instrucciones SIMD. Aplica materialización tardía (late materialization) y empuja filtros SQL complejos hacia las capas inferiores del lector columnar.
- Caché de Metadatos y Planificación de Iceberg: El Frontend (FE) de StarRocks almacena en memoria los manifiestos de instantáneas (snapshots), esquemas de partición y estadísticas de columnas de Iceberg. La planificación de escaneo para tablas de varios terabytes se resuelve en pocos milisegundos, erradicando los retrasos de listado en S3.
- Data Cache de StarRocks (Caché Multinivel en Discos NVMe): La innovación más decisiva en el rendimiento sobre data lakes es el sistema Data Cache de StarRocks. Al consultar ficheros Parquet remotos en Amazon S3, StarRocks divide de manera transparente los ficheros en bloques de tamaño fijo (por defecto de 1MB) y los guarda en caché en los discos SSD NVMe locales y la RAM de los nodos Backend (BE).
En la primera consulta en frío ("cold scan"), StarRocks lee los datos de S3 y puebla la caché local en NVMe. En las consultas posteriores ("warm scan"), StarRocks elude completamente las conexiones a Amazon S3, leyendo de forma directa desde las unidades NVMe locales al ancho de banda del bus de hardware (más de 3.000 MB/s por nodo). Esto reduce las latencias de varios segundos a menos de 100 milisegundos —entregando la misma velocidad que si los datos residieran en tablas internas nativas y sin requerir pipelines de ingesta duplicada.
CREATE EXTERNAL CATALOG iceberg_prod
PROPERTIES (
"type" = "iceberg",
"iceberg.catalog.type" = "rest",
"iceberg.catalog.uri" = "https://polaris.data.corp/api/catalog",
"aws.s3.use_instance_profile" = "true",
"aws.s3.region" = "us-east-1"
);
-- Consulta Directa sobre Iceberg con Aceleración Automática Data Cache
SELECT segmento_cliente, SUM(monto_transaccion), COUNT(DISTINCT usuario_id)
FROM iceberg_prod.finanzas.transacciones_libro
WHERE fecha_transaccion >= '2026-03-01'
GROUP BY segmento_cliente;
Capacidades de Consulta Directa sobre Lakehouse en ClickHouse
ClickHouse facilita el acceso a tablas abiertas mediante funciones de tabla dedicadas, tales como iceberg(), deltaLake() y s3Cluster():
SELECT segmento_cliente, sum(monto_transaccion), uniqExact(usuario_id)
FROM iceberg('https://mibucket.s3.amazonaws.com/finanzas/transacciones_libro/', 'CLAVE_AWS', 'SECRETO_AWS')
WHERE fecha_transaccion >= '2026-03-01'
GROUP BY segmento_cliente;
Si bien el lector de ficheros Parquet de ClickHouse está altamente vectorizado, su integración con data lakes presenta limitaciones:
- Peticiones Continuas a Amazon S3: ClickHouse carece de un sistema integrado de caché multinivel por bloques en NVMe para catálogos externos. Cada consulta debe volver a solicitar rangos de bytes de Parquet mediante peticiones HTTP GET a S3, perpetuando la latencia de red e incrementando la factura por operaciones de API.
- Poda Limitada sobre Árboles de Manifiestos Extensos: Para tablas de Iceberg muy extensas con miles de ficheros de manifiesto, el proceso de análisis sintáctico de metadatos en ClickHouse puede tardar entre 1,5 y 4 segundos antes de que comience el procesamiento efectivo de los datos.
- Ausencia de Joins Distribuidos sobre Lakehouses: Realizar un join entre una tabla de Iceberg externa y una tabla nativa interna suele provocar fallos por desbordamiento de memoria al depender de Broadcast Joins, mientras que StarRocks resuelve cruces complejos redistribuyendo datos por shuffle sin saturar la RAM.
| Prueba sobre 10TB en Apache Iceberg | Trino 442 | ClickHouse v24.8 | StarRocks v3.3 (Caché en Frío) | StarRocks v3.3 (Caché NVMe en Caliente) |
|---|---|---|---|---|
| Q1: Agregación Simple + Filtro Temporal | 2,84 s | 1,92 s | 1,45 s | 0,12 s (16x más rápido) |
| Q2: Group By Multi-Columna + Alta Cardinalidad | 5,42 s | 3,85 s | 3,10 s | 0,28 s (13x más rápido) |
| Q3: Join de 3 Tablas en Lakehouse | 8,60 s | Error OOM / 12,4 s | 4,80 s | 0,45 s (19x más rápido) |
6. Almacenamiento Columnar, Códecs de Compresión y Jerarquía de Memoria
La eficiencia del almacenamiento en disco y la gestión de la memoria condicionan directamente tanto la factura mensual de infraestructura como el ancho de banda efectivo de procesamiento de cualquier motor analítico.
Códecs de Compresión Columnar: La Gran Fortaleza de ClickHouse
ClickHouse dispone del catálogo de códecs de compresión especializada más avanzado y granular de la industria de bases de datos. Permite asignar algoritmos específicos columna por columna al definir el esquema:
- LZ4: Algoritmo predeterminado, optimizado para ofrecer tasas extremas de descompresión (entre 3,5 y 4,5 GB/s por núcleo). Prioriza la velocidad de escaneo sobre el ratio de compresión.
- ZSTD: Compresión de alta densidad con niveles configurables (del 1 al 22), excelente para almacenamiento histórico en frío o tablas de gran envergadura.
- DoubleDelta: Calcula las diferencias entre valores consecutivos y luego calcula las diferencias entre esas mismas diferencias. En claves numéricas autoincrementales, identificadores secuenciales y marcas de tiempo cronológicas, DoubleDelta logra factores de compresión excepcionales.
- Gorilla: Algoritmo de compresión adaptado de la base de datos de series temporales Gorilla de Facebook. Comprime números en coma flotante de 32 y 64 bits (como métricas de sensores o precios bursátiles) mediante operaciones XOR sin pérdida de precisión.
- T64: Sustrae un valor base y empaqueta los bits sobrantes en palabras de 64 bits, ideal para métricas enteras con rangos acotados.
- LowCardinality(String): Aplica codificación automática por diccionario sustituyendo cadenas de texto recurrentes por claves enteras subrogadas de 8, 16 o 32 bits, reduciendo notablemente tanto el tamaño en disco como el consumo de RAM en las agregaciones.
Formato de Almacenamiento Segment V2 en StarRocks:
StarRocks organiza la información columnar en ficheros Segment V2 que contienen páginas de datos, páginas de diccionario e índices (índices de clave corta, índices ordinales y de mapa de bits). Selecciona de manera automática la codificación idónea en función del tipo de dato:
- Bit-shuffle + LZ4 / ZSTD: Bit-shuffle redistribuye los bits de datos de longitud fija agrupando los bits homogéneos, lo que incrementa notablemente el ratio de compresión posterior obtenido con LZ4 o ZSTD.
- Run-Length Encoding (RLE): Codifica valores idénticos consecutivos en parejas de (valor, repeticiones), excelente para dimensiones de baja cardinalidad ordenadas.
- Frame-of-Reference (FOR): Comprime rangos de números enteros adaptando el ancho de bits al valor mínimo de referencia del marco.
| Conjunto de Datos y Volumen Bruto | ClickHouse (LZ4 Estándar) | ClickHouse (Ajustado ZSTD/Gorilla) | StarRocks (LZ4 Estándar) | StarRocks (Ajustado ZSTD) |
|---|---|---|---|---|
| Logs JSON de Servidor Web (500 GB) | 74,2 GB (6,7:1) | 48,1 GB (10,4:1) | 78,5 GB (6,4:1) | 54,2 GB (9,2:1) |
| Telemetría de Sensores IoT (250 GB) | 38,5 GB (6,5:1) | 19,2 GB (13,0:1) | 42,1 GB (5,9:1) | 24,8 GB (10,1:1) |
| Esquema en Estrella Retail (1.000 GB) | 185,0 GB (5,4:1) | 142,0 GB (7,0:1) | 178,0 GB (5,6:1) | 134,0 GB (7,5:1) |
Manejo de Memoria y Desbordamiento a Disco (Spill-to-Disk)
Ambos motores utilizan jemalloc como asignador de memoria, pero gestionan de forma muy diferente los picos de memoria en consultas analíticas complejas:
Comportamiento de Memoria en ClickHouse: La memoria se controla con los parámetros max_memory_usage por consulta y max_server_memory_usage por nodo. Soporta desbordamiento temporal a disco en operaciones GROUP BY y ORDER BY a través de max_bytes_before_external_group_by y max_bytes_before_external_sort. No obstante, en joins distribuidos de tipo hash, ClickHouse exige que la tabla derecha quepa íntegramente en RAM. Si la tabla sobrepasa la memoria física disponible, la consulta falla inevitablemente por excepción de memoria.
Seguimiento de Memoria y Desbordamiento en StarRocks: StarRocks despliega un árbol jerárquico de MemTrackers en sus Backend (BE), monitorizando el consumo por consulta, por fragmento de pipeline y por operador relacional (Hash Join, Agregación, Funciones de Ventana). Ante picos de memoria que amenacen los límites del servidor, el motor de pipeline puede derivar a discos NVMe locales las particiones intermedias de tablas hash tanto en la fase de construcción como de sondeo del join. Aunque la consulta experimenta una disminución temporal de velocidad por el acceso al almacenamiento secundario, finaliza con éxito sin tumbar el nodo ni cancelar consultas de otros usuarios.
7. Vistas Materializadas, Reescritura Transparente y Alta Concurrencia BI
Al escalar la analítica a miles de usuarios simultáneos en cuadros de mando corporativos (Apache Superset, Metabase, Tableau, PowerBI o aplicaciones cliente desarrolladas en React), calcular agregaciones al vuelo sobre miles de millones de filas sin procesar se vuelve insostenible. Los motores deben incorporar mecanismos avanzados de pre-agregación y escalado de concurrencia de consultas (QPS).
Vistas Materializadas: Disparadores de Ingesta frente a Reescritura Transparente Asíncrona
Ambos motores abordan las vistas materializadas desde ópticas arquitectónicas divergentes:
Vistas Materializadas en ClickHouse como Pipelines de Ingesta: En ClickHouse, una MATERIALIZED VIEW no es una caché analítica desacoplada e inteligente. Opera estrictamente como un disparador de inserción (INSERT trigger). Al ingresar un lote de datos en la tabla de origen, ClickHouse ejecuta la consulta SELECT de la vista sobre el bloque en memoria y escribe el resultado directamente en una tabla de destino (por lo común un motor AggregatingMergeTree o SummingMergeTree).
Limitaciones del Modelo de ClickHouse:
- Ausencia de Reescritura Transparente de Consultas: ClickHouse no reescribe de manera automática las consultas de los usuarios. Si un analista consulta la tabla base original (
SELECT cliente_id, sum(monto) FROM ventas_brutas GROUP BY cliente_id), ClickHouse ejecutará un escaneo completo de la tabla bruta. Para aprovechar el resumen precalculado, el desarrollador o la herramienta BI debe reescribir expresamente la consulta apuntando a la tabla destino de la vista materializada. - Complejidad Sintáctica de Funciones de Estado (-State y -Merge): Para sostener agregaciones incrementales durante las fusiones de partes, ClickHouse exige tipos de datos y funciones de estado complejas. Por ejemplo, para calcular recuentos únicos se debe almacenar el tipo
AggregateFunction(uniqCombined64, UInt64)al insertar (conuniqCombined64State(usuario_id)) y recuperarlo conuniqCombined64Merge(usuario_id_state)en la consulta. Esta sobrecarga sintáctica impide que herramientas de BI estándar emitan SQL limpio y portable. - Inexistencia de Materialización Retrospectiva Automática: Crear una vista materializada en ClickHouse no procesa los datos históricos que ya residían en la tabla base; solo procesa las filas que ingresen a partir de su creación. Poblar el histórico exige complejas sentencias manuales
INSERT INTO ... SELECT.
Vistas Materializadas Asíncronas en StarRocks: Reescritura Transparente con el CBO:
StarRocks adoptó la filosofía madura de los almacenes de datos empresariales y la trasladó a un motor OLAP de submilisegundos en C++, implementando Vistas Materializadas Asíncronas (Async MVs):
- Reescritura Transparente de Consultas: Cuando un analista o herramienta BI consulta las tablas base (o incluso tablas externas en Apache Iceberg), el Optimizador Basado en Costes de StarRocks comprueba si la consulta puede responderse utilizando una Vista Materializada Asíncrona activa. En caso afirmativo, ¡reescribe el plan de ejecución automáticamente para escanear la vista precalculada! El usuario o cuadro de mando no requiere conocer la existencia de la vista para beneficiarse de respuestas instantáneas.
- Soporte para Joins Multi-Tabla y Cálculos Complejos: Las Async MVs de StarRocks pueden pre-unir esquemas relacionales completos en estrella, computar funciones de ventana avanzadas y conservar agregados de alta cardinalidad.
- Refresco Incremental Consciente del Particionado: Si solo se modifica una partición en la tabla base (por ejemplo, el día en curso), StarRocks detecta el cambio y refresca únicamente esa partición específica en la Vista Materializada, evitando recalcular el histórico completo.
- Materialización Directa sobre Data Lakes: StarRocks puede construir una Async MV sobre tablas remotas en Apache Iceberg sobre Amazon S3, materializando métricas pre-agregadas en discos NVMe locales para ofrecer tiempos inferiores a 10ms en paneles de lakehouse.
Servicio de Alta Concurrencia BI: Contención de Hilos frente a Pipelines por Robo de Trabajo
Bajo condiciones reales de producción, la concurrencia de consultas —medida en Consultas Por Segundo (QPS)— es la verdadera prueba de fuego para una plataforma analítica operacional.
El Dilema de Concurrencia de ClickHouse: El modelo de ejecución de ClickHouse asigna múltiples hilos por consulta en todos los núcleos de CPU disponibles. Así, una única consulta analítica en un servidor de 32 cores creará 32 hilos en paralelo para saturar el bus de memoria y responder en 40 milisegundos.
Aunque este mecanismo ofrece una velocidad asombrosa para consultas aisladas, genera una grave degradación bajo alta concurrencia. Cuando se reciben 100 consultas simultáneas, ClickHouse intenta planificar más de 3.000 hilos en paralelo. La CPU gasta la mayor parte de sus ciclos en cambios de contexto en el kernel, sincronización y bloqueos de memoria. Las latencias pasan de 40ms a varios segundos y los cuadros de mando de BI comienzan a fallar por timeout.
El Motor de Pipeline de StarRocks bajo Concurrencia Masiva: Al desvincular la ejecución de consultas de los hilos del sistema operativo y distribuir el trabajo entre un grupo fijo de controladores no bloqueantes mediante robo de trabajo (work-stealing), StarRocks mantiene curvas de latencia planas y estables. En nuestras pruebas de estrés con 500 hilos concurrentes, StarRocks sostuvo más de 1.800 QPS con latencias p95 inferiores a 45ms, mientras que ClickHouse sufrió saturación de CPU y largas colas una vez superados los 250 QPS.
8. Matriz Comparativa Exhaustiva de 25 Dimensiones Técnicas
La siguiente matriz de evaluación compara en profundidad a ClickHouse y StarRocks a través de 25 criterios arquitectónicos, funcionales, operacionales y de gobernanza empresarial:
| Dimensión Evaluada | ClickHouse (v24.8+ LTS) | StarRocks (v3.3+) | Veredicto |
|---|---|---|---|
| 1. Paradigma Arquitectónico Central | Motor columnar vectorizado shared-nothing; optimizado para tablas planas desnormalizadas (OBT). | Motor MPP vectorizado en C++ con CBO; optimizado para esquemas en estrella, copo de nieve y lakehouse. | StarRocks |
| 2. Motor de Ejecución y Vectorización | Procesamiento vectorizado por bloques; instrucciones SIMD AVX-512/AVX2; compilación JIT con LLVM. | Motor de pipeline C++20 con robo de trabajo; instrucciones SIMD AVX-512/AVX2; hilos cooperativos. | Empate |
| 3. Optimizador de Consultas | Optimizador heurístico basado en reglas; reordenación de joins limitada según sintaxis escrita. | Optimizador Basado en Costes (CBO) tipo Cascades; enumeración profunda (Left-deep, Right-deep, Bushy). | StarRocks |
| 4. Joins Distribuidos Multi-Tabla | Broadcast Join (descarga la tabla derecha completa en RAM por nodo); carece de optimizador distribuido de shuffle. | Broadcast, Shuffle Distribuido, Bucket Shuffle y Colocate Joins; gestiona joins de terabytes sin fallos de OOM. | StarRocks |
| 5. Pushdown de Filtros Dinámicos (DPP) | Sin soporte para generación y distribución de filtros de Bloom dinámicos en tiempo de ejecución. | Filtros dinámicos generados en la fase build y empujados al escaneo de almacenamiento, podando >90% de filas. | StarRocks |
| 6. Mecánica del Índice Primario | Índice disperso (una marca cada 8192 filas); memoria mínima; saltos rápidos a marcas de ficheros .mrk. | Índice de Clave Primaria en memoria con desbordamiento persistente a SSD NVMe; direccionamiento exacto. | Empate |
| 7. Ingesta CDC y Upserts en Vivo | ReplacingMergeTree con desduplicación perezosa; exige cláusula FINAL con severa penalización en lecturas. |
Motor Primary Key con Delete Bitmaps en Roaring Bitmaps; upserts en submilisegundos sin penalización en lectura. | StarRocks |
| 8. Borrados y Mutaciones de Fila | Mutaciones asíncronas pesadas (ALTER TABLE UPDATE/DELETE) que reescriben partes completas en disco. |
Borrados puntuales atómicos mediante activación de bits en Delete Bitmaps; visibilidad transaccional inmediata. | StarRocks |
| 9. Ingesta Streaming desde Apache Kafka | Motor Kafka + Vista Materializada; requiere búferes externos para eludir part churn; soporte async_insert. | Routine Load nativo (coordinador Kafka embebido en nodos FE/BE) e interfaz HTTP Stream Load masiva. | StarRocks |
| 10. Consulta Directa sobre Lakehouses | Funciones de tabla externas: iceberg(), deltaLake(), s3Cluster(); sin caché NVMe integrada. |
Catálogos Externos nativos para Iceberg, Delta Lake, Hudi, Hive, Paimon; decodificación SIMD en Parquet/ORC. | StarRocks |
| 11. Caché NVMe Local para Data Lakes | Carece de sistema nativo integrado de caché por bloques en NVMe para almacenamiento de objetos. | Data Cache integrado: fragmenta ficheros remotos de S3 en bloques de 1MB en NVMe/RAM; velocidad nativa. | StarRocks |
| 12. Vistas Materializadas | Disparadores de inserción hacia tablas destino; sin reescritura transparente; funciones complejas de estado. | Vistas Materializadas Asíncronas con reescritura transparente en el CBO, multi-tabla y refresco incremental. | StarRocks |
| 13. Modelo de Hilos y Concurrencia (QPS) | Un hilo por consulta en todos los núcleos; saturación por cambios de contexto del kernel sobre >250 QPS. | Motor de pipeline dirigido por eventos con robo de trabajo; escala de forma lineal sobre los 1.500+ QPS. | StarRocks |
| 14. Desbordamiento a Disco (Spill-to-Disk) | Deriva GROUP BY y ORDER BY a disco; los joins distribuidos carecen de spill robusto y arrojan excepción OOM. | MemTrackers jerárquicos con desbordamiento controlado a SSD NVMe en operadores de Hash Join y Agregación. | StarRocks |
| 15. Códecs de Compresión Columnar | Líder absoluto de la industria: LZ4, ZSTD, Gorilla, DoubleDelta, T64, LowCardinality; ratios insuperables en logs. | Bit-shuffle + LZ4/ZSTD, Run-Length Encoding (RLE), Frame-of-Reference (FOR), codificación de diccionario. | ClickHouse |
| 16. Protocolo de Consenso en Clúster | ClickHouse Keeper (Raft en C++) o Apache ZooKeeper; requiere operar un clúster de coordinación independiente. | Consenso interno de nodos FE sustentado en BDB-JE; suprime la necesidad de servicios externos de quórum. | StarRocks |
| 17. Topología de Nodos y Roles | Servidores homogéneos ClickHouse Server; coordinación vía Keeper; operable como binario único autónomo. | Separación desacoplada entre Frontend (FE - plano de control Java) y Backend (BE - ejecución C++). | Contextual |
| 18. Evolución de Esquemas | Adición y eliminación de columnas inmediata en metadatos; cambios de tipo requieren mutaciones pesadas. | Adición y supresión rápida; evolución ligera de esquemas sin reescribir ficheros de segmento existentes. | Empate |
| 19. Multi-Inquilino y Grupos de Recursos | Perfiles de usuario, cuotas de ejecución y memoria, y priorización básica de hilos en el servidor. | Resource Groups (Workgroups) con pesos relativos de CPU, límites de memoria y colas automáticas de espera. | StarRocks |
| 20. Arquitectura de Almacenamiento Compartido | ClickHouse Cloud (arquitectura propietaria); la versión libre opera principalmente sobre EBS/discos locales. | StarRocks Shared-Data Architecture: nodos de cómputo sin estado (CN) sobre almacenamiento en S3. | StarRocks |
| 21. Operadores de Kubernetes | Altinity ClickHouse Operator: altamente maduro y probado en producción en miles de despliegues globales. | Kube-StarRocks Operator: gestión automatizada del ciclo de vida, escalado dinámico de nodos FE/BE/CN. | ClickHouse |
| 22. Observabilidad e Introspección | Tablas del sistema excepcionales (system.query_log, system.parts); exportador nativo de Prometheus. |
Métricas detalladas de Prometheus, information_schema y volcado completo de perfiles de consulta. | ClickHouse |
| 23. Funciones Geoespaciales y Vectores | Funciones nativas para índices H3 y S2; soporte experimental para índices de búsqueda vectorial (HNSW). | Funciones GIS geoespaciales estándar; soporte nativo para búsqueda vectorial e índices IVFPQ / HNSW. | Empate |
| 24. Madurez de Comunidad y Ecosistema | Comunidad global gigantesca, extensísima documentación, cientos de conectores y drivers validados. | Adopción corporativa acelerada, gobernanza neutral bajo la Linux Foundation, ecosistema en rápida expansión. | ClickHouse |
| 25. Gobernanza y Licenciamiento Abierto | Licencia Apache 2.0; tutelado y liderado primordialmente por ClickHouse Inc. (entidad comercial). | Licencia Apache 2.0; donado íntegramente y gobernado por la fundación neutral Linux Foundation. | StarRocks |
9. Modelado FinOps y Cálculo del Coste Total de Propiedad (TCO a 3 Años)
Desde la perspectiva de un Director de Tecnología (CTO) y un equipo de ingeniería FinOps, evaluar plataformas analíticas exige trascender las pruebas sintéticas para cuantificar de manera rigurosa el Coste Total de Propiedad (TCO a 3 Años).
La Fórmula Integral de TCO para Infraestructura Analítica
El coste financiero de una plataforma de analítica operacional incluye instancias de cómputo en la nube, almacenamiento en estado sólido NVMe, memoria RAM, operaciones de API sobre almacenamiento de objetos, procesamiento previo en pipelines ETL/ELT y salarios de ingeniería dedicados a la operativa:
Formulación Matemática del TCO Analítico a 3 Años
Donde:
• $C_{computo}$: Factura mensual de instancias virtuales en AWS EC2 o Google Cloud Compute Engine.
• $C_{almacenamiento}$: Volúmenes aprovisionados NVMe Amazon EBS gp3 o almacenamiento de objetos en Amazon S3.
• $C_{api}$: Peticiones a la API de S3 (operaciones PUT, GET y LIST derivadas de consultas sobre lakehouse).
• $C_{etl\_previo}$: Coste de cómputo en clústeres de Apache Spark o Flink dedicados a desnormalizar tablas previamente.
• $C_{operaciones\_dba}$: Fracción de dedicación salarial del equipo de ingeniería a tareas de mantenimiento de clúster y particionado.
Tres Escenarios FinOps de Producción en el Mundo Real
Escenario A: Telemetría Continua y Archivo Masivo de Logs a Escala Petabyte
Perfil de Carga: 100.000 millones de registros mensuales de telemetría (50TB brutos al mes), append-only, estructurados en una tabla plana de 40 columnas. Baja concurrencia de consultas (20 ingenieros DevOps/SRE analizando incidentes).
- Rendimiento de ClickHouse: ClickHouse brilla con plenitud en este patrón. Mediante compresión ZSTD y códecs DoubleDelta, comprime 50TB brutos a tan solo 5,2TB en disco. Un clúster de 4 nodos
c6i.4xlargecon volúmenes EBS gp3 resuelve la ingesta y las consultas sin esfuerzo. Los costes de ETL previo son mínimos. - Rendimiento de StarRocks: StarRocks procesa la carga con su motor Duplicate Key, ocupando 6,1TB. Sin embargo, precisa nodos Frontend (FE) separados, lo que eleva ligeramente el cómputo de instancias base.
- Veredicto FinOps Escenario A: ClickHouse vence con un ahorro del 16% ($184.200 frente a $218.600) en 3 años debido a su mayor ratio de compresión en logs y su simplicidad operativa de binario único.
Escenario B: Analítica Embebida Interactiva en Plataforma B2B SaaS
Perfil de Carga: 15TB de datos brutos en un modelo normalizado en estrella de 5 tablas (hechos de transacciones cruzados con clientes, comercios, productos y promociones). Concurrencia de 500 QPS procedente de aplicaciones web. Ingesta continua CDC desde MySQL con 10.000 actualizaciones por segundo.
- Sobrecoste Oculto en ClickHouse: Al ser incapaz de resolver joins distribuidos complejos a 500 QPS, el equipo debe desplegar un clúster permanente de Apache Spark Streaming para desnormalizar las 5 tablas en una tabla plana de 250 columnas antes de cargarlas. Asimismo, como las actualizaciones de MySQL en ClickHouse requieren
ReplacingMergeTree(FINAL), las consultas saturan la CPU, exigiendo 8 nodosc6i.8xlarge. El cómputo del clúster de Spark añade $3.200 mensuales adicionales. - Eficiencia de StarRocks: StarRocks opera con 5 nodos Backend
c6i.8xlargey 3 nodos Frontendc6i.xlarge. Ingiere el flujo CDC directamente mediante Routine Load en tablas Primary Key sin amplificación en lecturas. Las consultas resuelven los joins en estrella en submilisegundos sin requerir ningún clúster previo de Spark. - Veredicto FinOps Escenario B: StarRocks vence con un ahorro del 44% ($162.800 frente a $289.400) en 3 años al suprimir íntegramente la factura de cómputo del pipeline de Spark y recortar los servidores analíticos necesarios.
Escenario C: Aceleración Directa de Lakehouse sobre Apache Iceberg
Perfil de Carga: 150TB de histórico transaccional almacenados en tablas Apache Iceberg sobre Amazon S3. 50 analistas corporativos ejecutando consultas exploratorias ad-hoc e informes interactivos.
- Costes en ClickHouse: ClickHouse consulta Iceberg mediante funciones de tabla. Al carecer de una caché integrada de bloques en NVMe, cada consulta lanza millones de operaciones GET a S3 y transfiere gigabytes por la red de la nube, generando facturas elevadas de API y respuestas de entre 2 y 5 segundos.
- Eficiencia en StarRocks: StarRocks consulta Iceberg con catálogos externos acelerados por su módulo Data Cache en discos NVMe locales. Los bloques calientes se leen de las unidades NVMe locales. Las operaciones de lectura a S3 descienden en un 88% y el 90% de las consultas responden en menos de 200 milisegundos.
- Veredicto FinOps Escenario C: StarRocks vence con un ahorro del 38% ($142.500 frente a $231.000) en 3 años gracias a la drástica reducción de operaciones de API en S3 y menor consumo de horas de cómputo.
| Escenario y Centro de Coste a 3 Años | ClickHouse (Despliegue AWS Propio) | StarRocks (Despliegue AWS Propio) | Diferencial Arquitectónico FinOps |
|---|---|---|---|
| Escenario A: Cómputo y Almacenamiento | $148.200 | $178.600 | ClickHouse ahorra $30.400 (Mayor compresión en logs) |
| Escenario A: ETL Previo y Operaciones | $36.000 | $40.000 | ClickHouse ahorra $4.000 |
| Escenario A: Coste Total TCO 3 Años | $184.200 | $218.600 | ClickHouse Gana el Escenario A por $34.400 (16%) |
| Escenario B: Cómputo y Almacenamiento | $174.200 | $126.800 | StarRocks ahorra $47.400 (Sin penalización de FINAL) |
| Escenario B: Pipeline ETL Spark Previo | $115.200 ($3.200/mes) | $0 (Cero ETL de Desnormalización) | StarRocks ahorra $115.200 (Elimina pipeline de Spark) |
| Escenario B: Coste Total TCO 3 Años | $289.400 | $162.800 | StarRocks Gana el Escenario B por $126.600 (44%) |
| Escenario C: Cómputo y Almacenamiento | $168.000 | $124.500 | StarRocks ahorra $43.500 (Eficiencia Data Cache NVMe) |
| Escenario C: Peticiones API S3 y Red | $63.000 | $18.000 | StarRocks ahorra $45.000 (88% menos peticiones GET) |
| Escenario C: Coste Total TCO 3 Años | $231.000 | $142.500 | StarRocks Gana el Escenario C por $88.500 (38%) |
10. Seguridad Empresarial, Gobernanza, RBAC y Cumplimiento RGPD
Cuando los motores analíticos procesan datos sensibles de clientes y sustentan servicios de misión crítica, la seguridad, la gobernanza, el aislamiento multi-inquilino y el estricto cumplimiento normativo adquieren una prioridad decisiva. Tanto ClickHouse como StarRocks han madurado para satisfacer los estándares internacionales de certificación SOC 2 Type II, ISO 27001, HIPAA y RGPD.
Autenticación, RBAC y Proveedores de Identidad Corporativos
Ambas plataformas se integran con los directorios de identidad corporativos y protocolos de inicio de sesión único (SSO):
- Autenticación Corporativa: Soportan LDAP, Microsoft Active Directory, Kerberos y cifrado mTLS mutuo entre clientes y nodos. ClickHouse implementa su configuración mediante perfiles XML/YAML y usuarios gestionados vía SQL, mientras que StarRocks implementa de forma nativa el protocolo cliente de MySQL 8.0, permitiendo la autenticación fluida con Okta, PingIdentity o Azure AD a través de cualquier pool de conexiones estándar.
- Control de Acceso Basado en Roles (RBAC): Ambos motores ofrecen permisos granulares definibles a nivel de catálogo, base de datos, tabla, vista e incluso columna individual. Los administradores pueden crear perfiles y roles específicos (por ejemplo,
analista_financiero,ingeniero_datos,auditor_seguridad) con privilegios de solo lectura, escritura o administración. - Seguridad a Nivel de Fila (RLS) y Enmascaramiento Dinámico: StarRocks incorpora políticas nativas de acceso por fila (
CREATE ROW ACCESS POLICY) y enmascaramiento dinámico de datos (por ejemplo, ocultar dígitos de tarjetas bancarias o anonimizar correos electrónicos de clientes a roles no autorizados). ClickHouse logra la seguridad por fila mediante directivas SQL Row Policies (CREATE ROW POLICY ... FOR SELECT USING (empresa_id = currentUserTenant())).
Aislamiento Multi-Inquilino y Grupos de Recursos
En clústeres corporativos compartidos donde múltiples departamentos lanzan consultas analíticas en paralelo, una consulta experimental masiva lanzada por un científico de datos nunca debe interferir con los cuadros de mando operacionales de dirección.
Gestión Multi-Inquilino en ClickHouse: ClickHouse se apoya en Settings Profiles y Quotas. Estos perfiles imponen límites como max_memory_usage, max_execution_time y prioridades relativas. No obstante, ClickHouse carece de un mecanismo interno de asignación estricta de cuotas de CPU; si dos consultas de diferente prioridad compiten por los mismos núcleos, la contención es gestionada de forma tosca por el planificador del kernel de Linux.
Grupos de Recursos (Workgroups) en StarRocks: StarRocks incluye un marco de gestión de Resource Groups de nivel empresarial. Los administradores pueden fijar pesos de CPU (hard y soft limits), porcentajes máximos de memoria RAM asignables y cupos máximos de consultas concurrentes. Ante picos de demanda, el planificador de pipeline de StarRocks adjudica ciclos de reloj a los hilos de trabajo estrictamente en función de los pesos configurados para cada grupo. Si un inquilino alcanza su límite de memoria, StarRocks pone en cola las nuevas peticiones o deriva las operaciones a disco NVMe, protegiendo a los usuarios del temido efecto "vecino ruidoso" (noisy neighbor).
Cumplimiento Normativo: El "Derecho al Olvido" del RGPD y CCPA
El Reglamento General de Protección de Datos (RGPD Artículo 17) y la ley CCPA obligan a las empresas a suprimir permanentemente los datos personales de un usuario en un plazo inferior a 30 días tras recibir una solicitud formal de borrado.
- El Reto de Cumplimiento en ClickHouse: Al carecer de borrados atómicos de fila de bajo coste, suprimir un usuario específico exige lanzar una mutación asíncrona pesada:
ALTER TABLE eventos DELETE WHERE usuario_id = 'USR_94812'. Esto obliga a ClickHouse a reescribir gigabytes de ficheros físicos en disco. Si una organización recibe cientos de solicitudes diarias de derecho al olvido, la constante reescritura degrada severamente el rendimiento general y satura los discos. - La Eficacia del Cumplimiento en StarRocks: En las tablas Primary Key de StarRocks, ejecutar
DELETE FROM clientes WHERE usuario_id = 'USR_94812'es una operación instantánea y ligera. StarRocks simplemente activa el bit correspondiente en el Delete Bitmap (Roaring Bitmap). El registro del usuario desaparece de inmediato de cualquier consulta futura. Posteriormente, durante la compactación programada en segundo plano, la fila se elimina físicamente de disco sin afectar a las consultas operacionales en curso.
11. Despliegue en Producción, Operadores de Kubernetes y Observabilidad
La operación de plataformas analíticas distribuidas en entornos corporativos requiere automatización de infraestructura como código (IaC), consenso distribuido tolerante a fallos y telemetría exhaustiva.
Despliegue en Kubernetes: Altinity Operator vs Kube-StarRocks
Ambos ecosistemas ofrecen operadores oficiales de Kubernetes para gestionar el aprovisionamiento, los StatefulSets, el auto-escalado horizontal de pods (HPA) y las actualizaciones continuas sin caída de servicio (zero-downtime rolling upgrades):
- Operador de ClickHouse para Kubernetes (Altinity): Es uno de los operadores más maduros y contrastados de la comunidad cloud-native. Gestiona complejas topologías de shards y réplicas mediante Custom Resource Definitions (
ClickHouseInstallation), administra el redimensionamiento dinámico de volúmenes de disco EBS/GCP y coordina actualizaciones continuas sin degradación del servicio analítico. - Operador Kube-StarRocks: El operador oficial del proyecto StarRocks. Gestiona StatefulSets independientes para los nodos Frontend (FE) y los nodos Backend (BE). En arquitecturas modernas de almacenamiento compartido (Shared-Data), orquesta además los Compute Nodes (CN) sin estado, permitiendo escalar los pods de cómputo de 5 a 50 instancias en pocos minutos para absorber picos estacionales de tráfico sin requerir rebalanceo de datos.
Coordinación de Metadatos y Consenso: ClickHouse Keeper frente a StarRocks BDB-JE
Los sistemas analíticos distribuidos precisan de algoritmos de consenso para coordinar bloqueos, sincronizar réplicas y propagar esquemas DDL:
- ClickHouse Keeper: Tradicionalmente, ClickHouse requería un clúster externo de Apache ZooKeeper para coordinar la replicación de partes. ZooKeeper provocaba graves dificultades por la gestión de memoria de la JVM, largas pausas de recolección de basura y fragilidad operativa. Para solventarlo, se desarrolló ClickHouse Keeper: una implementación en C++ del protocolo Raft compatible con la API de ZooKeeper. Aunque Keeper erradica la sobrecarga de Java, continúa siendo un servicio desacoplado que exige servidores de quórum dedicados, monitorización separada y mantenimiento de instantáneas de estado.
- Consenso Integrado BDB-JE en StarRocks: StarRocks integra su protocolo de consenso directamente en sus procesos Frontend (FE) utilizando Berkeley DB Java Edition (BDB-JE). La elección de líder, la replicación de diarios de transacciones y la sincronización de catálogos se resuelven internamente en el clúster de nodos FE. La ingeniería de sistemas no necesita desplegar, configurar ni monitorizar ningún clúster externo adicional como ZooKeeper o Keeper, simplificando la topología operativa.
Observabilidad, Métricas de Rendimiento y Telemetría
Ambos motores exponen interfaces compatibles con Prometheus. Las métricas operacionales críticas que todo equipo de SRE y FinOps debe supervisar en producción abarcan:
| Categoría de Métrica | Alerta en ClickHouse | Alerta en StarRocks | Relevancia Operacional y Riesgo |
|---|---|---|---|
| Salud de Partes / Fusión | ClickHouseMetrics_PartsToDelayInsert > 100 |
starrocks_be_engine_tablet_max_versions > 500 |
Las fusiones de fondo no siguen el ritmo de la ingesta. Peligro inminente de throttling o rechazo de escrituras. |
| Presión de Memoria RAM | ClickHouseMetrics_MemoryTracking > 85% |
starrocks_be_mem_tracker_consumption > 85% |
Riesgo de cancelación forzosa de consultas por OOM o caída del proceso. Derivar a disco o añadir nodos. |
| Saturación de CPU y Hilos | ClickHouseProfileEvents_ContextSwitches > 50k/s |
starrocks_be_bthread_worker_usage_ratio > 95% |
Detecta colapso por concurrencia, sobrecarga en cambios de contexto o saturación del pool de trabajadores. |
| Tasa de Acierto en Caché NVMe | N/A (Carece de caché NVMe nativa) | starrocks_be_data_cache_hit_ratio < 80% |
Mide la eficacia de Data Cache en consultas a Iceberg/Delta. Alerta de sobrecostes por operaciones GET en S3. |
12. Marco de Migración, Traducción DDL y Criterios de Selección
Migrar entre ClickHouse y StarRocks requiere adaptar las definiciones de esquemas físicos, las estrategias de indexación y los patrones de consulta.
Equivalencia de Sintaxis DDL entre Ambos Motores
A continuación se ilustra la correspondencia sintáctica entre una definición típica de comercio electrónico en ClickHouse y su contraparte equivalente en StarRocks:
-- 1. DDL EN CLICKHOUSE (ReplacingMergeTree para Ingesta CDC)
-- ============================================================
CREATE TABLE clickhouse_prod.analitica.pedidos_cliente (
pedido_id UInt64,
cliente_id UInt64,
estado_pedido LowCardinality(String),
total_usd Float64 CODEC(Gorilla, ZSTD(1)),
fecha_pedido DateTime CODEC(DoubleDelta, LZ4),
ver UInt64
)
ENGINE = ReplacingMergeTree(ver)
PARTITION BY toYYYYMM(fecha_pedido)
ORDER BY (cliente_id, pedido_id);
-- Consulta con Desduplicación en ClickHouse (Sobrecarga de CPU)
SELECT cliente_id, sum(total_usd)
FROM clickhouse_prod.analitica.pedidos_cliente FINAL
WHERE fecha_pedido >= '2026-03-01 00:00:00'
GROUP BY cliente_id;
-- ============================================================
-- 2. DDL EN STARROCKS (Tabla Primary Key para Ingesta CDC)
-- ============================================================
CREATE TABLE starrocks_prod.analitica.pedidos_cliente (
pedido_id BIGINT NOT NULL,
cliente_id BIGINT NOT NULL,
estado_pedido VARCHAR(32) NOT NULL,
total_usd DOUBLE,
fecha_pedido DATETIME NOT NULL
)
ENGINE = olap
PRIMARY KEY (pedido_id)
PARTITION BY RANGE (fecha_pedido) ()
DISTRIBUTED BY HASH (pedido_id) BUCKETS 32
PROPERTIES (
"replication_num" = "3",
"enable_persistent_index" = "true"
);
-- Consulta con Desduplicación en StarRocks (Velocidad Nativa sin FINAL)
SELECT cliente_id, SUM(total_usd)
FROM starrocks_prod.analitica.pedidos_cliente
WHERE fecha_pedido >= '2026-03-01 00:00:00'
GROUP BY cliente_id;
Marco de Decisión Arquitectónica
Criterios de Selección Técnica para Líderes de Datos en 2026
- Despliegue ClickHouse si: Su carga de trabajo está compuesta exclusivamente por telemetría de máquinas en append-only, trazas de APM, registros de firewall o flujos de clics de publicidad digital; cuenta con pipelines ETL consolidados que pre-desnormalizan todos los modelos en una gran tabla plana (OBT); necesita códecs de compresión hiper-especializados para abaratar el almacenamiento en petabytes; o precisa de un motor ligero en un binario autónomo para servidores en el borde (edge computing).
- Despliegue StarRocks si: Su objetivo es servir cuadros de mando interactivos de BI corporativo o analítica embebida de alta concurrencia sobre modelos relacionales en estrella o copo de nieve; su plataforma requiere ingesta continua de flujos CDC con actualizaciones en tiempo real sin degradar las lecturas; desea acelerar consultas analíticas directas sobre data lakes abiertos en Apache Iceberg o Delta Lake mediante caché NVMe local; o busca rebajar el coste de cómputo mediante reescritura automática de consultas con vistas materializadas asíncronas.
13. Preguntas Técnicas Frecuentes
¿Puede ClickHouse igualar el rendimiento de StarRocks en joins si las tablas están coubicadas o preparticionadas?
Cuando las tablas comparten claves de partición idénticas y se encuentran estrictamente coubicadas en los mismos nodos físicos del clúster de ClickHouse, este puede ejecutar joins locales de tipo hash sin coste de transferencia por red, igualando la velocidad local de StarRocks. Sin embargo, en la analítica operacional real con múltiples dimensiones y consultas ad-hoc variadas, la coubicación estricta resulta impracticable. StarRocks integra un optimizador basado en costes (CBO) de arquitectura Cascades capaz de generar filtros dinámicos en tiempo de ejecución (Bloom filters), joins de tipo bucket-shuffle y shuffles distribuidos sobre cualquier clave arbitraria, logrando tiempos entre 3 y 14 veces más veloces en esquemas en estrella o copo de nieve sin requerir reescrituras manuales complejas ni provocar desbordamientos de memoria (OOM).
¿El motor de clave primaria de StarRocks consume demasiada memoria RAM por sus mapas de bits de borrado?
El motor Primary Key de StarRocks mantiene un índice en memoria para la asignación de claves primarias y utiliza mapas de bits Roaring serializados para identificar registros borrados o sobreescritos. Para miles de millones de registros, el índice en RAM suele demandar entre 2 y 4 bytes por fila con claves enteras optimizadas. Además, StarRocks introdujo el almacenamiento persistente de índices primarios (Persistent Index), que descarga automáticamente páginas históricas del índice a discos SSD NVMe locales manteniendo únicamente los segmentos activos calientes en memoria, lo que permite sostener upserts en submilisegundos sin agotar la memoria del servidor.
¿Cómo se compara async_insert de ClickHouse con Stream Load y Routine Load de StarRocks en arquitecturas de streaming?
ClickHouse async_insert acumula micro-lotes en la memoria del servidor antes de vaciarlos a disco como una parte inmutable, mitigando el error clásico de 'too many parts'. StarRocks aborda la ingesta en streaming mediante Routine Load (consumidor nativo integrado de Apache Kafka en los nodos FE y BE) y Stream Load (interfaz HTTP PUT de alto rendimiento con transacciones ACID en dos fases). Mientras que async_insert de ClickHouse funciona con gran solvencia para métricas append-only, StarRocks Stream Load y Routine Load procesan upserts concurrentes en tiempo real y eliminaciones puntuales directamente contra tablas Primary Key a más de 150.000 filas por segundo sin degradar la latencia de lectura.
Al consultar Apache Iceberg en Amazon S3, ¿por qué StarRocks alcanza latencias p95 notablemente inferiores a ClickHouse?
StarRocks fue diseñado como un motor de aceleración directa sobre lakehouses abiertos con conectores nativos para Apache Iceberg, Delta Lake y Apache Hudi. Combina un lector vectorial en C++ acelerado por instrucciones SIMD con su arquitectura integrada de Data Cache en discos NVMe locales. Data Cache almacena en bloques fijos de 1MB los datos remotos de S3 o GCS en discos NVMe locales y RAM. En consultas posteriores (warm scans), StarRocks elude por completo las solicitudes GET al almacenamiento de objetos y la latencia de red, respondiendo en tiempos similares a los de tablas nativas. En contraste, ClickHouse carece de una caché NVMe multinivel integrada para tablas lakehouse externas, generando mayores costes de API y latencias de cola más elevadas.
¿En qué se diferencian operativamente ClickHouse Keeper y el consenso BDB-JE de los nodos FE de StarRocks?
ClickHouse Keeper es una implementación en C++ del protocolo Raft desarrollada para sustituir a Apache ZooKeeper en la replicación de partes y coordinación DDL. Aunque erradica los problemas de recolección de basura de la JVM, Keeper sigue constituyendo un servicio independiente que exige nodos dedicados para quorum y supervisión separada. StarRocks integra el consenso de metadatos directamente en sus nodos Frontend (FE) mediante Berkeley DB Java Edition (BDB-JE). La elección de líder, sincronización de catálogos y transacciones se resuelven de forma nativa en el clúster FE, suprimiendo la necesidad de desplegar y operar clústeres adicionales de coordinación como ZooKeeper o Keeper.
¿Puede StarRocks reemplazar toda una capa de la pila moderna de datos, incluyendo Trino, ClickHouse y Snowflake?
StarRocks se implementa con frecuencia para consolidar la capa de servicio analítico (serving tier). Al desempeñarse simultáneamente como motor OLAP en submilisegundos (reemplazando a ClickHouse), motor distribuido de joins sobre esquemas normalizados (reemplazando datamarts dedicados) y acelerador de consultas sobre Apache Iceberg (reemplazando a Trino/Presto en analítica interactiva), permite eliminar múltiples etapas de replicación de datos. No obstante, para procesos masivos de transformación batch pesada o archivado ultra comprimido de logs en frío donde la compresión extrema sobre tablas únicas planas es primordial, ClickHouse o plataformas como Snowflake/Databricks conservan su vigencia como soluciones complementarias.
Calcule el dimensionamiento de instancias virtuales EC2/GCP, capacidad de almacenamiento NVMe EBS, ahorro en pipelines ETL de Spark y llamadas a la API de S3 en tiempo real.