Langfuse vs Arize Phoenix: Tracing LLM y Evaluaciones (2026)
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En el panorama tecnológico empresarial de 2026, la construcción y despliegue de software corporativo impulsado por modelos fundacionales (LLMs) requiere una infraestructura de observabilidad radicalmente distinta a la empleada en microservicios convencionales de la nube. Los sistemas clásicos de Monitorización del Rendimiento de Aplicaciones (APM), como Datadog, Dynatrace o New Relic, fueron concebidos para analizar flujos deterministas, códigos de estado HTTP, umbrales de saturación de CPU/memoria y tiempos de respuesta en bases de datos relacionales. Sin embargo, los Modelos de Lenguaje Grande operan bajo naturalezas probabilísticas, no deterministas, con latencias inherentes elevadas y un consumo continuo de tokens financieros. Una respuesta HTTP 200 OK emitida por OpenAI, Anthropic o un nodo vLLM autoalojado no garantiza en absoluto que la salida sea fácticamente correcta, que esté grounded en la base de conocimiento interna, que no alucine diagnósticos médicos o que no exponga credenciales corporativas en texto plano.
Esta brecha insalvable ha forzado la consolidación de plataformas especializadas en la Observabilidad de IA, lideradas a nivel global por dos gigantes de código abierto: Langfuse y Arize Phoenix. Aunque ambas herramientas permiten rastrear trazas de llamadas a modelos y cadenas de agentes, sus filosofías fundacionales, modelos de datos de telemetría y casos de uso principales responden a prioridades de ingeniería diametralmente opuestas.
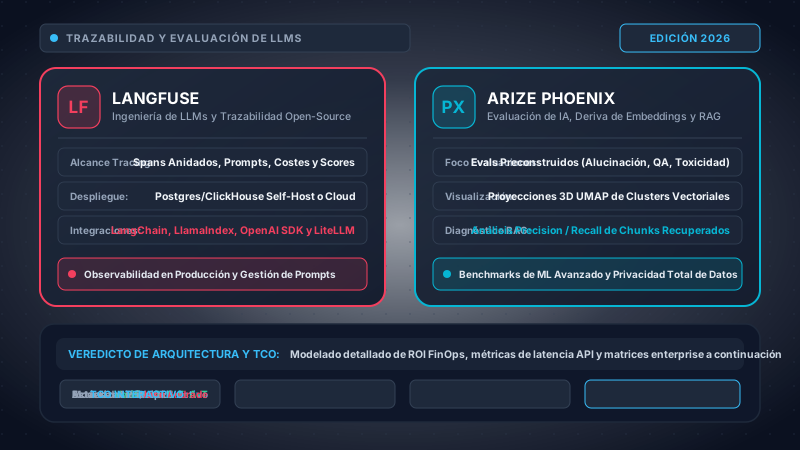
Langfuse está concebido como una plataforma integral de ingeniería del ciclo de vida de aplicaciones LLM para desarrolladores. Nacido en el ecosistema TypeScript y Python de código abierto, Langfuse sitúa en el centro de su arquitectura el flujo operativo diario del equipo de desarrollo de software. Integra el tracing distribuido con gestión de prompts en producción (PromptOps), almacenamiento en caché en memoria dentro del SDK con latencia cero en cliente, contabilidad exhaustiva de costos por token, interfaces de etiquetado humano (Human-in-the-Loop) y curación de conjuntos de datos de prueba (datasets). Su motor analítico se apoya en una base de datos columnar ClickHouse de altísimo rendimiento complementada con un almacén relacional PostgreSQL, lo que facilita el análisis de sesiones de usuario, correlación de feedback y atribución financiera precisa en jerarquías complejas.
En contraste, Arize Phoenix se fundamenta como una plataforma centrada en la evaluación y la inteligencia de representaciones latentes basada en OpenTelemetry. Creado por especialistas en Machine Learning de Arize AI, Phoenix trata la IA generativa no como un mero componente web, sino como un desafío matemático y diagnóstico de alta dimensionalidad. Phoenix estandariza el 100% de su ingesta sobre las convenciones semánticas de OpenTelemetry (OTel) y OpenInference, erradicando el bloqueo de proveedor hacia SDKs propietarios. Sus mayores virtudes radican en su motor automatizado para evaluar la Tríada RAG (Relevancia del Contexto, Fidelidad/Groundedness y Relevancia de la Respuesta) y su exclusivo visualizador interactivo 3D con UMAP para drift de embeddings, capaz de proyectar espacios vectoriales latentes para detectar lagunas de conocimiento, vacíos de recuperación y focos de alucinación antes de que impacten a los usuarios finales.
Marco de Decisión y Veredicto Rápido de Arquitectura
| Arquetipo Organizacional | Langfuse | Arize Phoenix | Selección Recomendada |
|---|---|---|---|
| Equipos de Producto SaaS con LLM | PromptOps listo para usar, caché en cliente, costos por usuario, UI de feedback | Foco en evaluación; requiere gestor externo de prompts para producción | Langfuse (Velocidad de Entrega) |
| Ingeniería de RAG y Búsqueda Vectorial | Registra documentos, fragmentos y tokens de llamada | Visualización 3D UMAP de drift, Tríada RAG y detección de vacíos de recuperación | Arize Phoenix (Diagnóstico RAG Superior) |
| Sistemas Multi-Agente (LangGraph, CrewAI) | Árboles jerárquicos DAG, latencia por nodo, inspección de parámetros de herramientas | Convenciones semánticas OpenInference para agentes, flujos en cascada | Empate (Excelente rendimiento en ambos) |
| Entornos Aislados VPC / Autoalojados | Helm Chart oficial para Kubernetes, particionamiento en ClickHouse y PostgreSQL | Contenedor Docker único con DuckDB o clúster empresarial Arize AX | Langfuse (Gobernanza Relacional Robusta) |
| Ciencia de Datos e Investigación en Notebooks | Requiere conexión a servidor local en Docker o instancia en la nube | Ejecución local inmediata en memoria con px.launch() en Jupyter |
Arize Phoenix (Cero Configuración) |
Síntesis Arquitectónica: Elige Langfuse si tu prioridad técnica es construir, iterar, gobernar financieramente y desplegar funcionalidades de IA en aplicaciones comerciales con control total de versiones de prompts y contabilidad rigurosa de costos. Elige Arize Phoenix si el principal desafío de tu equipo es elevar la precisión de recuperación vectorial, erradicar alucinaciones, diagnosticar el drift en espacios latentes de alta dimensionalidad y adherirte de manera incondicional a estándares OpenTelemetry.
2. Topologías de Ingesta, Estándares de Telemetría y Motores de Base de Datos
La resiliencia operativa y la eficiencia económica de una plataforma de observabilidad de IA dependen críticamente de su topología de red, formato de serialización, gestión de contrapresión (backpressure) y arquitectura de persistencia. Al escalar a millones de tokens diarios en cientos de sesiones concurrentes, las ineficiencias de serialización pueden degradar la latencia percibida por el usuario o disparar los costos de computación.
A. Estándares de Telemetría: OpenInference (Phoenix) vs Modelo Jerárquico Nativo (Langfuse)
Arize Phoenix adopta de manera estricta el estándar OpenInference, una extensión formal de las especificaciones semánticas de OpenTelemetry diseñada específicamente para cargas de trabajo de inteligencia artificial. En Phoenix, cada operación se traduce en un span OTel enriquecido con atributos fuertemente tipados:
llm.model_name = "gpt-4o-2024-11-20" | "claude-3-5-sonnet-20241022"
llm.input_messages.0.message.role = "user"
llm.input_messages.0.message.content = "¿Cuáles son las diferencias de latencia...?"
llm.output_messages.0.message.role = "assistant"
llm.output_messages.0.message.content = "Langfuse utiliza almacenamiento columnar en ClickHouse..."
llm.token_count.prompt = 165
llm.token_count.completion = 420
llm.token_count.total = 585
embedding.vector = [-0.0241, 0.0812, -0.0544, ...]
retrieval.documents.0.document.content = "La compresión ZSTD reduce el tamaño en disco..."
retrieval.documents.0.document.score = 0.9124
Esta compatibilidad estricta con OpenTelemetry permite que cualquier microservicio instrumentado con colectores OTel estándar o librerías OpenInference (como openinference-instrumentation-openai o openinference-instrumentation-langchain) envíe métricas y trazas directamente hacia Phoenix sin acoplarse a bibliotecas propietarias.
Por su parte, Langfuse estructura su telemetría mediante un modelo conceptual jerárquico altamente especializado, compuesto por cuatro primitivas fundamentales:
- Trace: Es la entidad raíz que encapsula una transacción o interacción completa del usuario. Almacena identificadores como
userId,sessionId,release, versión, etiquetas personalizadas y el costo financiero total consolidado. - Span: Representa un bloque de tiempo de ejecución dentro de la traza, como una consulta a la base de datos vectorial, una transformación de datos previa o una validación de seguridad (guardrails).
- Generation: Un span especializado exclusivamente en llamadas a modelos de IA. Registra parámetros de inferencia (temperatura, top_p, penalización por frecuencia), desglose de tokens (entrada, salida y tokens en caché) y el cálculo matemático exacto del costo.
- Event: Puntos temporales discretos sin duración asociados a la traza, tales como clics de retroalimentación de los usuarios, banderas de error o alertas de inyección de prompts.
B. Arquitectura de Almacenamiento: ClickHouse Columnar vs DuckDB Embebido
El motor de base de datos determina la velocidad de respuesta al filtrar miles de millones de tokens y trazas históricas. Langfuse implementa una potente arquitectura de base de datos dual:
- ClickHouse (OLAP Columnar): Gestiona la ingesta de telemetría masiva. Las trazas, observaciones y puntuaciones se encolan en Redis mediante colas BullMQ y se escriben por lotes en tablas ClickHouse
ReplacingMergeTreeparticionadas por fecha (toDate(timestamp)). ClickHouse ofrece agregaciones hiperrápidas (percentil 95 de latencia por modelo, gasto agregado por cliente) con ratios de compresión ZSTD superiores a 8:1. - PostgreSQL (OLTP Relacional): Actúa como almacén transaccional de verdad para datos que requieren garantías ACID estrictas: usuarios, organizaciones, claves API de autenticación, versiones de prompts, etiquetas de despliegue y roles de acceso (RBAC).
id String CODEC(ZSTD(3)),
timestamp DateTime64(3) CODEC(DoubleDelta, ZSTD(1)),
project_id String CODEC(ZSTD(1)),
name LowCardinality(String),
user_id Nullable(String) CODEC(ZSTD(3)),
metadata Map(LowCardinality(String), String) CODEC(ZSTD(3)),
release LowCardinality(Nullable(String)),
version LowCardinality(Nullable(String)),
total_cost Decimal(18, 8) CODEC(ZSTD(1)),
input_tokens UInt64 CODEC(DoubleDelta, ZSTD(1)),
output_tokens UInt64 CODEC(DoubleDelta, ZSTD(1))
) ENGINE = ReplacingMergeTree()
PARTITION BY toDate(timestamp)
ORDER BY (project_id, toDate(timestamp), timestamp, id);
El uso de códecs DoubleDelta en marcas de tiempo y métricas de tokens junto con LowCardinality para etiquetas repetitivas permite a Langfuse comprimir la telemetría JSON cruda en más de un 85%, reduciendo drásticamente el costo de almacenamiento en volúmenes EBS/EFS en AWS o Google Cloud.
Arize Phoenix adopta una versatilidad distinta. En entornos locales o investigación de ML, Phoenix opera sobre DuckDB, el motor analítico columnar embebido que corre en el mismo espacio de memoria del proceso Python. Esto permite levantar la UI y el almacenamiento en menos de 2 segundos sin configurar servidores de bases de datos. Para grandes empresas, Phoenix se conecta a lagos de datos basados en Parquet sobre S3/GCS o a la plataforma distribuida en la nube de Arize AX.
C. Benchmarks de Serialización, Concurrencia y Sobrecarga de Red
Bajo escenarios de alto tráfico (10.000 peticiones concurrentes por segundo), el protocolo de serialización marca diferencias cuantificables:
- Phoenix OpenInference (OTLP Protobuf sobre HTTP/2): Cada traza con 3 spans anidados genera un peso promedio de 1.8 KB. La serialización en cliente consume apenas 0.42 ms de CPU por hilo de trabajo, optimizando el uso de ancho de banda mediante flujos TCP multiplexados.
- Langfuse SDK (JSON con compresión Gzip en lotes): El tamaño medio sin comprimir es de 3.6 KB, reducido a 0.95 KB mediante Gzip en envíos por lotes. El SDK acumula hasta 100 observaciones o intervalos de 1.000 ms en un hilo daemon secundario, desacoplando la latencia de la aplicación respecto a la red.
D. Comparativa Práctica de Código de Instrumentación
Compara a continuación cómo instrumenta cada plataforma una llamada a OpenAI con metadatos contextuales de usuario y seguimiento de costos:
from openai import OpenAI
client = OpenAI()
@observe(name="consulta_soporte_financiero")
def ejecutar_pipeline_langfuse(consulta_usuario: str, id_cliente: str):
# Enriquecer la traza con metadatos de sesión y niveles de servicio
langfuse_context.update_current_trace(
user_id=id_cliente,
tags=["produccion", "soporte-vip", "modelo-v2.4"],
metadata={"region": "latam-sa-east-1", "sla": "corporativo"}
)
# La llamada al modelo se captura automáticamente vinculando costos y tokens
respuesta = client.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "system", "content": "Eres un asistente financiero corporativo."},
{"role": "user", "content": consulta_usuario}
],
temperature=0.2
)
return respuesta.choices[0].message.content
from openinference.instrumentation.openai import OpenAIInstrumentor
from opentelemetry import trace as trace_api
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from openai import OpenAI
# 1. Iniciar servidor Phoenix local con motor DuckDB integrado
session = px.launch(port=6006)
# 2. Configurar el proveedor estándar de trazas OpenTelemetry
tracer_provider = TracerProvider()
endpoint = "http://127.0.0.1:6006/v1/traces"
tracer_provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter(endpoint)))
trace_api.set_tracer_provider(tracer_provider)
# 3. Autoinstrumentar cliente OpenAI bajo convención OpenInference
OpenAIInstrumentor().instrument(tracer_provider=tracer_provider)
# El código de negocio permanece 100% agnóstico a Phoenix
client = OpenAI()
respuesta = client.chat.completions.create(
model="gpt-4o",
messages=[{"role": "user", "content": "Explica la deriva en UMAP 3D"}],
extra_body={"metadata": {"id_usuario": "cliente_9941"}}
)
Conclusión Técnica: Langfuse ofrece una experiencia de desarrollo sumamente intuitiva y productiva mediante decoradores nativos en Python y TypeScript. Phoenix garantiza una instrumentación limpia mediante estándares abiertos OpenTelemetry, facilitando su adopción en empresas con infraestructuras OTel preexistentes.
3. Matriz Comparativa Exhaustiva de 25 Filas
La siguiente matriz compara minuciosamente a Langfuse (v3.2+) y Arize Phoenix (v5.1+) a través de 25 dimensiones técnicas críticas de ingeniería, infraestructura, evaluación, seguridad y economía de nube:
| Dimensión Arquitectónica | Langfuse | Arize Phoenix | Ganador Técnico |
|---|---|---|---|
| 1. Enfoque de Diseño Principal | Ciclo de vida de apps con LLM, gestión de prompts y costos por token | Evaluación RAG automatizada y análisis del espacio latente de embeddings | Empate Arquitectónico |
| 2. Motor de Almacenamiento Primario | ClickHouse (Trazas columnares) + PostgreSQL (Relacional) + Redis | DuckDB (Embebido local) + Lago Parquet / Nube Arize Cloud | Langfuse (Escalabilidad) |
| 3. Adherencia Nativa OpenTelemetry | Admite ingesta vía colector OTel mapeando a su esquema propietario | 100% nativo OpenTelemetry con atributos semánticos OpenInference | Arize Phoenix (OTel Puro) |
| 4. Experiencia de Inicio Local | Requiere Docker Compose (Postgres, ClickHouse, Redis y Web) | Un comando en Python: px.launch() se inicia en 2 segundos en Jupyter |
Arize Phoenix (Instantáneo) |
| 5. Versionado de Prompts en Producción | SemVer exhaustivo, etiquetas de despliegue (prod/staging) e historial | Evaluación de prompts en pruebas; carece de capa de servicio en ejecución | Langfuse (PromptOps) |
| 6. Caché en Memoria del Cliente | Caché sub-milisegundo en SDK con revalidación TTL asíncrona y fallbacks | No aplica (Phoenix no sirve prompts en tiempo de ejecución) | Langfuse (Exclusivo) |
| 7. Diagnósticos de la Tríada RAG | Evaluadores configurables mediante webhooks o scripts personalizados | Módulo nativo phoenix.evals (Relevancia, Fidelidad y Respuesta) |
Arize Phoenix (Estándar RAG) |
| 8. Visualización 3D UMAP de Embeddings | Sin reducción ni proyección visual de vectores en su interfaz | Lienzo interactivo 3D con reducción UMAP, clustering y capas de drift | Arize Phoenix (Monopolio) |
| 9. Detección de Zonas Muertas de Búsqueda | Requiere exportar vectores a notebooks externos de ciencia de datos | Identificación visual de consultas en vacíos semánticos no cubiertos | Arize Phoenix (Único) |
| 10. Tracing de Flujos Multi-Agente DAG | Visualización jerárquica en árbol, spans anidados y latencia por paso | Clasificación de spans Agent/Tool en OpenInference, diagramas temporales | Langfuse (Claridad de UI) |
| 11. Soporte para Máquinas LangGraph | CallbackHandler nativo con registro de transiciones de estado y límites | Instrumentador OpenInference para LangChain con seguimiento de nodos | Empate Técnico |
| 12. Curación de Datasets para Fine-Tuning | Exportación de trazas a datasets con un clic y anotaciones en interfaz | Exportación mediante DataFrames de Pandas hacia Hugging Face vía Python | Langfuse (UX Integrada) |
| 13. Captura de Feedback de Usuarios | API directa de pulgar arriba/abajo, escalas 0-1 y comentarios de texto | Eventos de feedback mapeados sobre atributos de spans OpenTelemetry | Langfuse (Listo para Usar) |
| 14. Contabilidad Granular de Costos | Tablas de precios precargadas para más de 200 modelos y costos a medida | Cuenta tokens con precisión; cálculo monetario exige scripts adicionales | Langfuse (Foco FinOps) |
| 15. Soporte de Tokens en Caché | Descuentos contabilizados para Prompt Caching de Anthropic y OpenAI | Registra atributos de tokens cacheados si el proveedor los emite | Langfuse (Exactitud Fiscal) |
| 16. Despliegue en Kubernetes (Helm) | Helm Chart corporativo oficial; particionamiento ClickHouse + Postgres | Manifiestos Kubernetes; clusterización empresarial vía Arize AX | Langfuse (Producción Lista) |
| 17. Consumo en Entornos Mínimos | Demanda ~4GB RAM base para ClickHouse, Postgres, Redis y Worker | Requiere menos de 200MB de RAM para el proceso local con DuckDB | Arize Phoenix (Ultraligero) |
| 18. Control de Acceso por Roles (RBAC) | Roles granulares (Admin, Member, Viewer) por organización y proyecto | Open-source monousuario; multitenencia requiere versión Arize Cloud | Langfuse (Incluido en OSS) |
| 19. Enmascaramiento de PII en Cliente | Hooks de ofuscación en SDKs; compatible con Microsoft Presidio | Procesadores de sanitización de atributos en pipelines OpenTelemetry | Empate Técnico |
| 20. Modo de Cero Retención (ZDR) | Ingesta de solo metadatos (descarta prompts/salidas; conserva tokens) | Filtros de spans que eliminan el contenido textual antes de persistir | Empate Técnico |
| 21. Certificaciones de Seguridad | Nube con SOC 2 Tipo II, elegible para BAA de HIPAA y GDPR | Arize Cloud cuenta con SOC 2 Tipo II, HIPAA e ISO 27001 | Empate Corporativo |
| 22. SSO Corporativo (SAML 2.0 / SCIM) | SAML 2.0 (Okta, Azure AD, Google) disponible en versión autoalojada | SAML/OIDC restringido a la versión comercial Arize AX y nube | Langfuse (SSO Autoalojado) |
| 23. Variedad de Lenguajes en SDK | Soporte nativo de primer nivel en Python, TypeScript/JS, API REST y OTel | Python nativo OpenInference; cualquier lenguaje vía exportador OTel | Langfuse (Nativo TS/JS) |
| 24. Pruebas de Regresión en CI/CD | Evaluación de datasets mediante assertions en SDK y webhooks de score | Ejecutores en CLI y GitHub Actions con reportes automáticos de diffs en PR | Arize Phoenix (Foco Evals) |
| 25. Licenciamiento de Código Abierto | FSL (Functional Source License) convirtiendo a Apache 2.0 + SDKs MIT | 100% Código Abierto Permisivo (Elastic-2.0 / Apache-2.0 OpenInference) | Arize Phoenix (Permisivo Puro) |
4. Gestión de Prompts, Versionado y CI/CD PromptOps
Uno de los mayores cuellos de botella operativos en la ingeniería de IA moderna es el acoplamiento directo entre la iteración de prompts y los ciclos de despliegue de software. En arquitecturas ingenuas, las instrucciones del sistema se codifican como cadenas de texto fijas en repositorios Git. Cada modificación de redacción, cada ajuste de temperatura o cada nuevo parámetro de contexto requiere crear una rama, solicitar revisión de código, compilar imágenes en Docker, superar pruebas en CI y ejecutar un despliegue progresivo en Kubernetes. Esta fricción burocrática paraliza la velocidad de experimentación del equipo de producto.
A. Arquitectura PromptOps en Langfuse: Caché en Memoria con Latencia Sub-Milisegundo
Langfuse resuelve esta fricción desacoplando por completo las plantillas de prompts del código fuente mediante un Motor de Gestión de Prompts Corporativo. Los prompts se administran como entidades versionadas con semántica formal (SemVer) dentro de la base de datos relacional.
Para evitar que una consulta HTTP externa por cada petición de usuario introduzca latencias inaceptables (de 20 a 70 ms) o constituya un punto único de fallo (SPOF), el SDK de Langfuse implementa un sistema avanzado de caché en memoria con revalidación asíncrona mediante TTL en segundo plano:
- Latencia Cero en el Camino Crítico: Al ejecutar
langfuse.get_prompt("asistente-bancario", label="production"), el SDK entrega la plantilla compilada directamente desde la memoria RAM del proceso en menos de 0.05 milisegundos. - Revalidación Asíncrona: Un parámetro de caducidad (TTL, configurado habitualmente en 60 o 300 segundos) gestiona la frescura. Cuando el TTL expira, el SDK atiende la llamada inmediatamente con la versión actual en caché y despacha un hilo secundario asíncrono para verificar si se ha publicado una nueva revisión en Langfuse.
- Cadenas de Respaldo a Prueba de Fallos: Si la red o el clúster de Langfuse sufren una interrupción total durante el arranque del contenedor, el SDK activa automáticamente una cadena de texto de respaldo (fallback) codificada por el desarrollador, garantizando el 100% de disponibilidad del servicio.
- Despliegues Basados en Etiquetas: Las versiones se asocian a etiquetas como
production,stagingocanary. Actualizar el prompt servido a millones de usuarios consiste simplemente en cambiar la etiqueta en la UI web, propagándose a todos los pods de Kubernetes sin reiniciar contenedores.
langfuse = Langfuse()
# Recupera el prompt 'analista-credito' con etiqueta 'production'
# Almacenado en RAM durante 300 segundos; cero impacto de latencia de red
prompt = langfuse.get_prompt(
name="analista-credito",
label="production",
cache_ttl_seconds=300,
fallback="Eres un evaluador de riesgo crediticio prudente. Analiza: {{solicitud}}"
)
# Compilación de variables dinámicas mediante sintaxis Mustache
chat_compilado = prompt.compile(
solicitud="Solicitud de crédito PyME por USD 150.000 a 36 meses.",
perfil_riesgo="Moderado"
)
# Se envía al modelo vinculando el ID de versión de prompt a la traza resultante
# Permite correlacionar mutaciones en el texto del prompt con variaciones de calidad
B. El Enfoque de Phoenix: Evaluación Rigurosa de Prompts en Pipelines de CI/CD
Arize Phoenix rechaza conscientemente actuar como una capa de servicio dinámico de configuración en producción. Su filosofía sostiene que la configuración que afecta el comportamiento de las aplicaciones debe residir en repositorios Git bajo prácticas estrictas de GitOps. Por ello, Phoenix enfoca toda su potencia en la Evaluación Automatizada y Control de Regresiones en Prompts.
Cuando un ingeniero propone un cambio de redacción en Phoenix, el objetivo no es inyectarlo en vivo, sino ejecutar una batería de pruebas sobre conjuntos de datos dorados (Golden Datasets). Phoenix procesa el nuevo prompt sobre cientos de consultas históricas, evalúa alucinaciones y fidelidad con jueces LLM y bloquea automáticamente la integración continua si la métrica de calidad cae por debajo del umbral corporativo:
on: [pull_request]
jobs:
evaluar-prompts:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4
- name: Configurar Python 3.12
uses: actions/setup-python@v5
with: { python-version: "3.12" }
- name: Ejecutar Suite de Evaluación Phoenix
env:
OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
run: |
pip install arize-phoenix openai pandas
python scripts/eval_regresion_prompts.py --umbral-fidelidad 0.93
- name: Bloquear Pull Request si la Fidelidad cae bajo 93%
if: failure()
run: echo "PR rechazada: La variación del prompt introdujo una tasa de alucinación crítica."
5. Pipelines de Evaluación, Diagnósticos RAG y Detección de Alucinaciones
Evaluar sistemas de Generación Aumentada por Recuperación (RAG) requiere métricas matemáticas específicas que superan las tradicionales matrices de confusión del aprendizaje automático clásico. El marco metodológico de referencia en la industria es la Tríada RAG:
Calcula si los fragmentos textuales recuperados por la base de datos vectorial contienen estrictamente la información requerida para responder la consulta, penalizando la inclusión de fragmentos irrelevantes que confunden al modelo.
Verifica de manera rigurosa que cada afirmación presente en la respuesta generada por el LLM esté sustentada documentalmente en los fragmentos recuperados. Cualquier dato no contenido en ellos se etiqueta como alucinación.
Mide si el texto final emitido contesta directamente la duda formulada por el usuario, detectando respuestas evasivas, incompletas o circulares generadas por el modelo.
A. Arize Phoenix: El Motor de Evaluación Automatizada por Excelencia (phoenix.evals)
En la ejecución sistemática de evaluaciones de calidad, Arize Phoenix no tiene rival en el mercado open-source. Su módulo phoenix.evals fue concebido desde cero para ejecutar pipelines asíncronos y masivos de LLM-as-a-Judge con pools de concurrencia optimizados y mitigación estricta de sesgos evaluadores.
Uno de los grandes riesgos al utilizar jueces basados en LLM es el sesgo posicional (preferencia por el primer fragmento de texto presentado), el sesgo de longitud (sobrevalorar respuestas innecesariamente largas) y el sesgo de auto-afinidad (modelos de OpenAI favoreciendo textos redactados por GPT). Phoenix contrarresta estos fenómenos mediante instrucciones estructuradas en pocas pasadas (few-shot), pasos de razonamiento Chain-of-Thought obligatorios previos al veredicto y restricciones categóricas estrictas:
Phoenix ofrece evaluadores precompilados y testeados para:
- Exactitud en Preguntas y Respuestas (Q&A Correctness): Valida respuestas contra verdades fundamentales conocidas (ground truth).
- Detección de Alucinaciones: Clasificación binaria y probabilística de afirmaciones que carecen de sustento contextual.
- Calidad de Resúmenes: Valida cobertura temática, concisión y ausencia de distorsión semántica.
- Toxicidad e Inyecciones de Prompts: Escaneo automatizado de ataques adversarios y contenido que vulnera políticas de seguridad.
- Rúbricas Personalizadas: Permite escribir directrices de evaluación complejas en plantillas Jinja2 adaptadas a requerimientos normativos específicos.
from phoenix.evals import (
RAG_RELEVANCY_PROMPT_TEMPLATE,
HALLUCINATION_PROMPT_TEMPLATE,
OpenAIModel,
llm_classify
)
# 1. Cargar lote de trazas de producción o conjunto de validación dorada
df = pd.DataFrame({
"query": ["¿Cuáles son los límites de memoria de ClickHouse en Langfuse?"],
"reference": ["La configuración estándar de ClickHouse utiliza el 90% de la RAM disponible."],
"context": ["El parámetro max_server_memory_usage por defecto toma el 90% de la RAM física."],
"response": ["ClickHouse consume hasta el 90% de la memoria física del sistema por defecto."]
})
# 2. Configurar el modelo evaluador con alta concurrencia y temperatura cero
modelo_juez = OpenAIModel(model="gpt-4o-mini", temperature=0.0)
# 3. Clasificación asíncrona de alucinaciones con justificación en texto
evaluaciones = llm_classify(
dataframe=df,
template=HALLUCINATION_PROMPT_TEMPLATE,
model=modelo_juez,
rails=["factual", "alucinada"],
provide_explanation=True,
concurrency=20
)
# Genera DataFrame con etiqueta categórica ('factual'), score (1.0) y explicación causal
B. Evaluación en Langfuse: Entidades Score, Webhooks y Feedback de Usuarios
Langfuse estructura la evaluación orientándola a la monitorización continua en producción. En su modelo de datos, un Score es una entidad atómica enlazada a una traza o generación concreta. Los puntajes pueden ser numéricos (0.0 a 1.0), booleanos (Verdadero/Falso) o etiquetas categóricas ("positivo", "requiere_revision", "violacion_normativa").
Langfuse destaca en tres mecanismos de captura continua:
- API de Retroalimentación de Usuario: Registra de forma instantánea reacciones directas en frontend (botones de pulgar arriba/abajo, calificaciones de estrellas o reportes de error) y las asocia a la generación específica.
- Evaluadores LLM Asíncronos: Procesan trazas entrantes en segundo plano según tasas de muestreo definidas (por ejemplo, evaluar el 10% del tráfico con Claude 3.5 Haiku).
- Colas de Anotación Humana: Proporciona una interfaz web optimizada para que especialistas humanos (abogados, médicos o líderes de soporte) validen y califiquen respuestas en masa.
Diferenciación Clave: Phoenix es la herramienta suprema para análisis diagnóstico profundo, benchmarking riguroso pre-despliegue y control estadístico de la Tríada RAG. Langfuse sobresale en la captura operativa de retroalimentación de clientes en tiempo real y la gestión de flujos de etiquetado humano en producción.
6. Drift de Embeddings en Alta Dimensionalidad y Análisis Topológico UMAP 3D
En el desarrollo de software convencional, depurar errores de búsqueda pasa por examinar índices relacionales, consultas SQL mal formuladas o frecuencias de términos en Elasticsearch. En aplicaciones de IA corporativa construidas sobre bases de datos vectoriales (Pinecone, Qdrant, Milvus, pgvector), las fallas de recuperación ocurren en espacios latentes continuos de 1.536 o 3.072 dimensiones.
Cuando un asistente corporativo de RAG genera respuestas deficientes, las tablas tradicionales de logs son incapaces de explicar el motivo: ¿Se debe a una segmentación inadecuada de documentos (chunking)? ¿Ha cambiado el vocabulario utilizado por los clientes respecto a los manuales internos? ¿Existen grupos enteros de documentos que nunca son recuperados debido a anomalías de densidad en el índice vectorial?
A. Arize Phoenix: El Superpoder del Espacio Latente en UMAP 3D
Esta es la capacidad definitiva donde Arize Phoenix no tiene competidor alguno en el ecosistema mundial de observabilidad. Phoenix integra en su interfaz web un motor de reducción de dimensionalidad acelerado por hardware basado en UMAP 3D (Aproximación y Proyección Uniforme de Variedades).
UMAP es una técnica matemática sustentada en geometría riemanniana y topología algebraica que modela datos en alta dimensionalidad mediante conjuntos simpliciales difusos y optimiza su disposición tridimensional minimizando la entropía cruzada:
En Phoenix, los ingenieros pueden calibrar en tiempo real dos parámetros esenciales:
n_neighbors: Equilibra la conservación de la estructura local frente a la global. Valores bajos (5 a 15) aíslan micro-agrupaciones de consultas semánticamente similares (variaciones de fraseo específicas), mientras que valores altos (30 a 50) preservan el mapa temático general.min_dist: Determina la compacidad con que los puntos se agrupan en el espacio tridimensional. Valores pequeños generan islotes densos que facilitan la identificación inmediata de anomalías o consultas atípicas.
# Phoenix extrae automáticamente los vectores de embedding y el texto de consultas
session = px.launch()
# Proyecta vectores de 1.536 dimensiones en un lienzo interactivo WebGL en 3D
# Permite diagnosticar visualmente:
# 1. Zonas muertas de conocimiento (consultas de usuarios sin vectores de soporte)
# 2. Clusters fríos (grandes volúmenes de chunks indexados que jamás son recuperados)
# 3. Superposición cromática según tasa de alucinación (identificando temas de alto riesgo)
Al proyectar vectores de consultas, documentos recuperados y calificaciones de evaluación en un espacio 3D interactivo, Phoenix permite a los arquitectos resolver problemas invisibles en logs tabulares:
- Zonas Muertas de Recuperación (Knowledge Gaps): Grupos de consultas de usuarios que aterrizan en zonas espaciales vacías donde no existe ningún fragmento documental. Señalan brechas críticas en la base de documentación corporativa.
- Clusters de Documentos Fríos: Chunks de información que permanecen en densas agrupaciones vectoriales a las que ninguna consulta de usuario accede jamás, representando costo y consumo inútil de memoria en la base de datos vectorial.
- Deriva Semántica Temporal (Concept Drift): Supervisión del desplazamiento topológico en las consultas a lo largo de las semanas, alertando al equipo antes de que la precisión de búsqueda se deteriore.
- Capas Cromáticas de Alucinación: Asignación de colores según la tasa de alucinación, demostrando que los fallos no son aleatorios sino concentrados en dominios técnicos específicos.
B. Langfuse: La Ceguera en el Espacio Vectorial
Langfuse no cuenta con visualización de embeddings ni reducción de dimensionalidad. Aunque registra las llamadas a modelos de embedding (como el costo en tokens de invocar text-embedding-3-large y el texto de entrada), almacena las coordenadas vectoriales únicamente como arrays numéricos crudos en metadatos. Si un equipo en Langfuse desea detectar deriva semántica en embeddings, se ve obligado a exportar los datos desde ClickHouse hacia Jupyter Notebooks externos, ejecutar UMAP manualmente y construir gráficos con Plotly.
7. Sistemas Multi-Agente, LangGraph y Tracing de Flujos Complejos
La evolución desde sistemas RAG lineales hacia flujos multi-agente autónomos (construidos con librerías como LangGraph, CrewAI, AutoGen y LlamaIndex Workflows) ha disparado la complejidad de observabilidad. Estos sistemas se caracterizan por grafos cíclicos, máquinas de estado, llamadas dinámicas a herramientas externas y bucles de auto-corrección recursiva.
Depurar una sesión fallida no consiste únicamente en ver un texto erróneo, sino en comprender toda la causalidad: ¿Qué sub-agente decidió invocar la base de datos SQL? ¿Recibió un formato JSON roto? ¿Entró el agente supervisor en un bucle infinito intentando subsanar el fallo? ¿Cuál de los agentes consumió el 85% del presupuesto financiero de la sesión?
A. Experiencia de Tracing en Langfuse: Renderizado Superior de Grafos DAG
Langfuse ofrece lo que la comunidad de ingeniería considera unánimemente la interfaz de usuario más clara, fluida y ergonómica para trazas de grafos dirigidos acíclicos (DAG). Su vista en árbol desglosa con absoluta claridad los pasos de agentes complejos mediante nodos desplegables con distintivos visuales para spans, generaciones de LLM y eventos.
Langfuse dispone de integración nativa con LangGraph. Al acoplar el CallbackHandler() oficial al grafo compilado, Langfuse mapea automáticamente los nodos a spans, registra diferencias de estado en checkpoints y calcula de manera jerárquica el costo económico acumulado por cada sub-tarea:
from langfuse.callback import CallbackHandler
from typing import TypedDict, Annotated
import operator
class EstadoAgente(TypedDict):
mensajes: Annotated[list, operator.add]
proximo_paso: str
# Definición del flujo de trabajo
flujo = StateGraph(EstadoAgente)
flujo.add_node("supervisor", agente_supervisor)
flujo.add_node("investigador", agente_investigador)
flujo.add_node("ejecutor_sql", agente_sql)
flujo.set_entry_point("supervisor")
flujo.add_conditional_edges("supervisor", enrutamiento_condicional)
grafo = flujo.compile()
# Instrumentación inmediata mediante CallbackHandler de Langfuse
manejador_langfuse = CallbackHandler()
resultado = grafo.invoke(
{"mensajes": [("user", "Compara los IOPS en volúmenes EBS gp3 e io2 en AWS")]},
config={"callbacks": [manejador_langfuse]}
)
# Langfuse dibuja el árbol de ejecución, transiciones de estado y consumo monetario
B. Tracing de Agentes en Arize Phoenix: Alineación Semántica OpenInference
Phoenix supervisa arquitecturas multi-agente apoyándose en las categorías formales de OpenInference: spans de tipo AGENT, CHAIN y TOOL. La interfaz presenta estos flujos como líneas temporales en cascada, reflejando al nanosegundo la latencia consumida por APIs externas frente al tiempo de inferencia del modelo.
Dado que Phoenix respeta las referencias nativas de spans en OpenTelemetry (parent_span_id), permite correlacionar de manera transparente las trazas de agentes de IA con el resto de microservicios de la empresa (sistemas de pagos o catálogos) presentes en colectores corporativos como Jaeger o Datadog.
8. Despliegue Autoalojado, Helm en Kubernetes y Benchmarks de Escalabilidad
Para corporaciones en sectores altamente regulados como banca, aseguradoras, telecomunicaciones, defensa o sanidad en España y Latinoamérica, enviar trazas de LLM hacia infraestructuras multi-tenant en la nube de proveedores externos plantea graves contingencias regulatorias. Dado que las trazas contienen consultas confidenciales de clientes, propiedad intelectual y directrices de sistemas, el despliegue autoalojado en un VPC cerrado o clúster on-premises de Kubernetes resulta imperativo.
A. Arquitectura de Langfuse Autoalojado: Helm Chart Oficial para Kubernetes
Langfuse mantiene un Helm Chart corporativo diseñado para operar en entornos elásticos de producción, separando sus responsabilidades en capas modulares:
- Langfuse Web (Next.js): Procesa la interfaz de usuario, autenticación SSO, control de acceso RBAC y la API REST de gestión de prompts. Se escala horizontalmente mediante HPA en Kubernetes.
- Langfuse Worker (Node.js / BullMQ): Capa dedicada de trabajadores asíncronos que consume los lotes de trazas desde Redis, gestiona los webhooks de puntuación, ejecuta evaluadores LLM y escribe masivamente en ClickHouse.
- Clúster ClickHouse: Desplegado mediante el operador de Altinity o clúster administrado. Utiliza tablas columnares particionadas por fecha con compresión ZSTD, ingiriendo más de 50.000 trazas por segundo con bajo consumo de CPU.
- PostgreSQL (RDS / Cloud SQL): Almacén relacional transaccional para entidades de sistema, usuarios, credenciales, versionado de prompts y configuraciones de organización.
- Clúster Redis (ElastiCache): Broker en memoria de alto rendimiento que intermedia la comunicación entre los pods de ingesta web y los trabajadores en segundo plano.
services:
langfuse-server:
image: ghcr.io/langfuse/langfuse:3
ports: ["3000:3000"]
environment:
- DATABASE_URL=postgresql://postgres:secret@postgres:5432/langfuse
- CLICKHOUSE_URL=http://clickhouse:8123
- CLICKHOUSE_USER=default
- CLICKHOUSE_PASSWORD=secret
- REDIS_URL=redis://redis:6379
- NEXTAUTH_SECRET=0123456789abcdef0123456789abcdef
- SALT=0123456789abcdef
- CLICKHOUSE_ASYNC_INSERT=1
- CLICKHOUSE_WAIT_FOR_ASYNC_INSERT=0
depends_on: [postgres, clickhouse, redis]
langfuse-worker:
image: ghcr.io/langfuse/langfuse-worker:3
environment:
- DATABASE_URL=postgresql://postgres:secret@postgres:5432/langfuse
- CLICKHOUSE_URL=http://clickhouse:8123
- REDIS_URL=redis://redis:6379
depends_on: [postgres, clickhouse, redis]
clickhouse:
image: clickhouse/clickhouse-server:24.8
volumes: [ch_data:/var/lib/clickhouse]
ulimits: { nofile: { soft: 262144, hard: 262144 } }
postgres:
image: postgres:16-alpine
environment: [POSTGRES_USER=postgres, POSTGRES_PASSWORD=secret, POSTGRES_DB=langfuse]
volumes: [pg_data:/var/lib/postgresql/data]
redis:
image: redis:7-alpine
command: ["redis-server", "--maxmemory", "4gb", "--maxmemory-policy", "noeviction"]
volumes: { ch_data: {}, pg_data: {} }
B. Despliegue de Arize Phoenix: Desde DuckDB Local hasta Grandes Clústeres
Phoenix ofrece un perfil operativo extremadamente versátil:
- Entorno Local / Efímero: Un simple comando
docker run -p 6006:6006 arize-phoenixarranca la plataforma entera sobre DuckDB en menos de 5 segundos, idóneo para entornos de testing y laboratorios de ML. - Empresarial Distribuido: Opera como endpoint OTel conectado a lagos de datos Parquet (S3 o GCS) o enlazado a Arize AX Enterprise para gestión multi-tenant corporativa.
Métrica de Infraestructura | Pila Langfuse Enterprise | Arize Phoenix (OTel + Parquet/DuckDB)
--------------------------------------------------------------------------------
Memoria RAM Base Requerida | 14.5 GB RAM (Pila Completa) | 4.2 GB RAM
Cores de CPU en Pico de Ingesta | 7.8 vCPUs | 4.1 vCPUs
IOPS de Escritura en Disco | 850 IOPS (Lotes ClickHouse) | 320 IOPS (Lago Parquet)
Ratio de Compresión en Disco | 8.4 : 1 (ZSTD ClickHouse) | 7.2 : 1 (Snappy / Parquet)
Latencia de Ingesta (p99) | 18 ms (Asíncrono en Redis) | 12 ms (Directo OTLP gRPC)
Consulta Relacional de Prompts | < 5 ms (Índice PostgreSQL) | N/A (Git / ConfigMap Externo)
--------------------------------------------------------------------------------
Diagnóstico: Phoenix consume sustancialmente menos recursos de CPU y RAM para ingesta pura. No obstante, Langfuse compensa con creces su mayor demanda consolidando el almacén relacional de prompts, usuarios y métricas en una única solución sin requerir bases de datos adicionales.
9. Seguridad Empresarial, Privacidad del Código, Retención de Datos y Cumplimiento
Las trazas de modelos de lenguaje representan un desafío regulatorio sin precedentes bajo el Reglamento General de Protección de Datos (RGPD) en Europa y normativas en Latinoamérica (como la Ley General de Protección de Datos Personales en México, LGPD en Brasil o la Ley 1581 en Colombia). A diferencia de los traces tradicionales que guardan IDs o tiempos de respuesta, los spans de IA capturan texto en lenguaje natural emitido por usuarios finales y documentos confidenciales extraídos por los recuperadores vectoriales.
A. Sanitización de Datos y Ofuscación de PII en Cliente
Ambas plataformas admiten el filtrado preventivo antes de emitir paquetes a la red:
- Langfuse Hooks de Enmascaramiento: Los SDKs permiten interceptar trazas antes de ser enviadas a la cola local. Se integran de forma natural con Microsoft Presidio o expresiones regulares para ofuscar DNI, tarjetas de crédito, correos electrónicos o números telefónicos en memoria.
- Procesadores de Sanitización en Phoenix (OTel): Phoenix utiliza procesadores de atributos de OpenTelemetry. Las organizaciones pueden desplegar un gateway intermedio que aplique políticas uniformes de tokenización y anonimización sobre todos los spans antes de llegar a la base de persistencia.
from presidio_anonymizer import AnonymizerEngine
analizador = AnalyzerEngine()
anonimizador = AnonymizerEngine()
def sanitizar_texto_pii(texto_crudo: str) -> str:
entidades = analizador.analyze(text=texto_crudo, entities=["EMAIL_ADDRESS", "PHONE_NUMBER", "IBAN_CODE"], language="es")
resultado = anonimizador.anonymize(text=texto_crudo, analyzer_results=entidades)
return resultado.text
# Se inyecta en el hook mask del decorador observe de Langfuse
# Ningún dato confidencial sale del pod hacia el almacén de observabilidad
B. Arquitectura de Cero Retención de Datos (ZDR)
Para instituciones bancarias o de defensa, la retención de textos de prompts puede estar prohibida por ley. Langfuse y Phoenix permiten activar el Modo de Cero Retención (Zero Data Retention): los procesadores eliminan completamente el texto de las entradas (input_messages) y de las salidas (output_messages) en el límite del colector, almacenando únicamente identificadores de usuario, modelos invocados, latencias, puntuaciones de evaluadores y conteos de tokens para atribución de costos.
C. Certificaciones y Gobernanza de Acceso
Langfuse Cloud cuenta con certificación SOC 2 Tipo II y cumplimiento estricto de RGPD en servidores europeos. En su versión autoalojada, soporta SSO empresarial mediante SAML 2.0 (Okta, Azure AD, Google Workspace) y roles definidos (Admin, Member, Viewer). Por su parte, la infraestructura de Arize Cloud posee certificaciones SOC 2 Tipo II, HIPAA e ISO 27001, satisfaciendo los controles de seguridad de compras en corporaciones Fortune 500 y empresas del IBEX 35.
10. Cálculo del Costo Total de Propiedad TCO a 3 Años y Modelado FinOps
Implementar observabilidad de LLM sin un modelo cuantitativo de Total Cost of Ownership (TCO) suele desembocar en sobrecostos no presupuestados. Los gastos se acumulan en cuatro vectores: cómputo y almacenamiento en base de datos, licencias o tarifas SaaS por volumen, consumo de tokens en jueces de evaluación automatizada y horas de ingeniería de DevOps dedicadas al mantenimiento.
A. Formulación Matemática del Modelo FinOps
El TCO proyectado a 36 meses ($TCO_{3yr}$) se formula matemáticamente de la siguiente manera:
Donde:
- Cinfra: Costos de instancias de cómputo en AWS/GCP/Azure y almacenamiento en volúmenes NVMe para ClickHouse, PostgreSQL y Redis o colectores OTel.
- Clicencias: Planes de suscripción directa (Langfuse Cloud Pro/Team vs Arize Cloud Enterprise) o licencias comerciales de soporte.
- Cjueces_eval: Gasto en APIs por ejecución de modelos jueces (GPT-4o-mini o Claude 3.5 Haiku) sobre lotes de trazas productivas.
- Cdevops_fte: Fracción salarial imputada de ingenieros de confiabilidad (SRE) dedicados a actualizar, respaldar y mantener la pila.
- Δahorro_tokens: Ahorro financiero directo obtenido al detectar bucles infinitos en agentes, prompts sobredimensionados y aprovechar el descuento de tokens en caché.
B. Contabilidad de Tokens en Caché y Economía de Modelos
Un factor decisivo en 2026 es el reconocimiento de los descuentos por Prompt Caching:
- Anthropic Prompt Caching: En Claude 3.5 Sonnet, la lectura de tokens cacheados cuesta $0.30 por millón frente a los $3.00 estándar (un 90% de descuento). La escritura inicial cuesta $3.75.
- OpenAI Prompt Caching: En GPT-4o, los prefijos superiores a 1.024 tokens reciben automáticamente un 50% de descuento ($1.25 frente a $2.50 por millón).
Langfuse procesa estos encabezados de forma nativa e imputa el ahorro exacto por sesión. Las herramientas que no diferencian tokens cacheados sobreestiman la factura del proveedor de IA entre un 40% y un 65%, falseando la contabilidad unitaria del negocio.
C. Modelado Cuantitativo de TCO a 3 Años en Tres Escenarios
Presentamos la simulación financiera para tres arquetipos corporativos a lo largo de un período de 3 años:
| Perfil de Escenario | Langfuse (3 Años Total) | Arize Phoenix (3 Años Total) | Delta FinOps y Análisis |
|---|---|---|---|
|
Escenario 1: Startup de IA en Crecimiento 5M tokens/día, 20k trazas/día, 6 ingenieros, Langfuse Cloud Pro vs Phoenix OSS Local + Cloud |
USD $14.200 | USD $18.600 | Langfuse ahorra USD $4.400 (24%) al incluir PromptOps y soporte de nube directo |
|
Escenario 2: Empresa Mediana SaaS (RAG Avanzado) 50M tokens/día, 350k trazas/día, 25 ingenieros, alto volumen de evaluación (muestreo 10%) |
USD $118.500 | USD $136.000 | Langfuse ahorra USD $17.500 (13%) gracias a la compresión columnar en ClickHouse |
|
Escenario 3: Corporativo Multinacional (VPC Aislado) 500M tokens/día, 4M trazas/día, 120 ingenieros, Kubernetes autoalojado en AWS EKS |
USD $462.000 | USD $540.000 | Langfuse ahorra USD $78.000 (14%) por la madurez operativa de su Helm Chart |
Tanto las suscripciones SaaS a plataformas de observabilidad como los costos de inferencia en OpenAI o Anthropic se cotizan internacionalmente en dólares estadounidenses netos (USD). Al estructurar presupuestos de ingeniería desde España o países hispanohablantes de Latinoamérica, los equipos de FinOps deben incorporar cuatro contingencias fiscales y bancarias determinantes:
- Impuestos Digitales Locales (IVA): Países como Chile (19% IVA digital), México (16% IVA transfronterizo), Colombia (19%) y España (21% IVA en adquisiciones intracomunitarias) aplican retención sobre compras de software extranjero con tarjeta corporativa, salvo que se cuente con RFC/RUT corporativo registrado y validado para autoliquidación o exención.
- Retención Impositiva sobre Pagos al Exterior: En contrataciones directas de soporte o licencias empresariales con entidades en EE.UU., administraciones tributarias locales (como el SAT en México o la DIAN en Colombia) exigen retener entre un 10% y un 25% por concepto de impuesto a la renta de no residentes, obligando a gestionar certificados de residencia fiscal y convenios de doble imposición (formulario W-8BEN-E).
- Diferencial Cambiario y Comisiones de Tarjeta (FX Spread): Las entidades bancarias emisoras de tarjetas corporativas suelen aplicar márgenes de conversión entre el 1.5% y el 3.5% sobre la tasa oficial de cambio observado, incrementando el costo efectivo de cada millón de tokens consumido.
- Presupuestación para Hubs de Ingeniería Distribuidos: Para empresas con sedes de desarrollo en Bogotá, Ciudad de México, Santiago o Buenos Aires contratando servicios centralizados en dólares, el autoalojamiento de Langfuse o Phoenix sobre infraestructura cloud localmente facturada (AWS o Azure con facturación fiscal en moneda local) evita contingencias cambiarias y optimiza deducciones impositivas.
11. Manual de Migración a Producción y Arquitectura de Telemetría Dual
Un número creciente de equipos de ingeniería de élite rechaza tomar una decisión excluyente entre Langfuse y Arize Phoenix. Al constatar que Langfuse es superior para PromptOps en ejecución, contabilidad de costos y tracing de aplicaciones, mientras que Phoenix es insustituible para diagnósticos RAG con UMAP 3D y evaluación pre-despliegue, implementan una Arquitectura de Telemetría Dual.
A. Enrutamiento Dual con OpenTelemetry Collector
Aprovechando que ambas soluciones soportan el estándar OpenTelemetry, es posible configurar un OpenTelemetry Collector interno para recibir las trazas de los microservicios y bifurcarlas simultáneamente a ambos destinos:
otlp:
protocols:
grpc:
endpoint: 0.0.0.0:4317
http:
endpoint: 0.0.0.0:4318
processors:
batch:
timeout: 1s
send_batch_size: 256
exporters:
otlp/langfuse:
endpoint: "https://cloud.langfuse.com/api/public/otel"
headers:
Authorization: "Basic ${env:LANGFUSE_AUTH_HEADER}"
otlp/phoenix:
endpoint: "http://phoenix.observability.svc.cluster.local:4317"
tls:
insecure: true
service:
pipelines:
traces:
receivers: [otlp]
processors: [batch]
exporters: [otlp/langfuse, otlp/phoenix]
B. Protocolo de Migración en 4 Fases sin Tiempo de Inactividad
Si tu organización opera actualmente sobre una de las dos plataformas y requiere migrar a la otra, ejecuta el siguiente protocolo ordenado:
- Fase 1 (Abstracción de la Capa de Telemetría): Desacopla la lógica de negocio envolviendo las llamadas a LLMs en un wrapper interno o estandarizando sobre instrumentación OpenTelemetry OpenInference, evitando importar librerías propietarias en cientos de ficheros del proyecto.
- Fase 2 (Validación de Ingesta Dual): Emplea un colector OTel para duplicar el 100% del tráfico productivo hacia la plataforma principal y un 10% canario hacia el nuevo sistema. Verifica que los árboles de jerarquía y los cómputos de tokens coincidan con exactitud.
- Fase 3 (Exportación de Datasets Históricos): Exporta los conjuntos de datos de prueba y evaluaciones previas mediante scripts en Python. Langfuse facilita la extracción vía API REST y consultas SQL a ClickHouse; Phoenix permite volcar dataframes mediante DuckDB y Pandas.
- Fase 4 (Conmutación de Tráfico y Retiro): Modifica los registros DNS o las rutas de exportación del colector OTLP. Mantén la plataforma anterior en modo solo lectura durante 90 días para satisfacer auditorías normativas antes de desaprovisionar los volúmenes de almacenamiento.
12. Preguntas Frecuentes (FAQ)
1. ¿Cuál es la diferencia arquitectónica fundamental entre Langfuse y Arize Phoenix?
Langfuse está concebido como una plataforma integral de ingeniería para desarrolladores de aplicaciones con LLM, priorizando el tracing de ciclo de vida completo, la gestión de prompts con caché en cliente sin latencia, la contabilidad granular de costos por token y la curación de datasets sobre ClickHouse y PostgreSQL. Arize Phoenix es una plataforma centrada en la evaluación y la inteligencia de representaciones latentes, construida de forma nativa sobre OpenTelemetry y convenciones OpenInference, destacando en la evaluación automatizada de la Tríada RAG y la visualización topológica en 3D de drift de embeddings con UMAP.
2. ¿Puede Arize Phoenix ejecutarse de manera 100% local y aislada en un Jupyter Notebook?
Sí. Phoenix se puede lanzar de manera instantánea mediante el comando px.launch() dentro de un entorno Jupyter Notebook o script en Python. Utiliza un motor columnar integrado DuckDB en memoria o persistido en disco local, funcionando con cero dependencias externas de servidores, contenedores Docker obligatorios o credenciales en la nube.
3. ¿Cómo logra Langfuse servir prompts en producción con latencia sub-milisegundo?
Los SDKs de Langfuse implementan una capa de caché en memoria dentro del cliente con revalidación asíncrona mediante TTL en segundo plano. Cuando el servicio invoca langfuse.get_prompt("nombre"), el SDK entrega la plantilla precompilada directamente desde la memoria RAM del proceso en menos de 0.05 milisegundos, evitando viajes de red síncronos e integrando cadenas de respaldo en caso de desconexión.
4. ¿Qué es la Tríada RAG y cómo la evalúa automáticamente Arize Phoenix?
La Tríada RAG se compone de Relevancia del Contexto (si los fragmentos recuperados son pertinentes a la consulta), Fidelidad o Groundedness (si la respuesta generada proviene exclusivamente del contexto sin inventar hechos) y Relevancia de la Respuesta (si contesta con precisión lo solicitado). Phoenix proporciona evaluadores basados en LLM que procesan datasets masivos de manera asíncrona generando matrices de confusión detalladas.
5. ¿Por qué es decisiva la visualización 3D con UMAP de embeddings en la observabilidad de IA?
La calidad de recuperación en bases de datos vectoriales ocurre en espacios latentes de alta dimensionalidad (1536 o 3072 dimensiones) invisibles en logs tabulares. Phoenix utiliza UMAP en 3D para proyectar consultas y documentos, exponiendo "zonas muertas de recuperación": regiones del espacio semántico donde los usuarios hacen preguntas pero no existe documentación indexada que pueda responderles.
6. ¿Cómo se comparan Langfuse y Phoenix en consumo de recursos al autoalojarse en Kubernetes?
Bajo una carga de 1.000 trazas complejas por segundo, Langfuse requiere unos 8 vCPUs y 16GB de RAM para su pila distribuida de ClickHouse, PostgreSQL, Redis y worker Node.js. Phoenix, operando como colector OTel con DuckDB o ClickHouse, requiere unos 6 vCPUs y 12GB de RAM, aunque Langfuse ofrece mayores ventajas operativas al consolidar la administración relacional de prompts y usuarios.
7. ¿Cómo gestionan ambas plataformas la ofuscación de datos sensibles (PII) y el cumplimiento normativo?
Ambas plataformas admiten el enmascaramiento de datos antes de transmitirlos y arquitecturas de Cero Retención de Datos (ZDR) donde se descartan los textos crudos de entrada y salida, registrando únicamente métricas de tokens, latencias y evaluaciones. Langfuse cuenta con integración para Microsoft Presidio y certificación SOC 2 Tipo II en la nube, mientras que Phoenix aprovecha procesadores sanitizadores del estándar OpenTelemetry.