Portkey vs LiteLLM: Benchmark de AI Gateways Empresariales (2026)
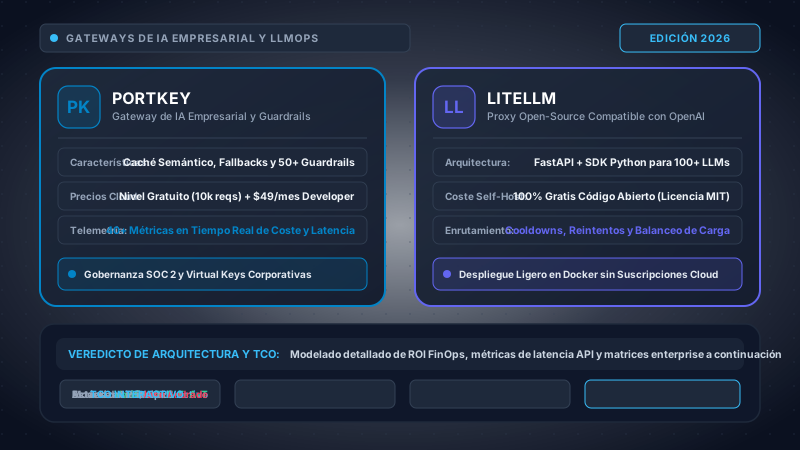
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En el panorama tecnológico empresarial de 2026, permitir que microservicios de aplicación, agentes autónomos y clientes frontend se conecten directamente a las APIs públicas de proveedores de modelos de lenguaje—como OpenAI, Anthropic, AWS Bedrock, Google Vertex AI o Azure OpenAI—se ha convertido en un antipatrón crítico e insostenible. Distribuir claves maestras de API entre múltiples repositorios, codificar clientes propietarios de cada proveedor de forma rígida y depender de reintentos ingenuos en el lado del cliente genera puntos únicos de fallo catastróficos, facturas de inferencia descontroladas y una nula visibilidad operativa entre equipos de ingeniería.
Para solucionar esta dispersión, los arquitectos de sistemas empresariales han estandarizado el Patrón de AI Gateway: una capa de proxy inverso inteligente que intercepta todas las llamadas de inferencia a LLMs, valida políticas de seguridad y guardrails, almacena en caché respuestas a prompts redundantes, enruta dinámicamente entre múltiples proveedores ante caídas y aplica techos presupuestarios estrictos antes de que los paquetes abandonen la red corporativa. En esta categoría de infraestructura, dos soluciones dominan ampliamente los despliegues de producción: Portkey y LiteLLM.
Aunque ambas plataformas cumplen el objetivo fundamental de unificar diversas APIs de LLMs bajo una interfaz compatible con el estándar de OpenAI, sus arquitecturas de sistemas, entornos de ejecución, presupuestos de latencia, superficie de mantenimiento y filosofías de gobernanza corporativa son profundamente distintas:
Portkey: Plano de Control Gestionado en el Borde
Portkey está diseñado como un gateway de IA de nivel de operador y un plano de gobernanza corporativo de latencia ultra baja. Con un núcleo de gateway open-source escrito en TypeScript optimizado para ejecutarse en aislados V8 de Cloudflare Workers o entornos Node.js ligeros, Portkey ofrece una latencia de enrutamiento sub-milisegundo (0.8ms - 1.4ms) sin precedentes.
- Mayor Fortaleza: Plano de control corporativo llave en mano con más de 50 guardrails integrados, caché semántica vectorial automática, estudio de ingeniería de prompts y modo de Retención Cero de Datos (ZDR).
- Casos de Uso Ideales: Aplicaciones SaaS de alto volumen de cara al cliente, arquitecturas B2B multi-inquilino con aislamiento presupuestario y empresas que buscan una red global perimetral sin costos de mantenimiento de infraestructura.
- Compromiso Principal: La interfaz de usuario completa, auditorías de gasto y catálogo de seguridad se entregan mediante SaaS comercial o despliegue privado VPC, mientras que el núcleo open-source es puramente headless.
LiteLLM: Proxy de Código Abierto Orientado a Desarrolladores
LiteLLM, creado por BerriAI, nació como un SDK en Python para estandarizar más de 100 proveedores en el formato de ChatCompletion de OpenAI. Ha evolucionado hasta convertirse en un microservicio proxy autohospedado basado en FastAPI, Uvicorn y Starlette, respaldado por PostgreSQL y Redis.
- Mayor Fortaleza: Base 100% de código abierto bajo licencia Apache 2.0 que puede desplegarse de manera completamente aislada (air-gapped) en clústeres internos de Kubernetes sin llamadas externas a la nube.
- Casos de Uso Ideales: Equipos de ciencia de datos e ingeniería de ML centrados en Python, plataformas internas de desarrollo y organizaciones del sector público o sanitario obligadas por normativas estrictas de soberanía de datos.
- Compromiso Principal: El runtime en Python introduce entre 8ms y 25ms de latencia proxy; escalar a alta concurrencia (>3,000 RPS) demanda aprovisionamiento horizontal de Pods, clústeres de Redis y mantenimiento continuo de PostgreSQL.
Marco de Decisión Ejecutiva: ¿Cuál Gateway Debe Estandarizar su Organización?
| Escenario Operativo Empresarial | Idoneidad de Portkey | Idoneidad de LiteLLM | Recomendación Estratégica |
|---|---|---|---|
| SaaS para Clientes con Latencia Crítica (>2,000 RPS) | Óptima (Aislados V8 de borde sub-1ms) | Aceptable (15ms-45ms de overhead proxy) | Portkey por su enrutamiento perimetral determinista. |
| Centro de Datos Soberano y Air-Gapped / VPC Aislada | Capaz (Licencia enterprise self-hosted) | Óptima (Open-source Apache 2.0 puro) | LiteLLM por su despliegue sin dependencias externas. |
| Guardrails Llave en Mano y Anonimización de PII | Superior (50+ verificaciones nativas) | Requiere Configuración (Presidio / hooks) | Portkey elimina el aprovisionamiento de microservicios extra. |
| Claves Virtuales B2B y Presupuestos por Inquilino | Excepcional (Token buckets distribuidos) | Sólida (Gestión vía Redis + PostgreSQL) | Portkey para topes sin condiciones de carrera. |
| Gestión y Versionado de Prompts con Evaluaciones | Integrado (Playground y LLM-as-a-judge) | Inexistente (Requiere Langfuse/Phoenix) | Portkey ofrece un plano unificado; LiteLLM requiere stack múltiple. |
Si su equipo de ingeniería requiere un gateway de IA listo para producción con latencia ultra baja en el borde global, más de 50 guardrails de seguridad listos para usar, caché semántica vectorial integrada y observabilidad completa de prompts sin absorber tareas complejas de mantenimiento de plataforma, Portkey es la opción ganadora. Por el contrario, si su organización construye una plataforma interna de datos en Python, opera bajo mandatos estrictos de soberanía en centros de datos desconectados o cuenta con especialistas en DevOps para Kubernetes capaces de administrar clústeres de Redis y PostgreSQL, LiteLLM Proxy proporciona máxima flexibilidad y total ausencia de dependencia de proveedores.
2. Topologías de Gateway, Runtimes y Mecánica de Paquetes de Red
La disparidad técnica fundamental entre Portkey y LiteLLM se origina en los estratos más profundos de la arquitectura de sistemas: el entorno de ejecución, el bucle de eventos asíncronos, la gestión del pool de conexiones TCP y el manejo de flujos de eventos Server-Sent Events (SSE) bajo alta concurrencia.
Portkey: Aislados V8, TypeScript e Ingress Sub-Milisegundo en el Borde
El núcleo del gateway de Portkey ha sido desarrollado desde sus cimientos en TypeScript puro y moderno, prescindiendo por completo de frameworks web pesados. Está optimizado para dos entornos de ejecución: Node.js (aprovechando el cliente HTTP nativo undici y el bucle de eventos libuv) y Cloudflare Workers (ejecutándose dentro de aislados de V8).
Al desplegarse en la red perimetral Anycast de Cloudflare, una solicitud HTTP entrante termina en el punto de presencia (PoP) más cercano entre más de 300 ciudades globales. Dentro del aislado V8, Portkey analiza los encabezados HTTP, valida la clave virtual contra una caché distribuida en memoria, evalúa las políticas de guardrails previas al enrutamiento, consulta las claves de caché exacta y semántica, y envía la solicitud al proveedor de LLM mediante conexiones pre-negociadas y multiplexadas sobre HTTP/2 con keep-alive activo.
Dado que los aislados V8 eliminan el peso de sistemas operativos virtualizados o contenedores pesados (iniciándose en menos de 5 milisegundos con una huella de memoria inferior a 15 megabytes), Portkey añade únicamente entre 0.8ms y 1.4ms de overhead de latencia de proxy en solicitudes no cacheadas.
LiteLLM: Python 3.12, FastAPI, Uvicorn y Concurrencia AsyncIO
LiteLLM Proxy se ejecuta como un servicio web en Python estructurado sobre FastAPI y Starlette, utilizando el servidor ASGI Uvicorn con la implementación de bucle de eventos en C uvloop. LiteLLM se encarga de traducir las solicitudes en formato OpenAI a las estructuras de datos de cada proveedor (como el formato messages de Anthropic, la API Converse de AWS Bedrock o los buffers Protobuf de Gemini en Google Cloud) mediante diccionarios de Python.
Las conexiones salientes se gestionan a través de pools asíncronos mediante httpx.AsyncClient. La autenticación de claves virtuales, límites de tasa y presupuestos se comprueban consultando una base de datos PostgreSQL (mediante Prisma Python ORM) y una instancia distribuida de Redis.
Aunque uvloop proporciona un excelente rendimiento de sockets a nivel C, el entorno CPython está restringido por el Global Interpreter Lock (GIL). En Python 3.12, tareas con alta carga de CPU—como la validación de esquemas JSON voluminosos, la ejecución de expresiones regulares complejas para escaneo de datos sensibles y el formateo de matrices de tokens—se ejecutan de manera síncrona en el bucle principal. En escenarios de alta concurrencia, esto sitúa la latencia añadida de LiteLLM entre 12ms y 28ms en condiciones normales, alcanzando picos de 65ms a 95ms en el percentil p99 ante la saturación de los workers.
Flujo de Paquetes: Comparativa del Ciclo de Vida de la Solicitud
PIPELINE DE BORDE EN PORTKEY (TypeScript / Aislados V8)
========================================================================================
[Cliente App] ──HTTPS/2──► [PoP Global Cloudflare / Motor Node.js] (Ingress <1ms)
                               │
                               ├─► 1. Validación de Clave Virtual y Tasa (Memoria / LRU)
                               ├─► 2. Ejecución de Guardrails de Entrada (Regex / Lakera)
                               ├─► 3. Búsqueda en Caché Exacta / Semántica (Redis / Vector DB)
                               │      └─► [CACHE HIT] ──► Flujo SSE Inmediato Sintetizado (12ms)
                               │
                               ├─► 4. Selección Dinámica de Objetivo (Canary / Fallback)
                               ├─► 5. Despacho Multiplexado HTTP/2 ──► [Proveedor Upstream]
                               │                                          (OpenAI / Anthropic)
                               │                                                   │
[Cliente App] ◄──Reenvío de Chunks SSE (Buffer Zero-Copy) ◄────────────────────────┘
                               │
                               └─► 6. Volcado Asíncrono de Telemetría (OpenTelemetry)

----------------------------------------------------------------------------------------

PIPELINE DEL PROXY LITELLM (Python / FastAPI / Uvicorn)
========================================================================================
[Cliente App] ──HTTPS/1.1─► [Nginx / Controlador Ingress] ──► [Worker Uvicorn] (~15ms Overhead)
                                                                 │
                               ├─► 1. Verificación Asíncrona de Presupuesto ──► [Redis / Postgres]
                               ├─► 2. Middlewares (Llamada HTTP a Microsoft Presidio)
                               ├─► 3. Consulta de Caché (Redis / ChromaDB Vector)
                               │      └─► [CACHE HIT] ──► Retorno de Respuesta Cacheada
                               │
                               ├─► 4. Transformación de Payloads en Python (OpenAI a Claude)
                               ├─► 5. Despacho httpx.AsyncClient ──► [Proveedor Upstream]
                               │                                           │
[Cliente App] ◄──Generador asíncrono yield chunks (Tarea AsyncIO) ◄─────────┘
                               │
                               ├─► 6. Cálculo de Tokens consumidos y costo en memoria
                               └─► 7. Escritura en BD ──► [Tabla PostgreSQL LiteLLM_SpendLogs]
Streaming Server-Sent Events (SSE) y Consumo de Memoria Bajo Carga
Dado que más del 90% de las aplicaciones de IA en producción dependen del streaming de tokens mediante Server-Sent Events (SSE) para brindar una experiencia interactiva fluida al usuario final, la capacidad del gateway para sostener conexiones HTTP abiertas durante periodos prolongados sin fugas de memoria es esencial.
En Portkey, los fragmentos de streaming se canalizan mediante primitivas nativas de la Web Streams API (ReadableStream y TransformStream). En el entorno perimetral V8, esto permite un reenvío de bytes de copia cero (zero-copy): los paquetes de tokens se transmiten de inmediato por el socket TCP del cliente sin almacenar la respuesta completa en el heap de memoria. Como resultado, Portkey mantiene una huella plana de aproximadamente 45MB de memoria por cada 1,000 conexiones concurrentes de streaming activas.
En LiteLLM, el streaming se procesa a través de generadores asíncronos en Starlette (StreamingResponse). Debido a que LiteLLM calcula el recuento de tokens en paralelo y analiza las señales de cierre de conexión para asentar el costo final en PostgreSQL, retiene búferes intermedios en la memoria de Python. Bajo una carga de prueba de 1,000 conexiones simultáneas de streaming, un solo worker de Uvicorn consume entre 280MB y 420MB de RAM. Además, si el cliente desconecta abruptamente su navegador, el proxy debe sondear periódicamente request.is_disconnected() para evitar que la llamada upstream continúe facturando tokens innecesariamente.
3. Enrutamiento Resiliente, Fallbacks Dinámicos y Circuit Breaking
En infraestructuras de inteligencia artificial en producción, los fallos en los proveedores no son incidentes fortuitos: constituyen una certeza operativa diaria. Los proveedores principales arrojan frecuentemente errores HTTP 429 (Límite de Tasa Excedido) en horarios de alta demanda, presentan degradaciones temporales de servicio (HTTP 500/503), enfrentan escasez de capacidad en modelos de última generación (como Claude 3.5 Sonnet o GPT-4o) o agotan el límite de la ventana de contexto.
Tanto Portkey como LiteLLM ofrecen capas avanzadas de abstracción de enrutamiento, pero sus metodologías de configuración, algoritmos de conmutación por error y mecanismos de circuit-breaker reflejan filosofías de ingeniería contrapuestas.
Portkey: Configuraciones Declarativas JSON/YAML y Balanceo Canary
Portkey gestiona el enrutamiento mediante un modelo completamente desacoplado y declarativo. Las reglas de conmutación y balanceo (denominadas Portkey Configs) se definen como documentos JSON o YAML centralizados en el registro del plano de control, y son invocadas dinámicamente por las aplicaciones mediante un encabezado HTTP simple: x-portkey-config: pc-enrutamiento-produccion-v2. Esto faculta a los equipos de plataforma para reconfigurar topologías de enrutamiento, ajustar porcentajes canary o esquivar caídas de centros de datos de manera instantánea, sin necesidad de reiniciar servicios ni desplegar nuevo código en producción.
Portkey admite estrategias avanzadas de resiliencia:
- Reintentos Automáticos con Backoff Exponencial y Jitter: Presupuestos de reintentos configurables para códigos de error específicos (como 429, 500, 502, 503, 504) con retrasos aleatorios para evitar sobrecargas masivas.
- Cadenas de Fallback Multi-Proveedor: Si Azure OpenAI en la región Este devuelve un error 429, Portkey conmuta inmediatamente a OpenAI directo, luego a Claude 3.5 Sonnet en AWS Bedrock y finalmente a una instancia privada de vLLM con DeepSeek-V3.
- Balanceo de Carga Ponderado (Canary Releases): Dirige el 85% del tráfico de producción a GPT-4o mientras canaliza un 15% a Claude 3.5 Sonnet para benchmarking automatizado de costo, velocidad y precisión.
- Enrutamiento Condicional por Parámetros: Conmuta dinámicamente solicitudes que superen los 16,000 tokens hacia modelos de contexto masivo (como Gemini 1.5 Pro) o reserva instancias de rendimiento provisionado para clientes VIP.
{
  "strategy": {
    "mode": "fallback",
    "on_status_codes": [429, 500, 502, 503, 504]
  },
  "targets": [
    {
      "provider": "azure-openai",
      "api_key": "vault:azure-eastus-key",
      "resource_name": "corp-ai-prod",
      "deployment_id": "gpt-4o-global",
      "override_params": { "temperature": 0.2 },
      "retry": {
        "attempts": 3,
        "on_status_codes": [429],
        "backoff_factor": 1.5
      }
    },
    {
      "strategy": {
        "mode": "loadbalance"
      },
      "targets": [
        {
          "provider": "openai",
          "api_key": "vault:openai-master-key",
          "override_params": { "model": "gpt-4o" },
          "weight": 0.7
        },
        {
          "provider": "anthropic",
          "api_key": "vault:anthropic-key",
          "override_params": { "model": "claude-3-5-sonnet-20241022" },
          "weight": 0.3
        }
      ]
    },
    {
      "provider": "bedrock",
      "aws_region": "us-west-2",
      "override_params": { "model": "anthropic.claude-3-5-sonnet-20241022-v2:0" }
    }
  ]
}
LiteLLM: Clase Router, config.yaml y Enfriamientos Dinámicos
LiteLLM gestiona la resiliencia a través de su clase Python Router, la cual puede configurarse mediante código o de forma estática en el archivo config.yaml que se lee al inicializar el contenedor del proxy.
El enrutador de LiteLLM agrupa los despliegues bajo alias lógicos (por ejemplo, asignando tres endpoints de Azure y una clave de OpenAI bajo el nombre unificado gpt-4o), permitiendo diversas estrategias de balanceo:
simple-shuffle: Distribución aleatoria de solicitudes entre los despliegues activos disponibles.least-busy: Asigna la nueva petición al modelo que presente el menor número de solicitudes concurrentes activas.usage-based-routing: Supervisa el consumo en tiempo real de Tokens por Minuto (TPM) y Peticiones por Minuto (RPM) en Redis, enviando el tráfico a los despliegues con mayor cuota disponible.latency-based-routing: Calcula una media móvil exponencial del Tiempo al Primer Token (TTFT) y de la latencia total, enrutando dinámicamente hacia el endpoint más veloz.
model_list:
  - model_name: gpt-4o
    litellm_params:
      model: azure/gpt-4o-eastus
      api_base: https://corp-eastus.openai.azure.com/
      api_key: os.environ/AZURE_EASTUS_KEY
      rpm: 10000
      tpm: 800000
  - model_name: gpt-4o
    litellm_params:
      model: azure/gpt-4o-westus
      api_base: https://corp-westus.openai.azure.com/
      api_key: os.environ/AZURE_WESTUS_KEY
      rpm: 8000
      tpm: 600000
  - model_name: gpt-4o
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_DIRECT_KEY
      rpm: 5000

router_settings:
  routing_strategy: latency-based-routing
  routing_strategy_args:
    ttl: 30
  allowed_fails: 3
  cooldown_time: 60
  num_retries: 2
  timeout: 10
  fallbacks:
    - gpt-4o: ["claude-3-5-sonnet", "bedrock-claude"]

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL
  redis_url: os.environ/REDIS_URL
Mecánica de Circuit Breaking y Prevención de Caídas en Cascada
Una distinción técnica sustancial radica en la máquina de estados del disyuntor (circuit breaker). Cuando un endpoint de un proveedor de modelos comienza a fallar de forma recurrente, continuar enviándole tráfico satura los pools de conexiones y prolonga innecesariamente la latencia que experimenta el usuario final.
En LiteLLM, el disyuntor se gestiona mediante las directivas allowed_fails y cooldown_time registradas en Redis. Al registrar 3 fallos consecutivos, el endpoint entra en un periodo de enfriamiento de 60 segundos durante el cual se ignora por completo. Una vez expira este temporizador, se reactiva de golpe al 100% del tráfico, lo cual puede desencadenar un colapso en manada (thundering herd) si el proveedor aún no se ha estabilizado.
En Portkey, el disyuntor implementa un autómata finito de tres estados (Cerrado, Abierto, Semi-Abierto). Al superar el umbral de errores, el circuito se abre. Al finalizar el tiempo de enfriamiento, entra en estado Semi-Abierto: únicamente un 2% del tráfico se canaliza para sondear la disponibilidad del servicio. Solo cuando estas peticiones de prueba devuelven códigos HTTP 200 con latencias normales, Portkey restaura progresivamente el flujo total, protegiendo la arquitectura frente a oscilaciones y caídas secundarias.
4. Ingeniería de Caché Semántica y Almacenamiento por Coincidencia Exacta
A medida que las aplicaciones de inteligencia artificial evolucionan hacia flujos de agentes autónomos multi-paso, arquitecturas RAG (Retrieval-Augmented Generation) y asistentes conversacionales corporativos, la inferencia redundante se convierte en el mayor factor de desperdicio en los presupuestos de nube. En entornos de soporte o bases de conocimiento internas, entre el 35% y el 60% de las consultas entrantes comparten una intención idéntica o semánticamente equivalente a preguntas procesadas con anterioridad.
Implementar un motor de caché inteligente en la capa de gateway intercepta estas solicitudes redundantes antes de que lleguen a los proveedores externos. Esto convierte una llamada que tarda 1,200ms y cuesta $0.03 por respuesta en un acierto local de 12ms con un costo insignificante de $0.00002.
Caché por Coincidencia Exacta: Hash SHA-256 e Invalidación por Etiquetas
La caché exacta funciona de forma determinista. Al recibir una petición, el gateway calcula un hash criptográfico SHA-256 normalizando la estructura del JSON: eliminando espacios en blanco irrelevantes, ordenando claves de objetos e incorporando el modelo, temperatura y texto del prompt del sistema.
En LiteLLM, la caché exacta puede respaldarse en un diccionario en memoria (limitado a desarrollo local), una instancia de Redis o un bucket de AWS S3. Aunque es veloz (menos de 2ms mediante Redis), carece de un sistema integrado para purgar selectivamente claves asociadas a versiones de documentación sin ejecutar comandos SCAN y DEL que pueden degradar el rendimiento de Redis en producción.
En Portkey, la caché exacta se vincula con etiquetas de invalidación (Cache Invalidation Tags). Por ejemplo, se pueden marcar las respuestas con la etiqueta manual_rrhh_v3. Cuando los documentos internos se actualizan, el equipo de ingeniería puede purgar miles de respuestas almacenadas mediante una simple petición REST: POST /v1/cache/invalidate?tag=manual_rrhh_v3, además de definir TTLs granulares por espacio de trabajo.
Caché Semántica: Embeddings Vectoriales, Similitud Coseno y Riesgos de Falsos Positivos
La caché semántica va más allá de la igualdad léxica. Cuando un usuario pregunta “¿Cómo cambio mi contraseña de inicio de sesión único?” y otro usuario consulta después “¿Cuál es el procedimiento para restablecer mis credenciales de SSO?”, la caché semántica detecta la equivalencia de significado y devuelve la respuesta previamente generada.
El flujo técnico de la caché semántica se ejecuta en tres fases:
- Generación de Embeddings: El texto entrante se transforma en un vector denso mediante un modelo de incrustación de alta velocidad (como
text-embedding-3-smallo FastEmbed ONNX). - Búsqueda en Índice Vectorial: El vector se compara contra una base de datos vectorial (Qdrant, Redis Vector Search, Milvus o ChromaDB) utilizando algoritmos de Vecino Más Cercano Aproximado (ANN) como HNSW calculando la Similitud Coseno.
- Evaluación de Umbral: Si la distancia coseno es inferior al límite de tolerancia (por ejemplo, distancia ≤ 0.05, lo que representa una similitud ≥ 95%), se devuelve la respuesta en caché. Si excede el umbral, se considera un fallo de caché, se consulta al modelo en la nube y se guarda de forma asíncrona la nueva pareja de vectores.
Benchmark Cuantitativo de Caché: Coincidencia Exacta vs. Semántica vs. Sin Caché
| Ruta de Ejecución | Latencia en Portkey | Latencia en LiteLLM | Costo de Tokens (1k In / 500 Out) | Infraestructura Requerida |
|---|---|---|---|---|
| Acierto en Caché Exacta | 1.2 ms | 4.8 ms | $0.00000 (100% de ahorro) | Redis / KV en Memoria |
| Acierto en Caché Semántica | 14.5 ms | 38.2 ms | $0.00002 (Solo embedding) | Qdrant / Milvus / Redis Vector |
| Fallo de Caché (Llamada GPT-4o) | 1,120 ms | 1,148 ms | $0.01250 (Inferencia completa) | API Externa del Proveedor |
El Peligro Crítico de los Falsos Positivos: Si el umbral de similitud se configura con demasiada holgura (por ejemplo, 0.85), se producen errores operativos graves. En aplicaciones financieras o contables, consultas como “¿Puedo transferir $5,000 sin comisiones?” y “¿Puedo transferir $50,000 sin comisiones?” comparten más del 91% de similitud vectorial, pero responder con los datos de la primera consulta genera una respuesta errónea. Portkey incorpora comprobaciones semánticas que respetan entidades numéricas específicas para bloquear la contaminación cruzada entre parámetros cuantitativos.
5. Guardrails Empresariales, Gobernanza y Moderación de Contenido
Al habilitar modelos de lenguaje en aplicaciones corporativas, los sistemas quedan expuestos a vulnerabilidades de seguridad singulares: inyección indirecta de prompts, técnicas de jailbreak para eludir restricciones, fuga de información confidencial o datos de tarjetas de crédito y generación de código con comandos peligrosos.
La intercepción y filtrado mediante guardrails en el gateway garantiza que las amenazas se detecten y bloqueen antes de que la petición llegue al modelo upstream, ahorrando costos de inferencia y blindando el perímetro de seguridad corporativo.
Portkey: Más de 50 Guardrails Nativos y Acciones Automatizadas
Portkey concibe la seguridad como un componente nativo de su canalización. En lugar de obligar al equipo de desarrollo a orquestar múltiples APIs de seguridad externas, Portkey incluye un catálogo de más de 50 verificaciones prediseñadas, complementadas con integraciones directas con Lakera Guard, Protect AI, AWS Bedrock Guardrails y Llama Guard.
Las reglas de seguridad se configuran en dos etapas clave:
- Verificaciones Previas (Pre-Call): Detección de inyección de instrucciones, bloqueo de jailbreaks, anonimización y enmascaramiento de PII (números de Seguro Social, tarjetas de crédito, correos corporativos y nombres mediante NER), filtrado de contenido sin sentido y cumplimiento lingüístico.
- Verificaciones Posteriores (Post-Call): Detección de lenguaje tóxico, menciones no autorizadas de competidores, cálculo de alucinación frente a fragmentos de contexto RAG, validación estricta de esquemas JSON y escaneo de inyecciones SQL o comandos de shell en código generado.
- Políticas de Ejecución: Al detectar una infracción, Portkey puede aplicar tres tipos de respuesta:
reject(devolver un código HTTP 400 con un mensaje seguro),redact(enmascarar los datos identificables con etiquetas[REDACTADO]antes del envío) ofallback(conmutar silenciosamente a un modelo de seguridad estricto).
{
  "guardrails": {
    "before_request_hooks": [
      {
        "id": "lakera-prompt-injection",
        "action": "reject",
        "parameters": { "threshold": 0.85 },
        "custom_error_message": "Violación de seguridad: Se ha detectado una estructura de prompt adversaria."
      },
      {
        "id": "pii-masking",
        "action": "redact",
        "parameters": {
          "entities": ["CREDIT_CARD", "US_SSN", "EMAIL_ADDRESS"],
          "masking_character": "[PROTEGIDO]"
        }
      }
    ],
    "after_request_hooks": [
      {
        "id": "json-schema-validator",
        "action": "fallback",
        "parameters": {
          "schema": {
            "type": "object",
            "properties": {
              "estado": { "type": "string" },
              "nivel_confianza": { "type": "number" }
            },
            "required": ["estado", "nivel_confianza"]
          }
        }
      }
    ]
  },
  "targets": [{ "provider": "openai", "override_params": { "model": "gpt-4o" } }]
}
LiteLLM: Integración con Microsoft Presidio y Middlewares en Python
LiteLLM delega la gobernanza en microservicios externos de código abierto, integrándose con Microsoft Presidio para la anonimización de PII y con Llama Guard para la moderación general.
Para habilitar el enmascaramiento de datos personales en LiteLLM, es necesario mantener contenedores independientes para los servicios presidio-analyzer y presidio-anonymizer, los cuales el proxy invoca por HTTP en cada petición. Su mayor atractivo radica en la capacidad de programar ganchos asíncronos nativos en Python mediante la clase CustomLogger, permitiendo a los desarrolladores insertar reglas personalizadas de cumplimiento interno sin salir del ecosistema de Python.
6. Claves Virtuales, Multi-Inquilino y Control Presupuestario de FinOps
Proporcionar claves de API maestras (como tokens raíz de OpenAI o credenciales de AWS) directamente a desarrolladores o aplicaciones es una práctica de alto riesgo de seguridad y el motivo más común de sobrecostos imprevistos en FinOps. Un script con un bucle infinito puede consumir decenas de miles de dólares en pocas horas.
Ambos gateways solucionan este problema mediante el concepto de Claves Virtuales de API: credenciales sintéticas con permisos acotados emitidas por el gateway que se vinculan a las cuentas maestras almacenadas de forma segura en un baúl encriptado.
Portkey: Jerarquía Organizacional y Topes de Gasto con Auto-Killswitch
Portkey organiza la gobernanza en una jerarquía empresarial sólida: Organización → Espacios de Trabajo (Workspaces) → Claves Virtuales → Configuraciones → Bóveda de Proveedores.
- Límites Financieros Estrictos (Killswitches): Se pueden asignar topes de gasto diarios, semanales o mensuales por clave o por equipo. Al alcanzar el 100% del presupuesto, el borde de Portkey activa un interruptor de parada de emergencia automático, devolviendo un error HTTP 429 sin realizar llamadas externas a los proveedores.
- Límites de Tasa Paramétricos: Control de Peticiones por Minuto (RPM), Tokens por Minuto (TPM) y Peticiones por Día (RPD).
- Fijación de Configuraciones: Una clave virtual puede asociarse de forma obligatoria a una plantilla de prompt o configuración de enrutamiento específica, impidiendo que el cliente altere los parámetros de temperatura o evada los guardrails corporativos.
- Atribución de Centros de Costos: Cada petición puede incluir metadatos JSON arbitrarios (como
cliente_idocentro_costo), permitiendo a los líderes de finanzas desglosar con precisión el costo unitario por producto o cliente.
LiteLLM: Gestión de Claves en PostgreSQL y Registro Distribuido en Redis
LiteLLM almacena sus claves virtuales en PostgreSQL dentro de la tabla LiteLLM_VerificationToken, mientras que los contadores de gasto y límites de tasa activos se gestionan en Redis. Los administradores pueden aprovisionar claves mediante el panel de control o por vía de su API REST en el endpoint /key/generate:
curl -X POST "http://localhost:4000/key/generate" \
  -H "Authorization: Bearer sk-litellm-master-key" \
  -H "Content-Type: application/json" \
  -d '{
    "models": ["gpt-4o", "claude-3-5-sonnet"],
    "max_budget": 500.0,
    "budget_duration": "30d",
    "tpm_limit": 100000,
    "rpm_limit": 500,
    "metadata": {
      "equipo": "analitica-datos",
      "proyecto": "informes-trimestrales"
    }
  }'
Control de Concurrencia y Condiciones de Carrera: Para evitar que ráfagas simultáneas de solicitudes superen el presupuesto asignado, LiteLLM utiliza operaciones atómicas en Redis (INCRBYFLOAT) respaldadas por scripts Lua. Portkey emplea una arquitectura distribuida de token bucket en la memoria perimetral de sus puntos de presencia, garantizando validaciones sub-milisegundo sin cuellos de botella en la base de datos central.
7. Herramienta Interactiva y Simulación Cuantitativa de TCO de FinOps a 3 Años
Al comparar gateways de IA, los directores de ingeniería y líderes de FinOps caen a menudo en la trampa de considerar que el código abierto equivale a costo cero. Aunque LiteLLM ofrece un núcleo libre bajo licencia Apache 2.0, operar un gateway en producción a escala empresarial implica costos ocultos significativos: nodos de cómputo en Kubernetes, clústeres de Redis multi-AZ de alta disponibilidad, instancias de base de datos PostgreSQL administradas, transferencia de datos entre zonas de disponibilidad y, fundamentalmente, horas de ingeniería DevOps dedicadas al mantenimiento y resolución de incidentes.
Por otro lado, Portkey aplica un modelo de suscripción SaaS o VPC transparente que incluye el cómputo perimetral global, habilita ahorros automáticos inmediatos mediante caché semántica y elimina por completo la carga de gestión de infraestructura interna.
Los precios de software de infraestructura de IA y consumo de APIs se cotizan internacionalmente en dólares estadounidenses (USD netos). Al presupuestar desde empresas de habla hispana, es indispensable considerar cuatro factores económicos determinantes:
- Impuestos a Servicios Digitales del Exterior (IVA): Países como España (21% IVA), México (16% IVA transfronterizo), Chile (19% IVA digital) y Colombia (19%) retienen automáticamente este tributo al pagar plataformas SaaS en el extranjero mediante tarjeta corporativa, salvo que la entidad cuente con un RFC/RUT empresarial registrado como sujeto pasivo directo.
- Retenciones en la Fuente por Remesas al Exterior: En diversas jurisdicciones de la región (como Colombia con retenciones del 15% al 20% para software importado, o Argentina con esquemas de impuestos PAIS/percepciones aduaneras de divisas), la contratación directa de SaaS foráneo puede incrementar el desembolso financiero real entre un 15% y un 30% respecto a la factura neta.
- Diferencial Cambiario y Comisiones de Tarjeta (FX Spread): Las entidades bancarias locales suelen aplicar sobrecargas de conversión cambiaria de entre el 1.5% y el 3.5% sobre la tasa oficial de cambio al procesar pagos en USD.
- Arbitraje de Salarios de Ingeniería en la Región: En contraste con los costos salariales de Estados Unidos ($160k - $210k anuales para un ingeniero senior de DevOps / SRE), en hubs tecnológicos de Latinoamérica (Ciudad de México, Bogotá, Buenos Aires, Santiago) un ingeniero de plataforma senior percibe entre $45,000 y $75,000 USD anuales. Esto altera el balance de rentabilidad de FinOps: autohospedar LiteLLM resulta comparativamente más accesible en costo de mano de obra en LATAM que en Norteamérica o Europa occidental.
Modelado Matemático: Costo Total de Propiedad (TCO) a 36 Meses en 3 Escenarios
A continuación, desglosamos tres proyecciones de gasto proyectadas a 3 años considerando un crecimiento anual compuesto del volumen de inferencias del 25%:
Escenario A: Startup Tecnológica en Crecimiento (15 Desarrolladores, 10M Peticiones/Mes)
Perfil de Carga: 10 millones de llamadas al mes (~4 RPS promedio, 35 RPS pico). Promedio por petición: 800 tokens de entrada, 250 tokens de salida. Proveedores: OpenAI GPT-4o y Anthropic Claude 3.5 Sonnet.
| Rubro de Costo (Anualizado) | Portkey (Plan Scale) | LiteLLM Proxy (Autohospedado OSS) | Dinámica de FinOps |
|---|---|---|---|
| Licencias de Software / Suscripción SaaS | $5,880 ($490/mes base) | $0 (Apache 2.0 Open-Source) | LiteLLM comunitario no requiere costo de licencia de software. |
| Cómputo en la Nube (Nodos EKS / GKE) | $0 (Incluido en la red perimetral) | $3,240 (3x instancias t4g.medium) | LiteLLM requiere mínimo 3 nodos en 3 zonas de disponibilidad para HA. |
| Base de Datos PostgreSQL y Redis Gestionados | $0 (Administrado por Portkey) | $2,160 (RDS Postgres + ElastiCache) | Postgres para claves y auditoría; Redis para limitación de tasa. |
| Mano de Obra DevOps de Mantenimiento | $2,040 (24 horas/año de ajustes) | $12,240 (144 horas/año de soporte) | Actualización de imágenes Docker, migraciones de esquema y guardias. |
| Ahorro Neto por Caché Semántica (18% aciertos) | -$8,640 (Reducción en factura de LLM) | -$2,880 (Requiere vector store propio) | La caché lista de Portkey disminuye el consumo de tokens de inmediato. |
| Costo Neto / (Ahorro Neto) en Año 1 | -$720 (Retorno Financiero Positivo) | $14,760 Costo Neto | Portkey genera $15,480 de ventaja neta en el primer año. |
Escenario B: Empresa Scale-Up en Expansión (60 Desarrolladores, 100M Peticiones/Mes)
Perfil de Carga: 100 millones de peticiones mensuales (~40 RPS promedio, 350 RPS pico). 60 desarrolladores en 8 escuadrones de producto. Petición promedio: 1,200 tokens de entrada, 350 de salida.
| Componente Financiero (Anualizado) | Portkey Enterprise | LiteLLM Enterprise (Autohospedado) | Análisis Comparativo |
|---|---|---|---|
| Licenciamiento de Software / Asientos | $28,000 / año | $14,400 (60 puestos @ $20/mes) | Licencia LiteLLM Enterprise obligatoria para SSO y auditorías. |
| Cómputo en Kubernetes y Balanceadores | $0 (Incluido en servicio gestionado) | $14,800 (8x instancias c6g.xlarge + ALB) | Alta concurrencia en Uvicorn distribuido en 3 zonas de nube. |
| Bases de Datos de Alta Disponibilidad | $0 (Gestionado) | $9,600 (Postgres Aurora + Redis Cluster) | Instancias db.r6g.large con replicación multizona activa. |
| Horas de Plataforma e Ingeniería DevOps | $4,080 (48 horas/año) | $32,640 (384 horas/año = 0.20 FTE) | Mantenimiento de clústeres, resolución de cuellos de botella e índices. |
| Ahorro de Tokens por Caché Semántica (22%) | -$79,200 (Ahorro comprobado) | -$42,000 (Gestión propia en Qdrant) | La caché semántica de Portkey amortiza ampliamente la suscripción. |
| Balance Neto en Año 1 | -$47,120 (Rentabilidad Neta) | $29,440 Costo Neto | Ventaja neta de $76,560 anuales a favor de Portkey. |
Escenario C: Corporación Global Fortune 500 (400 Ingenieros, 1,000 Millones de Peticiones/Mes)
| Proyección Consolidada a 3 Años (25% Crecimiento) | Portkey Enterprise VPC / Cloud | LiteLLM Enterprise (K8s Propio) | Diferencial Económico |
|---|---|---|---|
| Año 1 Costo Total | $84,000 | $182,400 | Portkey ahorra $98,400 |
| Año 2 Costo Total (+25% Carga) | $98,000 | $224,500 | Portkey ahorra $126,500 |
| Año 3 Costo Total (+25% Carga) | $114,000 | $278,200 | Portkey ahorra $164,200 |
| TCO Acumulado a 3 Años | $296,000 | $685,100 | Ahorro Neto: $389,100 (-56.8%) |
8. Observabilidad, Trazabilidad Distribuida, Gestión de Prompts y Evaluaciones
Supervisar modelos de IA en producción requiere métricas mucho más especializadas que los simples códigos de respuesta HTTP de una API tradicional. Los equipos de ingeniería necesitan visibilidad en tiempo real sobre el Tiempo al Primer Token (TTFT), la velocidad de generación (tokens/segundo), el desvío semántico y el gasto exacto por equipo.
Portkey: Observabilidad Unificada, Estudio de Prompts y Evaluaciones LLM-as-a-Judge
Portkey integra de fábrica un entorno completo de telemetría y evaluación sin necesidad de instrumentar código en las aplicaciones:
- Trazabilidad Nativa con OpenTelemetry (OTel): Mapea árboles jerárquicos de tramos (spans) en aplicaciones RAG complejas (Prompt → Búsqueda Vectorial → Re-ranking → Generación → Validación de Guardrail).
- Estudio de Prompts Colaborativo y Control de Versiones: Permite redactar plantillas con sintaxis Mustache (
{{nombre_usuario}}), versionar cambios y desplegar a producción sin recompilar código. - Playground Comparativo Simultáneo: Prueba un prompt contra 4 modelos al mismo tiempo (como GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro y Mistral Large), comparando latencia, costo y calidad de respuesta en paralelo.
- Evaluaciones Automatizadas (LLM-as-a-Judge): Configuración de evaluadores automáticos para puntuar la veracidad, relevancia y ausencia de toxicidad en las respuestas de producción.
LiteLLM: Exportador de Prometheus y Conexión con Ecosistemas Externos
LiteLLM adopta una postura abierta y desacoplada. No intenta proveer un panel de versionado de prompts ni un entorno de evaluación integrado. En su lugar, expone un endpoint estándar /metrics para ser recolectado por Prometheus y exportado a paneles de Grafana, además de integraciones directas mediante callbacks con herramientas como Langfuse, Helicone, Datadog y Sentry.
9. Seguridad Corporativa, Cumplimiento Normativo y Modo de Retención Cero de Datos (ZDR)
Para instituciones bancarias, compañías de seguros y organizaciones del sector salud, la privacidad del flujo de datos de IA está sujeta a auditorías rigurosas. La intercepción no autorizada de prompts puede provocar la fuga de secretos comerciales, propiedad intelectual o datos médicos protegidos (PHI).
Arquitectura de Retención Cero de Datos (Zero Data Retention - ZDR)
Portkey cuenta con un modo certificado de Retención Cero de Datos (ZDR). Al activarse:
- Los prompts, instrucciones del sistema y respuestas de inferencia se procesan exclusivamente en memoria RAM volátil dentro de los aislados de borde V8.
- Ningún texto de prompt ni contenido generado se almacena en discos duros, bases de datos relacionales ni registros permanentes.
- Únicamente se retienen metadatos no sensibles (conteo de tokens, códigos de estado, latencias y códigos de error) para conciliación contable de FinOps.
- Portkey suscribe acuerdos de asociados comerciales para HIPAA (BAA) y cuenta con certificación anual SOC 2 Tipo II e ISO 27001.
En LiteLLM, de forma predeterminada, el proxy registra el payload completo de cada solicitud y respuesta en la tabla PostgreSQL LiteLLM_SpendLogs. Para habilitar una política de retención cero, el administrador de infraestructura debe configurar expresamente litellm.turn_off_message_logging = True en config.yaml.
Despliegues Soberanos y Desconectados (Air-Gapped)
En entidades gubernamentales o empresas sujetas a leyes estrictas de soberanía digital nacional que prohíben la salida de datos hacia plataformas SaaS extranjeras, LiteLLM Open-Source posee una ventaja determinante: puede desplegarse dentro de clústeres de Kubernetes 100% aislados de Internet (air-gapped), sin llamadas de verificación de licencias, enrutando peticiones exclusivamente hacia modelos locales alojados en vLLM o servidores Ollama internos.
10. Matriz Comparativa Exhaustiva de 25 Dimensiones
A continuación se presenta el benchmark técnico integral que analiza a Portkey y LiteLLM en 25 factores arquitectónicos decisivos para despliegues de ingeniería y producción empresarial:
| Criterio de Evaluación | Portkey | LiteLLM Proxy | Ganador Arquitectónico |
|---|---|---|---|
| 1. Entorno y Runtime Principal | TypeScript / Aislados V8 / Cloudflare Edge o Node.js | Python 3.12 / FastAPI / Starlette / Uvicorn (uvloop) | Portkey (Aislados V8 sub-1ms) |
| 2. Overhead de Latencia Proxy | 0.8ms - 1.4ms (p50), <3.5ms (p99) | 12ms - 25ms (p50), 45ms - 80ms (p99) | Portkey (10x menor penalización) |
| 3. Licenciamiento de Código Abierto | Open-Core (Gateway Apache 2.0; UI y control propietarios) | Código abierto puro (Apache 2.0; Enterprise pagada) | LiteLLM (Código base más permisivo) |
| 4. Disponibilidad de SaaS Gestionado | Sí (Más de 300 PoPs, SLA de 99.99%) | No oficial (Exclusivamente autohospedado) | Portkey (Cero gestión de infraestructura) |
| 5. Despliegue Air-Gapped Soberano | Compatible (Requiere contrato VPC Enterprise) | Nativo (Docker / Helm, sin llamadas a Internet) | LiteLLM (Despliegue local sin barreras) |
| 6. Proveedores de LLM Homologados | 250+ Proveedores (Comerciales y locales) | 100+ Proveedores (Grandes nubes y servidores locales) | Portkey (Catálogo más extenso) |
| 7. Reglas de Enrutamiento Declarativas | JSON / YAML versionados con actualización sin caídas | config.yaml o código Python (requiere recargar pod) | Portkey (Invocación dinámica por slug) |
| 8. Fallbacks Multi-Proveedor | Matrices multi-nivel con filtrado por código HTTP | Listas de conmutación por alias de modelo | Empate (Ambos manejan 429/500/503 con eficacia) |
| 9. Algoritmos de Balanceo de Carga | Canary ponderado, round-robin, enrutamiento condicional | Basado en latencia, menor carga, uso de cuota y shuffle | LiteLLM (Más algoritmos de balanceo) |
| 10. Arquitectura de Circuit Breaking | Tres estados (Cerrado / Abierto / Sonda Semi-Abierta) | Dos estados (Activo / Periodo de Enfriamiento en Redis) | Portkey (Evita colapsos en manada) |
| 11. Caché de Coincidencia Exacta | Sub-2ms con invalidación granular por etiquetas | Redis / Memoria (Carece de purga por etiquetas) | Portkey (Purga selectiva por versión) |
| 12. Caché Semántica Vectorial | Nativa integrada (Sin requerir bases de datos extra) | Requiere aprovisionar y gestionar Qdrant/ChromaDB | Portkey (Caché vectorial totalmente gestionada) |
| 13. Catálogo de Guardrails Nativos | 50+ Verificaciones (PII, inyecciones, alucinaciones, JSON) | Requiere contenedores externos de Presidio o Llama Guard | Portkey (Seguridad integral lista para usar) |
| 14. Extensibilidad con Middlewares | Webhooks HTTP y funciones en JavaScript de borde | Ganchos asíncronos y clases personalizadas en Python | LiteLLM (Flexibilidad insuperable en Python) |
| 15. Gobernanza de Claves Virtuales | Multi-inquilino: Organización → Workspace → Clave | Almacenadas en PostgreSQL: Clave / Usuario / Equipo | Empate (Excelente aislamiento en ambos) |
| 16. Topes Presupuestarios e Interruptor de Parada | Killswitch perimetral sin sobrecostos por carreras | Operaciones atómicas INCRBYFLOAT en Redis | Portkey (Garantía estricta de cero sobregiro) |
| 17. Atribución Contable de Centros de Costo | Agregación de metadatos JSON arbitrarios en tiempo real | Metadatos almacenados en registros de PostgreSQL | Portkey (Filtrado visual interactivo en UI) |
| 18. Estudio y Versionado de Prompts | Entorno visual integrado, Mustache y playground simultáneo | No disponible (Requiere Langfuse o Phoenix) | Portkey (Plano unificado de ingeniería de prompts) |
| 19. Evaluaciones LLM-as-a-Judge | Pipelines de evaluación automatizada continuos | Requiere herramientas de evaluación externas | Portkey (Retroalimentación continua en producción) |
| 20. Trazabilidad con OpenTelemetry (OTel) | Sí (Exportador nativo OTLP gRPC/HTTP) | Sí (Generación de spans OTel para llamadas LLM) | Empate (Integración limpia con estándares OTel) |
| 21. Recolección de Métricas en Prometheus | Disponible mediante reenviadores Datadog/CloudWatch | Endpoint /metrics nativo para Prometheus | LiteLLM (Estándar nativo para Prometheus) |
| 22. SSO / SAML y Aprovisionamiento SCIM | Integrado en plan Enterprise (Okta, Azure AD, Google) | Disponible solo en la edición comercial LiteLLM Enterprise | Empate (Ambos requieren contrato empresarial) |
| 23. Modo de Retención Cero de Datos (ZDR) | Modo ZDR auditado (Procesamiento en RAM, cero disco) | Configurable desactivando logging en PostgreSQL | Portkey (ZDR formalmente certificado) |
| 24. Certificaciones de Cumplimiento | SOC 2 Tipo II, HIPAA BAA, RGPD, ISO 27001 | Heredadas de la infraestructura interna de la empresa | Portkey (Informes de auditoría listos para clientes) |
| 25. TCO Consolidado a 3 Años (FinOps) | Menor TCO ($296,000 para 1B peticiones/mes) | Mayor TCO ($685,100 incluyendo mano de obra K8s/DevOps) | Portkey (56.8% de ahorro financiero neto) |
11. Preguntas Frecuentes Técnicas (FAQ)
Resoluciones técnicas a las dudas de arquitectura más habituales al implementar Portkey y LiteLLM en infraestructuras corporativas:
12. Guía de Migración y Lista de Verificación para Producción
La transición desde llamadas directas a un gateway de IA corporativo puede llevarse a cabo de forma progresiva sin tiempo de inactividad:
Opción A: Migración al SDK de Portkey en Python
Portkey ofrece un SDK para Python que envuelve al cliente oficial de OpenAI, inyectando encabezados de rastreo, claves virtuales y slugs de configuración de forma transparente:
from portkey_ai import Portkey

# Inicialización con Clave Virtual y Slug de Configuración de Enrutamiento
portkey = Portkey(
    api_key="PORTKEY_API_KEY",              # Clave del plano de control
    virtual_key="vk-openai-prod-4b2a",      # Mapea a la clave protegida en vault
    config="pc-enrutamiento-resiliente-v2"  # Reglas declarativas de reintento/fallback
)

# Llamada estándar compatible con OpenAI con streaming y telemetría automática
response = portkey.chat.completions.create(
    messages=[
        {"role": "system", "content": "Eres un arquitecto especialista en FinOps empresarial."},
        {"role": "user", "content": "Calcula el costo amortizado de operar 20 réplicas de workers Uvicorn."}
    ],
    model="gpt-4o",
    temperature=0.2,
    stream=True
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Opción B: Migración al Proxy LiteLLM con el SDK de OpenAI
Al utilizar LiteLLM Proxy, no es necesario instalar librerías propietarias adicionales; simplemente se redirige base_url hacia el proxy interno:
from openai import OpenAI

# Apuntar el cliente estándar de OpenAI hacia el proxy interno
client = OpenAI(
    api_key=os.environ.get("LITELLM_VIRTUAL_KEY"),      # Clave emitida por el proxy
    base_url="https://litellm-proxy.empresa.corp/v1"
)

response = client.chat.completions.create(
    model="azure-gpt-4o-alias",              # Alias configurado en config.yaml
    messages=[
        {"role": "system", "content": "Eres un arquitecto de seguridad en la nube."},
        {"role": "user", "content": "Analiza los trade-offs entre aislados V8 y el GIL de Python."}
    ],
    temperature=0.3
)

print(response.choices[0].message.content)
Lista de Verificación para Producción Empresarial
José Andrade
Staff Systems Architect & FinOps ModelerFundador y Editor Principal en CloudBizStack. José se especializa en arquitecturas de AI gateways distribuidos, topologías de Kubernetes y modelos cuantitativos de TCO y FinOps para infraestructura en la nube.