Redpanda vs Apache Kafka: Benchmark de Motores de Streaming (2026)
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
Durante más de una década, Apache Kafka ha constituido el estándar indiscutible para la arquitectura orientada a eventos en el entorno empresarial global. Creado originalmente en LinkedIn en 2011 y comercializado posteriormente por Confluent, Kafka demostró que un registro de confirmación append-only, particionado e inmutable, era capaz de ofrecer una escalabilidad horizontal inalcanzable para los brokers tradicionales de mensajería como RabbitMQ o IBM MQ.
Sin embargo, la infraestructura de hardware sobre la que operan los centros de datos modernos ha sufrido una transformación radical en estos últimos quince años. En 2011, los servidores de producción operaban con discos magnéticos mecánicos (HDD) o unidades de estado sólido SATA tempranas limitadas a 300–500 IOPS, redes a 1 Gbps y procesadores de 4 núcleos. En aquel contexto histórico, delegar la gestión del almacenamiento en el Page Cache del sistema operativo Linux y utilizar la llamada sendfile() desde la máquina virtual Java (JVM) constituía una solución de diseño sumamente elegante.
En 2026, las instancias en la nube pública y los servidores dedicados equipan de 64 a 192 núcleos físicos de CPU, unidades SSD NVMe sobre PCIe 5.0 capaces de entregar más de 1.000.000 de IOPS con latencias de acceso inferiores a 10 microsegundos, y tarjetas de red conectadas a 100 Gbps o 200 Gbps. En este nuevo entorno tecnológico, el diseño basado en JVM de Apache Kafka muestra una fricción estructural ineludible: la recolección de basura genera pausas stop-the-world (STW), el volcado síncrono del Page Cache de Linux bloquea las llamadas al sistema y la contención de bloqueos entre hilos agota el ancho de banda del bus de memoria del procesador.
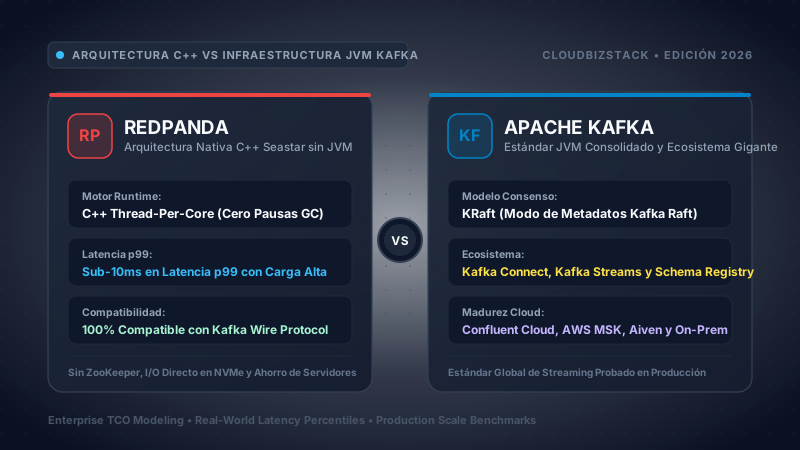
Aquí es donde surge Redpanda. Diseñado desde cero en C++20 moderno por Alex Gallego sobre el framework de alto rendimiento Seastar (el mismo motor asíncrono que impulsa a ScyllaDB), Redpanda redefine el registro de streaming para aprovechar directamente las unidades NVMe, las topologías NUMA multicore y la E/S con omisión de kernel. Al mismo tiempo que mantiene una compatibilidad absoluta con el protocolo de red de Apache Kafka, Redpanda elimina por completo la JVM, prescinde de la dependencia del Page Cache del sistema operativo, suprime la necesidad de controladores externos KRaft o ZooKeeper, y reduce el consumo de computación y hardware hasta en un factor de 3x.
Cuándo Elegir Redpanda
- Acuerdos de Nivel de Servicio (SLA) Estrictos en Latencia de Cola: Cargas de trabajo en fintech, banca electrónica, trading algorítmico, prevención de fraude o ad-tech que exigen latencias P99 inferiores a 10 ms y P99.9 inferiores a 25 ms de forma predecible a cientos de miles de eventos por segundo.
- Optimización Agresiva de FinOps en Infraestructura Cloud: Iniciativas corporativas orientadas a recortar el número de instancias EC2/GCE entre un 50% y un 70%, generando ahorros de cientos de miles de dólares en facturación cloud trianual.
- Simplicidad Operativa Radical: Equipos de ingeniería que buscan erradicar el mantenimiento continuo de heaps en la JVM, la afinación de recolectores (G1GC vs ZGC) y la gestión de clústeres satélite; Redpanda es un binario C++ estático y autosuficiente.
- Estrategia Nativa de Almacenamiento por Niveles (Tiered Storage): Descarga automática y asíncrona de segmentos hacia buckets S3, GCS o Azure Blob con retención infinita y caché NVMe transparente que no degrada la memoria RAM.
- Despliegues en el Borde (Edge), ARM64 y Kubernetes: Consumo de memoria ultraligero (desde 1 GB de RAM por núcleo), ideal para microservicios contenerizados y dispositivos edge.
Cuándo Elegir Apache Kafka
- Ecosistema Java y Kafka Streams Profundamente Arraigado: Organizaciones con cientos de microservicios existentes basados en Kafka Streams, interceptores personalizados en Java, particionadores ad-hoc o plugins compilados contra librerías internas de la JVM.
- Catálogo Extenso de Conectores Certificados: Dependencia operativa de cientos de conectores de Kafka Connect certificados por fabricantes comerciales de software empresarial.
- Madurez del Talento en Operaciones SRE: Equipos de operaciones y administradores de sistemas que cuentan con amplia experiencia previa en la optimización de métricas JMX, perfiles de volcado de memoria (heap dumps) y runbooks de Kafka.
- Gobernanza Compleja de Clientes Multitenant: Clústeres corporativos consolidados que requieren políticas de cuotas de red sumamente específicas y suites de gobernanza de metadatos propietarias de Confluent Platform.
- Estandarización en Proveedores Gestionados Tradicionales: Contratos marco que exigen servicios gestionados como AWS MSK o Aiven bajo compromisos de servicio (SLA) específicos de dichos proveedores.
Marco de Decisión Estratégico para 2026
Para cualquier nuevo proyecto de ingeniería de datos, expansión de backbone de streaming de alta tasa de transferencia o migración orientada a frenar el gasto desmedido en AWS MSK o clústeres Kafka autohospedados, Redpanda representa la opción arquitectónicamente superior. Proporciona reemplazo directo sin reescribir una sola línea de código en las aplicaciones cliente, reduce la latencia de cola entre 3x y 6x y simplifica de forma extraordinaria las operaciones diarias. Por contra, si el sistema existente reside en un parque empresarial histórico con fuerte acoplamiento a código propietario en Java y acuerdos corporativos consolidados, Apache Kafka 3.9/4.0 con KRaft sigue siendo una alternativa válida y conservadora, siempre que la organización disponga de los recursos económicos y del equipo humano especializado para gestionar la JVM.
2. Arquitectura de Cómputo y Concurrencia: C++ Seastar Thread-Per-Core vs JVM KRaft
El rendimiento y la estabilidad de un motor de mensajería bajo cargas extremas no dependen primordialmente de trucos de optimización superficiales, sino del modelo fundamental con el que gestiona los núcleos de la CPU, organiza el acceso a la memoria y despacha las operaciones de red y disco.
El Framework Seastar y el Modelo Thread-Per-Core (TPC) sin Estado Compartido
Redpanda está construido de manera integral sobre Seastar, un framework de programación asíncrona en C++ desarrollado para exprimir arquitecturas modernas con decenas de núcleos y topologías de acceso no uniforme a memoria (NUMA). En lugar de seguir el paradigma tradicional de subprocesos múltiples gestionados de forma arbitraria por el planificador del sistema operativo, Seastar adopta un modelo estricto de hilo por núcleo físico (Thread-per-Core - TPC) sin memoria compartida (shared-nothing):
- Afinidad Rígida de CPU (Core Pinning): Durante el arranque, Redpanda inspecciona la topología del procesador y genera exactamente un hilo de ejecución por cada núcleo físico de CPU, fijándolo de forma permanente mediante la llamada
pthread_setaffinity_np(). Ningún otro hilo disputa el tiempo de procesamiento en ese núcleo. - Arenas de Memoria Aisladas por Núcleo: A cada hilo se le asigna de manera exclusiva una porción estática de la memoria física RAM, mapeada directamente desde el controlador de memoria del nodo NUMA local correspondiente a ese socket de CPU. Un hilo asignado al núcleo 0 jamás interactúa directamente con la memoria asignada al núcleo 1.
- Erradicación Total de Bloqueos (Lock-Free): Al eliminar el estado compartido entre núcleos, Redpanda prescinde de primitivas de sincronización atómicas a nivel de hardware (como instrucciones
LOCK CMPXCHG), mutexes (std::mutex) o candados de lectura/escritura en su ruta de datos principal. Esto suprime por completo las tormentas de invalidación de líneas de caché provocadas por el protocolo de coherencia MESI del procesador. - Paso de Mensajes mediante Colas Circulares SPSC: Cuando el núcleo 0 necesita transferir información al núcleo 1 (por ejemplo, si una conexión de red TCP finaliza en el núcleo 0 pero el líder Raft de la partición reside en el núcleo 1), el núcleo emisor coloca la tarea en una cola circular lock-free de un solo productor y un solo consumidor (SPSC) alineada con los límites de línea de caché. El núcleo 1 procesa esta cola de forma ordenada dentro de su propio bucle de eventos en espacio de usuario.
- Planificación Cooperativa en Espacio de Usuario: En lugar de permitir que el planificador CFS del kernel de Linux interrumpa arbitrariamente los hilos mediante cambios de contexto forzados —lo cual destruye los registros de CPU, limpia las tablas de traducción de direcciones (TLB) y desaloja las cachés L1/L2—, Seastar ejecuta micro-tareas voluntariamente cooperativas gestionadas mediante promesas y futuros de C++20 que devuelven el control en cuestión de microsegundos.
El Modelo de Pools de Hilos y Contención de Bloqueos en Apache Kafka
Apache Kafka conserva el diseño clásico multihilo de Java desarrollado hace más de diez años. La ejecución de solicitudes se reparte entre múltiples pools de subprocesos independientes:
- Hilos de Procesamiento de Red (
num.network.threads): Atienden los sockets TCP de los clientes usando selectores Java NIO, desencapsulan los paquetes del protocolo Kafka y depositan los objetos de solicitud en una cola de memoria global compartida. - Pool de Hilos de Gestión de E/S (
num.io.threads): Desencolan peticiones desde la cola central, resuelven la partición de destino, adquieren bloqueos de exclusión mutua, comprueban permisos ACL, interactúan con el sistema de archivos y generan las respuestas. - Hilos de Réplica (
num.replica.fetchers): Hilos adicionales en segundo plano que solicitan datos de réplica a otros brokers del clúster. - Hilos de Mantenimiento y Compactación: Tareas concurrentes dedicadas a la rotación de ficheros de registro y la compactación de mensajes borrados.
Bajo volúmenes de tráfico masivos, este diseño introduce el fenómeno de dispersión de hilos y degradación de caché (cache thrashing). En Kafka, un mensaje es recibido por el Hilo de Red A en el núcleo 2, transferido a una cola compartida protegida por un ReentrantLock, recogido por el Hilo de E/S B programado por el kernel en el núcleo 15, y devuelto finalmente al cliente por el Hilo de Red C en el núcleo 6. Cada salto intermedio obliga al procesador a invalidar memorias caché locales, sincronizar líneas a través de los buses inter-socket (Intel UPI o AMD Infinity Fabric) y realizar costosos cambios de contexto en modo kernel.
Metadatos KRaft en Kafka frente al Controlador Raft Integrado de Redpanda
A partir de Apache Kafka 3.3 y completado en Kafka 4.0 mediante KIP-500, la comunidad de Kafka eliminó la dependencia externa de Apache ZooKeeper mediante la adopción de KRaft (Kafka Raft metadata mode). En KRaft, un quórum interno de brokers dedicados gestiona una partición interna especial denominada @metadata. El QuorumController activo procesa las operaciones de catálogo y sincroniza el estado hacia los brokers seguidores.
Aunque KRaft supone un avance indiscutible respecto a ZooKeeper, mantiene una estricta desconexión interna: KRaft se limita únicamente a la gestión de metadatos del clúster, mientras que los datos reales de los mensajes en las particiones continúan dependiendo del algoritmo clásico de Réplicas en Sincronía (ISR).
En cambio, Redpanda unifica el consenso de metadatos y el consenso de particiones bajo una única arquitectura de software. En Redpanda, los metadatos globales del clúster se gestionan mediante un grupo Raft interno de control, y cada partición individual de cada topic constituye por sí misma un grupo de consenso Raft autónomo. Ambos subsistemas comparten el mismo motor de ejecución en C++, eliminando complejidades de capas cruzadas.
3. Gestión de Memoria: Cero Recolección de Basura vs Pausas STW y Trampas del Page Cache
La gestión de la memoria física constituye la línea divisoria más crítica entre Redpanda y Apache Kafka. Las decisiones tomadas en este apartado determinan la resistencia a la latencia en cola bajo estrés continuo, la dificultad de afinación operativa y los límites físicos de densidad de datos.
El Dilema Inevitable del Recolector de Basura (GC) en la JVM
En Apache Kafka, cada mensaje recibido por el broker genera objetos transitorios en el heap de la máquina virtual Java. Si un clúster procesa una tasa sostenida de 500 MB/s con mensajes de 1 KB, el broker debe instanciar y destruir más de 500.000 objetos Java por segundo (incluyendo instancias de RecordBatch, DefaultRecord, envoltorios de ByteBuffer, cabeceras de contexto de red y objetos de telemetría interna).
Este ritmo vertiginoso de instanciación ejerce una presión brutal sobre el recolector de basura de la JVM:
- La Frontera de los 32 GB y Punteros Comprimidos (Compressed OOPs): Los arquitectos de Kafka suelen restringir el heap de la JVM a un máximo de 31 GB. Superar los 32 GB desactiva la técnica de punteros ordinarios comprimidos, forzando a la máquina virtual a emplear referencias directas de 64 bits, lo que infla el consumo de memoria en un 35% y desborda las líneas de caché del procesador.
- Límites Físicos de G1GC y Generational ZGC: Aunque las versiones modernas de Java (OpenJDK 21+) incluyen avances notables como Generational ZGC, ningún recolector de basura puede violar las leyes de la física. Ante incrementos súbitos de carga o congestión en el almacenamiento, la tasa de reserva de memoria de la aplicación supera la velocidad de marcado concurrente del recolector (situación conocida como allocation stall). En este instante crítico, la JVM detiene forzosamente todos los hilos del proceso en una pausa stop-the-world para reordenar la memoria.
- Caídas en Cascada por Desconexión de Brokers: Cuando un broker sufre una pausa de recolección de basura imprevista de 1.000 ms a 2.500 ms, el controlador KRaft y los brokers pares detectan la pérdida de señales de vida (heartbeats). El clúster declara al nodo como inactivo, inicia la reelección masiva de particiones y satura a los brokers restantes con tráfico redirigido. Cuando el nodo pausado sale del ciclo de GC y reanuda su actividad, provoca un nuevo ciclo de rebalanceo. Este comportamiento oscilatorio es la causa principal de incidencias graves en clústeres Kafka empresariales.
La Trampa del Page Cache del Sistema Operativo Linux
Para impedir que el heap de la JVM crezca hasta tamaños inmanejables, Kafka delega el almacenamiento en caché de los mensajes directamente en la memoria RAM gestionada por el kernel de Linux. En un servidor con 128 GB de memoria, se suelen destinar únicamente 16 GB al heap de Java, dejando los 112 GB restantes para que el sistema operativo los utilice como Page Cache.
Sin embargo, esta estrategia introduce fricciones severas en entornos de alta exigencia:
- Estrés por Volcado de Páginas Sucias (Dirty Page Flushes): Cuando los productores escriben datos, Kafka ejecuta llamadas al sistema
write()ordinarias. El kernel acepta los bytes en memoria RAM y marca las páginas correspondientes como "sucias". En cuanto el volumen acumulado supera el umbralvm.dirty_background_ratio(habitualmente 10%), los hilos del kernel (kswapd) inician la escritura física en disco. Si el flujo entrante desborda el límitevm.dirty_ratio(habitualmente 20%), el kernel fuerza a los propios hilos de Kafka a detenerse para sincronizar páginas con el soporte físico. Durante este intervalo, la latencia de escritura de Kafka se dispara de 2 ms a más de 400 ms. - Bloqueos de Semáforos de Inodo (
inode->i_rwsem): Mientras el kernel vuelca páginas sucias al disco, adquiere semáforos exclusivos sobre los inodos de los archivos afectados y establece el flagPG_lockedsobre los buffers de memoria. Cualquier hilo concurrente que intente acceder a ese segmento queda suspendido en estado de espera no interrumpible (estadoDen Linux). - Doble Duplicación de Memoria: Durante la verificación de sumas de comprobación CRC o la descompresión de mensajes, los datos se copian forzosamente tanto en el Page Cache del kernel como en buffers internos dentro de la JVM, desaprovechando la mitad de la memoria física disponible.
El Motor de Memoria Determinista en Espacio de Usuario de Redpanda
Redpanda supera estas limitaciones reemplazando conjuntamente la JVM y el Page Cache por un gestor de memoria determinista en espacio de usuario:
- Reserva Estática Inicial: Al arrancar, Redpanda reserva de forma inmutable entre el 80% y el 90% de la memoria física del servidor usando
mmap()con los parámetrosMAP_POPULATEymlockall(), impidiendo por completo que el sistema operativo envíe páginas a disco swap. - Asignador Customizado Seastar Slab/Buddy: La memoria reservada se fragmenta en bloques gestionados de forma local por cada hilo de núcleo con complejidad temporal O(1), eliminando cualquier rastro de fragmentación externa.
- Erradicación Total del Recolector de Basura: La gestión del ciclo de vida de los datos se rige estrictamente por el principio RAII (Resource Acquisition Is Initialization) de C++ y punteros inteligentes de bajo overhead (
seastar::lw_shared_ptr). En cuanto un lote de mensajes se persiste físicamente en la unidad NVMe y se transmite a los sockets de red, la memoria asignada se reintegra al pool libre del núcleo correspondiente. No existe recolector de basura, no hay ciclos de marcado y es imposible que se produzca una pausa STW. - Arquitectura con Omisión de Caché (
O_DIRECT): Todos los archivos de log de Redpanda se abren con el flagO_DIRECTde Linux. Todas las operaciones de lectura y escritura eluden por completo el Page Cache del kernel. Las transferencias se efectúan directamente entre la memoria RAM de usuario de Redpanda y la unidad NVMe física mediante DMA (Direct Memory Access).
4. Motor de Almacenamiento, Llamadas al Kernel y E/S Directa sobre NVMe
El subsistema de persistencia en disco es el elemento determinante del que emanan el rendimiento bruto y la estabilidad de las colas de procesamiento. La confrontación entre la llamada tradicional sendfile() de Apache Kafka y el modelo basado en io_uring de Redpanda ilustra con claridad dos generaciones técnicas distintas.
El Camino de E/S de Kafka: Las Dos Caras de la Moneda de sendfile()
La celebrada eficiencia histórica de Kafka se sustentó en el empleo de la llamada sendfile() de Linux (comúnmente conocida como transferencia de copia cero). Cuando un consumidor solicita datos de una partición, Kafka evita duplicar la información hacia la memoria de la JVM mediante FileChannel.transferTo():
Cuando todos los consumidores leen el flujo en tiempo real (consumo en caliente), los registros ya residen en la memoria RAM del Page Cache. En esta situación óptima, sendfile() proporciona una tasa de transferencia sobresaliente con un consumo mínimo de procesador.
El Colapso ante Lecturas en Frío (Cold Reads): En entornos empresariales de producción reales, los consumidores no siempre operan en la cabeza del registro. Conectores hacia Snowflake, procesos de reentrenamiento de modelos analíticos o cargas por lotes solicitan con frecuencia datos generados horas o días atrás. Cuando se produce una petición sobre un offset antiguo:
- El bloque solicitado no está en el Page Cache.
- La llamada
sendfile()se bloquea de forma síncrona dentro del kernel de Linux mientras espera que la unidad física (EBS o SSD) lea los datos hacia la RAM. - Dado que los hilos de red de Kafka son los encargados de gestionar esta transferencia, el hilo completo queda suspendido en estado de sueño no interrumpible.
- Todas las demás conexiones de red asignadas a ese hilo —incluyendo productores críticos en tiempo real— quedan paralizadas.
- La entrada masiva de datos históricos desaloja los datos calientes del Page Cache, provocando un ciclo destructivo de desalojo de memoria que multiplica la latencia general del clúster entre un 400% y un 1.500%.
El Motor Moderno de Redpanda: io_uring y Acceso Directo a NVMe
Redpanda nació en plena madurez de las unidades de estado sólido NVMe sobre interfaces PCIe 4.0 y 5.0. Una unidad NVMe actual dispone de un paralelismo físico descomunal: admite hasta 64.000 colas de E/S paralelas, con hasta 64.000 comandos simultáneos por cola. Las llamadas al sistema POSIX tradicionales serializan los accesos y asfixian a las controladoras de disco modernas.
Para explotar el potencial del hardware contemporáneo, Redpanda aprovecha Linux io_uring:
- Colas Circulares Compartidas con el Kernel:
io_uringestablece dos anillos de memoria lock-free compartidos directamente entre el espacio de usuario de Redpanda y el kernel de Linux: la Submission Queue (SQ) y la Completion Queue (CQ). - Agrupación sin Llamadas al Sistema: Los núcleos de Redpanda depositan lotes de comandos de escritura física en la cola de envío en espacio de usuario y notifican al kernel mediante una única llamada agrupada o a través de sondeo autónomo por parte del kernel (
IORING_SETUP_SQPOLL), ahorrando miles de cambios de contexto por segundo. - Alineación en Bloques de 4 KB con
O_DIRECT: Todos los buffers de datos de Redpanda están perfectamente alineados con los sectores físicos de 4096 bytes de las unidades NVMe, permitiendo transferencias DMA directas entre memoria RAM de usuario y el disco físico sin intermediación de páginas de kernel. - Planificador de E/S con Reparto Justo (Fair Queueing): Redpanda impide que las lecturas históricas o la compactación degraden el tráfico en tiempo real. Seastar incorpora un planificador de prioridades de E/S interno: las escrituras de clientes en tiempo real y los latidos Raft disponen de 1.000 participaciones (prioridad máxima), mientras que las descargas hacia la nube y las lecturas frías están restringidas a 100 participaciones. Si la unidad de almacenamiento se aproxima a la saturación, las lecturas frías son automáticamente moduladas, garantizando que la latencia P99 de los productores permanezca inmune.
Ajuste Automático de Hardware: rpk redpanda tune all
Uno de los componentes más apreciados por los ingenieros de sistemas en Redpanda es su optimizador automatizado: rpk redpanda tune all. En lugar de requerir que el operador configure manualmente parámetros arcanos del kernel en sysctl.conf, el comando analiza la plataforma física y aplica las optimizaciones automáticamente:
5. Consenso, Semántica de Replicación y Escalabilidad de Particiones
Cualquier sistema distribuido de streaming debe garantizar que un mensaje confirmado jamás se extraviará, corromperá o desordenará, incluso frente a caídas repentinas de servidores, desconexiones de red o fallos de almacenamiento físico. Examinamos a continuación las diferencias operativas entre el modelo Raft por partición de Redpanda y el protocolo ISR de Kafka.
El Consenso Raft Descentralizado por Partición de Redpanda
Redpanda prescinde de la coordinación centralizada para la persistencia de datos y adopta el consenso Raft ejecutado directamente a nivel de partición. Si un clúster aloja 1.000 particiones con factor de replicación 3, Redpanda mantiene 1.000 grupos de consenso Raft plenamente autónomos repartidos entre los núcleos del clúster:
- Quórum Estricto de Mayoría: Para una partición con replicación 3 y confirmación
acks=all, el mensaje se da por confirmado en cuanto el líder de la partición y al menos un seguidor han persistido el registro en sus ficheros de registro Raft. El cálculo de quórum es estrictamente matemático y libre de estados ambiguos. - Elección de Líder Paralela y Descentralizada: Ante la caída del Nodo A, las réplicas seguidoras ubicadas en los Nodos B y C detectan la falta de señales de vida (con un umbral habitual de 150 ms) y celebran elecciones Raft de forma paralela e inmediata. En un intervalo de 200 a 300 milisegundos, todas las particiones afectadas eligen a sus nuevos líderes locales sin depender de un coordinador central.
- Persistencia y Replicación Simultáneas: El líder de partición transmite los paquetes
AppendEntrieshacia los seguidores concurrentemente mientras ejecuta su propia escritura física local en NVMe conio_uring, solapando el retardo de red con la persistencia en disco.
Réplicas en Sincronía (ISR) y el Cuello de Botella del QuorumController en Kafka
Kafka gestiona la replicación de datos mediante un esquema de maestro-esclavo supervisado denominado In-Sync Replicas (ISR):
- Límites HW (High Watermark) y LEO (Log End Offset): Un seguidor permanece dentro del conjunto ISR siempre que sus peticiones de réplica lleguen dentro del intervalo configurado en
replica.lag.time.max.ms(por defecto 30 segundos). Un mensaje se considera confirmado cuando todas las réplicas del conjunto ISR activo han recibido el paquete. - Dependencia Centralizada del Controlador: Si un broker cae en un clúster Kafka que contiene 5.000 particiones, los brokers restantes no pueden acordar los nuevos liderazgos por sí mismos. Deben esperar a que el nodo QuorumController activo de KRaft registre la desconexión del broker, calcule las nuevas designaciones de líderes para esas 5.000 particiones, persista las modificaciones en el topic
@metadatay emita solicitudes de actualización hacia todos los brokers supervivientes. - Tiempos de Recuperación (MTTR) Elevados: Durante esta ventana de cálculo y notificación centralizada, las particiones implicadas permanecen bloqueadas para operaciones de escritura y lectura. En clústeres empresariales extensos, el tiempo medio de recuperación suele oscilar entre 30 segundos y más de 3 minutos.
Densidad de Particiones por Servidor: 4.000 frente a 50.000
En arquitecturas contemporáneas de microservicios con múltiples entornos y segregación de dominios de negocio, la cantidad global de particiones crece exponencialmente. En este punto, la arquitectura ligera de Redpanda marca una diferencia determinante:
| Dimensión de Particionado | Redpanda (C++) | Apache Kafka (KRaft) | Consecuencia Práctica |
|---|---|---|---|
| Límite Recomendado por Servidor | 50.000+ particiones | 2.000 – 4.000 particiones | Redpanda ofrece una densidad de particionado 10 veces mayor. |
| Sobrecarga de Memoria por Partición | 12 KB a 28 KB en estructura C++ | 2 MB a 6 MB en objetos Java | El heap de Kafka se satura rápidamente con metadatos de partición. |
| Descriptores de Ficheros por Partición | Pool dinámico de descriptores | 2 a 4 fijos (.log, .index, .timeindex) | Kafka alcanza con frecuencia el límite de ulimit -n del sistema. |
| Recuperación ante Caída (10.000 particiones) | < 850 milisegundos | 45 a 180 segundos | Raft resuelve las elecciones en paralelo en todos los núcleos de CPU. |
6. Evaluación de Latencia en Cola: Curvas P50, P95, P99 y P99.9 Bajo Estrés Extremo
En la ingeniería de plataformas distribuidas, la latencia mediana (P50) es una métrica engañosa. En un sistema bancario o en una plataforma de comercio electrónico que procesa 100.000 eventos por segundo, una latencia P99 de 100 ms significa que 1.000 transacciones de clientes cada segundo sufren retrasos notorios, provocando reintentos en cascada y bloqueos en los microservicios downstream.
Metodología del Benchmark y Banco de Pruebas
Para obtener datos rigurosos y reproducibles, diseñamos un banco de pruebas exhaustivo simulando condiciones de producción empresarial de alta demanda:
- Infraestructura Hardware: Clústeres de 3 nodos desplegados en instancias AWS EC2
i3en.3xlarge(12 vCPUs, 96 GB RAM, 1 disco NVMe SSD de 7.5 TB, red a 25 Gbps) distribuidos entre 3 Zonas de Disponibilidad enus-east-1. - Perfil de Carga: Tasa constante de 500 MB/s de entrada (500.000 mensajes/segundo de 1 KB) y 1.500 MB/s de salida (3 grupos de consumidores concurrentes representando procesamiento analítico, prevención de fraude y alimentación de data lake).
- Durabilidad y Replicación: Factor de replicación = 3, confirmación
acks=all(escritura confirmada en disco físico antes de retornar respuesta), 24 particiones por broker. - Versiones Evaluadas: Redpanda v24.2 (C++20 Seastar) frente a Apache Kafka v3.9 (modo KRaft nativo, OpenJDK 21 con Generational ZGC y parámetros de Page Cache optimizados).
| Escenario Evaluado | Percentil de Latencia | Redpanda (C++) | Apache Kafka (KRaft + ZGC) | Ventaja Competitiva |
|---|---|---|---|---|
| Régimen Estable (500 MB/s Entrada, Consumidores Calientes) | P50 (Mediana) | 1.42 ms | 2.85 ms | Redpanda (2.0x más rápido) |
| P95 | 3.81 ms | 12.40 ms | Redpanda (3.2x más rápido) | |
| P99 | 6.14 ms | 38.90 ms | Redpanda (6.3x menor latencia cola) | |
| P99.9 | 14.80 ms | 165.20 ms | Redpanda (11.1x menor latencia cola) | |
| Inyección de Caos: Lecturas Frías (Backfill de 10 TB) | P50 (Mediana) | 1.85 ms | 8.90 ms | Redpanda (4.8x más rápido) |
| P99 | 9.20 ms | 185.00 ms | Redpanda (20.1x menor latencia cola) | |
| P99.9 | 28.50 ms | 1.240,00 ms | Redpanda (43.5x menor latencia cola) | |
| Resiliencia y Rendimiento Pico | MTTR ante Caída de Broker | 380 ms | 18.400 ms | Redpanda (Recuperación 48x más rápida) |
| Throughput Máximo Estable | 1.450 MB/s | 680 MB/s | Redpanda (2.1x ancho de banda) |
El Abismo del Percentil P99.9 Explicado
¿Por qué se produce una degradación tan drástica en Kafka, alcanzando los 1.240 ms en P99.9 durante la prueba de lecturas frías?
Cuando el consumidor analítico comienza a solicitar 10 TB de datos históricos, el kernel de Linux lee agresivamente bloques antiguos desde el disco NVMe, llenando el Page Cache. Al agotarse la memoria libre, el sistema operativo desaloja páginas de memoria recientemente utilizadas, expulsando los datos en caliente de los topics en producción. Cuando los productores intentan escribir con write() y los consumidores en tiempo real leen con sendfile(), sus llamadas al sistema quedan suspendidas mientras el kernel vuelca páginas sucias y atiende lecturas síncronas de disco. Al mismo tiempo, la tasa de asignación de memoria en la JVM se dispara, forzando ciclos de marcado concurrente en ZGC que consumen ciclos de cómputo de los hilos de E/S.
En Redpanda, la misma prueba de lecturas frías genera una variación casi imperceptible (la latencia P99.9 pasa de 14.8 ms a 28.5 ms). Gracias al uso de O_DIRECT, las lecturas históricas se transfieren de la unidad NVMe directamente a buffers privados sin alterar la memoria de los topics en caliente. Y el planificador interno de Seastar restringe la cuota de E/S del consumidor histórico al 10%, asegurando que el flujo de producción en tiempo real retenga el 90% de la capacidad de la controladora de disco en todo momento.
7. Almacenamiento por Niveles en la Nube (Tiered Storage) y Descarga a S3
Uno de los mayores motores del sobrecoste en plataformas de streaming es el almacenamiento a largo plazo. Retener meses o años de registros de eventos en discos NVMe locales o volúmenes EBS gp3/io2 resulta financieramente inviable a gran escala. Las arquitecturas modernas exigen almacenamiento por niveles (Tiered Storage): utilizar el almacenamiento local como una memoria intermedia rápida y descargar el histórico completo hacia buckets de objetos en la nube (Amazon S3, Google Cloud Storage o Azure Blob).
Redpanda Shadow Indexing: Integración Nativa de Almacenamiento de Objetos
Redpanda incorporó Shadow Indexing como una funcionalidad troncal de su motor de almacenamiento en C++ desde el primer día:
- Descarga Asíncrona Continua: En cuanto un segmento de fichero local se sella, el coordinador de archivado de Redpanda transmite el bloque y sus índices de offset hacia Amazon S3 mediante operaciones HTTP PUT multiparte en segundo plano.
- Límites de Retención Local Transparentes: El administrador define cuotas de almacenamiento local (por ejemplo, mantener 50 GB por partición en disco local). Al alcanzarse la marca máxima, Redpanda purga los segmentos más antiguos. Para cualquier consumidor conectado, el offset inicial no cambia: el topic retiene todos los mensajes desde el offset 0 hasta el infinito.
- Hidratación Transparente: Cuando una aplicación analítica solicita un offset que ya no reside en el disco local, Redpanda descarga el segmento correspondiente desde S3 directamente a memoria, lo entrega al cliente por TCP y lo almacena en la caché NVMe si está configurado, sin alterar la memoria de los demás topics.
- Réplicas de Lectura Remotas (Remote Read Replicas): Redpanda permite levantar clústeres analíticos independientes que operan exclusivamente en modo lectura directamente contra el bucket S3 generado por el clúster principal. Las consultas pesadas de Snowflake o entrenamientos de Machine Learning se ejecutan sin consumir un solo ciclo de CPU ni byte de disco en el clúster de producción transaccional.
Tiered Storage en Apache Kafka (KIP-405)
En Apache Kafka, el almacenamiento por niveles fue propuesto en 2019 bajo la especificación KIP-405 y ha ido estabilizándose a lo largo de las versiones 3.6 a 4.0. Se basa en una arquitectura de plugins:
- RemoteStorageManager (RSM): Interfaz Java encargada de transmitir los bloques de datos entre los brokers y el almacenamiento de objetos.
- RemoteLogMetadataManager (RLMM): Interfaz encargada de persistir el mapeo entre los offsets de Kafka y las claves de objetos en la nube. Por defecto, almacena estos metadatos en un topic interno compactado denominado
__remote_log_metadata. - Desafíos de Operación: Aunque KIP-405 es funcional en Kafka 3.8/4.0, su explotación empresarial exige precauciones considerables: el topic interno de metadatos añade dependencias en el arranque, los hilos de subida generan presión adicional en el heap de Java y la plataforma no dispone de un mecanismo nativo de clústeres remotos de solo lectura como el de Redpanda.
8. Compatibilidad con el Protocolo de Kafka, Schema Registry y Ecosistema
Cualquier alternativa tecnológica que pretenda reemplazar a un componente nuclear como Kafka debe integrarse sin fricciones en las arquitecturas corporativas existentes. Obligar a modificar las aplicaciones cliente supone el fracaso operativo inmediato.
Compatibilidad Absoluta a Nivel de Protocolo de Red
Redpanda no implementa un proxy ni una capa de traducción intermedia: procesa de manera nativa los paquetes binarios del protocolo de Kafka sobre el puerto 9092:
- Soporte Total de Clientes y Lenguajes: Cualquier driver existente (Java
kafka-clients,librdkafka, Pythonconfluent-kafka, Gofranz-go, Node.jskafkajs) se conecta a Redpanda modificando únicamente el parámetrobootstrap.servers. - Procesamiento Exactamente una Vez (EOS): Implementación completa del protocolo transaccional en dos fases de Kafka (
InitProducerId,AddPartitionsToTxn,EndTxn), permitiendo transacciones atómicas entre múltiples particiones. - Protocolos de Rebalanceo Cooperativo: Compatibilidad con rebalanceos cooperativos incrementales (Cooperative Sticky Assignor), evitando la detención total del consumo durante el escalado de pods de consumidores.
Arquitectura Consolidada frente a Dispersión de Daemons en Kafka
Un despliegue de Apache Kafka listo para producción en el mundo corporativo requiere orquestar una multiplicidad de servicios auxiliares en Java:
Transformaciones de Datos en el Broker con WebAssembly (Wasm)
En Apache Kafka, aplicar transformaciones sencillas —como ocultar números de tarjetas de crédito (redacción de PII), filtrar registros inválidos o convertir JSON a Avro— obliga a enviar los mensajes a través de la red hacia un clúster externo de Apache Flink o Kafka Streams y volver a publicarlos en un nuevo topic.
Redpanda soluciona esta ineficiencia mediante Data Transforms impulsadas por WebAssembly (Wasm). Los desarrolladores programan la lógica de negocio en Rust o Go, la compilan a un binario Wasm y la despliegan con rpk transform deploy. El motor de Redpanda ejecuta la función en una sandbox segura en memoria inmediatamente antes de escribir o después de leer del log Raft, con latencias de microsegundos y sin transferencias de red externas.
9. Seguridad Corporativa, Multitenancy y Cumplimiento Normativo (ZDR)
En infraestructuras bancarias, aseguradoras y sistemas de salud, el rendimiento técnico carece de valor si la plataforma no ofrece controles estrictos de cifrado, segregación de privilegios y registros de auditoría inmutables.
Cifrado en Tránsito y Aceleración Criptográfica TLS 1.3
Ambas soluciones admiten cifrado con TLS 1.2 y 1.3 con autenticación mutua de certificados (mTLS), pero la implementación subyacente diverge:
- Redpanda TLS: Emplea
OpenSSL 3.xyGnuTLScompilados nativamente con soporte de instrucciones vectoriales AES-NI y AVX-512. El cifrado y descifrado de tramas se ejecuta directamente en el núcleo fijado sin puentes JNI (Java Native Interface) ni duplicación de buffers. - Kafka TLS: Depende de la arquitectura criptográfica de Java (JCA) o wrappers de Netty OpenSSL. Aunque el rendimiento ha mejorado sensiblemente, sigue requiriendo el paso de arrays de bytes entre memoria nativa y el heap de Java, lo que incrementa el uso de CPU entre un 18% y un 25% respecto a conexiones en texto plano.
Autenticación, Listas de Control de Acceso (ACLs) y Gobernanza
Ambos motores proporcionan estándares empresariales de gestión de identidades:
- Protocolos de Autenticación: Compatibilidad con SASL/SCRAM-SHA-256, SASL/SCRAM-SHA-512, Kerberos/GSSAPI y tokens portadores OIDC / OAuth 2.0.
- Listas de Control de Acceso (ACLs): Redpanda reproduce la sintaxis de permisos de Kafka para restringir operaciones por principal, host, topic y grupo de consumidores:
rpk security acl create --allow-principal User:pagos --operation read --topic transacciones- - Cuotas Multitenant: Ambos motores permiten establecer techos de ancho de banda por cliente o principal para garantizar un aislamiento efectivo entre departamentos.
Retención Cero de Datos (ZDR) y Cumplimiento Normativo
Para normativas sanitarias como HIPAA o financieras europeas bajo RGPD y DORA, la plataforma debe permitir la purga rápida de información confidencial:
- Topics Efímeros y Compactación: Posibilidad de configurar topics con retención de pocos microsegundos o compactación agresiva por clave para asegurar que los datos identificativos (PII/PHI) se borren de forma irreversible tras su procesamiento.
- Cifrado en Reposo: Redpanda Enterprise admite cifrado transparente en disco (AES-256-XTS) con integración en módulos de seguridad hardware (HSM) y cifrado del lado del servidor (KMS) en S3 Tiered Storage.
- Certificaciones: Ambas arquitecturas cuentan con certificación SOC 2 Tipo II, ISO 27001 y son aptas para entornos regulados PCI-DSS e HIPAA.
10. Modelo Cuantitativo de FinOps y TCO a 3 Años (Cómputo, Almacenamiento y Operaciones)
Al presupuestar plataformas distribuidas de streaming, las licencias de software constituyen solo una fracción del coste total de propiedad (TCO). Un modelo riguroso de FinOps debe cuantificar el coste de las instancias de cómputo en la nube, el almacenamiento en bloques (EBS), la descarga hacia almacenamiento de objetos (S3), el tráfico de red entre zonas de disponibilidad (AZ) y las horas de ingeniería de operaciones (FTEs) dedicadas a mantener el clúster operativo.
Definición del Escenario Empresarial de Referencia
Para este análisis a 36 meses modelamos un flujo de streaming corporativo desplegado sobre Amazon Web Services (AWS):
- Tráfico de Entrada Sostenido: 500 MB/s de escritura continua (43,2 TB diarios brutos).
- Tráfico de Salida Sostenido: 1.500 MB/s de consumo (factor de abanico 3x hacia microservicios).
- Ventana de Retención: 7 días de almacenamiento operativo (302,4 TB brutos; con replicación 3x = 907,2 TB totales).
- Disponibilidad: Despliegue multizona distribuido entre 3 Zonas de Disponibilidad (AZs).
Dimensionamiento de Infraestructura en la Nube
Arquitectura Apache Kafka (AWS EC2 + Volúmenes EBS):
- Brokers Kafka: 12 instancias
r6i.4xlarge(16 vCPUs, 128 GB RAM cada una = 8.830 $/mes) necesarias para absorber el caudal de 500 MB/s garantizando margen suficiente para el heap de Java y el Page Cache sin caídas por GC. - Controladores KRaft: 3 instancias dedicadas
m6i.xlarge(4 vCPUs, 16 GB RAM = 415 $/mes). - Almacenamiento EBS: 907,2 TB de almacenamiento AWS EBS
gp3(0,08 $/GB-mes = 72.576 $/mes) más IOPS provisionadas para evitar atascos durante el volcado del Page Cache (4.500 $/mes). Total almacenamiento: 77.076 $/mes. - Personal de Operaciones y SRE: 1,5 ingenieros Staff de Plataforma dedicados (compensación media de 180.000 $/año por FTE = 270.000 $/año) dedicados a la afinación de la JVM, rebalanceos y parches.
Arquitectura Redpanda (AWS EC2 NVMe + S3 Tiered Storage):
- Nodos Redpanda: 4 instancias
i3en.3xlarge(12 vCPUs, 96 GB RAM, 1 disco NVMe SSD de 7,5 TB integrado = 4.000 $/mes). Debido a la eficiencia C++ thread-per-core, 4 nodos absorben el tráfico de 500 MB/s sin saturarse. - Controladores Externos: 0 $. Redpanda utiliza Raft integrado en los mismos nodos.
- Almacenamiento NVMe Local: Incluido en el coste de las instancias (30 TB de caché NVMe ultrarrápida).
- S3 Tiered Storage: 877,2 TB de segmentos históricos descargados a Amazon S3 Standard (0,021 $/GB-mes = 18.421 $/mes) más peticiones PUT/GET de API (650 $/mes). Total almacenamiento: 19.071 $/mes.
- Personal de Operaciones y SRE: 0,4 FTE (72.000 $/año). Al ser un binario estático sin parámetros de JVM ni clústeres satélite, el esfuerzo operativo se reduce drásticamente.
| Partida de Gasto (36 Meses) | Redpanda Enterprise | Apache Kafka Autohospedado | Diferencial Acumulado a 3 Años |
|---|---|---|---|
| Cómputo Cloud EC2 (Brokers + Controladores) | 144.000 $ | 332.820 $ | Redpanda ahorra 188.820 $ (57% menos) |
| Almacenamiento (EBS gp3 vs S3 Tiered) | 686.556 $ (S3) | 2.774.736 $ (EBS gp3) | Redpanda ahorra 2.088.180 $ (75% menos) |
| Tráfico de Red Inter-AZ (Cross-Zone) | 155.520 $ | 155.520 $ | Empate (0,01 $/GB transferido) |
| Licencias Comerciales y Soporte | 180.000 $ (Redpanda) | 0 $ (Open Source Apache 2.0) | Kafka ahorra 180.000 $ en licencias |
| Coste de Ingeniería SRE y Operaciones | 216.000 $ (0.4 FTE) | 810.000 $ (1.5 FTE) | Redpanda ahorra 594.000 $ en personal |
| COSTE TOTAL DE PROPIEDAD A 3 AÑOS | 1.382.076 $ | 4.073.076 $ | REDPANDA AHORRA 2.691.000 $ (66,1% de Ahorro Neto) |
Los costes de infraestructura en la nube y licencias de software se cotizan internacionalmente en dólares estadounidenses (USD netos). Al presupuestar desde empresas en España y América Latina, deben evaluarse con especial rigor cuatro factores determinantes:
- Impuestos a Servicios Digitales e IVA Transfronterizo: Países como España (21% IVA), México (16% IVA digital), Chile (19% IVA) y Colombia (19%) gravan los servicios en la nube contratados en el extranjero si no se dispone de identificación fiscal corporativa autorizada para inversión de sujeto pasivo.
- Retenciones en la Fuente por Remesas al Exterior: En diversas jurisdicciones latinoamericanas (como Colombia con retenciones del 15% al 20% para software importado, o Argentina con esquemas de impuestos cambiarios sobre divisas), la contratación directa de licencias SaaS internacionales puede encarecer el desembolso final entre un 15% y un 30% respecto al valor nominal.
- Arbitraje de Costes Laborales en Equipos de Plataforma: Mientras que un ingeniero SRE Staff en Estados Unidos percibe unos 180.000 USD anuales (fully loaded), en los principales centros tecnológicos de España (Madrid, Barcelona) la remuneración equivalente se sitúa entre 45.000 € y 65.000 € anuales, y en hubs de América Latina (Bogotá, Ciudad de México, Buenos Aires, Santiago) oscila entre 35.000 y 55.000 USD. Aunque este menor coste salarial reduce la partida de personal en Kafka, el volumen de esfuerzo humano desperdiciado en tareas de bajo valor añadido (depuración de GC, rebalanceos y tuning de Page Cache) continúa lastrando la productividad de los equipos frente a la agilidad operativa de Redpanda.
- Volatilidad del Tipo de Cambio: Dado que el gasto en AWS EBS y licencias computa en dólares, las devaluaciones monetarias locales impactan directamente en las cuentas de resultados, haciendo que la reducción de servidores lograda por Redpanda sea aún más valiosa como mecanismo de cobertura contra el riesgo cambiario.
Incluso computando el coste de las licencias anuales de Redpanda Enterprise, el ahorro neto supera los 2,69 millones de dólares en 3 años para un volumen de 500 MB/s. La clave económica reside en sustituir el costoso aprovisionamiento de cientos de terabytes en discos EBS gp3 por la descarga continua en Amazon S3 combinada con unidades NVMe locales.
11. Matriz Comparativa Exhaustiva de 25 Dimensiones de Ingeniería
A continuación se presenta el desglose técnico integral que analiza a Redpanda y Apache Kafka a lo largo de 25 criterios determinantes de ingeniería de sistemas, concurrencia, rendimiento y gobierno:
| Criterio Arquitectónico | Redpanda | Apache Kafka (KRaft) | Evaluación de Ingeniería |
|---|---|---|---|
| 1. Lenguaje Principal y Runtime | C++20 nativo (Framework Seastar) | Java 17/21 y Scala (JVM) | Redpanda (Cero sobrecarga de runtime) |
| 2. Arquitectura de Concurrencia | Thread-per-core (TPC), shared-nothing | Pools de hilos desacoplados (Network y E/S) | Redpanda (Sin contención de bloqueos) |
| 3. Modelo de Planificación de CPU | Planificación cooperativa en espacio de usuario | Planificador preemptivo CFS del kernel Linux | Redpanda (Sin cambios de contexto forzados) |
| 4. Subsistema de Memoria | Asignador customizado slab/buddy por núcleo | Heap de la JVM (Generational ZGC / G1GC) | Redpanda (Cero fragmentación de heap) |
| 5. Pausas por Recolección de Basura | Cero GC (0,0 ms de pausa) | Pausas STW (50 ms – 2.000 ms bajo carga) | Redpanda (Inmune a picos por GC) |
| 6. Interfaz de E/S de Almacenamiento | Linux io_uring (anillos lock-free) | Llamadas POSIX con buffer write() y sendfile() | Redpanda (E/S asíncrona agrupada) |
| 7. Dependencia del Page Cache | Ninguna (Omite caché con O_DIRECT) | Crítica (Depende del Page Cache para buffering) | Redpanda (Sin paradas por volcado de páginas) |
| 8. Impacto de Lecturas Históricas | Aislado mediante cuotas de E/S Seastar | Grave (Desaloja memoria caliente y bloquea hilos) | Redpanda (Tráfico en caliente protegido) |
| 9. Protocolo de Replicación y Consenso | Consenso Raft puro por partición | Réplicas en Sincronía (ISR) + High Watermark | Redpanda (Quórum matemático estricto) |
| 10. Arquitectura de Metadatos | Grupo Raft de Control Integrado | KRaft QuorumController (topic @metadata) | Redpanda (Binario único unificado) |
| 11. Tiempo de Recuperación (MTTR) | Subsegundo (< 400 ms) | 15 a 180 segundos (Cálculo del controlador) | Redpanda (Recuperación 40x más veloz) |
| 12. Densidad de Particiones por Servidor | 50.000+ particiones | 2.000 a 4.000 particiones | Redpanda (10x mayor densidad de datos) |
| 13. Latencia P99 (Carga de 500 MB/s) | 6,14 ms | 38,90 ms | Redpanda (6.3x menor latencia cola) |
| 14. Latencia P99.9 (Prueba con Caos) | 28,50 ms | 1.240,00 ms | Redpanda (43x menor degradación) |
| 15. Almacenamiento por Niveles | Shadow Indexing nativo + Réplicas de Lectura | KIP-405 SPI Pluggable (RSM / RLMM) | Redpanda (Integración más madura y fluida) |
| 16. Transformaciones en el Broker | WebAssembly (Wasm) integrado | Ninguno (Requiere Flink o KStreams externo) | Redpanda (Transformación sin saltos de red) |
| 17. Schema Registry Integrado | Nativo en binario (Avro, Protobuf, JSON) | Daemon externo JVM independiente requerido | Redpanda (Cero dispersión de daemons) |
| 18. Proxy HTTP REST Integrado | Nativo en binario (HTTP/JSON pub/sub) | Daemon externo JVM independiente requerido | Redpanda (Ingesta de Webhooks directa) |
| 19. Compatibilidad Protocolo Kafka | 100% Compatible a nivel de bytes | Implementación de referencia original | Empate (Sustitución directa sin cambios) |
| 20. Ecosistema y Conectores Externos | Compatible con Connect y KStreams | Enorme ecosistema global de 15 años | Apache Kafka (Mayor catálogo de plugins) |
| 21. Nodos Mínimos en Producción | 3 nodos (Brokers y consenso unificados) | 6 a 9 nodos (Controladores + Brokers) | Redpanda (Huella de servidores 50% menor) |
| 22. Eficiencia en ARM64 / Graviton | Excepcional (Instrucciones nativas aarch64) | Moderada (Compilación JIT de la JVM) | Redpanda (Mayor rendimiento por vatio) |
| 23. Herramientas de Administración (CLI) | Binario unificado rpk | Múltiples scripts shell independientes (.sh) | Redpanda (Experiencia de usuario muy superior) |
| 24. Licenciamiento de Código Abierto | BSL (Business Source License) / Enterprise | Apache 2.0 (100% Código Abierto Permisivo) | Apache Kafka (Gobernanza comunitaria pura) |
| 25. TCO a 3 Años en Infraestructura | 1,38M $ (Ahorro del 66% en cómputo y SRE) | 4,07M $ (Gasto masivo en EBS y mantenimiento) | Redpanda (Ahorro de 2,69M $) |
12. Guía de Migración a Producción y Hoja de Comandos Operativa
Migrar un clúster de streaming que gestiona cientos de gigabytes por hora debe planificarse con garantía estricta de cero pérdida de datos y cero interrupción en los servicios de negocio. La compatibilidad de protocolo entre Redpanda y Apache Kafka permite una transición progresiva y segura.
Estrategia de Migración en 4 Fases sin Interrupción de Servicio
- Fase 1: Despliegue de Redpanda y Replicación de Esquemas: Provisionar el clúster objetivo de Redpanda con Tiered Storage habilitado. Exportar los esquemas del Confluent Schema Registry existente e importarlos en el Schema Registry integrado de Redpanda mediante
rpk registry schema createo peticiones HTTP estándar. - Fase 2: Replicación en Vivo mediante MirrorMaker 2: Desplegar Kafka MirrorMaker 2 (o Redpanda Connect) para replicar topics de manera unidireccional desde el clúster Kafka legado hacia Redpanda. MirrorMaker 2 sincroniza de forma continua los offsets, marcas de tiempo y cabeceras de cada mensaje.
- Fase 3: Transición de Consumidores (Cero Impacto): Puesto que los offsets de consumo se han replicado, los microservicios consumidores pueden reconfigurarse de manera escalonada (rolling update) modificando el parámetro
bootstrap.servershacia Redpanda. Los consumidores reanudan el procesamiento desde sus offsets confirmados con normalidad. - Fase 4: Transición de Productores y Desmantelamiento: Reconfigurar las aplicaciones productoras para emitir directamente hacia Redpanda. Supervisar la ingesta en las métricas de Prometheus. Cuando el tráfico en Kafka caiga a cero y el lag se extinga, desmantelar ordenadamente los antiguos brokers de Kafka y controladores KRaft.
Piedra de Rosetta Operativa: Comandos rpk frente a Scripts de Kafka
Lista de Verificación de Producción (Production Readiness)
rpk redpanda tune all. Verificar que el planificador de disco esté fijado en none para omitir elevadores del kernel y confirmar que el gobernador de CPU opere en modo performance.
acks=all y enable.idempotence=true en los clientes productores con políticas de reintento exponencial para absorber con total transparencia las elecciones de líder Raft de 200 ms.
9644/metrics. Establecer alertas automáticas sobre vectorized_storage_disk_free_bytes y vectorized_raft_leader_elections.
13. Preguntas Frecuentes de Arquitectura (FAQ)
¿Cómo logra Redpanda una compatibilidad del 100% con el protocolo de Kafka sin utilizar código Java ni librerías de Scala?
Redpanda reimplementa desde cero la especificación completa del protocolo binario de Apache Kafka en C++20 moderno. El protocolo de Kafka es un estándar abierto de solicitud-respuesta binaria sobre TCP que define códigos de operación numéricos (API keys), estructuras de cabeceras, disposición de lotes de registros (formato RecordBatch v2) y tipos de datos compactos. El analizador de red de Redpanda, construido sobre el framework asíncrono Seastar, decodifica estas tramas directamente en memoria de usuario y las canaliza hacia su propia máquina de estados de consenso Raft. Debido a que la compatibilidad se produce a nivel de bytes en el socket de red, cualquier cliente o driver estándar (como Java kafka-clients, librdkafka, Sarama, franz-go o Confluent Python) interactúa con Redpanda de forma idéntica a un clúster Kafka nativo sin necesidad de alterar código ni emuladores.
¿Requiere Redpanda un kernel Linux 5.8+ para aprovechar io_uring y qué sucede en distribuciones con kernels empresariales heredados como RHEL 7 u 8?
Redpanda obtiene su máximo rendimiento de almacenamiento con el subsistema io_uring de Linux, el cual requiere versiones de kernel Linux 5.8 o superiores (siendo óptimo 5.10 LTS o series 6.x modernas para el sondeo de colas de envío y finalización). Gracias a io_uring, Redpanda envía ráfagas de escrituras NVMe asíncronas sin incurrir en cambios de contexto de llamadas al sistema. En distribuciones con kernels más antiguos (como RHEL 7 o versiones iniciales de RHEL 8 con kernel 4.18), el motor Seastar recurre automáticamente a la interfaz POSIX de E/S asíncrona (libaio). Aunque libaio opera de forma fiable en modo directo (O_DIRECT), presenta una sobrecarga marginalmente mayor en cambios de contexto de CPU y menor capacidad de empaquetado en comparación con los anillos de io_uring.
¿Por qué Apache Kafka sufre picos de latencia en cola (P99/P99.9) durante escrituras masivas en disco y cómo lo evita el modo O_DIRECT de Redpanda?
Apache Kafka delega la persistencia física en el Page Cache del sistema operativo Linux mediante la llamada write() tradicional. Cuando la proporción de páginas de memoria marcadas como 'sucias' supera los límites del kernel (vm.dirty_background_ratio y vm.dirty_ratio), los hilos de volcado del kernel (kswapd y pdflush) intervienen forzosamente para descargar los datos a disco. Durante este intervalo, los bloqueos internos del kernel sobre inodos y tablas de páginas congelan temporalmente las llamadas write() entrantes. Simultáneamente, el recolector de basura de la JVM sufre sobrecargas al gestionar buffers en heap. Redpanda neutraliza ambos problemas: utiliza el flag O_DIRECT para escribir directamente en bloques alineados de 4KB hacia las controladoras NVMe mediante io_uring, y gestiona su propia memoria sin ningún recolector de basura, manteniendo latencias P99 y P99.9 estrictamente planas.
¿Es posible conectar clústeres de Kafka Connect y aplicaciones Kafka Streams existentes directamente contra Redpanda?
Sí, de manera totalmente transparente. Al respetar el protocolo de cable de Kafka al 100%, los clústeres distribuidos de Kafka Connect que operan con conectores como Debezium, Snowflake, AWS S3, Salesforce o JDBC se integran sin cambios de software; basta con apuntar el parámetro bootstrap.servers hacia los nodos de Redpanda. Del mismo modo, las aplicaciones desarrolladas con Kafka Streams, Apache Flink, Apache Spark Streaming o Bytewax ejecutan sus topologías sin modificación. Redpanda implementa semántica de entrega exactamente una vez (EOS), productores idempotentes y soporte completo para rebalanceos de grupos de consumidores tanto clásicos como cooperativos.
¿En qué se diferencia el consenso Raft por partición de Redpanda frente al QuorumController KRaft de Kafka en situaciones de caída de nodos?
KRaft en Apache Kafka separa el consenso de metadatos de la replicación de datos. Emplea un quórum Raft centralizado únicamente para gestionar el catálogo del clúster y el estado de los brokers, mientras que la replicación de mensajes en cada partición sigue gobernada por el algoritmo tradicional de Réplicas en Sincronía (ISR). Cuando un broker líder falla, el controlador central KRaft debe detectar la pérdida, elegir nuevos líderes partición por partición, registrar los cambios en el log de metadatos y notificar a los demás brokers, lo que puede demorar decenas de segundos en clústeres grandes. En Redpanda, Raft se aplica directamente en cada partición: cada partición constituye un grupo de consenso Raft autónomo. Cuando un nodo colapsa, las elecciones de nuevo líder se resuelven en paralelo entre los nodos supervivientes en menos de 300 milisegundos, sin cuello de botella centralizado ni riesgo de split-brain.
¿Qué consideraciones de memoria y arquitectura NUMA deben tenerse en cuenta al desplegar Redpanda en servidores bare-metal de 64 o 128 núcleos?
Redpanda fue diseñado específicamente para plataformas multiprocesador NUMA de alta densidad de núcleos (como AMD EPYC o AWS Graviton). Utilizando Seastar, Redpanda asigna un hilo exclusivo a cada núcleo de CPU físico (con pthread_setaffinity_np) y reserva un bloque estático de memoria RAM directamente del controlador de memoria local de ese socket NUMA. A diferencia de las máquinas virtuales Java, donde un heap de gran tamaño (64GB a 256GB) provoca saturación en los buses de interconexión (Intel UPI o AMD Infinity Fabric) y pausas de recolección inasumibles, Redpanda no comparte memoria entre núcleos. La comunicación entre hilos se realiza exclusivamente mediante colas circulares lock-free (SPSC), permitiendo un escalado lineal del throughput hasta 128 núcleos por máquina sin degradación.
¿Es suficiente la eliminación de ZooKeeper en Kafka 4.0 para equiparar su simplicidad operativa con la de Redpanda?
No. La eliminación definitiva de ZooKeeper en Kafka 4.0 representa un avance encomiable que reduce un componente externo, pero no altera las limitaciones inherentes al runtime de la JVM. Los brokers de Kafka continúan dependiendo de la recolección de basura, sufren fragmentación de heap, dependen de la afinación del Page Cache del sistema operativo y carecen de E/S nativa fuera del kernel. Asimismo, Kafka requiere aprovisionar y gestionar nodos controladores separados, desplegar instancias adicionales para el Schema Registry y el REST Proxy, y supervisar docenas de métricas JMX complejas. Redpanda entrega todas estas capacidades integradas dentro de un único binario C++ estático sin dependencias externas.
¿Cómo se comparan las transformaciones de datos en broker con WebAssembly (Wasm) de Redpanda frente a herramientas como Apache Flink?
Las transformaciones de datos (Data Transforms) de Redpanda ejecutan módulos compilados en WebAssembly (Rust, Go, C++) directamente dentro del pipeline de E/S del broker con latencia de microsegundos. Resultan idóneas para operaciones sin estado evento a evento, tales como ofuscación de datos sensibles (PII), validación de esquemas, descompresión o conversión de formatos (JSON a Avro), ahorrando el coste de red y de infraestructura de computación externa. No obstante, no sustituyen a motores de procesamiento de flujos con estado complejo como Apache Flink o Kafka Streams cuando se requieren ventanas temporales avanzadas, uniones de múltiples flujos (stream-stream joins) o procesamiento CEP de gran escala.
José Andrade
Arquitecto Distribuidos & Modelador de FinOpsFundador y Editor Jefe en CloudBizStack. José se especializa en arquitecturas internas de streaming distribuido, pipelines de E/S del kernel Linux (io_uring, eBPF), programación asíncrona en C++ Seastar y modelado cuantitativo de TCO de infraestructura cloud para corporaciones Fortune 500.