Temporal vs Apache Airflow: Orquestación de Workflows (2026)
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En el panorama de ingeniería de software empresarial de 2026, el término “orquestación de workflows” ha dejado de representar una categoría homogénea. Las organizaciones técnicas se enfrentan a una bifurcación arquitectónica fundamental: ¿necesitan coordinar lógica de negocio asíncrona, tolerante a fallos y de larga duración entre microservicios transaccionales distribuidos, o necesitan programar y supervisar grafos de dependencias de transformaciones de datos en lote (batch) a través de lakehouses empresariales? Confundir o forzar la convergencia de estos dos dominios computacionales constituye uno de los antipatrones más costosos de la ingeniería cloud moderna.
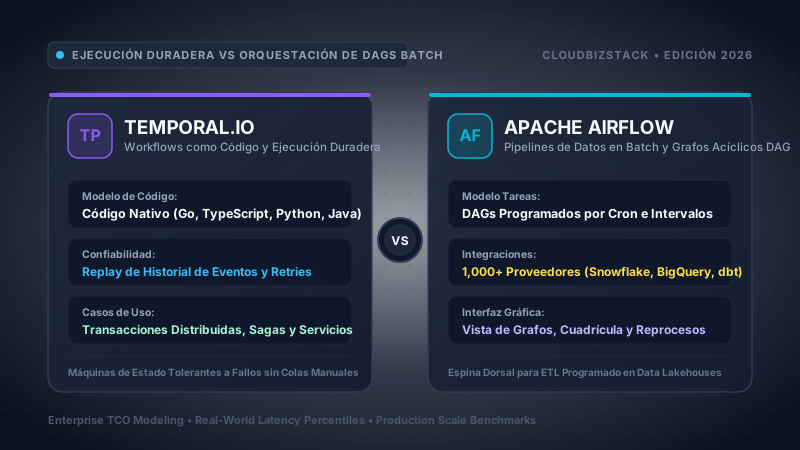
En este exhaustivo benchmark comparamos frente a frente a los dos titanes que definen el mercado: Temporal.io (el estándar de facto para Ejecución Duradera y máquinas de estado distribuidas basadas en código) y Apache Airflow (el estándar universal para Grafos Acíclicos Dirigidos (DAGs) programados y canalizaciones de ingeniería de datos). Aunque ambas herramientas gestionan procesos de múltiples pasos, sus motores internos de ejecución, capas de persistencia, modelos de estado, latencias mínimas y filosofías operativas pertenecen a extremos opuestos del espectro de sistemas distribuidos:
Temporal: Ejecución Duradera en Código
Temporal proporciona un runtime de ejecución duradera basado en event-sourcing donde los flujos de trabajo se programan en lenguajes Turing-completos de propósito general (Go, TypeScript, Python, Java, .NET). Al interceptar toda entrada/salida y registrar un historial inmutable de eventos en un anillo de particiones distribuido, Temporal puede reconstruir en milisegundos el estado de ejecución en memoria, las variables de subprocesos locales, la pila de llamadas y los temporizadores ante caídas de workers o desahucios en Kubernetes.
- Fortaleza Principal: Despacho reactivo de eventos en sub-segundos (latencia de 10ms a 50ms), sagas transaccionales con compensaciones automáticas, comunicación interactiva bidireccional mediante Signals y Queries, y cero pérdida de estado durante meses de ejecución.
- Cargas Ideales: Core bancario, procesamiento de pagos, sagas de altas de usuarios, bucles de agentes de IA autónomos, aprovisionamiento de infraestructura y coordinación de microservicios transaccionales.
- Compromiso Arquitectónico: Requiere estricto determinismo dentro del código del workflow; carece de conectores analíticos nativos de fábrica para data warehouses (Spark, Snowflake, BigQuery, dbt).
Apache Airflow: DAGs Batch Programados
Apache Airflow es un scheduler centralizado basado en bucles de sondeo (polling), diseñado específicamente para gobernar grafos acíclicos dirigidos estáticos de operaciones de datos en lote. Escrito y configurado en Python, Airflow orquesta tareas heterogéneas despachando comandos aislados a flotas de workers (Celery o Pods efímeros de Kubernetes) coordinados a través de una base de datos relacional central.
- Fortaleza Principal: Ecosistema masivo de más de 1.500 operadores preconstruidos, integración nativa profunda con data warehouses analíticos (Snowflake, Databricks, BigQuery, Redshift), linaje automático de datos con OpenLineage y visualización excepcional en interfaz web.
- Cargas Ideales: Pipelines diarios/horarios de ETL/ELT para data lakehouses empresariales, transformaciones masivas en almacenes columnares, ingeniería de características para ML y consolidación de reportes de inteligencia de negocios.
- Compromiso Arquitectónico: Latencia mínima impuesta por sondeo (retrasos de 5s a 30s por paso de tarea), arranque pesado de intérpretes Python por cada ejecución, contención de bloqueos de base de datos bajo alta concurrencia e incapacidad estructural para ejecutar sagas transaccionales de microservicios.
Matriz de Decisión Ejecutiva: Selección por Escenario Operativo
| Escenario de Ingeniería Empresarial | Ajuste Arquitectónico Temporal | Ajuste Arquitectónico Airflow | Recomendación Estratégica |
|---|---|---|---|
| Sagas de Microservicios y Pasarelas de Pago | Óptimo (Rollbacks automáticos y latencia sub-50ms) | Antipatrón (Retrasos de sondeo, sin compensación atómica) | Temporal: Garantiza transacciones distribuidas sin estados huérfanos. |
| Data Lakehouse ETL / ELT y Transformaciones SQL | Deficiente (Requiere programar actividades manuales para SQL/Spark) | Óptimo (+1.500 conectores de datos, dbt, Spark nativo) | Airflow: El estándar absoluto para pipelines de ingeniería de datos. |
| Bucles de Agentes Autónomos de IA y Razonamiento | Óptimo (Bucles infinitos duraderos, ramificación dinámica) | Inadecuado (Los DAGs no soportan ciclos o pausas dinámicas) | Temporal: Permite ciclos continuos de razonamiento con estado persistente. |
| Tareas Programadas tipo Cron y Carga Diaria | Soportado (Función Temporal Schedules sin desfase de tiempo) | Nativo (Expresiones cron, backfills históricos por fecha) | Empate: Airflow para datos; Temporal si el cron ejecuta APIs operativas. |
| Procesos con Humanos en el Bucle (Semanas o Meses) | Óptimo (Cero consumo de CPU/memoria durante la espera) | Subóptimo (Los sensores o el Triggerer acaparan recursos) | Temporal: Suspensión dirigida por eventos sin hilos de ejecución activos. |
2. Fundamentos Arquitectónicos y Mecánica de los Runtimes
Para comprender las abismales diferencias de rendimiento, escalabilidad y sobrecostes operacionales entre Temporal y Apache Airflow, es imperativo diseccionar sus topologías internas de sistemas distribuidos. La divergencia raíz parte de cómo gestionan el estado, cómo despachan las tareas y cómo reaccionan ante contingencias de infraestructura en la nube.
2.1 Arquitectura de Máquina de Estados Distribuida de Temporal
Temporal funciona como un motor de estados particionado y distribuido compuesto por cuatro microservicios desacoplados que se comunican exclusivamente mediante gRPC de alto rendimiento sobre HTTP/2, respaldados por una base de datos relacional o de columnas anchas (Apache Cassandra, PostgreSQL, MySQL) y un motor de indexación secundaria opcional (Elasticsearch / OpenSearch):
- Frontend Service: Es la puerta de enlace sin estado que autentica conexiones gRPC, aplica limitación de tasa (rate limiting) mediante algoritmos de token bucket, enruta peticiones hacia las particiones (shards) correctas del servicio History mediante hashing consistente y valida certificados mTLS corporativos.
- History Service: El núcleo inteligente de Temporal. El History Service se divide en miles de particiones lógicas (habitualmente entre 512 y 16.384 shards). Cada shard gobierna un rango de identificadores de ejecución de workflows, procesa transiciones de estado, genera eventos de ejecución, escribe registros atómicos en la base de datos subyacente y gestiona temporizadores internos de alta precisión.
- Matching Service: Un intermediario de colas en memoria de rendimiento extremo. Mantiene las colas de tareas (Task Queues) tanto para Workflow Tasks como para Activity Tasks. Implementa semántica de sondeo prolongado (long polling): cuando un worker solicita trabajo, el Matching Service asocia la tarea pendiente de forma directa al flujo HTTP/2 abierto del worker, eliminando cualquier consulta cíclica a disco o bases de datos relacionales.
- Worker Service del Sistema: Procesos en segundo plano del propio clúster que ejecutan tareas de recolección de basura, archivado histórico de eventos en almacenamiento de objetos fríos (AWS S3, Google Cloud Storage) y gestión de namespaces.
- Flota de Workers de Aplicación: Fundamentalmente, el código de aplicación de los usuarios jamás se ejecuta dentro del clúster de Temporal. Los workers son demonios sin estado alojados enteramente en la infraestructura del cliente (pods en Kubernetes, instancias ECS o máquinas virtuales). Los workers se conectan al Frontend Service mediante gRPC saliente, descargan tareas, ejecutan el código localmente y transmiten el resultado de vuelta al servicio History.
2.2 La Mecánica del Replay del Historial de Eventos
La mayor innovación arquitectónica de Temporal es el Replay del Historial de Eventos (Event History Replay). En los orquestadores tradicionales, el estado se preserva serializando la memoria del proceso o guardando capturas monolíticas en filas de base de datos. Temporal adopta un modelo de aprovisionamiento de eventos (event-sourcing) inmutable y append-only.
Cada efecto secundario externo, temporizador o cambio de estado genera un evento inmutable registrado en el clúster. Por ejemplo, una saga de pagos de tres pasos produce un flujo estructurado de eventos:
1. WorkflowExecutionStarted      { WorkflowType: "SagaPedidos", Input: {...}, Timeout: 86400s }
2. WorkflowTaskScheduled        { TaskQueue: "pedidos-queue" }
3. WorkflowTaskStarted          { WorkerID: "worker-pod-8b4f" }
4. WorkflowTaskCompleted        { Commands: [ScheduleActivityTask("CobrarTarjeta")] }
5. ActivityTaskScheduled        { Activity: "CobrarTarjeta", Timeout: 30s }
6. ActivityTaskStarted          { WorkerID: "worker-pod-8b4f" }
7. ActivityTaskCompleted        { Activity: "CobrarTarjeta", Result: { TxID: "ch_98df7" } }
8. WorkflowTaskScheduled        { TaskQueue: "pedidos-queue" }
9. WorkflowTaskStarted          { WorkerID: "worker-pod-2c1a" }  <-- Worker Distinto!
10. WorkflowTaskCompleted       { Commands: [ScheduleActivityTask("ReservarStock")] }
...
Si el pod worker-pod-8b4f sufre un fallo de hardware catastrófico o un OOMKill de Kubernetes inmediatamente después del paso 7, el clúster de Temporal no pierde el estado. El servicio Matching simplemente programa una nueva Workflow Task y la despacha al siguiente worker disponible (ejemplo: worker-pod-2c1a).
Cuando worker-pod-2c1a recibe la tarea, el SDK de Temporal ejecuta la función del workflow desde la línea 1. Al llegar a await CobrarTarjeta(), el SDK intercepta la instrucción, consulta el registro de eventos históricos, comprueba que ya existe un ActivityTaskCompleted con el resultado TxID: "ch_98df7" y resuelve la Promise inmediatamente con dicho valor en memoria sin volver a realizar la llamada a la pasarela bancaria. El flujo continúa ejecutándose exactamente desde ese microsegundo.
Debido a que el motor de reproducción depende de que la ruta de ejecución del código coincida con la secuencia grabada de eventos, la lógica de los workflows debe ser estrictamente determinista. Cualquier operación no determinista ejecutada dentro de la función de workflow —como invocar datetime.now(), generar números o UUIDs aleatorios, leer variables de entorno variables, consultar bases de datos o mutar variables globales compartidas— alterará la secuencia. Si el código diverge del historial, el SDK de Temporal aborta la tarea inmediatamente con un NonDeterministicWorkflowError para proteger la integridad de los datos. Toda llamada de red o E/S no determinista debe residir obligatoriamente en Activities.
2.3 La Arquitectura de Sondeo y Grafos DAG de Apache Airflow
Apache Airflow aborda la orquestación desde una perspectiva diametralmente opuesta. En lugar de modelar el código como un flujo de eventos reanudable y continuo, Airflow modela los flujos de trabajo como Grafos Acíclicos Dirigidos (DAGs) estáticos formados por tareas aisladas en lote. Su entorno de ejecución comprende cinco subsistemas principales:
- Airflow Scheduler: Un demonio multihilo que ejecuta bucles continuos de evaluación. El Scheduler escanea los archivos de DAG en el directorio configurado, procesa los scripts de Python mediante el
DagFileProcessorManager, evalúa las dependencias y fechas de ejecución, serializa los grafos en la base de datos relacional y transiciona las instancias de tarea al estadoQUEUED. - Base de Datos de Metadatos: El repositorio relacional central (PostgreSQL o MySQL). En Airflow, la base de datos no es un simple medio de almacenamiento pasivo; opera como el bus de sincronización y mecanismo de bloqueo entre procesos. Schedulers, servidores web, triggerers y workers ejecutan transacciones de lectura-modificación-escritura con bloqueos de fila sobre las tablas
task_instance,dag_runyxcom. - Airflow Webserver: Una aplicación web desarrollada en Flask-AppBuilder que renderiza la interfaz visual, lee las definiciones serializadas de la base de datos, presenta los grafos de ejecución, permite la activación manual de tareas y gestiona el control de acceso basado en roles (RBAC).
- Airflow Triggerer (Airflow 2.2+): Un demonio asíncrono basado en el bucle de eventos
asynciode Python. El Triggerer ejecuta operadores aplazables (deferrable operators), permitiendo que las tareas que esperan jobs externos lentos (como un clúster EMR o un job en Databricks) cedan sus slots de worker y duerman hasta que un evento de sondeo asíncrono despierte la tarea, aliviando la saturación de workers. - Flota de Ejecutores (Executors): La infraestructura encargada de correr el código de las tareas. En producción se utiliza habitualmente CeleryExecutor (donde las tareas se envían a colas Redis o RabbitMQ consumidas por workers Celery persistentes) o KubernetesExecutor (donde el Scheduler llama a la API de Kubernetes para crear un Pod efímero dedicado por cada tarea individual).
La limitación estructural de la arquitectura de Airflow es el Bucle de Sondeo del Scheduler. Frente al modelo reactivo por gRPC de Temporal, Airflow acumula retrasos sustanciales en cada transición de estado:
Paso 1: DagFileProcessor escanea mi_pipeline.py en disco     [Duración: 200ms - 2.500ms]
Paso 2: Scheduler evalúa ejecuciones activas en PostgreSQL   [Duración: 150ms - 800ms]
Paso 3: Scheduler comprueba dependencias de Tarea B         [Duración: 50ms - 200ms]
Paso 4: Tarea B pasa a estado QUEUED en base de datos        [Duración: 20ms - 100ms]
Paso 5: Executor envía tarea a Redis / API de Kubernetes    [Duración: 100ms - 500ms]
Paso 6: Worker reclama la tarea de la cola broker            [Duración: 200ms - 1.000ms]
Paso 7: Worker inicia subproceso Python e importa módulos    [Duración: 1.500ms - 6.000ms]
-----------------------------------------------------------------------------------------
Latencia Base Acumulada de Despacho por Cada Tarea:          3,2s a 12,5 segundos!
En una canalización de data lakehouse que procesa 500 millones de registros en Snowflake una vez al día, un desfase de 5 segundos entre tareas es completamente despreciable. No obstante, para una transacción de checkout de comercio electrónico, un flujo de incorporación bancaria o un agente de inteligencia artificial que encadena 40 pasos de razonamiento, acumular 5 segundos por paso resulta en una degradación inaceptable con timeouts inmediatos.
3. Modelos de Programación, Experiencia de Desarrollo y Código vs. DSL
La divergencia técnica fundamental entre Temporal y Apache Airflow se refleja con máxima intensidad en la experiencia diaria de los ingenieros de software. ¿Cómo se programan, prueban en local, depuran y refactorizan los flujos de trabajo en cada plataforma?
3.1 El Paradigma de Código como Flujo de Trabajo en Temporal
En Temporal no existe ningún lenguaje de dominio específico (DSL), ni ficheros declarativos en JSON o YAML, ni definiciones estáticas de grafos. Tu propio código fuente es el flujo de trabajo. Los desarrolladores utilizan las construcciones habituales de su lenguaje preferido: bucles for e iteradores, estructuras condicionales if/else, bloques de captura de excepciones try/catch, jerarquías de clases y mecanismos nativos de concurrencia asíncrona (como Promise.all() en TypeScript o asyncio.gather() en Python).
Las arquitecturas en Temporal imponen una separación de responsabilidades nítida y estricta:
- Workflows: Coordinadores de orquestación puramente deterministas. Secuencian actividades, gestionan temporizadores duraderos, escuchan Signals externos, responden a consultas Queries y evalúan reglas de negocio en memoria. Tienen prohibido interactuar de forma directa con sockets de red, archivos locales o bases de datos.
- Activities: Unidades de ejecución con efectos secundarios externos no deterministas. Las actividades ejecutan peticiones HTTP a Stripe o proveedores externos, consultan PostgreSQL, suben ficheros a buckets S3, llaman a modelos de lenguaje (OpenAI, Claude) e invocan otros microservicios. Cada actividad puede configurarse con políticas independientes de reintento exponencial, tiempos límite de ejecución y latidos de verificación (heartbeats).
3.2 Primitivas de Interacción Bidireccional: Signals, Queries y Updates
A diferencia de los orquestadores de DAGs batch donde una ejecución iniciada es una caja negra que corre de principio a fin sin interacción intermedia, los workflows de Temporal son actores virtuales duraderos y reactivos que admiten tres tipos de interacción en tiempo real:
- Signals: Notificaciones asíncronas de entrada única enviadas a un flujo en ejecución desde el exterior (por ejemplo, la recepción de un webhook bancario, un clic de aprobación humana o una señal de alerta de un sensor IoT). Los Signals modifican el estado interno del workflow sin requerir mecanismos de sondeo continuo.
- Queries: Peticiones síncronas de solo lectura que examinan las variables locales en memoria de un workflow activo sin alterar su historial de eventos ni ejecutar actividades secundarias (por ejemplo, consultar el porcentaje de progreso de un pedido o verificar el tiempo restante de un temporizador).
- Updates (Temporal 1.20+): Operaciones síncronas de lectura y escritura que validan la carga recibida, mutan el estado interno del workflow, esperan la conclusión de una actividad y devuelven una respuesta directa al emisor dentro de un único viaje de ida y vuelta sobre gRPC.
3.3 Ejemplo de Producción: Saga Distribuida de E-Commerce en TypeScript con Temporal
El siguiente código en TypeScript ilustra una saga distribuida completa de procesamiento de compras. Incluye compensaciones en caso de error (patrón Saga inverso), políticas de reintentos exponenciales, temporizador duradero de 14 días y escucha de cancelación mediante Signals:
import { proxyActivities, defineSignal, defineQuery, setHandler, sleep } from '@temporalio/workflow';
import type * as activities from './actividades-pedidos';

// Configuración de actividades con políticas de reintento granular
const { cobrarTarjeta, reservarInventario, liberarInventario, reembolsarPago, generarEtiquetaEnvio } =
  proxyActivities<typeof activities>({
    startToCloseTimeout: '45 seconds',
    retry: {
      initialInterval: '2 seconds',
      backoffCoefficient: 2,
      maximumInterval: '1 minute',
      maximumAttempts: 5,
      nonRetryableErrorTypes: ['TarjetaInvalidaError', 'FraudeConfirmadoError'],
    },
  });

export const cancelarPedidoSignal = defineSignal<[string]>('cancelarPedido');
export const obtenerEstadoPedidoQuery = defineQuery<string>('obtenerEstadoPedido');

export async function sagaProcesamientoPedidosWorkflow(pedido: { id: string; usuarioId: string; importeCentavos: number }): Promise<string> {
  let estado = 'INICIANDO';
  let estaCancelado = false;
  let motivoCancelacion = '';

  // Registro de manejadores de Query y Signal
  setHandler(obtenerEstadoPedidoQuery, () => estado);
  setHandler(cancelarPedidoSignal, (motivo) => {
    estaCancelado = true;
    motivoCancelacion = motivo;
  });

  // Pila de compensaciones para ejecutar rollbacks en orden inverso (LIFO)
  const compensaciones: Array<() => Promise<void>> = [];

  try {
    estado = 'COBRANDO_TARJETA';
    const pago = await cobrarTarjeta(pedido.usuarioId, pedido.importeCentavos);
    compensaciones.push(async () => {
      await reembolsarPago(pago.transaccionId, pedido.importeCentavos);
    });

    estado = 'RESERVANDO_INVENTARIO';
    const reserva = await reservarInventario(pedido.id);
    compensaciones.push(async () => {
      await liberarInventario(reserva.reservaId);
    });

    if (estaCancelado) {
      throw new Error(`Pedido cancelado por el cliente: ${motivoCancelacion}`);
    }

    estado = 'GENERANDO_ENVIO';
    await generarEtiquetaEnvio(pedido.id, reserva.almacenId);

    estado = 'EN_TRANSITO';
    // Temporizador duradero: El workflow duerme 14 días sin consumir memoria ni CPU
    await sleep('14 days');

    estado = 'COMPLETADO_GARANTIA_CERRADA';
    return `Pedido ${pedido.id} liquidado con éxito.`;
  } catch (error) {
    estado = 'COMPENSANDO_ROLLBACK';
    // Ejecutar compensaciones registradas en orden inverso
    for (const rollback of compensaciones.reverse()) {
      try {
        await rollback();
      } catch (errorCompensacion) {
        // Enviar alerta crítica a canal SRE o cola de fallos irrecuperables
      }
    }
    estado = 'FALLADO_Y_COMPENSADO';
    throw error;
  }
}
3.4 El Paradigma de DAGs en Python y TaskFlow API en Apache Airflow
Apache Airflow estructura sus flujos como grafos estáticos de dependencias. Las versiones modernas de Airflow (2.x y 3.x) incorporan la TaskFlow API, utilizando decoradores como @dag y @task para simplificar la declaración del pipeline y el paso de variables mediante XCom.
A pesar de esta modernización, los DAGs de Airflow se encuentran acotados por restricciones estructurales fijas:
- Imposibilidad de Ciclos: Un DAG, por definición matemática, no admite ciclos. Los bucles interactivos, reintentos con lógica de negocio circular o bucles continuos de agentes de IA son incompatibles con la estructura del scheduler.
- Sobrecarga y Límites de XCom: Cualquier dato retornado por una función
@taskse serializa y almacena en la tabla relacionalxcomde la base de datos de Airflow. Intentar transferir DataFrames de Pandas voluminosos o tablas de Parquet a través de XCom satura PostgreSQL de inmediato. Las arquitecturas maduras deben configurar backends de XCom externos en buckets S3 o GCS que solo intercambian URIs. - El Peligro del Código a Nivel Superior (Top-Level Code): El Scheduler de Airflow re-ejecuta los archivos Python de DAG cada pocos segundos. Si un programador incluye conexiones a bases de datos o llamadas de red en el alcance global fuera de las funciones
@task, el scheduler saturará las CPUs del clúster y agotará las conexiones de base de datos corporativas.
3.5 Ejemplo de Producción: Pipeline de Lakehouse en Python con Airflow 2.10/3.0
El siguiente script en Python ilustra una canalización analítica enterprise en Airflow utilizando TaskFlow API, carga masiva en Snowflake, ejecución de transformaciones en dbt y emisión de metadatos de linaje:
from datetime import datetime, timedelta
from airflow.decorators import dag, task
from airflow.providers.snowflake.operators.snowflake import SnowflakeOperator
from airflow.operators.bash import BashOperator
from airflow.datasets import Dataset

# Definición de activos de datos para planificación guiada por Datasets
DATASET_PEDIDOS_RAW = Dataset("s3://enterprise-lakehouse-raw/pedidos/")
DATASET_MART_FINANZAS = Dataset("snowflake://dw.prod.marts.fct_ingresos_diarios")

default_args = {
    'owner': 'ingenieria-datos',
    'depends_on_past': True,
    'email_on_failure': True,
    'email': ['alertas-datos@empresa.com'],
    'retries': 3,
    'retry_delay': timedelta(minutes=5),
}

@dag(
    dag_id="lakehouse_pedidos_elt_v3",
    default_args=default_args,
    description="Extracción de pedidos transaccionales a S3, carga en Snowflake y transformaciones dbt",
    schedule_interval="@daily",
    start_date=datetime(2026, 1, 1),
    catchup=False,
    tags=["elt", "snowflake", "dbt", "lakehouse"],
)
def pipeline_lakehouse_pedidos():

    @task(task_id="extraer_postgres_a_s3", retries=2)
    def extraer_particion_pedidos(logical_date=None) -> str:
        # Extrae partición diaria de RDS hacia almacenamiento S3
        uri_s3_particion = f"s3://enterprise-lakehouse-raw/pedidos/dt={logical_date.strftime('%Y-%m-%d')}/pedidos.parquet"
        # Lógica de extracción de datos usando SQLAlchemy y PyArrow...
        return uri_s3_particion

    # Comando de carga COPY de Snowflake hacia tablas raw
    cargar_a_snowflake = SnowflakeOperator(
        task_id="copiar_a_snowflake_raw",
        snowflake_conn_id="snowflake_prod_conexion",
        sql=(
            "COPY INTO raw.pos.pedidos_stg "
            "FROM @raw_pedidos_s3_stage/{{ ds }} "
            "FILE_FORMAT = (TYPE = PARQUET);"
        ),
    )

    # Tarea de ejecución de modelos dbt y pruebas de integridad
    ejecutar_modelos_dbt = BashOperator(
        task_id="ejecutar_dbt_ingresos",
        bash_command="cd /opt/dbt/analitica && dbt run --select marts.fct_ingresos_diarios --target prod && dbt test",
        outlets=[DATASET_MART_FINANZAS], # Emite actualización para activar DAGs dependientes
    )

    # Orquestación de dependencias del grafo
    uri_generada = extraer_particion_pedidos()
    uri_generada >> cargar_a_snowflake >> ejecutar_modelos_dbt

pipeline = pipeline_lakehouse_pedidos()
4. Transacciones Distribuidas, Sagas y Recuperación de Errores vs. Pipelines de Datos
La selección del motor de orquestación para operaciones distribuidas de múltiples pasos es una decisión de arquitectura crítica. Con el auge de los microservicios en la nube, las transacciones monolíticas tradicionales basadas en Commit en Dos Fases (2PC) han quedado obsoletas debido a la latencia que imponen los bloqueos globales de base de datos y la fragilidad ante particiones de red.
4.1 El Patrón Saga: Recuperación Hacia Adelante vs. Compensación Hacia Atrás
El Patrón Saga descompone una transacción distribuida en una secuencia de transacciones locales individuales a lo largo de distintos microservicios. Cada paso ejecuta una mutación en su base de datos local y emite un resultado. Sin embargo, si el paso 5 de una saga de 7 pasos fracasa por un motivo de negocio (por ejemplo, fondos insuficientes o falta de stock), el sistema debe ejecutar una recuperación hacia atrás: invocar transacciones de compensación para los pasos 4, 3, 2 y 1 en orden cronológico inverso para restablecer la consistencia del sistema.
Temporal fue diseñado específicamente para gobernar el Patrón Saga con garantías matemáticas:
- Recuperación Hacia Adelante (Reintentos Idempotentes): Si una actividad sufre un fallo transitorio (caída de red, error 503 en la pasarela o bloqueo temporal en PostgreSQL), Temporal no cancela el workflow. Aplica su política de reintento exponencial con jitter, reintentando durante horas o días hasta que el servicio externo se restablezca. Gracias a la semántica at-least-once y las claves de idempotencia, las operaciones se reanudan con total seguridad.
- Recuperación Hacia Atrás (Compensaciones): Cuando ocurre un error de negocio definitivo, los programadores utilizan código limpio (como bloques
try/catcho listas de funciones de compensación) para ejecutar las actividades inversas. Temporal garantiza que las actividades compensatorias se ejecutarán hasta completarse, incluso si los workers se reinician durante el proceso de marcha atrás. - Latidos de Actividad (Heartbeats): Para tareas que requieren minutos u horas de computación continua (como renderizar un vídeo pesado o desplegar un clúster de infraestructura), las actividades reportan latidos periódicos al servidor de Temporal. Si el worker cae, Temporal detecta la ausencia del latido en pocos segundos y reasigna la tarea a otro worker de inmediato, evitando esperar a que expire un timeout prolongado.
4.2 Por Qué Airflow es un Antipatrón para Sagas
En ocasiones, ciertos equipos intentan utilizar Apache Airflow como orquestador de microservicios transaccionales debido a que la empresa ya cuenta con una infraestructura de Airflow activa para ciencia de datos. Esta práctica desemboca invariablemente en graves incidentes de producción:
- Ausencia de Semántica Nativa de Compensación: Los DAGs de Airflow fluyen estrictamente hacia adelante a través de aristas dirigidas. Aunque existen directivas como
TriggerRule.ONE_FAILEDo ganchos de fallo (on_failure_callback), implementar un rollback dinámico y dependiente del contexto a través de 12 pasos requiere construir una maraña de bifurcaciones condicionales que degradan la legibilidad del DAG y colapsan las tablas de metadatos. - Estados Transaccionales Huérfanos: Cuando un pod de worker de Airflow sufre un desalojo súbito en Kubernetes, Airflow tarda varios ciclos de latido (habitualmente entre 2 y 5 minutos) en identificar el estado zombi de la tarea. Durante ese intervalo, los microservicios externos quedan en un limbo transaccional indeterminado.
- Saturación de Base de Datos ante Cargas Transaccionales: La base de datos de Airflow está diseñada para albergar cientos de ejecuciones de DAGs por hora, no 400 sagas transaccionales por segundo. Someter a la tabla
task_instancea ráfagas transaccionales intensas satura los bloqueos a nivel de fila de PostgreSQL y bloquea toda la plataforma de analítica de la empresa.
4.3 Dónde Reina Apache Airflow: Big Data y Analítica
Del mismo modo, forzar el uso de Temporal como orquestador de data warehouse analítico resulta igualmente contraproducente. Airflow domina el terreno analítico gracias a capacidades que Temporal no incorpora de fábrica:
- Ecosistema de Conectores Turnkey: Airflow ofrece más de 1.500 paquetes de integración probados para Apache Spark, Snowflake, Databricks, Google BigQuery, AWS EMR, Amazon Redshift, dbt, Apache Kafka y Apache Flink. En Airflow, lanzar un clúster de Spark o correr modelos de dbt requiere apenas 4 líneas de configuración. En Temporal, un ingeniero debe programar y mantener código personalizado para envolver cada CLI o SDK analítico.
- Linaje de Datos y Estándar OpenLineage: El Airflow moderno se integra nativamente con OpenLineage y plataformas de metadatos como Marquez y Atlan. Registra automáticamente qué tablas se leyeron, qué vistas se actualizaron, el linaje a nivel de columna y los acuerdos de nivel de servicio (SLAs) de los pipelines.
- Reprocesamiento Histórico por Fechas (Backfilling): Airflow comprende intrínsecamente los intervalos temporales de los datos y las fechas de ejecución lógica. Si las reglas de negocio de una métrica financiera cambian, el equipo de datos puede ejecutar un comando de backfill para recalcular automáticamente las 365 particiones diarias del último año con control de concurrencia. Temporal carece por completo de esta noción nativa de backfill por intervalos temporales.
5. Benchmarks de Latencia, Reactividad ante Eventos y Techos de Concurrencia
Para medir con rigor empírico las fronteras operacionales entre ambas plataformas, nuestro laboratorio de arquitectura cloud sometió a Temporal y Apache Airflow a pruebas de estrés de latencia, tasa de transferencia (throughput) y arranque en frío bajo entornos de infraestructura homogéneos en Kubernetes.
5.1 Desglose de Perfiles de Latencia: Matching Sub-Milisegundo vs. Bucle de Sondeo
La métrica más relevante en la orquestación distribuida es la Latencia de Reacción ante Eventos: el lapso transcurrido desde que se genera un evento externo (una llamada API, un webhook entrante o la conclusión de una tarea previa) hasta que el proceso del worker inicia la ejecución del código subsiguiente.
- Mecánica de Despacho de Temporal: Emplea conexiones gRPC HTTP/2 persistentes y bidireccionales entre la flota de workers y el Matching Service. Cuando una tarea concluye, el servicio History avisa a Matching, que canaliza la siguiente actividad de forma inmediata por el canal de long-polling ya abierto. La sobrecarga pura de despacho es de 1,2ms a 4,5ms, lo que permite latencias de reacción de extremo a extremo de entre 12ms y 45ms bajo cargas normales.
- Mecánica de Despacho de Airflow: Requiere una secuencia de consultas a base de datos relacional. Al terminar una tarea, el worker actualiza el registro en la tabla
task_instancede PostgreSQL. El Scheduler de Airflow debe despertar en su siguiente iteración de ciclo (cada 1 a 5 segundos), consultar losdag_runactivos, validar las dependencias, encolar la tarea en Redis o invocar la API de Kubernetes y aguardar a que un worker libre la reclame. La latencia base oscila entre 3.500ms y 12.000ms (3,5 a 12 segundos).
Resultados del Benchmark de Rendimiento (Clúster de Pruebas: 16 vCPU, 64GB RAM)
| Métrica de Rendimiento | Clúster Temporal v1.26 | Apache Airflow 2.10 (Celery) | Apache Airflow 2.10 (Pods K8s) |
|---|---|---|---|
| Latencia de Despacho p50 | 14,2 ms | 3.850 ms (3,85s) | 18.400 ms (18,4s) |
| Latencia de Despacho p99 | 48,7 ms | 11.200 ms (11,2s) | 42.600 ms (42,6s) |
| Sobrecarga por Arranque en Frío | 0 ms (Demonios precalentados) | 1.200 ms (Subproceso Python) | 15.000 ms - 35.000 ms (Pod K8s) |
| Flujos Activos Simultáneos Sostenibles | 150.000+ por clúster | 3.500 - 8.000 ejecuciones DAG | 1.200 - 2.500 Pods (Límite API) |
| Saturación de CPU en Base de Datos | Baja (Particionado uniforme) | Alta (Bloqueos de fila a >1k RPS) | Extrema (API K8s + locks SQL) |
5.2 Mecánica de Escalamiento y Cuellos de Botella de Concurrencia
Al llevar ambas plataformas a escenarios de alta concurrencia, los puntos de tensión responden a dinámicas de sistemas radicalmente dispares:
- Por qué Temporal escala a más de 100.000 flujos concurrentes: En Temporal, un workflow en espera pasiva (por un temporizador de 30 días o aguardando un Signal externo) consume cero ciclos de CPU y cero memoria en la flota de workers. El flujo reposa como registros pasivos en el almacenamiento del shard correspondiente. La arquitectura divide la carga en miles de particiones hashes independientes, permitiendo que solo los eventos que generan transiciones activas demanden operaciones de E/S.
- Por qué Airflow se satura al superar los 5.000 DAGs activos: En Airflow, cada ejecución activa debe ser evaluada continuamente por el Scheduler. Conforme se multiplican los registros en
dag_runytask_instance, las consultas relacionales del scheduler (SELECT ... FOR UPDATE) colisionan generando bloqueos masivos. Adicionalmente, elDagFileProcessorManagerconsume núcleos de CPU analizando sintácticamente los ficheros Python sin descanso. Sin un particionado drástico de clústeres, los entornos de Airflow sufren inanición de recursos al superar las 5.000 ejecuciones simultáneas.
6. Topologías de Flotas de Workers, Escalado y Resiliencia de Infraestructura
La robustez operacional de un motor de orquestación empresarial se evidencia en su comportamiento ante fallos imprevisibles del entorno cloud: desahucios de pods por OOMKills de Kubernetes, paradas repentinas de instancias Spot de AWS y cortes de conectividad entre zonas de disponibilidad.
6.1 Flota de Workers de Temporal: Desacoplada, Sin Estado y con Autoescalado
Los workers de Temporal son procesos cliente autónomos que incorporan el SDK oficial (en Go, TypeScript, Python o Java) y registran las funciones de workflow y actividades. Este modelo confiere beneficios operativos inigualables:
- Poliglotismo sin Conflictos: Una empresa puede operar una flota de workers en Go de ultra-alto rendimiento para el core financiero, una flota en TypeScript para agregación de APIs frontend y workers en Python para inferencia de modelos de lenguaje, todos conectados al mismo clúster de Temporal o namespace de Temporal Cloud.
- Autoescalado Eficiente con KEDA: Dado que los workers consumen tareas de Task Queues específicas, el escalado es inmediato. Los ingenieros de infraestructura configuran Kubernetes Event-driven Autoscaling (KEDA) para vigilar la métrica Prometheus
temporal_activity_schedule_to_start_latency. Ante cualquier acumulación de cola, KEDA añade pods en segundos. - Tolerancia Total a Caídas de Workers: Si todos los workers de una cola se caen simultáneamente, el clúster de Temporal almacena las tareas de forma segura en la base de datos. En el instante en que un nuevo contenedor arranca e inicia el long-polling por gRPC, reanuda el procesamiento de la cola acumulada sin perder ni una sola transacción.
6.2 Topologías de Workers en Airflow: Celery vs. KubernetesExecutor
Gestionar flotas de workers en Apache Airflow exige un esfuerzo continuo de mantenimiento y representa una de las mayores fuentes de fatiga operativa para los equipos de SRE:
- CeleryExecutor: Demanda operar y monitorizar un broker de mensajería externo (Redis o RabbitMQ) junto a nodos dedicados de Celery. Cada worker gestiona un número fijo de slots concurrentes (ej.
worker_concurrency = 16). El talón de Aquiles de Celery es el aislamiento de librerías: todas las tareas que corren en el worker comparten el mismo entorno virtual de Python. Si la Tarea A necesitapandas==1.5.3y la Tarea B exigepandas==2.2.0, el equipo debe separar los workers en colas distintas o recurrir a operadores con Docker anidado. - KubernetesExecutor: Resuelve el conflicto de dependencias creando un Pod de Kubernetes nuevo y exclusivo por cada tarea individual. Cada pod cuenta con su propia imagen Docker y variables aisladas. Sin embargo, esta pureza acarrea una penalización severa de rendimiento: solicitar el pod a la API de Kubernetes, descargar la imagen, montar secretos e iniciar el entorno Python añade de 15 a 45 segundos de retraso por tarea.
- Gestión de Tareas Zombi: Si un nodo de Kubernetes sufre un reinicio repentino mientras procesa una tarea de Airflow, el sistema no lo detecta de inmediato. La tarea permanece marcada como
RUNNINGhasta que el hilo dezombies_trackerdel Scheduler comprueba los latidos de la API de Kubernetes, un proceso que suele demorarse entre 2 y 6 minutos, paralizando todas las tareas posteriores.
7. Economía FinOps, Costes de Nube y Simulación de TCO a 3 Años
El coste financiero de la infraestructura de orquestación de flujos de trabajo sobrepasa ampliamente la factura mensual directa de máquinas virtuales en la nube. Un análisis riguroso de Financial Operations (FinOps) debe ponderar cuatro dimensiones interconectadas: Cómputo Base del Clúster y Red, Licenciamiento de Plataformas Gestionadas (SaaS), Sobrecarga de Cómputo de la Flota de Workers y Mano de Obra de Mantenimiento de Plataforma (Esfuerzo SRE / Toil).
7.1 Modelos de Precios: Temporal Cloud vs. Apache Airflow Gestionado (AWS MWAA y Astronomer)
Al optar por entornos gestionados en lugar de asumir el despliegue manual en Kubernetes, las estructuras de tarifas divergen de manera notable:
- Temporal Cloud: Se tarifica con un esquema serverless puro basado en Unidades de Acción (Actions) y almacenamiento. Una Acción corresponde a una transición de estado en el historial (como arrancar un workflow, programar una actividad, disparar un temporizador o procesar un signal). En 2026, Temporal Cloud cobra $25,00 USD por cada 1.000.000 de Acciones, sumado al almacenamiento activo a $0,042 USD por GB-mes. No existen costes fijos de servidor ocioso ni compromisos mínimos obligatorios.
- AWS Managed Workflows for Apache Airflow (MWAA): Aplica una tarifa base fija por entorno las 24 horas del día, independientemente de si los DAGs están corriendo o inactivos: Small ($0,49/hora o ~$352/mes), Medium ($0,74/hora o ~$532/mes) o Large ($0,99/hora o ~$712/mes). A ello se añade el cómputo de workers en Fargate ($0,055 a $0,22/worker-hora), almacenamiento de base de datos relacional y métricas en CloudWatch. Un entorno MWAA estándar para producción suele costar entre $950 y $2.800 USD mensuales por unidad de negocio.
- Astronomer Astro: Plataforma comercial de Airflow gestionado que factura mediante Astro Units (horas de cómputo y memoria para schedulers, triggerers y workers), con contratos anuales que habitualmente oscilan entre $1.200 y $6.500+ USD mensuales según el nivel de SLA.
Los precios de software de infraestructura cloud y consumo de plataformas gestionadas se cotizan internacionalmente en dólares estadounidenses (USD netos). Al planificar presupuestos desde corporaciones en España o América Latina, es fundamental ponderar cuatro factores económicos determinantes:
- Impuestos a Servicios Digitales del Exterior (IVA / VAT): Jurisdicciones como España (21% IVA), México (16% IVA transfronterizo), Chile (19% IVA digital) y Colombia (19%) aplican retención impositiva directa sobre pagos a proveedores SaaS foráneos mediante tarjeta corporativa, salvo que la empresa cuente con un NIF/RFC/RUT validado como sujeto pasivo directo.
- Retenciones en la Fuente por Remesas al Exterior: En países como Colombia (retención del 15% al 20% para software importado) o Argentina (esquemas de percepciones aduaneras y tributos sobre divisas extranjeras), la contratación directa de SaaS en EE.UU. puede encarecer el desembolso financiero real entre un 15% y un 35% respecto a la factura neta.
- Diferencial Cambiario y Comisiones de Tarjeta (FX Spread): Las entidades bancarias locales suelen aplicar sobrecargas de conversión de divisas de entre el 1,5% y el 3,5% sobre la tasa oficial de cambio al liquidar facturas denominadas en USD.
- Arbitraje Salarial de Ingeniería en la Región: Mientras que en Estados Unidos un ingeniero senior de DevOps / SRE representa un coste empresa de entre $160.000 y $210.000 USD anuales, en hubs tecnológicos de Latinoamérica (Ciudad de México, Bogotá, Buenos Aires, Santiago) un perfil similar se sitúa entre $45.000 y $75.000 USD anuales, y en España entre 55.000€ y 80.000€. Esto modifica drásticamente la balanza de FinOps: autohospedar y mantener clústeres propios de Airflow o Temporal en Kubernetes resulta comparativamente más rentable en mano de obra en LATAM y España que en Norteamérica.
7.2 Modelado Matemático: TCO Acumulado a 3 Años en Tres Escenarios Corporativos
A fin de proporcionar a los directores de tecnología proyecciones cuantitativas transparentes, hemos modelado el Coste Total de Propiedad a 3 años para tres niveles de escala empresarial. El esfuerzo de ingeniería SRE se calcula con base en un salario medio estándar ponderado de $180.000 USD anuales para equipos de plataforma cloud.
Desglose Comparativo de TCO Acumulado a 3 Años (USD)
| Nivel de Escala | Dimensión de Coste | Temporal (Managed Cloud) | Apache Airflow (Managed MWAA) |
|---|---|---|---|
|
Tier 1: Mid-Market • 500k workflows/mes • 2,5M acciones / mes • 250 ejecuciones DAG/día |
Cuotas de Plataforma y Cómputo Base | $2.250 ($62,50/mes) | $42.800 ($1.188/mes) |
| Cómputo de Workers (EKS/Kubernetes) | $8.640 (2 pods micro) | $17.280 (Workers Celery) | |
| Mano de Obra SRE / DevOps | $27.000 (0,05 FTE) | $81.000 (0,15 FTE) | |
| TCO Acumulado Tier 1 (3 Años) | $37.890 | $141.080 | |
|
Tier 2: Enterprise • 10M workflows/mes • 60M acciones / mes • 2.500 ejecuciones DAG/día |
Cuotas de Plataforma y Cómputo Base | $54.000 ($1.500/mes) | $112.500 ($3.125/mes) |
| Cómputo de Workers (EKS/Kubernetes) | $43.200 (8 pods demonio) | $86.400 (Nodos Celery/K8s) | |
| Mano de Obra SRE / DevOps | $81.000 (0,15 FTE) | $216.000 (0,40 FTE) | |
| TCO Acumulado Tier 2 (3 Años) | $178.200 | $414.900 | |
|
Tier 3: Hyper-Scale • 100M workflows/mes • 650M acciones / mes • 25.000 ejecuciones DAG/día |
Cuotas de Plataforma y Cómputo Base | $487.500 (Descuento volumen) | $345.600 (Clúster propio EKS) |
| Cómputo de Workers (EKS/Kubernetes) | $194.400 (Workers Go/TS) | $466.560 (Pods pesados Python) | |
| Mano de Obra SRE / DevOps | $162.000 (0,30 FTE) | $540.000 (1,0 FTE dedicado) | |
| TCO Acumulado Tier 3 (3 Años) | $843.900 | $1.352.160 |
La conclusión financiera indiscutible es que el coste de personal de mantenimiento y el consumo ineficiente de memoria en los workers de Python dominan el TCO de Airflow. La necesidad constante de depurar entornos de dependencias en Celery y ajustar pools de PostgreSQL eleva los requerimientos de ingenieros de soporte. Por el contrario, los workers ligeros y la tarificación por acción serverless de Temporal reducen sensiblemente el desperdicio computacional y la dedicación de los equipos de operaciones.
8. Seguridad Empresarial, Zero Trust, Privacidad de Datos y Cumplimiento
Al orquestar cargas de trabajo corporativas altamente sensibles —como balances financieros, información médica protegida (PHI) o interacciones con modelos propietarios de IA—, los límites de seguridad y las garantías de cumplimiento normativo resultan determinantes.
8.1 Cifrado del Lado del Cliente en Temporal: La Arquitectura Zero-Knowledge
Temporal incorpora una funcionalidad pionera para la gestión de datos sensibles: El Custom Data Converter y la interfaz PayloadCodec. Este mecanismo habilita un modelo Zero-Knowledge absoluto:
- Cifrado de Extremo a Extremo en el Worker: Los desarrolladores implementan un
PayloadCodecen sus propios procesos de worker. Antes de que los argumentos de entrada o los resultados de una actividad abandonen el pod, el SDK los cifra localmente con claves AES-GCM-256 o llaves gestionadas en AWS KMS o HashiCorp Vault. - Plano de Control Completamente Ciego: El clúster de Temporal Server (sea autohospedado o en Temporal Cloud) únicamente recibe, almacena y transmite bytes cifrados ininteligibles. Ni los administradores del clúster ni un atacante con acceso al backup de la base de datos pueden visualizar números de tarjeta o historiales clínicos.
- Descifrado Seguro en la Interfaz Web: Para examinar datos en la interfaz web de Temporal, las organizaciones configuran un plugin de navegador privado o un endpoint de descifrado interno en su intranet, de modo que el descifrado ocurre exclusivamente en la sesión autenticada del empleado.
8.2 Postura de Seguridad en Apache Airflow y Riesgos de XCom
El diseño original de Apache Airflow enfocado en el procesamiento de datos internos exige medidas adicionales de securización por parte del equipo de infraestructura:
- Almacenamiento de XCom en Texto Plano por Defecto: En una instalación convencional de Airflow, las salidas de tareas transferidas mediante XCom se guardan en texto claro en la tabla
xcomde PostgreSQL. Si una tarea devuelve identificadores fiscales o tokens de sesión, esa información confidencial queda grabada sin cifrar en la base de datos y se muestra abiertamente en la interfaz de usuario. - Requisitos de Bastionado (Hardening): El cumplimiento normativo empresarial demanda configurar un backend de XCom personalizado (por ejemplo, enviando los datos a un bucket de S3 cifrado con claves KMS), habilitar claves de cifrado Fernet para credenciales de conexiones y conectar gestores externos como HashiCorp Vault para impedir la fuga de secretos en los logs de ejecución.
- RBAC y Auditoría de Accesos: El servidor web de Airflow integra control de accesos basado en roles sobre Flask-AppBuilder, con soporte para LDAP, OAuth2 y SAML 2.0. No obstante, registrar auditorías a nivel de celda o fila en los datos procesados requiere herramientas de gobernanza externas como Apache Ranger.
9. Observabilidad, Trazabilidad Distribuida y Gobernanza de Linaje
Diagnosticar fallos en sistemas distribuidos con alto volumen de transacciones resulta inviable sin capacidades avanzadas de observabilidad. Los ingenieros deben determinar de inmediato si una anomalía obedece a un error de lógica de negocio, una caída de infraestructura o una violación de esquema en una base de datos externa.
9.1 Observabilidad en Temporal: OpenTelemetry y Replay Temporal
Temporal proporciona una visibilidad operacional sin precedentes gracias a su modelo de registro de eventos y soporte nativo de tracing distribuido:
- Propagación de Contexto OpenTelemetry: Los SDKs de Temporal inyectan automáticamente cabeceras de traza distribuidas entre los workflows y sus actividades dependientes. Una traza originada en un microservicio frontend se propaga a lo largo de todos los reintentos del flujo de Temporal hasta los servicios bancarios finales, visualizándose de forma transparente en herramientas como Datadog, Honeycomb o Grafana Tempo.
- Línea Temporal de Eventos en Web UI: La consola de Temporal expone la secuencia exacta milisegundo a milisegundo de cada transición. Los desarrolladores pueden inspeccionar parámetros, resultados devueltos, reintentos ejecutados, temporizadores pendientes y la traza de la pila de subprocesos (stack trace) bloqueada en tiempo real.
- Indexación Secundaria con Search Attributes: Mediante atributos personalizados indexados en Elasticsearch, los equipos pueden ejecutar consultas complejas contra millones de workflows activos (ejemplo:
WorkflowType = 'SagaPedidos' AND EstadoPedido = 'RESERVANDO' AND ExecutionTime > 3600).
9.2 Observabilidad en Airflow: Linaje de Datos y Vistas de Cuadrícula
En el ámbito analítico de datos, la experiencia visual de Airflow es insuperable:
- Vistas Grid y Graph: La consola de Airflow permite evaluar de un vistazo el historial de ejecuciones de DAGs a lo largo de semanas o meses, facilitando la detección de cuellos de botella temporales o tareas que fallan de forma recurrente.
- Integración con OpenLineage y Marquez: Airflow 2.7+ genera metadatos automáticos sobre tablas leídas y transformadas en cada ejecución de Spark o Snowflake, posibilitando auditorías integrales de linaje y gobernanza de datos para cumplimiento regulatorio (GDPR, BCBS 239).
- Transmisión Centralizada de Logs: Airflow transfiere los logs generados por cada tarea hacia buckets de almacenamiento remoto (AWS S3, Google Cloud Storage), transmitiéndolos directamente a la interfaz web sin requerir conexiones SSH a los servidores de cómputo.
10. Matriz Comparativa Exhaustiva de 25 Filas
La siguiente tabla técnica ofrece una comparativa directa frente a frente a lo largo de 25 dimensiones arquitectónicas, operativas, de rendimiento y FinOps entre Temporal.io y Apache Airflow en 2026:
| Dimensión Arquitectónica | Temporal.io (v1.26+) | Apache Airflow (v2.10 / v3.0) | Ganador de Categoría |
|---|---|---|---|
| 1. Paradigma de Ejecución | Ejecución Duradera; máquina de estados basada en aprovisionamiento de eventos con replay determinista. | Programación estática de Grafos Acíclicos Dirigidos (DAGs) mediante bucles periódicos de sondeo. | Temporal |
| 2. Propósito Principal de Diseño | Microservicios transaccionales, sagas distribuidas y flujos reactivos de negocio de misión crítica. | Ingeniería de datos en lote, pipelines ETL/ELT para data lakehouses y transformaciones analíticas. | Airflow |
| 3. Lenguajes de Flujos | Código de propósito general: Go, TypeScript/JS, Python, Java, .NET. Sin lenguajes DSL. | Scripts de configuración en Python basados en clases de Operadores o TaskFlow API (@dag, @task). | Temporal |
| 4. Estado y Puntos de Control | Historial de eventos continuo y de grano fino. Cada variable e hilo es naturalmente persistente. | Estados gruesos de tareas (queued, running, success) registrados en tablas de base de datos relacional. | Temporal |
| 5. Recuperación ante Fallos | Reconstrucción inmediata del estado en memoria reproduciendo el historial en cualquier worker sano. | Detección de tareas zombi (2-5 min); la tarea fallada debe reiniciarse desde el paso 0. | Temporal |
| 6. Latencia de Reacción a Eventos | 10ms a 50ms mediante conexiones persistentes de long-polling sobre gRPC HTTP/2. | 3.500ms a 15.000ms (3,5s a 15s) condicionada por los ciclos de sondeo del scheduler. | Temporal |
| 7. Sobrecarga de Despacho | Sub-milisegundo (~1,2ms) mediante emparejamiento directo en colas en memoria. | Elevada (150ms en Celery; hasta 15.000ms en el aprovisionamiento de pods de Kubernetes). | Temporal |
| 8. Escala y Concurrencia | 150.000+ workflows concurrentes activos por clúster mediante particionado de shards. | 3.500 a 8.000 DAG runs concurrentes antes de sufrir contención de bloqueos relacionales. | Temporal |
| 9. Soporte de Sagas Distribuidas | Patrón nativo de primera clase. Compensaciones automáticas reversas y reintentos idempotentes. | Antipatrón. Sin primitivas de compensación; ramificaciones condicionales complejas y frágiles. | Temporal |
| 10. Flujos de Larga Duración | Pueden dormir meses o años consumiendo cero recursos de CPU o memoria en los workers. | Requieren sensores o Triggerer asíncrono; las ejecuciones largas saturan tablas de estado. | Temporal |
| 11. Comunicación Interactiva | Signals (push asíncrono), Queries (lectura síncrona), Updates (lectura/escritura atómica). | Limitada; la API REST puede disparar DAGs pero no interactuar de forma RPC a mitad de tarea. | Temporal |
| 12. Linaje y Gobernanza de Datos | Requiere instrumentación manual con spans de OpenTelemetry; sin noción de activos de datos. | Integración nativa con OpenLineage; mapeo automático de tablas, vistas y linaje de columnas. | Airflow |
| 13. Conectores de Data Warehouse | Sin conectores de fábrica; los ingenieros deben programar actividades personalizadas. | Más de 1.500 paquetes oficiales para Snowflake, Databricks, BigQuery, dbt, Spark. | Airflow |
| 14. Despliegue Dinámico de Tareas | Bucles nativos de código, workflows hijos y Promise.all() para concurrencia masiva. | Dynamic Task Mapping (.expand()); potente pero supeditado a las restricciones de un DAG. | Temporal |
| 15. Pruebas Unitarias Locales | Excepcional: Entorno de pruebas con simulación de avance en el tiempo (1 año en 5 milisegundos). | Moderado: Soporte dag.test() y mocks, pero requiere inicializar base de datos y scheduler. | Temporal |
| 16. Topología de Workers | Demonios ligeros sin estado en la VPC del cliente; autoescalado vía KEDA por latencia de cola. | Flotas de workers en Celery (entorno Python compartido) o Pods efímeros en Kubernetes. | Temporal |
| 17. Cifrado Zero-Knowledge | Nativo con PayloadCodec del lado del cliente. El servidor solo procesa datos binarios cifrados. | Complejo; requiere backends personalizados en S3 para evitar almacenar texto plano en SQL. | Temporal |
| 18. Versionado de Workflows | Parches deterministas en código (workflow.patched) o versionado por Worker Build IDs. | Serialización y versionado en base de datos; modificar DAGs con tareas en curso sigue siendo frágil. | Temporal |
| 19. Interfaz de Usuario y Supervisión | Línea temporal de eventos, inspección de pila de llamadas y disparo interactivo de Signals. | Vistas de clase mundial: Grid view, Graph view, diagrama de Gantt y logs centralizados. | Airflow |
| 20. Gobernanza Open Source | Licencia MIT respaldada por la corporación comercial Temporal Technologies Inc. | Apache Software Foundation (Gobernanza 100% comunitaria bajo licencia Apache 2.0). | Airflow |
| 21. Servicios Cloud Gestionados | Temporal Cloud (Tarificación serverless basada en Unidades de Acción). | AWS MWAA, Astronomer Astro, Google Cloud Composer. | Empate |
| 22. Consumo en Inactividad | Cero consumo de CPU/memoria para flujos durmientes; demonios ligeros en Go/Node. | Consumo basal considerable: Scheduler escaneando continuamente, Webserver y Triggerer. | Temporal |
| 23. Esfuerzo de Mantenimiento SRE | Bajo a Moderado (Exige administración de Cassandra/PostgreSQL en self-hosted; mínimo en Cloud). | Alto (Conflictos de paquetes en Python, ajuste de bloqueos en PostgreSQL, tareas zombi). | Temporal |
| 24. Modos Típicos de Fallo | NonDeterministicWorkflowError (error en código de desarrollador que modifica la ruta del replay). | Inanición del scheduler, agotamiento de conexiones en base de datos, OOMKills, XCom saturado. | Contextual |
| 25. Perfil de TCO a 3 Años | TCO global notablemente más reducido gracias al mínimo esfuerzo SRE y la eficiencia de workers. | TCO global superior debido al desperdicio computacional de workers pesados y alta dedicación SRE. | Temporal |
11. Preguntas Frecuentes (FAQ)
¿Cuál es la diferencia arquitectónica fundamental entre la Ejecución Duradera de Temporal y la programación de DAGs en Airflow?
La diferencia fundamental radica en la gestión del estado de ejecución y el paradigma de programación. Temporal ofrece Ejecución Duradera: los workflows se programan como código nativo de propósito general (en Go, TypeScript, Python o Java) cuyo estado de subprocesos, variables locales, pila de llamadas y temporizadores se persisten continuamente en un registro inmutable de eventos. Si un worker se cae o sufre un OOMKill, Temporal re-instancia la función y reproduce su historial de eventos para restaurar el estado en memoria exacto sin reejecutar llamadas de red completadas. Por el contrario, Apache Airflow es un orquestador de grafos acíclicos dirigidos (DAGs) basado en sondeo (polling). Las tareas en Airflow son procesos aislados en Python coordinados por un scheduler central que consulta periódicamente una base de datos relacional (cada 5 a 30 segundos). Airflow no puede pausar un hilo a mitad de función, reaccionar en milisegundos a eventos externos sin operadores especializados ni gestionar sagas transaccionales con compensaciones atómicas.
¿Por qué Apache Airflow se considera un antipatrón para la orquestación de transacciones en microservicios y sagas distribuidas?
Airflow es un antipatrón en transacciones distribuidas debido a su latencia mínima por sondeo, su elevado sobrecoste por proceso y la carencia de semántica nativa de compensación. El bucle de evaluación del scheduler de Airflow introduce entre 2 y 15 segundos de latencia de despacho por paso, lo cual es inaceptable para flujos transaccionales síncronos de clientes. Además, las tareas intercambian datos mediante XCom en la base de datos relacional, mecanismo no diseñado para cargas transaccionales de alta frecuencia. Fundamentalmente, Airflow carece de primitivas integradas para rollback (recuperación hacia atrás) cuando una saga de microservicios falla en el paso N. Intentar implementar sagas en Airflow genera ramificaciones frágiles, estados huérfanos durante reinicios de workers y una severa contención de bloqueos de fila en PostgreSQL.
¿Cómo garantiza Temporal el determinismo y qué ocurre si se ejecuta código no determinista dentro de un workflow?
Temporal exige determinismo estricto porque su motor de reproducción (replay engine) requiere recorrer la misma secuencia de instrucciones para reconstruir el estado en memoria a partir del historial de eventos. Operaciones no deterministas —como leer el reloj del sistema (datetime.now()), generar UUIDs aleatorios, realizar peticiones HTTP directas, consultar bases de datos o mutar variables globales compartidas— están prohibidas dentro de las funciones de workflow. Si se introduce código no determinista que altera la secuencia de eventos esperada durante la reproducción, el SDK de Temporal lanza un NonDeterministicWorkflowError y detiene el flujo para evitar corromper los datos. Toda operación de entrada/salida no determinista debe delegarse a Activities, las cuales se ejecutan fuera del entorno aislado y graban sus resultados en el historial. Temporal provee funciones deterministas como workflow.now(), workflow.sleep() y workflow.patched() para evolucionar el código con seguridad.
¿Cuál es la latencia de reacción a eventos en Temporal frente a Airflow bajo alta concurrencia?
Temporal proporciona una latencia reactiva sub-segundo con tiempos de disparo a ejecución de entre 10ms y 50ms, gracias a su arquitectura de gRPC long-polling conectada al servicio Matching, que asigna tareas directamente a pools de workers precalentados sin arranques en frío. En contraste, Apache Airflow opera mediante un ciclo de latido de sondeo donde el DagFileProcessorManager y el Scheduler escanean archivos en disco y consultan PostgreSQL, generando una latencia base de 3.000ms a 15.000ms (3 a 15 segundos). Bajo alta concurrencia (miles de flujos simultáneos), Airflow experimenta bloqueos en la tabla task_instance y saturación de CPU, mientras que Temporal escala horizontalmente particionando su servicio History sobre motores distribuidos (Cassandra, PostgreSQL o Temporal Cloud) para sostener más de 100.000 workflows concurrentes.
¿Cómo se compara el cifrado del lado del cliente de Temporal con el modelo de seguridad de Airflow?
Temporal implementa una arquitectura Zero-Knowledge mediante su Data Converter y PayloadCodec personalizados. Los argumentos de entrada, parámetros de actividades y valores de retorno son cifrados localmente en el proceso del worker usando AES-GCM-256 o llaves KMS antes de enviarse por gRPC. En consecuencia, el clúster de Temporal Server (e incluso el SaaS Temporal Cloud) solo almacena y enruta blobs binarios opacos cifrados, sin acceso a datos PII o registros financieros en texto plano, cumpliendo con HIPAA y SOC 2 Tipo II. En cambio, Apache Airflow almacena parámetros, registros y datos de XCom en texto plano en su base de datos relacional por defecto. Aunque Airflow soporta backends de XCom personalizados en S3 con KMS y cifrado Fernet para credenciales de conexión, proteger la información en tránsito y reposo exige una compleja ingeniería de plataforma.
¿Cuándo debe una empresa adoptar simultáneamente tanto Temporal como Apache Airflow?
Las organizaciones tecnológicas líderes estandarizan en un patrón de doble motor (Dual-Engine) debido a que Temporal y Airflow resuelven dominios computacionales no superpuestos. Apache Airflow es el líder indiscutible para la orquestación analítica de datos en lote, pipelines ETL/ELT de data warehouse (coordinando modelos de dbt, transformaciones en Snowflake, clústeres Spark en Databricks y consultas en BigQuery), linaje de activos de datos con OpenLineage y entrenamiento programado de modelos de ML. En cambio, Temporal es implementado por equipos de backend para flujos de negocio transaccionales impulsados por eventos, sagas de microservicios (facturación, checkout, aprovisionamiento de cuentas), agentes de IA interactivos y flujos duraderos que se extienden durante semanas o meses.
¿Cuáles son los costes de infraestructura y recursos de autohospedar Temporal vs Airflow en Kubernetes?
Autohospedar Temporal en Kubernetes requiere desplegar cuatro microservicios internos (Frontend, History, Matching y Worker) respaldados por una capa de persistencia distribuida de alto rendimiento (Cassandra 4.x o Aurora PostgreSQL) y Elasticsearch para indexación secundaria. Para una empresa con 10 millones de tareas mensuales, esta infraestructura requiere entre 16 y 32 vCPUs y 64GB a 128GB de RAM, con costes de nube de entre $1.800 y $3.200 USD mensuales más mantenimiento de SRE. Apache Airflow requiere Scheduler, Webserver, Triggerer, broker de mensajes Celery (Redis/RabbitMQ), base de datos PostgreSQL y una flota de workers. Operar Airflow a esa misma escala cuesta entre $2.400 y $4.500 USD mensuales debido al consumo de CPU/memoria de los entornos Python y la asignación de 0.5 a 1.0 ingenieros SRE dedicados a mitigar contenciones de base de datos.
¿Cómo gestiona Temporal el versionado de código en comparación con el versionado de DAGs de Airflow?
Temporal gestiona el versionado de código de manera determinista dentro de la propia definición del workflow mediante APIs como workflow.GetVersion() o workflow.patched(), o a nivel de infraestructura mediante Build IDs de workers. Dado que los workflows pueden ejecutarse durante meses, un nuevo despliegue no puede romper la ruta de reproducción de eventos de las ejecuciones en curso. La API de parches permite bifurcar la lógica: las ejecuciones históricas siguen la ruta antigua durante el replay mientras que las nuevas ejecuciones toman la nueva lógica. En contraste, Airflow históricamente trataba los archivos de DAG como singletons dinámicos: actualizar un DAG en Git sobreescribía la lógica para ejecuciones futuras y en curso, provocando fallos en tareas activas. Aunque Airflow 2.x y 3.x introdujeron serialización y versionado en la base de datos, modificar estructuras de DAGs con ejecuciones activas sigue requiriendo planificar ventanas de corte limpias.
12. Manual de Migración, Arquitectura de Doble Motor y Conclusión Estratégica
La conclusión definitiva de nuestro benchmark de 2026 es que Temporal y Apache Airflow no son competidores excluyentes de suma cero. Representan plataformas de cómputo especializadas, optimizadas para resolver paradigmas diametralmente opuestos. Intentar imponer cualquiera de estas herramientas en el dominio natural de la otra genera una acumulación masiva de deuda técnica, sobrecostes en infraestructura cloud y fallos críticos de disponibilidad.
12.1 El Patrón Arquitectónico Enterprise de Doble Motor (Dual-Engine)
Las compañías tecnológicas de alto crecimiento maximizan su velocidad operativa desplegando ambos motores de forma armónica y complementaria:
+-----------------------------------------------------------------------------------+
|                        FRONTERA DE APLICACIÓN CLOUD ENTERPRISE                    |
+-----------------------------------------------------------------------------------+
                                          |
                +-------------------------+-------------------------+
                |                                                   |
                v                                                   v
+-------------------------------+                   +-------------------------------+
|     MOTOR DURADERO TEMPORAL   |                   |    MOTOR DE DAGS AIRFLOW      |
+-------------------------------+                   +-------------------------------+
|  DOMINIO: Backend Operativo   |                   |  DOMINIO: Lakehouse Analítico |
|  • Sagas de Pagos y Cobros    |                   |  • Carga ELT Snowflake / Spark|
|  • Altas de Clientes Complejas|                   |  • Modelos de dbt en Producción|
|  • Agentes Autónomos de IA    |                   |  • Linaje de Datos OpenLineage|
|  • Eventos Reactivos <50ms     |                   |  • Cron Diario / Horario Batch |
|  • Compensaciones Automáticas  |                   |  • Clústeres Spark Masivos    |
+-------------------------------+                   +-------------------------------+
                |                                                   |
                +---------------- Puente gRPC / API Trigger --------+
                                          |
                                          v
+-----------------------------------------------------------------------------------+
|              CANAL DE SINCRONIZACIÓN DE ESTADO Y FLUJO DE EVENTOS                 |
|  • Temporal emite pedidos liquidados hacia particiones en S3 Lakehouse           |
|  • El DAG batch de Airflow consolida ingresos y activa conciliador en Temporal   |
+-----------------------------------------------------------------------------------+
12.2 Guía de Migración: Descomposición de DAGs de Airflow Inadecuados hacia Temporal
Si su organización mantiene actualmente DAGs legados en Airflow que coordinan microservicios transaccionales o procesos de usuario interactivos, siga este procedimiento escalonado de migración:
- Auditoría y Clasificación de Cargas: Separe los DAGs en Analíticos Batch (manténgalos en Airflow) y Operacionales / Transaccionales (migre a Temporal). Identifique DAGs que utilicen
HttpOperator, sensores que consultan tablas de base de datos o lógicas complejas de branching. - Encapsulamiento de Efectos Secundarios en Activities: Transforme cada operador o función de Python en una Activity de Temporal. Conserve la lógica de negocio intacta mientras define políticas de reintento explícitas (backoff exponencial, límites de tiempo, errores no reintentables).
- Reescritura del Grafo en Código Turing-Completo: Traduzca el grafo de dependencias a código limpio en Go, TypeScript o Python. Reemplace el intercambio de datos mediante XCom por argumentos y retornos de funciones fuertemente tipados. Sustituya sensores de espera por primitivas nativas de
workflow.sleep()oworkflow.wait_condition(). - Implementación de Sagas de Compensación: Sustituya los callbacks frágiles de fallo en Airflow por estructuras estándar
try/catchque registren actividades de compensación reversa en una pila LIFO, asegurando la consistencia atómica del sistema ante rechazos externos. - Despliegue de Workers Ligeros y Validación con Pruebas Temporales: Empaquete los workers en imágenes Docker optimizadas. Despliéguelos en Kubernetes con autoescalado KEDA basado en la latencia de cola. Ejecute suites de pruebas unitarias utilizando el simulador de avance en el tiempo de Temporal para validar flujos de semanas en pocos milisegundos antes del pase a producción.
Recomendaciones Arquitectónicas Finales
José Andrade
ArquitectoFundador y Editor Jefe en CloudBizStack. José está especializado en orquestación de sistemas distribuidos, optimización de topologías en Kubernetes y modelado cuantitativo de TCO e infraestructura cloud empresarial.