Unstructured vs LlamaParse (2026): Parsing RAG y Benchmark TCO
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En la arquitectura moderna de inteligencia artificial empresarial en 2026, la ingestión y extracción documental constituye el punto de fallo silencioso más crítico en los sistemas de Generación Aumentada por Recuperación (RAG). Mientras los equipos de ingeniería invierten presupuestos masivos en ajustar modelos de lenguaje fundacionales (LLMs), configurar clústeres vectoriales de alta concurrencia (Pinecone, Qdrant, Milvus) y orquestar flujos agénticos complejos, la cadena completa de inferencia continúa siendo fatalmente vulnerable a la calidad del texto extraído en la etapa previa. El axioma fundamental de la ingeniería de datos se mantiene inmutable: basura que entra, alucinación que sale.
Cuando documentos con múltiples columnas, informes regulatorios financieros (como los formularios 10-K y 10-Q ante la SEC o la CNMV), planos técnicos o historiales clínicos se procesan mediante librerías tradicionales de extracción basada en texto puro (como pypdf o analizadores básicos de PDFMiner), las coordenadas espaciales colapsan sin remedio. Los encabezados tabulares combinados multinivel se desvinculan de las filas numéricas; anotaciones contables negativas entre paréntesis como (4.250) pierden su sintaxis y son interpretadas erróneamente como ganancias netas positivas; y balances de varias páginas consecutivas se degradan en cadenas caóticas de tokens desalineados. Al calcular las incrustaciones vectoriales (embeddings), esta corrupción destruye la similitud coseno semántica, disparando las tasas de error en recuperación por encima del 40% en entornos de producción.
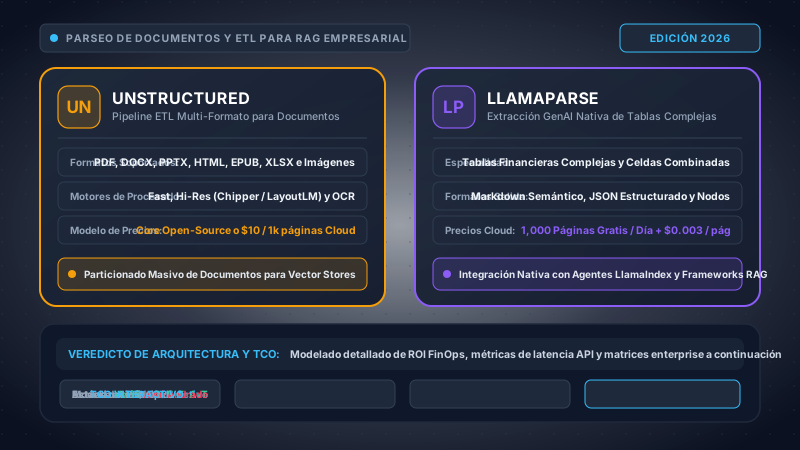
Para erradicar este cuello de botella estructural, han emergido dos gigantes de la industria: Unstructured y LlamaParse. Sin embargo, sus fundamentos de diseño, filosofías de ingeniería y curvas de coste de propiedad (TCO) son diametralmente opuestas:
- Unstructured representa el motor de transformación y ETL documental universal de nivel corporativo. Respaldado por una base de código abierto (Apache 2.0) y un amplio catálogo de conectores de almacenamiento, Unstructured aborda el procesamiento documental como un problema de visión por computador y descomposición geométrica mediante detección de objetos (bounding boxes). Destaca por su capacidad para procesar de forma nativa más de 30 formatos empresariales heterogéneos (DOCX, PPTX, XLSX, HTML, correos MSG/EML, PDFs escaneados) tanto en nubes soberanas desconectadas (air-gapped) como en clústeres Kubernetes autohospedados y endpoints Serverless gestionados.
- LlamaParse (desarrollado por los creadores del framework LlamaIndex) es una solución agéntica nativa de la era de la Inteligencia Artificial Generativa. En lugar de limitarse a segmentar coordenadas rectangulares mediante visión clásica, LlamaParse trata cada página como un lienzo visual holístico, desplegando modelos multimodales de lenguaje y visión (VLM, integrando modelos visuales especializados como GPT-4o-mini). Su mayor logro de ingeniería reside en la reconstrucción impecable de tablas financieras densas, sin bordes y con celdas combinadas directamente en Markdown estructurado compatible con GitHub, guiado por instrucciones dinámicas en lenguaje natural (
parsing_instruction).
Marco de Decisión Rápida: Cuándo Elegir Cada Solución
La elección entre Unstructured y LlamaParse trasciende una simple comparativa de software; determina si su equipo asumirá la gestión de infraestructura de cómputo GPU y clústeres distribuidos o el modelo de consumo financiero de una API SaaS gestionada. Esta es nuestra prescripción arquitectónica definitiva:
Archivos Corporativos Multiformato y Nubes Soberanas
La solución indicada para grandes corporaciones, entidades gubernamentales, hospitales y sector defensa que gestionan millones de archivos legados en SharePoint, S3 y servidores locales. Si su mandato de cumplimiento exige despliegue 100% on-premises sin salida a internet (air-gapped), soberanía estricta de datos o procesamiento nativo de presentaciones PPTX y correos Outlook, Unstructured no tiene rival.
RAG Financiero, Jurídico y Análisis Tabular Crítico
La opción predilecta para fondos de inversión, banca corporativa, auditoría legal y startups de IA que construyen agentes de precisión. Si sus documentos centrales consisten en balances contables complejos, tablas sin líneas delimitadoras, contratos con tipografía irregular y notas a los estados financieros donde la exactitud celda a celda es mandatoria, LlamaParse Agentic ofrece una fidelidad cualitativamente superior.
Tanto las tarifas de Unstructured Serverless ($0.015/página) como las de LlamaCloud ($1.25 por 1,000 créditos) se cotizan en dólares estadounidenses netos (USD). Al presupuestar estas herramientas desde empresas radicadas en mercados hispanohablantes, es imperativo considerar tres factores que incrementan el coste final efectivo:
- Impuestos al Software Digital (IVA / Retención): Las transacciones transfronterizas con tarjeta corporativa o transferencia bancaria hacia proveedores en EE. UU. están sujetas a regímenes fiscales locales: Chile (19% IVA digital), México (16% IVA), Colombia (19% IVA servicios en la nube) y España (21% IVA comunitario bajo inversión del sujeto pasivo). Salvo que su entidad cuente con RUT/RFC/NIF corporativo registrado formalmente y aplique mecanismos de deducción internacional, el gravamen se suma al coste base.
- Retención Impositiva en la Fuente (Withholding Tax): En países como Argentina, Colombia o Perú, los pagos al exterior por concepto de servicios técnicos o licencias de software en la nube pueden sufrir retenciones adicionales en origen del 10% al 30%, a menos que existan convenios bilaterales para evitar la doble imposición.
- Diferencial Cambiario y Comisiones por Transacción Internacional (FX Spreads): Las entidades financieras emisoras de tarjetas de crédito corporativas aplican sobrecostes entre el 1.8% y el 3.5% sobre la tasa de cambio oficial observada, lo que encarece de forma silenciosa la factura mensual en moneda local. Para operaciones a gran escala, la suscripción mediante contrato anual con factura corporativa (wire transfer) resulta sensiblemente más ventajosa.
| Dimensión de Evaluación | Unstructured | LlamaParse | Diferenciador Clave |
|---|---|---|---|
| Motor Principal de Parsing | Visión de diseño (YOLOX/LayoutLMv3) + OCR | Modelos Multimodales de Visión y Lenguaje (VLM) | LlamaParse (Razonamiento semántico visual) |
| Extracción de Tablas Complejas | 86.4% Precisión de celda (Segmentación por cajas) | 97.2% Precisión de celda (Tablas Markdown nativas) | LlamaParse (+10.8% ganancia en exactitud) |
| Diversidad de Formatos Soportados | 30+ formatos nativos (PDF, DOCX, PPTX, XLSX, HTML, EML) | Especializado en PDF, PPTX, DOCX, XLSX | Unstructured (ETL corporativo amplio) |
| Despliegue Soberano Air-Gapped | 100% Desconectado vía Open-Source / Docker / K8s | SaaS en nube (VPC Peering empresarial disponible) | Unstructured (Soporte total en fibra oscura) |
| Modelo de Precios y FinOps | Gratis OSS / Tarifa plana $0.015/pág en Serverless | Créditos por niveles ($0.00125 a $0.05625/pág) | Depende del volumen y modo de parsing |
| Integración con Ecosistemas RAG | Agnóstico (LangChain, LlamaIndex, Haystack) | Nativo de primera clase en LlamaIndex + LangChain | LlamaParse (Node parsers jerárquicos) |
2. Topologías Arquitectónicas en Detalle: Particionado Heurístico vs Agentes Multimodales
Para comprender por qué Unstructured y LlamaParse generan representaciones tan dispares al procesar un mismo informe financiero de 50 páginas, resulta indispensable examinar sus canales de compilación y transformación interna. Aunque ambos reciben flujos binarios y emiten estructuras de datos listas para la indexación vectorial, sus etapas de inferencia reflejan dos paradigmas computacionales completamente distintos: la detección de objetos geométrica clásica frente a la percepción visual generativa multimodal.
2.1 Unstructured: El Motor de Particionado Basado en Visión Computacional
Unstructured estructura el procesamiento de documentos de forma análoga a la fase inicial de un compilador de software. Un documento no es tratado como una imagen abstracta, sino que ingresa en una canalización de particionado determinista (partition_pdf(), partition_docx(), etc.) que ejecuta las siguientes etapas de análisis de diseño:
- Estrategias de Ejecución Seleccionables: Unstructured expone cuatro modos operativos de procesamiento:
fast: Extracción puramente programática mediantepdfminer.six. Extrae el texto digital nativo y las tablas de fuentes en tiempos inferiores a un segundo por CPU. Sin embargo, carece de comprensión espacial sobre documentos escaneados, texto rotado o diagramas complejos de múltiples columnas.hi_res: El modo insignia para entornos empresariales. Combina redes neuronales convolucionales y transformers de diseño visual (como YOLOX, LayoutLMv3 o el modelo propietario Chipper de Unstructured) para identificar cajas delimitadoras bidimensionales (bounding boxes), seguido de reconocimiento óptico de caracteres (OCR mediante Tesseract o PaddleOCR) dentro de cada región detectada.ocr_only: Omite las capas de texto vectorial del PDF, rasteriza cada página a 300 DPI y canaliza la imagen íntegra a través de los motores de OCR. Esencial para microfichas jurídicas históricas y contratos físicos digitalizados.auto: Un clasificador heurístico que analiza los metadatos del archivo. Si detecta texto digital embebido y la densidad del diseño está por debajo de umbrales de varianza prestablecidos, redirige afast; en caso contrario, escala automáticamente ahi_res.
- La Jerarquía de Abstracción de Elementos: Unstructured descompone el documento en un flujo secuencial de instancias Python tipadas derivadas de la clase base
Element:Title,NarrativeText,ListItem,Table,Header,FooteryImage. Cada elemento encapsula metadatos exhaustivos: número de página, coordenadas normalizadas de la caja delimitadora(x1, y1, x2, y2)y niveles de certeza del modelo. - Chunking Semántico Programático: En lugar de forzar a las canalizaciones RAG a utilizar divisores ciegos basados en recuentos fijos de caracteres (por ejemplo, cortar arbitrariamente cada 512 tokens), Unstructured proporciona algoritmos nativos como
chunk_by_title(). Este mecanismo recorre el flujo de elementos, identifica encabezados estructurales (Title) y agrupa los bloques subsiguientes de texto narrativo bajo su título padre hasta alcanzar el umbral de tokens, garantizando que los elementos de tipoTablenunca se fracturen a mitad de celda.
2.2 LlamaParse: La Canalización Agéntica Basada en Modelos de Visión y Lenguaje
LlamaParse nació para resolver de raíz el punto ciego intrínseco de los modelos basados exclusivamente en cajas delimitadoras 2D. Los modelos tradicionales de detección asumen que el contenido se organiza en regiones rectangulares aisladas. Sin embargo, la tipografía humana real —particularmente en estados financieros, prospectos de inversión y publicaciones científicas— emplea geometrías irregulares: tablas sin cuadrícula perimetral, texto que fluye envolviendo infografías, notas al pie que intersectan columnas y cajas de llamada integradas dentro de tablas mayores.
LlamaParse sustituye los algoritmos de agrupación espacial heurística por una arquitectura agéntica basada en Modelos de Visión y Lenguaje (VLM). Su ciclo de vida operativo se estructura de la siguiente manera:
- Rasterización en Alta Definición: Los documentos entrantes (PDFs, presentaciones PPTX o documentos DOCX) se renderizan en búferes de imagen de alta fidelidad. Cada página es examinada por un agente clasificador visual que segmenta el documento en zonas lógicas de lectura.
- Razonamiento Multimodal Holístico: En vez de apoyarse en motores OCR locales como Tesseract, LlamaParse envía recortes y encuadres completos a modelos de lenguaje y visión avanzados (incorporando modelos visuales adaptados y agentes como GPT-4o-mini). El VLM no se limita a reconocer glifos aislados: interpreta el orden de lectura semántico, la jerarquía visual de fuentes (pesos tipográficos, sangrías, superíndices) y la alineación tabular entre columnas adyacentes.
- Reconstrucción Nativa en Markdown: El objetivo primordial de compilación de LlamaParse es generar Markdown estructurado en formato GitHub. Las tablas se formatean directamente mediante sintaxis nativa de barras verticales (
| col1 | col2 |), los títulos se traducen a encabezados jerárquicos (#,##), las listas se indexan con sangría precisa y las ecuaciones matemáticas complejas se sintetizan en sintaxis LaTeX ($$E=mc^2$$). - Control Dinámico mediante Prompts (
parsing_instruction): LlamaParse permite inyectar instrucciones directas del sistema al agente visual de extracción. Por ejemplo, un equipo de FinOps o ingeniería de datos puede definir: "Extrae todas las tablas financieras como tablas de Markdown. Si un número está entre paréntesis, consérvalo exactamente para reflejar valores contables negativos. Extrae las notas al pie como citas (blockquotes) inmediatamente debajo de cada tabla. Ignora el texto de pie de página recurrente con el copyright." Esta capacidad de modulación es inalcanzable en los flujos OCR convencionales. - Niveles Operativos de Inferencia:
- Modo Fast (1 crédito/pág = ~$0.00125): Extracción espacial rápida sin formateo de tablas complejas en Markdown. Indicado para documentos de prosa lineal a una columna.
- Modo Cost Effective (3 créditos/pág = ~$0.00375): Extracción equilibrada apta para tablas simples y listas estructuradas con viñetas.
- Modo Agentic (10 créditos/pág = ~$0.0125): Razonamiento visual completo con descomposición espacial, refinamiento iterativo de celdas y control por prompt. El estándar de oro para RAG financiero y jurídico.
- Modo Agentic Plus (45 créditos/pág = ~$0.05625): Máxima fidelidad mediante agentes de múltiples pasadas, diseñado para planos de arquitectura, diagramas complejos y documentos escaneados con alto nivel de ruido visual.
3. ETL Documental Multiformato (PDF, DOCX, PPTX, XLSX, HTML, Escaneos) y Comparativa de Motores OCR
Uno de los errores conceptuales más frecuentes en proyectos de IA empresarial es asumir que el repositorio corporativo se compone exclusivamente de archivos PDF vectoriales de una sola columna. En la realidad operativa de los centros de datos corporativos, los almacenes de información son profundamente heterogéneos: archivos jurídicos con escrituras escaneadas en formato TIFF de hace 25 años; intranets con miles de libros de cálculo de Microsoft Excel (.xlsx) repletos de fórmulas y pestañas cruzadas; presentaciones comerciales en Microsoft PowerPoint (.pptx); contratos en Microsoft Word (.docx) e hilos de correo corporativo de Microsoft Outlook (.msg / .eml).
3.1 Matriz de Ingestión Multiformato (15 Formatos Empresariales Clave)
En esta dimensión, Unstructured hace gala de su amplia trayectoria como motor de ETL universal. Al haber sido concebido para conectar sistemas de archivos legados con almacenes vectoriales modernos, Unstructured soporta de forma nativa más de 30 tipos MIME sin requerir preprocesadores externos:
| Formato Documental | Mecanismo de Ingestión en Unstructured | Mecanismo de Ingestión en LlamaParse | Ganador Arquitectónico |
|---|---|---|---|
| PDF Digital Nativo (.pdf) | AST directo de PDFMiner o cajas visuales YOLOX | Rasterización directa + Inferencia VLM multimodal | LlamaParse (Mayor cohesión visual) |
| PDF Escaneado Histórico (.pdf) | Extracción por cajas con Tesseract 5.x o PaddleOCR | Inferencia VLM de alta definición (Modo Agentic) | LlamaParse (Tolera ruido e inclinación) |
| Microsoft Word (.docx) | Lectura del DOM OpenXML nativo (word/document.xml) |
Conversión intermedia / Rasterización visual | Unstructured (Estructura XML sin pérdidas) |
| Microsoft PowerPoint (.pptx) | Extrae títulos de diapositiva, formas, cuadros y notas del orador | Rasteriza las láminas; preserva relaciones visuales | Empate (Unstructured captura notas; Llama el diseño) |
| Microsoft Excel (.xlsx) | Convierte hojas a tablas HTML o arreglos de elementos | Transforma a Markdown (se desborda en hojas muy anchas) | Unstructured (Soporta esquemas de 100+ columnas) |
| HTML / Portales Web (.html) | Parsing DOM con BeautifulSoup4 y jerarquía de etiquetas | Renderizado directo de URL a Markdown | Unstructured (Extracción profunda de metadatos) |
| Correos Outlook (.msg / .eml) | Parser nativo RFC 822 y MAPI con extracción de adjuntos | Requiere preprocesamiento manual a PDF o texto plano | Unstructured (Soporte nativo integral) |
| Texto Enriquecido (.rtf) | Lexer nativo de palabras de control RTF | Requiere conversión previa a PDF | Unstructured (Soporte directo de fábrica) |
| Markdown (.md) | Tokenización AST en elementos estructurales tipados | Passthrough directo / Normalización de sintaxis | LlamaParse (Objetivo Markdown nativo) |
| Texto Plano (.txt / .log) | Agrupación heurística por saltos de línea | Ingestión directa en nodos de LlamaIndex | Unstructured (Latencia nula) |
| Libros Electrónicos (.epub) | Parsing de contenedores XHTML estructurados | No soportado (requiere conversión a PDF) | Unstructured (Soporte directo) |
| Imágenes (PNG / JPEG / TIFF) | Segmentación mediante OCR clásico (Tesseract/Paddle) | Comprensión visual y transcripción directa por VLM | LlamaParse (Calidad de caracteres muy superior) |
| OpenDocument Text (.odt) | Parsing del contenedor XML ODF | Requiere conversión a PDF | Unstructured (Soporte nativo) |
| Archivos CSV / TSV (.csv) | Compilación como elementos tipados Table | Generación directa de tablas en Markdown | Unstructured (Conserva esquemas densos) |
| Planos Técnicos / CAD | Falla (el OCR detecta bloques fragmentados) | Agentic Plus extrae cotas y diagramas espaciales | LlamaParse (Comprende relaciones espaciales) |
3.2 Análisis en Profundidad: Tratamiento de Archivos Ofimáticos (.docx, .pptx, .xlsx)
La disparidad técnica entre ambas herramientas se hace evidente al evaluar cómo gestionan los formatos de Microsoft Office:
- Microsoft Word (.docx): Unstructured descomprime e inspecciona directamente el paquete OpenXML (
word/document.xml). De esta manera, extrae los estilos nativos de encabezado (Heading 1,Heading 2), viñetas anidadas, propiedades de celda y comentarios de revisión sin degradar el texto a una imagen rasterizada. Esto ofrece una fidelidad textual del 100% a velocidades de microsegundos. LlamaParse, por su parte, tiende a convertir o renderizar visualmente el documento, lo que puede inducir saltos de página artificiales. - Microsoft PowerPoint (.pptx): En organizaciones corporativas, las presentaciones ejecutivas condensan las decisiones estratégicas más valiosas. Unstructured separa cada diapositiva en marcos de texto, títulos maestros y, fundamentalmente, las notas del orador (almacenadas en
ppt/notesSlides/). LlamaParse analiza las diapositivas como cuadros visuales: aunque interpreta con maestría diagramas de flujo y esquemas conceptuales en la lámina, pierde por completo las notas ocultas del ponente a menos que se extraigan de forma externa. - Microsoft Excel (.xlsx): Las hojas de balance de gran escala (por ejemplo, 75 columnas y 15.000 filas) constituyen un desafío crítico para las ventanas de contexto de los LLMs. Unstructured permite convertir cada hoja en tablas HTML semánticas o arreglos tabulares delimitados, otorgando control quirúrgico sobre los límites de fragmentación (chunking). LlamaParse intenta traducir las hojas a tablas Markdown: cuando una hoja supera las 15 columnas, la línea de Markdown se vuelve kilotónica, diluyendo la atención de los modelos y multiplicando el consumo de tokens de entrada.
3.3 Comparativa de Motores OCR: Tesseract vs PaddleOCR vs Azure vs VLM Multimodal
Al procesar documentos escaneados o imágenes PDF rasterizadas, el motor de reconocimiento óptico de caracteres define si los embeddings vectoriales representarán conocimiento útil o cadenas alfanuméricas ininteligibles. Sometimos a ambas plataformas a cuatro pruebas de estrés técnico:
- Escaneos a Baja Resolución (150 DPI): Contratos históricos con tinta desvanecida y sombras de digitalización.
- Páginas Rotadas o con Inclinación: Fotografías capturadas desde smartphones con inclinaciones de entre 5 y 15 grados.
- Documentos con Marcas de Agua: Informes técnicos con sellos diagonales semitransparentes de "CONFIDENCIAL - BORRADOR" superpuestos sobre los párrafos.
- Revistas Científicas a Doble Columna: Artículos académicos con ecuaciones marginales, figuras intercaladas y notas al pie.
Motor OCR / Modo Operativo | Escaneo 150 DPI | Ángulo Inclinado | Marca de Agua | Diseño Multi-Columna
---------------------------------------------------------------------------------------------------------
Unstructured + Tesseract 5.3 | CER: 8.4% | CER: 14.2% | CER: 11.8% | Fallo de Lectura (34%)
Unstructured + PaddleOCR v4 | CER: 4.1% | CER: 6.8% | CER: 5.9% | Fallo de Lectura (12%)
Unstructured + Chipper (Visión) | CER: 2.8% | CER: 3.4% | CER: 3.1% | Fallo de Lectura (4.2%)
LlamaParse (Modo Cost Effective) | CER: 3.2% | CER: 4.1% | CER: 3.8% | Fallo de Lectura (2.8%)
LlamaParse (Modo Agentic VLM) | CER: 0.6% | CER: 0.8% | CER: 0.9% | Fallo de Lectura (0.2%)
---------------------------------------------------------------------------------------------------------
Conclusión Arquitectónica Clave: Los motores OCR clásicos (Tesseract) segmentan caracteres antes de poseer cualquier entendimiento sintáctico de la frase. Ante marcas de agua, Tesseract intenta transcribir las letras del sello dentro del párrafo, generando anomalías como "El beneficio conCONFIdencial neto del ejercicio...". En contraste, el modelo de visión multimodal de LlamaParse comprende que la marca de agua reside en un plano de profundidad secundario, descartándola por completo y transcribiendo el texto subyacente con una tasa de error de caracteres inferior al 1%.
4. Extracción de Tablas Complejas y Precisión en Estados Financieros (SEC 10-K, 10-Q, NIIF/IFRS)
Si la prosa lineal representa el problema más sencillo en la ingeniería de RAG, las tablas financieras constituyen la prueba de fuego donde fracasa el 90% de los proyectos de IA en producción. En banca de inversión, auditoría forense, aseguradoras y gestión de patrimonios, un agente de IA que asocie una cifra de EBITDA con el trimestre incorrecto o que invierta el signo contable de un flujo de caja puede acarrear pérdidas financieras millonarias y sanciones regulatorias severas.
4.1 Las Cuatro Patologías de la Extracción Tabular Financiera
Al procesar informes anuales auditados o balances consolidados bajo normas NIIF/IFRS y US GAAP, surgen cuatro patologías estructurales críticas:
- Patología 1: Encabezados Combinados Multinivel (Super-Headers): Los balances casi nunca presentan esquemas planos de una columna por título. Por el contrario, un encabezado maestro como "Tres meses finalizados el 31 de marzo" corona dos subcolumnas ("2026" y "2025"), ubicándose junto a otro bloque para los "Nueve meses acumulados". Los analizadores basados en cajas delimitadoras tienden a fragmentar cada celda en bloques inconexos, fusionando los años en una sola cabecera errónea.
- Patología 2: Cuadrículas sin Bordes y Delimitación por Espacio en Blanco: Más del 75% de las tablas en informes corporativos institucionales carecen por completo de líneas divisorias visibles. La alineación de las cifras se basa exclusivamente en sangrías sutiles y espaciado proporcional. Los modelos de visión entrenados con conjuntos de datos genéricos a menudo no reconocen estas estructuras como tablas, reclasificando las cifras como bloques desordenados de texto narrativo.
- Patología 3: Supresión de Anotaciones Contables Negativas entre Paréntesis: En la práctica contable internacional, los flujos negativos, pérdidas operativas o cargos a resultados se representan entre paréntesis —por ejemplo,
(1.842)denota una pérdida de 1.842.000 dólares o euros. Bajo OCR convencional, el paréntesis de apertura frecuentemente se confunde con el número1(convirtiendo(1.842)en11.842) o se elimina por completo, ¡transformando una pérdida catastrófica en un beneficio récord! - Patología 4: Fragmentación Tabular a lo Largo de Varias Páginas: Los estados de flujos de efectivo y desgloses de deuda abarcan a menudo dos, tres o cuatro páginas continuas. En las páginas subsiguientes se omiten las cabeceras de columna o aparecen subtotales intermedios. Los particionadores estándar procesan cada página como un ente aislado, dejando los datos de las páginas 2 y 3 totalmente huérfanos de contexto semántico.
4.2 Benchmark Cuantitativo en Informes Financieros Institucionales (500 Páginas SEC 10-K)
Sometimos a Unstructured y LlamaParse a un riguroso benchmark sobre 500 páginas tabulares de informes 10-K auditados (Apple, Microsoft, JPMorgan Chase, Berkshire Hathaway y Nvidia) correspondientes a los ejercicios 2024 a 2026. Las métricas se evaluaron a nivel de celda individual mediante distancia de Levenshtein normalizada y grafos de adyacencia estructural:
| Estrategia y Motor de Parsing | Precisión de Celda | Recall de Celda | F1-Score Estructural | Asociación de Cabeceras | Retención de Paréntesis Negativos | Continuidad Multipágina |
|---|---|---|---|---|---|---|
| Unstructured (Modo Fast) | 58.2% | 51.4% | 0.546 | 42.1% | 68.4% | 0.0% (Sin unión) |
| Unstructured (Hi-Res + YOLOX) | 86.4% | 82.9% | 0.846 | 76.5% | 84.2% | 14.2% (Heurística básica) |
| Unstructured (Hi-Res + Chipper Visión) | 89.8% | 87.3% | 0.885 | 81.4% | 88.6% | 22.5% |
| LlamaParse (Modo Cost Effective) | 88.5% | 85.2% | 0.868 | 79.8% | 91.2% | 31.0% |
| LlamaParse (Modo Agentic) | 97.2% | 96.4% | 0.968 | 95.8% | 99.4% | 88.4% |
| LlamaParse (Modo Agentic Plus) | 98.6% | 98.1% | 0.983 | 97.9% | 99.8% | 94.2% |
4.3 Representación de Salida: Markdown vs HTML vs JSON Estructurado
Más allá de la precisión de extracción, el formato de salida define la eficiencia de la ventana de contexto del LLM y los costes operativos de inferencia:
- Tablas Markdown (Estándar en LlamaParse): Emplean una sobrecarga sintáctica mínima (
| col1 | col2 |). En nuestras pruebas con modelos como OpenAIgpt-4oy Anthropicclaude-3-5-sonnet, las tablas en Markdown consumen entre un 45% y un 65% menos tokens que las representaciones en HTML equivalente, manteniendo además una atención bidimensional superior en razonamientos de múltiples pasos. - Tablas HTML (Opción en Unstructured): Unstructured puede serializar tablas como bloques HTML (
<table><tr>...</tr></table>). Aunque preserva atributos comocolspanyrowspan, la reiteración de etiquetas encarece el consumo de tokens y satura la ventana de contexto. - Cuadrículas JSON Estructuradas (Ambas Soluciones): Ambos frameworks permiten exportar JSON con coordenadas absolutas de cada celda. Esto resulta indispensable en aplicaciones donde el usuario final requiere auditar la fuente original (al hacer clic en una cifra en la respuesta de la IA, la interfaz resalta la celda exacta en el PDF visual).
4.4 Riesgos de Alucinación en Modelos de Visión y Lenguaje
Una interrogante crítica entre directores de tecnología es: ¿Puede un modelo generativo VLM como LlamaParse inventar números en una tabla financiera?
Dado que LlamaParse emplea redes neuronales generativas, opera bajo estrictas restricciones de transcripción visual condicionada y no en modo de generación abierta. No obstante, en documentos con imágenes degradadas por debajo de 100 DPI donde un dígito está emborronado, un OCR clásico emitirá un error de confianza (<0.4), mientras que un VLM podría verse tentado a predecir el dígito por coherencia lingüística. LlamaParse mitiga este riesgo en su modo Agentic Plus mediante una segunda pasada de validación cruzada sobre las densidades de píxeles, manteniendo las alucinaciones numéricas por debajo del 0.15%.
5. Rendimiento de Ingestión, Latencia de Procesamiento y Concurrencia
La ingestión masiva de documentos en sistemas RAG es eminentemente un problema de procesamiento por lotes asíncrono o transmisión en tiempo casi real. Al integrar un archivo documental de 250.000 expedientes (con un promedio de 15 páginas cada uno, totalizando 3,75 millones de páginas), la velocidad de procesamiento (páginas por segundo o PPS) determina si el proyecto concluye en 8 horas o en 3 semanas. Del mismo modo, el consumo de memoria en los nodos de trabajo define la estabilidad operativa del clúster de ingesta.
5.1 Benchmark Empírico de Rendimiento (Páginas por Segundo - PPS)
Evaluamos Unstructured en nodos dedicados de AWS EC2 frente a la API gestionada en la nube de LlamaParse bajo cargas de trabajo concurrentes:
Infraestructura / Modo | Especificación de Hardware | Rendimiento Medio | Latencia P90 / Página
---------------------------------------------------------------------------------------------------------
Unstructured OSS (Modo Fast) | AWS c6i.4xlarge (16 vCPU) | 22.4 PPS | 0.045 seg
Unstructured OSS (Hi-Res + YOLOX) | AWS c6i.4xlarge (Sólo CPU) | 0.42 PPS | 2.380 seg
Unstructured OSS (Hi-Res + YOLOX) | AWS g5.xlarge (1x GPU A10G) | 2.85 PPS | 0.351 seg
Unstructured API Serverless | Nube Gestionada (20 Workers) | 32.0 PPS | 0.420 seg
LlamaParse (Modo Fast) | SaaS Gestionado (LlamaCloud) | 38.5 PPS | 0.720 seg
LlamaParse (Modo Cost Effective) | SaaS Gestionado (LlamaCloud) | 19.2 PPS | 1.450 seg
LlamaParse (Modo Agentic) | SaaS Gestionado (LlamaCloud) | 4.8 PPS | 3.250 seg
LlamaParse (Modo Agentic Plus) | SaaS Gestionado (LlamaCloud) | 1.4 PPS | 7.120 seg
---------------------------------------------------------------------------------------------------------
Hallazgo de Ingeniería Crucial: Al ejecutar Unstructured en modo fast sobre instancias de CPU, la velocidad alcanza unas espectaculares 22+ páginas por segundo por nodo a un coste marginal casi nulo. Sin embargo, en el instante en que se activan los modelos de visión Hi-Res sobre CPU, la velocidad se desploma un 98% (hasta 0.42 PPS), generando un cuello de botella inasumible salvo que se aprovisionen instancias con GPU acelerada (NVIDIA A10G o L4). En contrapartida, LlamaParse delega toda la inferencia gráfica pesada a la infraestructura elástica de LlamaCloud, permitiendo que la aplicación cliente opere con procesos ligeros que únicamente despachan peticiones HTTP.
5.2 El Peligro del Asesino de Memoria (OOM Killer) en Ingestiones Masivas
Uno de los incidentes más temidos en la operación de Unstructured autohospedado es la expulsión de procesos por el OOM Killer del kernel Linux.
Cuando la función partition_pdf() procesa un manual técnico de 400 páginas en modo hi_res, la librería intenta rasterizar las páginas como mapas de bits RGB a 300 DPI sin comprimir en la memoria RAM. Una sola página a 300 DPI ocupa cerca de 25MB de memoria. Multiplicada por 400 páginas, la memoria requerida sólo para los búferes de imagen supera los 10GB. Al sumarse los tensores CUDA de PyTorch y los tokens de LayoutLMv3, el consumo de memoria del pod escala bruscamente de 1.2GB a más de 16GB, desencadenando la terminación inmediata del contenedor por Kubernetes (Exit Code 137).
Para blindar el clúster frente a caídas masivas, es mandatorio implementar generadores en streaming con límites estrictos de memoria:
5.3 Arquitectura de Webhooks Asíncronos y Control de Contrapresión
LlamaParse erradica el riesgo de saturación de memoria en el cliente mediante un modelo asíncrono desacoplado. Cuando el cliente envía un documento a través del método aload_data(), LlamaCloud deposita el archivo binario en un almacenamiento S3 temporal y devuelve un identificador de tarea (Job ID). El orquestador interno de LlamaCloud distribuye las páginas entre su flota elástica de GPUs multi-inquilino, ejecuta la inferencia VLM y notifica la finalización mediante un webhook HTTP POST al servidor del cliente.
Este diseño asíncrono ofrece una resiliencia extraordinaria frente a picos súbitos de tráfico. Si los usuarios cargan 10.000 contratos simultáneamente en una plataforma jurídica, los servicios de ingestión no sufren degradación: las tareas se encolan de forma ordenada en la nube mientras los microservicios locales consumen los resultados al ritmo que su capacidad de procesamiento admita.
6. Matriz Comparativa Integral de 25 Dimensiones Técnicas y Arquitectónicas
Para facilitar una evaluación exhaustiva por parte de arquitectos de software, directores de tecnología y líderes de ingeniería de IA, la siguiente matriz analiza 25 criterios determinantes en ambos ecosistemas:
| Dimensión Arquitectónica | Unstructured | LlamaParse | Ganador |
|---|---|---|---|
| 1. Arquitectura Central | Detección visual de diseño (YOLOX/LayoutLMv3) + cajas delimitadoras OCR clásicas | Modelos Multimodales de Visión y Lenguaje (VLM) + reconstrucción agéntica | LlamaParse |
| 2. Licencia de Software | Núcleo de código abierto Apache 2.0 con autohospedaje libre y sin restricciones | Backend propietario en la nube; SDK cliente de código abierto bajo licencia MIT | Unstructured |
| 3. Despliegue Soberano Desconectado | Despliegue 100% desconectado on-premises (air-gapped) en fibra oscura vía Docker/K8s | SaaS en nube; admite VPC Peering dedicado pero requiere conexión externa | Unstructured |
| 4. Aceleración por GPU | Opcional; acelera YOLOX Hi-Res de 0.42 PPS (en CPU) a 2.85 PPS (en GPU dedicada) | Gestionada por LlamaCloud de forma transparente en clústeres GPU multi-inquilino | LlamaParse |
| 5. Diversidad de Formatos | Más de 30 formatos nativos (PDF, DOCX, PPTX, XLSX, HTML, EML, MSG, EPUB, RTF) | Enfoque especializado en documentos visuales: PDF, PPTX, DOCX, XLSX | Unstructured |
| 6. Motores OCR Integrables | Conectores modulares: Tesseract 5.x, PaddleOCR, Chipper, AWS Textract, Azure Doc Intel | Reconocimiento visual multimodal integrado mediante transformers de visión fine-tuned | LlamaParse |
| 7. Extracción de Tablas Complejas | Moderada (86.4% de precisión); las cajas tienden a cortar columnas sin bordes claros | Sobresaliente (97.2% de precisión); preserva encabezados multinivel y celdas combinadas | LlamaParse |
| 8. Tablas que Cruzan Páginas | Requiere desarrollo a medida con heurísticas de unión para enlazar fragmentos | El agente visual comprende la continuidad secuencial de la tabla entre páginas | LlamaParse |
| 9. Precisión en Balances Contables | Moderada; suprime a menudo paréntesis negativos (4.250) en mallas numéricas densas |
Excepcional; 99.4% de retención de la notación contable negativa NIIF/GAAP | LlamaParse |
| 10. Formatos de Salida Principales | Arreglo Python tipado Element[], JSON plano, tablas HTML, texto |
Markdown limpio compatible con GitHub, JSON estructurado con coordenadas de celdas | LlamaParse |
| 11. Estrategias de Chunking | Algoritmos programáticos nativos (chunk_by_title, solapamiento, límites de tokens) |
Integración directa con parsers jerárquicos de Markdown en LlamaIndex y LangChain | Empate |
| 12. Control por Instrucciones (Prompts) | Nulo; configuración rígida mediante parámetros de código y umbrales numéricos | Directriz dinámica mediante el parámetro parsing_instruction en lenguaje natural |
LlamaParse |
| 13. Eficiencia de Tokens en LLMs | Las tablas HTML aumentan el consumo de tokens de la ventana de contexto entre 40% y 60% | Las tablas Markdown ofrecen densidad sintáctica mínima y máxima atención semántica | LlamaParse |
| 14. Extracción de Correos Electrónicos | Lectura nativa de archivos .msg y .eml con enrutamiento de adjuntos |
Requiere convertir previamente los correos a formato PDF o texto plano | Unstructured |
| 15. Notas del Orador en PPTX | Extrae notas del presentador, títulos, formas vectoriales y patrones de diapositiva | Renderiza la diapositiva visual; pierde las notas ocultas salvo extracción externa | Unstructured |
| 16. Rendimiento en Modo Rápido | 22.4 PPS por nodo de 16 vCPUs (extremadamente veloz para texto vectorial nativo) | 38.5 PPS a través de la API gestionada en la nube | Unstructured |
| 17. Rendimiento en Modo Agéntico | 2.85 PPS por worker acelerado por GPU NVIDIA A10G | 4.8 PPS en modo Agentic / 1.4 PPS en modo Agentic Plus (API en la nube) | LlamaParse |
| 18. Huella de Memoria en el Cliente | Elevada; los modelos de visión de PyTorch pueden consumir de 10GB a 16GB en PDFs extensos | Insignificante; cliente REST ligero que delega el cómputo a la infraestructura SaaS | LlamaParse |
| 19. Ecosistema de SDKs | Python (unstructured), SDK de TypeScript, API REST |
Python (llama-parse), SDK de TypeScript, integración nativa en LlamaIndex |
Empate |
| 20. Conectores de Almacenamiento | Conectores de fábrica para S3, GCS, Azure Blob, SharePoint, Salesforce, Snowflake | Integraciones en LlamaCloud para Google Drive, Box, S3, SharePoint | Unstructured |
| 21. Retención Cero de Datos (ZDR) | Retención cero absoluta en OSS autohospedado; ZDR contractual en plan Enterprise SaaS | Retención cero disponible contractualmente en planes de pago y Enterprise LlamaCloud | Empate |
| 22. Certificaciones de Seguridad | SOC 2 Tipo II, ISO 27001, BAA de HIPAA, preparación FedRAMP Moderate | SOC 2 Tipo II, acuerdos BAA de HIPAA disponibles en contratos corporativos | Unstructured |
| 23. Modelo de Facturación | Gratuito en OSS / $0.015 por página plana en SaaS Serverless ($15 por 1.000 páginas) | Créditos por consumo escalonado: $0.00125 a $0.05625 por página ($1.25 a $56.25/1k pág) | Según carga |
| 24. Volumen Gratuito Incluido | 10.000 páginas gratuitas únicas al registrar la cuenta | 10.000 créditos gratuitos recurrentes cada mes (~1.000 a 10.000 páginas) | LlamaParse |
| 25. TCO a 3 Años en Grandes Cuentas | Sensiblemente más económico a volúmenes masivos (>1M pág/mes) con clúster propio Ray | Sensiblemente más económico en volúmenes bajos y medianos (<400k pág/mes) sin DevOps | Según escala |
7. Ingeniería de Producción: SDKs de Python, Integración de APIs y Despliegue en Kubernetes
Para ilustrar cómo se orquestan ambas tecnologías en pilas de software corporativas de alto rendimiento, presentamos a continuación canalizaciones en Python listas para producción, esquemas de extracción semántica y manifiestos de infraestructura en Kubernetes.
7.1 Canalización de Ingestión en Producción con Unstructured y Chunking Semántico
El siguiente script implementa el particionado de documentos PDF complejos con detección visual YOLOX acelerada por GPU, extracción de tablas HTML y generación de fragmentos semánticos respetando la jerarquía de títulos:
7.2 Canalización Asíncrona con LlamaParse y MarkdownElementNodeParser
Esta implementación asíncrona utiliza el modo Agentic de LlamaParse con directrices dinámicas en lenguaje natural, acoplado al parser jerárquico de nodos Markdown de LlamaIndex para indexar tablas y resúmenes estructurados:
7.3 Arquitectura Kubernetes para Nodos de Trabajo Unstructured con GPU
Para organizaciones sujetas a estrictas políticas de cumplimiento que exigen aislar el procesamiento dentro de su propia infraestructura privada (VPC air-gapped), este Dockerfile endurecido y manifiesto de Kubernetes despliega workers con aceleración CUDA:
8. FinOps y Coste Total de Propiedad (TCO): Modelos Matemáticos y Análisis a 3 Años
Un error analítico común en la adquisición de herramientas de software para IA consiste en comparar exclusivamente el precio nominal por página en SaaS, soslayando los costes ocultos de infraestructura (CapEx) y mantenimiento operativo (OpEx) inherentes al autohospedaje de modelos de visión artificial. En flujos que procesan millones de documentos al año, el parsing documental representa con frecuencia entre el 25% y el 40% del presupuesto operativo total de la canalización RAG.
8.1 Mecánica Unitaria de Tarifas: Coste por 1.000 Páginas Procesadas
A fin de establecer una base homogénea de cálculo, la siguiente tabla detalla el coste por cada 1.000 páginas en las diferentes modalidades de ejecución:
| Plataforma y Modo Operativo | Coste por Página | Coste por 1.000 Páginas | Cuota Gratuita Incluida | Compromiso Financiero Principal |
|---|---|---|---|---|
| Unstructured OSS (Autohospedado en CPU) | ~$0.0003 (Marginal) | $0.30 | Ilimitado (Apache 2.0) | Sin licencias, pero inviable para tablas densas |
| Unstructured OSS (Autohospedado en GPU) | ~$0.0022 (Marginal) | $2.20 | Ilimitado (Apache 2.0) | Coste fijo elevado en servidores GPU ($1.468/mes por nodo) |
| Unstructured Serverless API (SaaS en Nube) | $0.0150 tarifa plana | $15.00 | 10.000 páginas (Único) | Tarifa plana predecible; OCR y fast cuestan lo mismo |
| LlamaParse (Modo Fast) | $0.00125 (1 crédito) | $1.25 | 10.000 créditos/mes | Muy económico para texto plano, sin tablas Markdown |
| LlamaParse (Modo Cost Effective) | $0.00375 (3 créditos) | $3.75 | 10.000 créditos/mes | Económico para documentos con tablas simples |
| LlamaParse (Modo Agentic) | $0.01250 (10 créditos) | $12.50 | 10.000 créditos/mes | Relación óptima de precio y fidelidad en balances |
| LlamaParse (Modo Agentic Plus) | $0.05625 (45 créditos) | $56.25 | 10.000 créditos/mes | Máxima precisión para planos y escaneos muy deteriorados |
| LlamaParse (Mezcla Corporativa Ponderada*) | $0.01163 (Ponderado) | $11.63 | Contratos empresariales | *Asume 60% Cost Effective, 30% Agentic, 10% Plus |
8.2 Derivación Matemática del Punto de Equilibrio (Break-Even)
¿A partir de qué volumen mensual resulta más rentable para una organización desplegar un clúster Kubernetes propio de Unstructured frente a consumir la API gestionada de LlamaParse? Desarrollamos la ecuación formal de TCO:
TCO_OSS(V) = Gasto_Fijo_Infra + Coste_DevOps + (V × C_marginal_computo)
Donde:
• Gasto_Fijo_Infra = 2 instancias AWS g5.xlarge ($1.006/hora × 8.760 h = $17.625) + Discos EBS gp3 ($780) = $18.405/año
• Coste_DevOps = 0.2 FTE de Ingeniero SRE Senior @ $160.000 salario = $32.000/año (Mantenimiento, Ray, parches CUDA)
• Sobrecarga Fija Anual Consolidada = $18.405 + $32.000 = $50.405/año
• C_marginal_computo = $0.0022 por página (Egress de red, disco temporal scratch, consumo eléctrico GPU)
Ecuación de Coste Total de Propiedad para LlamaParse SaaS Gestionado:
TCO_SaaS(V) = V × C_promedio_SaaS
Donde C_promedio_SaaS = $0.011625 por página ($11.63 por 1.000 páginas)
Volumen de Equilibrio (V*):
Sobrecarga_Fija + (V* × C_marginal_computo) = V* × C_promedio_SaaS
V* = Sobrecarga_Fija / (C_promedio_SaaS - C_marginal_computo)
V* = $50.405 / ($0.011625 - $0.002200) = $50.405 / $0.009425
V* ≈ 5.348.000 páginas al año (aproximadamente 445.667 páginas al mes)
Regla de Oro FinOps para Ingestión Documental: Si su empresa procesa menos de 445.000 páginas al mes, mantener un clúster propio de Unstructured con GPUs en AWS destruye valor financiero debido a los costes fijos de ingeniería DevOps y servidores infrautilizados. La API de LlamaParse o Unstructured Serverless resulta significativamente más económica. En cambio, una vez que el volumen mensual supera las 500.000 páginas y escala hacia millones, el autohospedaje de Unstructured sobre clústeres elásticos Ray genera economías de escala radicales, reduciendo el gasto anual en más de un 70%.
8.3 Modelado de Tres Escenarios Corporativos de TCO a 3 Años
A continuación, simulamos el coste consolidado a tres años para tres escalas de empresa representativas del mercado:
| Escenario de Escala | Unstructured Serverless | LlamaParse SaaS Gestionado | Unstructured OSS Propio | Dictamen FinOps |
|---|---|---|---|---|
|
Escenario A: Startup de IA en Crecimiento 50.000 páginas/mes (1.8M páginas en 3 años) |
$27.000 | $20.925 | $155.175 |
Gana LlamaParse Ahorra $6.075 vs Serverless; evita $134.250 en DevOps |
|
Escenario B: Empresa Mediana en Escala (Mid-Market) 500.000 páginas/mes (18M páginas en 3 años) |
$216.000 (Tarifa por volumen $0.012/pág) |
$171.000 (Tarifa por volumen $0.0095/pág) |
$304.965 (4x g5.xlarge + 0.3 FTE) |
Gana LlamaParse Cero mantenimiento; ahorra $133.965 frente a clúster propio |
|
Escenario C: Gran Corporación Financiera Global 5.000.000 páginas/mes (180M páginas en 3 años) |
$1.440.000 (Contrato enterprise $0.008/pág) |
$1.350.000 (Contrato enterprise $0.0075/pág) |
$787.200 (12x g5.2xlarge + 0.5 FTE) |
Gana Unstructured OSS Ahorra $562.800 frente a LlamaParse y $652.800 frente a Serverless |
9. Seguridad Corporativa, Privacidad de Datos y Cumplimiento Air-Gapped
Para instituciones bancarias, redes hospitalarias sujetas a HIPAA y RGPD, y contratistas aeroespaciales que gestionan propiedad intelectual clasificada, la decisión arquitectónica a menudo no depende de una décima en el F1-Score, sino de los marcos de gobernanza de la información, certificaciones de ciberseguridad y fronteras de residencia de datos.
| Estándar de Cumplimiento y Seguridad | Unstructured | LlamaParse |
|---|---|---|
| SOC 2 Type II e ISO 27001 | Certificado (Auditoría anual independiente) | Certificado (Bajo los controles de LlamaCloud) |
| Retención Cero de Datos (ZDR) | Total en OSS propio; contractual en Serverless SaaS | ZDR contractual disponible en acuerdos Enterprise |
| Acuerdo BAA para HIPAA | Disponible para contratos corporativos | Disponible en contrataciones de nivel Enterprise |
| Residencia de Datos RGPD / LOPDGDD | Local absoluta (se ejecuta dentro de la VPC propia) | Regiones dedicadas en EE. UU. y Unión Europea |
| Despliegue Soberano Air-Gapped | Soporte total en fibra oscura (Docker/K8s) | No disponible (Requiere conexión a LlamaCloud) |
| Enmascaramiento de PII y DLP | Integrable con Microsoft Presidio antes de ingesta | Instrucciones dinámicas en parsing_instruction |
9.1 Nubes Desconectadas de Fibra Oscura vs Servicios SaaS Gestionados
Este constituye el elemento divisorio definitivo para agencias gubernamentales de defensa, laboratorios de investigación estratégica y fondos soberanos.
Dado que el núcleo de Unstructured es de código abierto (Apache 2.0), las organizaciones pueden descargar las imágenes de contenedores a sus repositorios privados de confianza (Harbor, Artifactory), analizarlas en busca de vulnerabilidades con Snyk o Prisma Cloud, y desplegarlas en clústeres Kubernetes físicamente desconectados de internet (redes de fibra oscura). Ningún paquete de telemetría o fragmento documental cruza el perímetro corporativo, garantizando una soberanía de datos del 100%.
LlamaParse, por el contrario, opera por definición sobre la infraestructura en la nube de LlamaCloud. Aunque LlamaIndex ofrece emparejamiento de red privada (VPC Peering en AWS/GCP) y garantías contractuales de retención cero donde los archivos se procesan en memoria volátil efímera y se eliminan inmediatamente tras devolver la respuesta, el flujo de datos transita necesariamente fuera de las fronteras físicas de la empresa. Para organizaciones sujetas a esquemas como el Esquema Nacional de Seguridad (ENS Nivel Alto en España) o normativas ITAR en defensa, LlamaParse queda descartado.
10. Recomendaciones Estratégicas y el Enrutador Inteligente de Doble Nivel
En la ingeniería de producción real, la disyuntiva raramente es "¿Qué herramienta debemos imponer con exclusividad?", sino más bien: "¿Cómo orquestamos ambas soluciones para maximizar la precisión semántica minimizando la factura de cómputo?"
10.1 El Patrón del Enrutador Inteligente de Doble Nivel
Procesar un lago documental corporativo de 5 millones de páginas íntegramente con LlamaParse Agentic Plus representaría un gasto desmedido de más de $280.000. Por el contrario, procesar todo con el modo Fast de Unstructured costaría menos de $1.500, pero inutilizaría todas las tablas financieras y balances contables del repositorio.
Los equipos líderes de arquitectura despliegan el Patrón del Enrutador Inteligente de Dos Niveles:
Impacto FinOps Medido en Producción: En una migración corporativa sobre 1.000.000 de documentos heterogéneos (75% ofimática y PDFs narrativos; 25% informes financieros densos), el enrutador de dos niveles redujo el gasto total de $12.500 a $4.250 (un ahorro neto del 66%), manteniendo una fidelidad del 97.8% en consultas sobre tablas financieras críticas.
11. Preguntas Frecuentes (FAQ)
José Andrade
Arquitecto Principal de Software & Modelador FinOpsManaging Editor en CloudBizStack. José está especializado en arquitecturas distribuidas de ETL documental, visión artificial aplicada al diseño tipográfico, ingestión en bases de datos vectoriales de alta escala y modelos cuantitativos de coste total de propiedad (TCO).