vCluster vs Namespaces: Multi-Tenancy en Kubernetes (2026)
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
Kubernetes se ha consolidado definitivamente como el estándar indiscutible para la orquestación de aplicaciones en la nube empresarial. Sin embargo, para los equipos de ingeniería de plataformas, arquitectos de infraestructura y líderes de FinOps, el multi-tenancy (aislamiento multi-inquilino) continúa siendo la principal fuente de fricción técnica y sobrecostes financieros. Tradicionalmente, las organizaciones se han visto atrapadas entre dos extremos arquitectónicamente deficientes: la proliferación incontrolada de clústeres (aprovisionar cientos de clústeres gestionados independientes en Amazon EKS, Google GKE o Azure AKS, generando un gasto desorbitado en tarifas fijas de control plane y una grave fragmentación de recursos) y la sobreconsolidación monolítica mediante namespaces (ubicar a decenas de escuadras autónomas dentro de un único clúster compartido utilizando namespaces nativos).
Aunque los namespaces estándar de Kubernetes proporcionan una frontera lógica para nombres de recursos, control de accesos básico (RBAC) y limitación de cuotas (ResourceQuotas), carecen por completo de la capacidad para aislar el plano de control (control plane). En un clúster compartido con namespaces, todos los inquilinos dependen de un registro global único de Definiciones de Recursos Personalizados (CRDs), una cadena compartida de webhooks de admisión mutables y validables, una única cola de peticiones en el kube-apiserver y una base de datos centralizada etcd. Una actualización de esquema en un CRD realizada por un equipo puede quebrar de inmediato los controladores de otros departamentos. Un webhook de admisión mal configurado con failurePolicy: Fail es capaz de congelar la creación de pods en toda la corporación. Y lo que resulta más restrictivo: los equipos de plataforma no pueden delegar autonomía real, pues instalar charts de Helm con componentes globales (como Cert-Manager, Istio, ArgoCD o Prometheus) exige privilegios de cluster-admin, comprometiendo la postura de seguridad de la infraestructura.
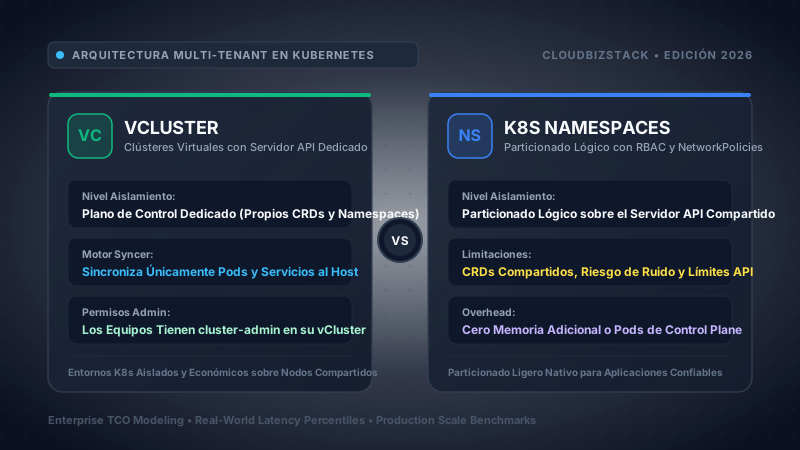
Loft Labs vCluster supera definitivamente este dilema histórico. Al instanciar un plano de control de Kubernetes virtual, ultra-ligero y dedicado (basado en k3s, k8s puro o k0s con almacenamiento SQLite o etcd embebido) como un pod no privilegiado dentro de un namespace anfitrión, vCluster materializa la virtualización completa del plano de control. Los inquilinos obtienen privilegios totales de cluster-admin en su servidor API virtual privado. Pueden crear sus propios sub-namespaces internos, establecer políticas de RBAC a medida e instalar CRDs y operadores sin interferir con inquilinos vecinos ni alterar el clúster anfitrión. Al mismo tiempo, el motor de sincronización inteligente vCluster Syncer proyecta exclusivamente las unidades de ejecución de bajo nivel (Pods, PVCs, Services) hacia los nodos de trabajo físicos compartidos, permitiendo una densificación de nodos masiva y reduciendo el gasto de infraestructura entre un 50% y un 75%.
● vCluster: El Estándar de Control Plane Virtual
Ofrece servidores API virtuales totalmente desacoplados y motores de almacenamiento SQLite/etcd independientes ejecutándose sobre nodos físicos compartidos. Facilita la delegación de cluster-admin, aislamiento estricto de CRDs, webhooks privados y creación de sub-namespaces. Incorpora modo de reposo automático (auto-pause) para suprimir costes ociosos en entornos no productivos.
● Namespaces Nativos: La Frontera Lógica Tradicional
Mecanismo de particionado lógico estándar integrado en el núcleo de Kubernetes. Depende en su totalidad de un plano de control compartido, espacio global de CRDs y RBAC centralizado. No genera sobrecarga adicional en memoria ni CPU para el control plane, pero introduce cuellos de botella operativos y colisiones inevitables al escalar operadores.
Matriz de Decisión Estratégica:
- Adoptar vCluster cuando: Los desarrolladores demanden privilegios de
cluster-adminpara evaluar charts de Helm o desplegar operadores; existan requerimientos incompatibles de CRDs globales (ej. Cert-Manager, Istio, Prometheus Operator); se requieran entornos de previsualización dinámicos en CI/CD; se busque consolidar decenas de clústeres EKS/GKE de desarrollo en un clúster anfitrión compartido para eliminar tarifas fijas; o se requiera auto-pause para apagar cargas en noches y fines de semana. - Mantener Namespaces Tradicionales cuando: La infraestructura aloje microservicios homogéneos gestionados por un pipeline centralizado de GitOps (ArgoCD/Flux) donde ningún desarrollador tiene acceso directo vía
kubectl; no se requieran CRDs propios ni sub-namespaces; se requiera una latencia de programación de pods sin ningún intermediario; o las políticas corporativas impongan clústeres físicamente aislados por normativa regulatoria.
2. Arquitectura Detallada: Plano de Control Virtual vs Monolito Compartido
Para comprender las diferencias operativas profundas entre vCluster y los namespaces estándar de Kubernetes, es indispensable analizar la capa de abstracción de la API y cómo interactúan los componentes del plano de control con el kernel de Linux, el runtime de contenedores (containerd/CRI-O) y el almacenamiento distribuido.
Anatomía de Loft Labs vCluster: Desacoplando el Control de la Ejecución
Un vCluster no es una simulación en espacio de usuario ni una capa decorativa sobre el RBAC de Kubernetes. Un vCluster es un clúster de Kubernetes completo y certificado que opera dentro de un pod (o un conjunto de pods en configuraciones de Alta Disponibilidad) en un namespace del clúster anfitrión. El sistema consta de tres elementos fundamentales:
+---------------------------------------------------------------------------------------------------+
|                                  CLÚSTER VIRTUAL (ESPACIO DEL INQUILINO)                          |
|  kubectl / Helm / ArgoCD  -->  [ kube-apiserver Virtual ] <---> [ Datastore Privado (SQLite/etcd) ]|
|                                       |                                                           |
|             +-------------------------+-------------------------+                                 |
|             |                         |                         |                                 |
|      [ CoreDNS Virtual ]       [ CRDs y Webhooks Propios ]  [ Sub-Namespaces ]                    |
|             |                         |                         |                                 |
|             +-------------------------+-------------------------+                                 |
|                                       |                                                           |
|                            [ Motor vCluster Syncer ]                                              |
+---------------------------------------|-----------------------------------------------------------+
                                        | (Bucle de sincronización bidireccional selectiva)
+---------------------------------------v-----------------------------------------------------------+
|                                    CLÚSTER ANFITRIÓN (HARDWARE COMPARTIDO)                        |
|                                [ kube-apiserver Anfitrión ]                                       |
|                                       |                                                           |
|                        +--------------+--------------+                                            |
|                        |                             |                                            |
|             [ Host Kube-Scheduler ]          [ Registro etcd Central ]                            |
|                        |                                                                          |
|       +----------------+----------------+                                                         |
|       |                                 |                                                         |
|  [ Nodo de Trabajo 1: Kubelet ]   [ Nodo de Trabajo 2: Kubelet ]                                  |
|  - Pod: app-pod-x-backend-x-vc1   - Pod: app-pod-x-frontend-x-vc1                                 |
|  - Runtime containerd compartido  - Runtime containerd compartido                                 |
+---------------------------------------------------------------------------------------------------+
1. El Servidor API y Almacén Virtual: De forma predeterminada, vCluster utiliza una versión aligerada y endurecida de Kubernetes upstream —habitualmente k3s— que integra el kube-apiserver, el kube-controller-manager y una base de datos transaccional SQLite en un único binario optimizado en Go. También permite desplegar Kubernetes upstream puro (k8s) con etcd dedicado o k0s. Dado que el almacenamiento reside en un volumen persistente dentro del namespace anfitrión, todos los objetos virtuales —como Namespaces, ServiceAccounts, Roles, RoleBindings, CRDs, Custom Resources y ConfigMaps— se confirman en esta base de datos local. El etcd del clúster anfitrión nunca procesa ni almacena estos recursos.
2. El Motor de Sincronización (vCluster Syncer): El componente central de vCluster es el syncer. Desarrollado en Go sobre las librerías client-go e informers de Kubernetes, opera como un bucle de conciliación bidireccional continuo. El syncer no replica todos los objetos; discrimina rigurosamente y proyecta hacia el anfitrión únicamente los recursos indispensables para la ejecución física y la conectividad de red:
- Sincronizados al Anfitrión: Pods, PersistentVolumeClaims (PVCs), Services, Endpoints y opcionalmente Ingresses o Secrets.
- Mantenidos Exclusivamente en el Entorno Virtual: Namespaces, CustomResourceDefinitions (CRDs), Custom Resources, ClusterRoles, ClusterRoleBindings, ServiceAccounts, PersistentVolumes (PVs), StorageClasses, PriorityClasses, MutatingWebhookConfigurations y ValidatingWebhookConfigurations.
3. Ofuscación de Nombres (Name Mangling) y Mapeo: Cuando un ingeniero dentro de un vCluster llamado equipo-finanzas crea un pod denominado pagos-api dentro de un namespace virtual llamado staging, el syncer intercepta el Pod virtual. Reescribe los metadatos y crea el pod en el clúster anfitrión dentro del namespace vcluster-equipo-finanzas bajo un nombre ofuscado:
Este esquema de nombrado garantiza que incluso si múltiples clústeres virtuales ejecutan pods con idéntico nombre en namespaces virtuales coincidentes, no exista riesgo alguno de conflicto en el clúster anfitrión. El planificador (kube-scheduler) y el agente (kubelet) del anfitrión programan y ejecutan el pod directamente en los nodos físicos, mientras que el syncer traslada los estados, streams de logs y túneles de port-forward al servidor API virtual en tiempo real.
Arquitectura de los Namespaces Tradicionales: La Rigidez del Monolito
En contraste radical, un namespace nativo de Kubernetes no constituye una celda de aislamiento de procesos ni un entorno virtualizado. Se trata simplemente de un prefijo lógico verificado a nivel de software por el único kube-apiserver central. Al ejecutar kubectl create namespace inquilino-a, la API registra un objeto de metadatos. Cada recurso posterior creado en ese espacio se guarda en el etcd central bajo una ruta jerárquica:
Debido a esta estructura compartida monolítica:
- Cola Única de API y Límites Globales: Todas las peticiones de todos los desarrolladores, pipelines de CI/CD, agentes de monitorización y controladores convergen en los mismos procesos
kube-apiserver. - Espacio Global de CRDs: Las CustomResourceDefinitions no admiten alcance por namespace. Se registran a nivel de clúster en
/registry/customresourcedefinitions, existiendo una única versión de esquema por grupo de API en todo el clúster. - Controladores de Admisión Globales: Los webhooks de validación y mutación operan a nivel de clúster, evaluando cada creación de pod en toda la plataforma.
- Jerarquía RBAC Plana: Los recursos clasificados como globales por la API de Kubernetes (Nodes, PersistentVolumes, StorageClasses, Namespaces, ClusterRoles) eluden por completo el particionado de los namespaces.
3. Aislamiento del Plano de Control, Conflictos de CRDs y Ecosistema de Operadores
Las restricciones intrínsecas de los namespaces tradicionales emergen con crudeza cuando las empresas sobrepasan la docena de microservicios e integran operadores complejos en Kubernetes. La maquinaria de la API impone una regla absoluta: las CustomResourceDefinitions (CRDs) tienen alcance global de clúster.
El Bloqueo por Colisión de Versiones de CRD en la Empresa
Examinemos un caso frecuente en una entidad corporativa que opera un clúster EKS compartido con 40 equipos de desarrollo organizados en namespaces estándar:
- El Equipo de Pasarela de Pagos gestiona un servicio crítico bajo certificación PCI-DSS que depende de
cert-manager.io/v1alpha2y Cert-Manager v1.5. Adaptar sus manifiestos exige meses de validación y re-certificación formal. - El Equipo de Inteligencia Artificial necesita desplegar gateways modernos con Kubernetes Gateway API y Cert-Manager v1.16+ para validar dominios de forma dinámica mediante retos HTTP-01 de Let's Encrypt.
En una arquitectura de namespaces compartidos, esta situación supone un bloqueo técnico insalvable. Al ser globales los CRDs, el equipo de plataforma no puede instalar Cert-Manager v1.16 sin modificar los esquemas del clúster entero. Si los nuevos esquemas deprecian campos requeridos por la versión antigua, los certificados de pagos dejan de renovarse, provocando una caída catastrófica. La empresa se ve obligada a congelar la innovación de IA o a asumir un coste adicional de $50,000 USD al año creando un clúster EKS separado.
Con vCluster, este conflicto desaparece por completo. El equipo de Pagos ejecuta su controlador Cert-Manager dentro de su vCluster privado, registrando los CRDs antiguos contra su servidor API virtual. El equipo de IA instala Cert-Manager v1.16 en su propio vCluster, registrando las definiciones modernas en su plano virtual. Ambos vClusters ejecutan sus pods sobre los mismos nodos físicos del clúster anfitrión, compartiendo cómputo y memoria con un aislamiento absoluto a nivel de control plane.
Cascadas de Fallo en Webhooks de Admisión y Amplificación del Radio de Explosión
Otro vector de riesgo severo en clústeres monolíticos compartidos reside en las configuraciones MutatingWebhookConfigurations y ValidatingWebhookConfigurations. Los webhooks de admisión interceptan cada llamada a la API antes de su persistencia en etcd.
El Agujero Negro Operativo de los Webhooks de Admisión
En un clúster compartido, si un ingeniero o un chart de Helm despliega un webhook de admisión (como una política restrictiva de Kyverno, un constraint de OPA Gatekeeper o un inyector de sidecars de Vault) con failurePolicy: Fail sin un namespaceSelector sumamente estricto, el webhook se convierte en un punto único de fallo global. Si el pod del webhook se satura de memoria (OOMKilled) o supera el timeout de 10 segundos, cualquier intento de crear un pod en cualquier namespace del clúster será rechazado con un error HTTP 500. El autoescalado se detiene, los microservices en reinicio fallan y los pipelines de despliegue se bloquean por completo.
En vCluster, los webhooks de admisión del inquilino se configuran exclusivamente en su servidor API virtual. Si un desarrollador introduce un webhook defectuoso, la afectación se circunscribe a su clúster virtual. El clúster anfitrión jamás invoca dicho webhook, garantizando que un fallo humano en un entorno de desarrollo no pueda propagarse jamás a otras áreas de la organización.
4. RBAC, Delegación de Cluster-Admin y Experiencia de Autoservicio
El objetivo principal de un equipo de ingeniería de plataformas es maximizar la velocidad del desarrollador: permitir que las escuadras de producto desplieguen, prueben e innoven sin depender de tickets manuales en Jira hacia el equipo de operaciones.
La Falacia del "Administrador de Namespace"
En Kubernetes tradicional, los administradores de plataforma intentan conceder autonomía enlazando la identidad de los desarrolladores al ClusterRole admin o edit mediante un RoleBinding limitado a un namespace específico. En teoría, esto permite al equipo gestionar Pods, Deployments y Services dentro de su entorno.
En la práctica, las aplicaciones cloud-native modernas desbordan constantemente los límites de un único namespace. Consideremos lo que sucede cuando un ingeniero intenta desplegar un chart estándar de Helm (como Apache Kafka, Istio Ambient Mesh, ArgoCD u OpenTelemetry):
- El chart requiere crear un
ClusterRolepara que su operador monitorice nodos. Resultado: Permiso Denegado. - El chart necesita registrar una
CustomResourceDefinitionpara sus esquemas. Resultado: Permiso Denegado. - El desarrollador requiere probar arquitecturas segmentadas en múltiples namespaces (ej.
frontend,backend,data). Un namespace no puede anidar otros namespaces. Resultado: Bloqueado. - Se requiere una clase de almacenamiento persistente personalizada (
StorageClass). Resultado: Permiso Denegado.
El desarrollador se ve forzado a solicitar asistencia abriendo un ticket. El equipo de plataforma debe inspeccionar el chart, extraer los recursos globales, aplicarlos manualmente en el clúster anfitrión y reconfigurar permisos. Este ciclo añade días de demora, destruyendo la agilidad del autoservicio.
Verdadera Delegación de Cluster-Admin Virtual
vCluster soluciona este dilema invirtiendo la relación de permisos. Cuando el equipo de plataforma entrega un vCluster a una escuadra, el equipo recibe privilegios plenos de cluster-admin dentro de su servidor API virtual:
# Dentro del vCluster (Contexto del Inquilino)
$ kubectl auth can-i '*' '*' --all-namespaces
yes

$ kubectl create namespace frontend
namespace/frontend created

$ kubectl create namespace backend
namespace/backend created

$ helm install kafka oci://registry-1.docker.io/bitnamicharts/kafka
Release "kafka" has been installed. Happy Helming!
Los desarrolladores pueden crear sub-namespaces, definir CRDs y ejecutar operadores libremente. Sin embargo, en el clúster anfitrión, todo el vCluster se ejecuta como una carga de trabajo no privilegiada confinada estrictamente a un único namespace con cuotas y políticas de seguridad controladas centralmente:
# En el Clúster Anfitrión (Contexto de Plataforma)
$ kubectl get pods -n vcluster-equipo-finanzas
NAME                                                    READY   STATUS    RESTARTS   AGE
vcluster-equipo-finanzas-0                              1/1     Running   0          4d
kafka-controller-0-x-backend-x-vcluster-equipo-finanzas 1/1     Running   0          5m
frontend-web-7d9f-x-frontend-x-vcluster-equipo-finanzas 1/1     Running   0          5m
Esta frontera arquitectónica hace realidad el equilibrio perfecto: autonomía total para el desarrollador en el plano virtual y gobernanza corporativa inquebrantable en el plano físico.
5. Radio de Explosión, Seguridad y Protección contra Vecinos Ruidosos
El diseño de plataformas multi-inquilino exige sopesar la autonomía frente a los riesgos operativos. Al contrastar vCluster frente a namespaces tradicionales, es imprescindible evaluar la saturación del API server, la segmentación de red y la seguridad a nivel de kernel de Linux.
Saturación del API Server y Políticas de Prioridad (APF)
Uno de los problemas más complejos en clústeres monolíticos compartidos es la contención en el servidor API. Los microservicios modernos y los motores de GitOps consultan la API de Kubernetes de manera constante. En un entorno compartido con 50 equipos:
- Si un equipo ejecuta un script de CI/CD ineficiente o un controlador que realiza bucles continuos de
LIST /api/v1/pods --watchsin caché, consume cientos de ranuras de concurrencia en la API central. - A pesar del sistema API Priority and Fairness (APF), las colas internas del
kube-apiserverse saturan cuando se superan los límites de peticiones concurrentes (--max-requests-inflight). - El servidor comienza a descartar tráfico respondiendo con errores HTTP 429 Too Many Requests a otros inquilinos, a los controladores de autoescalado horizontal (HPA) e incluso a los heartbeats de los nodos. ¡Los nodos físicos pueden pasar a estado
NotReadyal no poder renovar sus leases!
Con vCluster, las consultas de los inquilinos jamás llegan al servidor API del anfitrión. Las peticiones de desarrollo, despliegues de Helm y sondeos de controladores terminan en el servidor API virtual privado (k3s/k8s). El servidor API anfitrión recibe únicamente los eventos consolidados y filtrados que emite el proceso vcluster-syncer. Aunque un inquilino ejecute un script lesivo que agote su API virtual, la afectación queda totalmente contenida en su entorno, manteniendo el clúster anfitrión y los demás vClusters en óptimo funcionamiento.
La Realidad del Kernel Compartido: Multi-Tenancy Blando vs Estricto
Es fundamental desmitificar un concepto erróneo recurrente: ni vCluster ni los namespaces estándar proporcionan aislamiento a nivel de hipervisor o hardware por sí mismos.
Dado que vCluster proyecta la ejecución de los pods hacia los nodos anfitriones, dichos contenedores comparten el mismo kernel de Linux, los namespaces tradicionales del sistema operativo (cgroups, pid, mount, net, ipc, uts) y el runtime containerd o CRI-O. Si un atacante ejecuta código malicioso y explota una vulnerabilidad de escape de contenedor (como CVE-2024-21626 en runc, dirty cow o corrupción de memoria en eBPF), obtendrá acceso al nodo físico anfitrión, comprometiendo a todos los demás inquilinos alojados en esa máquina.
Estrategia de Defensa en Profundidad para Multi-Tenancy Estricto
Para empresas que ejecutan código totalmente no confiable o aplicaciones SaaS para clientes externos en infraestructura compartida, el aislamiento por software debe reforzarse con barreras de hardware y kernel:
- Runtimes Aislados: Configurar vCluster para usar
gVisor(runsc), interceptando las llamadas al sistema en espacio de usuario, oKata Containerspara encapsular cada pod en una microVM mediante QEMU o Cloud-Hypervisor. - Pools de Nodos Dedicados: Aplicar Kubernetes Node Taints, Tolerations y NodeAffinity para garantizar que los vClusters de clientes o áreas críticas se ubiquen en instancias EC2/GCE físicamente independientes.
- Pod Security Standards Estrictos: Imponer el perfil
restrictedmediante Pod Security Admission en los namespaces anfitriones y virtuales, prohibiendo contenedores como root y montajes hostPath. - Políticas de Red con Cilium o Calico: Bloquear el acceso a la dirección de metadatos del proveedor cloud (
169.254.169.254) y restringir el tráfico inter-namespace por defecto.
6. Benchmarks de Consumo de Cómputo, Memoria y Latencia
Una duda habitual planteada por los arquitectos de infraestructura gira en torno a la sobrecarga: "¿Desplegar un plano de control dedicado para cada equipo consumirá demasiada memoria y penalizará el arranque de los pods?"
Para responder cuantitativamente, nuestro laboratorio ejecutó pruebas de rendimiento midiendo consumo de RAM, vCPU, latencia del bucle de sincronización y deltas de programación a lo largo de 100 clústeres virtuales concurrentes sobre Amazon EKS v1.30 con nodos m6i.4xlarge (16 vCPU, 64 GB RAM).
Perfil de Consumo de Recursos del Plano de Control
La huella de recursos de un vCluster varía según la distribución seleccionada como motor virtual:
| Arquitectura de Control Plane | RAM Ociosa (Idle) | RAM Activa (50 Pods) | vCPU Ociosa | Motor de Datos |
|---|---|---|---|---|
| vCluster (k3s Predeterminado) | 120 MB - 160 MB | 210 MB - 280 MB | 0.01 - 0.03 vCPU | SQLite Embebido |
| vCluster (Backend k0s) | 180 MB - 240 MB | 310 MB - 390 MB | 0.02 - 0.05 vCPU | SQLite / Kine |
| vCluster (k8s Upstream + etcd) | 450 MB - 650 MB | 750 MB - 1,100 MB | 0.10 - 0.25 vCPU | Pod etcd dedicado |
| Namespaces Nativos | 0 MB (Amortizado) | 0 MB (Amortizado) | 0 vCPU | etcd Central Anfitrión |
| Clúster EKS Dedicado | 2,048 MB+ (DaemonSets) | 3,500 MB+ (Pods de Sistema) | 1.5 - 2.5 vCPU | etcd Gestionado Cloud |
Los datos empíricos revelan que un vCluster con motor k3s consume apenas ~140 MB de RAM y ~0.02 vCPU en reposo. Para dimensionarlo en perspectiva: empaquetar 50 vClusters totalmente aislados en un clúster anfitrión consume ~7 GB de RAM en todo el cluster, lo que equivale a sólo el 11% de la memoria de un único nodo m6i.4xlarge.
En cambio, desplegar 50 clústeres EKS independientes genera un despilfarro mayúsculo. Cada clúster requiere un mínimo de 2 nodos de trabajo para dar soporte a los daemonsets y pods del sistema (aws-node CNI, kube-proxy, coredns, ebs-csi-node, agentes de Datadog y monitorización). Entre los 50 clústeres, los pods de sistema consumen más de 100 GB de RAM y 75 vCPU exclusivamente en tareas de soporte de infraestructura.
Latencia de Programación y Sobrecarga del Syncer
En un namespace estándar, la creación de un pod requiere dos pasos: el kube-apiserver persiste el pod en etcd y el kube-scheduler lo asigna a un nodo físico.
En vCluster, se incorpora un paso intermedio de sincronización y traducción:
Nuestro benchmark evaluó el tiempo transcurrido desde kubectl apply -f pod.yaml hasta el estado Running a lo largo de 1,000 ciclos de despliegue:
- Namespace Nativo: p50 = 1.12 segundos; p95 = 2.45 segundos; p99 = 3.80 segundos (dominado por la descarga de imágenes y el inicio del contenedor).
- vCluster (k3s syncer): p50 = 1.15 segundos; p95 = 2.51 segundos; p99 = 3.89 segundos.
- Sobrecarga Neta del Syncer: p50 = 26 milisegundos; p95 = 58 milisegundos; p99 = 94 milisegundos.
Un incremento de 26 ms en el arranque de un pod resulta completamente imperceptible para microservicios y despliegues en producción. Una vez en ejecución, los paquetes de red circulan directamente por la interfaz CNI física sin proxies intermediarios, asegurando un 0.00% de penalización en tiempo de ejecución.
7. FinOps, Eficiencia de Densificación y TCO a 3 Años
Desde la perspectiva de FinOps, la topología de despliegue de Kubernetes representa uno de los mayores determinantes de la factura cloud. Para calcular el coste total de propiedad (TCO), los analistas deben ponderar las tarifas de los planos de control gestionados, el factor de empaquetado (bin-packing) de los nodos y el desperdicio por capacidad ociosa.
Ecuación Matemática: Clústeres Físicos vs Clústeres Virtuales
El coste anual de clústeres gestionados independientes ($C_{dedicado}$) se formula como:
Donde:
N_clusters= Número de entornos aislados (ej. 50 clústeres de desarrollo y pruebas).F_control_plane= Tarifa del plano de control cloud ($0.10 USD/hora = $73 USD/mes u $876 USD/año en EKS/GKE).N_min_nodos * C_nodo= Sobrecarga de nodos mínimos de soporte (~$3,360 USD/año por clúster en instanciasm6i.large).U_dedicada= Tasa de aprovechamiento medio en clústeres aislados de desarrollo (históricamente entre un 12% y un 22%).
En contraposición, la ecuación de costes de vCluster sobre nodos compartidos ($C_{vcluster}$) comprime drásticamente las tarifas fijas y la sobrecarga:
Donde:
F_anfitrion= Tarifa única del clúster anfitrión ($876 USD/año, sin importar si aloja 10 o 300 vClusters).O_vcluster= Sobrecarga de memoria del vCluster (~140 MB por entorno virtual).U_consolidada= Eficiencia de empaquetado en nodos grandes con Karpenter (65% al 80%).S_sleep= Ahorro por reposo automático en noches y fines de semana (reducción del 60% al 70% en cómputo ocioso).
Los servicios de infraestructura cloud (AWS, Google Cloud, Azure) se facturan internacionalmente en dólares estadounidenses netos (USD). Para organizaciones ubicadas en España y América Latina, la proliferación de clústeres independientes amplifica notablemente la carga impositiva y la exposición cambiaria:
- Impuestos a Servicios Digitales Transfronterizos (IVA): Jurisdicciones como España (21% IVA), México (16% IVA digital), Chile (19% IVA) y Colombia (19%) aplican retención sobre el consumo de cloud si la empresa liquida mediante tarjeta corporativa sin un NIF/RFC empresarial exento debidamente registrado. Multiplicar clústeres dedicados incrementa linealmente la base imponible del IVA devengado.
- Retención en la Fuente por Software Transfronterizo: En países como Colombia (retención del 15% al 20% en remesas de servicios técnicos) o Argentina (esquemas de impuestos sobre divisas y percepciones PAIS/Ganancias), la contratación directa en el exterior encarece la factura final entre un 15% y un 35% respecto a los precios nominales publicados.
- Estrategia FinOps con vCluster: Consolidar 50 entornos de desarrollo dispersos en un único clúster anfitrión gobernado por vCluster no sólo reduce la factura nominal en USD de $180,000 a $41,200 en 3 años, sino que reduce proporcionalmente el impacto del IVA no deducible y el riesgo de volatilidad cambiaria (FX spreads) frente a monedas locales (MXN, COP, CLP, ARS, EUR).
Modelado del TCO a 3 Años en 3 Escenarios Corporativos
A continuación se detallan las proyecciones financieras consolidadas a 3 años comparando tres alternativas arquitectónicas:
| Nivel Empresarial | Estrategia A: EKS Dedicados | Estrategia B: Namespaces | Estrategia C: vCluster (Auto-Pause) | Ahorro Neto con vCluster |
|---|---|---|---|---|
|
Nivel 1: Scale-Up en Expansión 15 Equipos, 30 Entornos Dev/Test |
$184,500 USD | $82,000 USD | $41,200 USD | $143,300 USD (77.6% Ahorro) |
|
Nivel 2: SaaS Mid-Market 45 Equipos, 90 Entornos Dinámicos |
$558,000 USD | $210,000 USD | $108,500 USD | $449,500 USD (80.5% Ahorro) |
|
Nivel 3: Gran Corporación 120 Equipos, 250 Sandboxes CI/CD |
$1,620,000 USD | $560,000 USD | $274,000 USD | $1,346,000 USD (83.1% Ahorro) |
Aunque los Namespaces convencionales parezcan económicos en una tabla teórica ($210,000 USD en Mid-Market), esa cifra no computa el coste oculto por fricción operativa: cientos de horas invertidas en resolver incidencias de CRDs compartidos, colas de espera en Jira para desplegar charts de Helm y depuración de bloqueos por webhooks globales. vCluster maximiza la rentabilidad financiera al tiempo que ahorra más de $449,500 USD en cómputo real a lo largo de 3 años.
8. Implementación Práctica: Manifiestos de Producción y CLI
A continuación se presenta la configuración declarativa requerida para desplegar un vCluster corporativo frente al conjunto de manifiestos necesarios para blindar un namespace estándar de Kubernetes.
1. Configuración de Producción de vCluster (vcluster.yaml)
En la arquitectura actual de vCluster v0.20+, toda la especificación se define en un archivo estructurado vcluster.yaml:
# vcluster.yaml - Especificación Empresarial
controlPlane:
  distro:
    k3s:
      enabled: true
      image:
        repository: rancher/k3s
        tag: v1.30.2-k3s1
  backingStore:
    etcd:
      embedded:
        enabled: true
  statefulSet:
    resources:
      requests:
        cpu: 100m
        memory: 180Mi
      limits:
        cpu: 1000m
        memory: 512Mi

sync:
  toHost:
    pods:
      enabled: true
    services:
      enabled: true
    persistentVolumeClaims:
      enabled: true
    ingresses:
      enabled: true
    secrets:
      enabled: false  # Los secretos virtuales NO se sincronizan al anfitrión
    configMaps:
      enabled: false # Se mantienen exclusivamente en el SQLite virtual

isolation:
  enabled: true
  networkPolicy:
    enabled: true
  resourceQuota:
    enabled: true
    quota:
      requests.cpu: "8"
      requests.memory: "16Gi"
      limits.cpu: "16"
      limits.memory: "32Gi"
      count/pods: "60"

# Reposo Automático (Auto-Pause / Sleep Mode)
policies:
  autoSleep:
    afterInactivity: 30m
    exclude:
      namespaces:
        - kube-system
    schedule: "0 20 * * 1-5"  # Suspende de lunes a viernes a las 20:00
El aprovisionamiento y conexión se realizan con dos comandos en la terminal:
# Crear el clúster virtual en el namespace anfitrión 'vcluster-pagos'
vcluster create pagos-cluster -n vcluster-pagos -f vcluster.yaml

# Conectar e interactuar directamente mediante kubectl
vcluster connect pagos-cluster -n vcluster-pagos --update-current=true
2. Suite de Manifiestos para Namespaces Tradicionales
Para intentar replicar un nivel de aislamiento comparable en namespaces tradicionales, el equipo de plataforma debe mantener un conjunto complejo de manifiestos por cada equipo:
apiVersion: v1
kind: Namespace
metadata:
  name: inquilino-pagos
  labels:
    pod-security.kubernetes.io/enforce: baseline
    pod-security.kubernetes.io/audit: restricted
---
apiVersion: v1
kind: ResourceQuota
metadata:
  name: cuota-computo
  namespace: inquilino-pagos
spec:
  hard:
    requests.cpu: "8"
    requests.memory: 16Gi
    limits.cpu: "16"
    limits.memory: 32Gi
    pods: "60"
---
apiVersion: v1
kind: LimitRange
metadata:
  name: limites-por-defecto
  namespace: inquilino-pagos
spec:
  limits:
  - default:
      cpu: 500m
      memory: 512Mi
    defaultRequest:
      cpu: 100m
      memory: 128Mi
    type: Container
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: aislamiento-red
  namespace: inquilino-pagos
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
  ingress:
  - from:
    - podSelector: {}
  egress:
  - to:
    - podSelector: {}
  - to: # Resolución DNS en kube-system
    - namespaceSelector:
        matchLabels:
          kubernetes.io/metadata.name: kube-system
      podSelector:
        matchLabels:
          k8s-app: kube-dns
    ports:
    - protocol: UDP
      port: 53
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: admin-equipo-pagos
  namespace: inquilino-pagos
subjects:
- kind: Group
  name: "oidc:desarrolladores-pagos"
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: ClusterRole
  name: admin
  apiGroup: rbac.authorization.k8s.io
Incluso con toda esta configuración aplicada, el equipo sigue confinado a un solo namespace, carece de la posibilidad de instalar CRDs y se encuentra imposibilitado para ejecutar charts de Helm que requieran componentes de alcance global.
9. Seguridad Corporativa, Cumplimiento Normativo y Gobernanza
Al someter infraestructuras de Kubernetes a marcos de auditoría empresarial —como SOC 2 Tipo II, ISO 27001, HIPAA y PCI-DSS—, los auditores de seguridad examinan exhaustivamente la segregación de registros de auditoría y la privacidad criptográfica de los secretos.
Segregación de Registros de Auditoría y SIEM
En clústeres monolíticos compartidos con namespaces tradicionales, el kube-apiserver anfitrión genera un único torrente masivo de logs de auditoría. En empresas grandes, este flujo produce miles de millones de eventos semanales, incrementando considerablemente los costes de ingestión en herramientas SIEM (como Splunk, Datadog o Elastic).
Con vCluster, los flujos de auditoría se desacoplan limpiamente:
- Auditoría Virtual del Inquilino: El servidor API virtual registra todas las interacciones de los desarrolladores (ej. ejecuciones de
kubectl execo modificaciones de roles). Estos logs pueden remitirse directamente al repositorio del equipo correspondiente. - Auditoría del Clúster Anfitrión: El clúster anfitrión registra únicamente las acciones ejecutadas por la cuenta de servicio del
vcluster-syncer, manteniendo el SIEM central despejado y enfocado en la integridad física de la infraestructura.
Gestión Criptográfica de Secretos y Zero Data Retention (ZDR)
En un namespace tradicional, todos los Secrets se persisten en el etcd central anfitrión. Cualquier administrador con acceso al clúster físico tiene capacidad técnica para inspeccionar las credenciales de cualquier inquilino.
vCluster introduce una frontera criptográfica fundamental. Al configurar sync.toHost.secrets.enabled: false en vcluster.yaml, los Secrets virtuales residen exclusivamente en la base de datos privada del vCluster. El syncer jamás los envía al etcd del anfitrión. Cuando un pod virtual monta un secreto, el syncer lo inyecta directamente en la especificación del contenedor en el runtime sin generar un objeto Secret en el anfitrión. Los operadores del clúster anfitrión no pueden leer las credenciales del inquilino mediante comandos kubectl get secrets.
10. Matriz Comparativa Arquitectónica de 25 Dimensiones
A continuación se presenta la tabla técnica comparativa exhaustiva que analiza todas las diferencias clave entre Loft Labs vCluster y los Namespaces tradicionales de Kubernetes en 25 dimensiones arquitectónicas y operativas.
| Dimensión Arquitectónica | Loft Labs vCluster | Kubernetes Namespaces | Análisis e Impacto Empresarial |
|---|---|---|---|
| 1. Arquitectura de Control Plane | Servidor API virtual dedicado por inquilino (k3s/k8s/k0s) | Monolito central kube-apiserver compartido | vCluster suprime el punto único de fallo en el procesamiento de APIs. |
| 2. Base de Datos del Estado | SQLite privado o etcd dedicado e independiente | Registro etcd centralizado y compartido | Los recursos del inquilino jamás saturan el etcd del clúster anfitrión. |
| 3. Definiciones Personalizadas (CRDs) | Totalmente aisladas; esquemas independientes por inquilino | Ámbito global de clúster; versión única obligatoria | Previene colisiones irreparables en operadores como Cert-Manager o Istio. |
| 4. Webhooks de Admisión | Los webhooks virtuales sólo evalúan peticiones del inquilino | Globales; un webhook fallido bloquea a todos los equipos | vCluster impide que un fallo en un webhook interrumpa la plataforma entera. |
| 5. Delegación de Cluster-Admin | Permisos plenos de cluster-admin dentro del plano virtual | Inviable; cluster-admin otorgaría control del clúster anfitrión | Los ingenieros trabajan con autonomía total sin riesgo de escalado de privilegios. |
| 6. Creación de Sub-Namespaces | Nativa; los inquilinos crean múltiples namespaces internos | No soportada (HNC añade gran complejidad operativa) | Facilita pruebas de arquitecturas multicapa (frontend, backend, data). |
| 7. Contención y Throttling en la API | Las consultas finalizan en el servidor API virtual privado | Colas APF compartidas; riesgo de saturación por inquilinos | Elimina las respuestas HTTP 429 por vecinos ruidosos en el API central. |
| 8. Independencia de Versión de K8s | La versión virtual puede diferir del anfitrión (+/- 2 versiones) | Vinculada estrictamente a la versión del clúster anfitrión | Permite validar actualizaciones de Kubernetes sin alterar el clúster base. |
| 9. Sobrecarga de Memoria (RAM) | 120 MB - 180 MB por clúster virtual (k3s) | 0 MB (amortizada en el control plane anfitrión) | Sobrecarga residual frente a las capacidades habituales de los nodos. |
| 10. Sobrecarga de CPU | 0.01 - 0.03 vCPU en reposo por clúster virtual | 0 vCPU dedicada | Bucle de sincronización en Go altamente eficiente en consumo de ciclos. |
| 11. Delta en Latencia de Programación | +20ms a +50ms (conciliación intermedia del syncer) | 0ms de paso intermedio (programación directa) | Completamente irrelevante en ciclos de despliegue de microservicios. |
| 12. Rendimiento del Plano de Red | 100% velocidad nativa del CNI del anfitrión (sin proxies) | 100% velocidad nativa del CNI del anfitrión | Los pods virtuales se ejecutan sobre la red overlay física del clúster. |
| 13. Políticas de Red (NetworkPolicy) | Doble capa: aplicables a nivel virtual y en el namespace anfitrión | Aplicables exclusivamente en el namespace individual | vCluster refuerza la seguridad con un perímetro de red de dos niveles. |
| 14. Despliegue de Ingress y Service Mesh | Posibilidad de ingress dedicado o compartido del anfitrión | Obligación de compartir el controlador de ingress central | Los inquilinos pueden probar topologías de enrutamiento personalizadas. |
| 15. Almacenamiento Persistente (CSI) | Los PVCs virtuales se mapean al driver CSI del anfitrión | Aprovisionamiento nativo directo vía StorageClasses | Cero pérdida de rendimiento en disco; soporta EBS, GCE-PD y Ceph. |
| 16. Privacidad de Secretos | Secretos 100% virtuales; invisibles en el etcd del anfitrión | Todos los secretos residen en el etcd central anfitrión | Impide que administradores del clúster físico lean credenciales privadas. |
| 17. Reposo Automático (Auto-Pause) | Nativo; escala pods ociosos a 0 y los reactiva al recibir tráfico | No soportado nativamente (requiere CronJobs o KEDA) | Ahorra entre un 60% y un 70% de cómputo en entornos de no producción. |
| 18. Radio de Explosión ante Errores | Confinado al plano de control virtual individual | Elevado riesgo de cascada hacia todo el clúster físico | Protege al equipo de plataforma frente a errores de configuración graves. |
| 19. Eficiencia de Densificación de Nodos | Alta (65% - 80% de aprovechamiento en nodos compartidos) | Alta (65% - 80% de aprovechamiento en nodos compartidos) | Ambos esquemas evitan la severa fragmentación de clústeres aislados. |
| 20. Tarifa Fija de Control Plane Cloud | $0 USD por vCluster (opera como un pod no privilegiado) | $0 USD por namespace | Ahorra $876 USD/año por entorno frente a clústeres EKS/GKE dedicados. |
| 21. Aptitud para CI/CD y Previews | Excepcional (creación instantánea, soporte Helm total, borrado limpio) | Media (la limpieza de namespaces suele dejar restos de CRDs) | Destruir el namespace anfitrión de un vCluster borra el 100% de recursos. |
| 22. Aislamiento de Kernel (Código No Seguro) | Multi-tenancy blando; kernel Linux compartido | Multi-tenancy blando; kernel Linux compartido | Ambos requieren Kata Containers, gVisor o nodos dedicados para código hostil. |
| 23. Compatibilidad con Ecosistema K8s | 100% compatible con la API estándar (Lens, K9s, Helm, ArgoCD) | 100% compatible con la API estándar | Los desarrolladores no perciben diferencia frente a un clúster físico. |
| 24. Carga en el etcd del Anfitrión | Baja; sólo los pods y servicios sincronizados tocan el etcd host | Alta; cada secret, configmap, role y pod impacta en el etcd host | vCluster permite aumentar drásticamente la densidad global de objetos. |
| 25. Nivel de Multi-Tenancy Idóneo | Equipos corporativos semi-confiables, CI/CD efímero, sandboxes | Microservicios homogéneos y estáticos en producción GitOps | Armoniza las fronteras de confianza corporativas con la arquitectura técnica. |
11. Preguntas Frecuentes de Arquitectura e Ingeniería
1. ¿Pueden los inquilinos dentro de un vCluster crear sus propias Definiciones de Recursos Personalizados (CRDs) y ejecutar operadores sin permisos de cluster-admin en el clúster anfitrión?
Sí. Esta es una de las ventajas arquitectónicas más transformadoras de vCluster sobre los namespaces tradicionales de Kubernetes. En los namespaces estándar, los CRDs (Custom Resource Definitions) son estrictamente objetos globales con alcance de clúster (cluster-scoped) almacenados directamente en el etcd anfitrión. En consecuencia, otorgar a un equipo de desarrollo la facultad de instalar o actualizar un CRD requiere privilegios globales de cluster-admin, y cualquier CRD instalado pasa a ser visible para todos los namespaces del clúster. Si dos equipos requieren versiones incompatibles de un operador (como Cert-Manager v1.12 frente a v1.16, Prometheus Operator o CRDs de Istio), se produce una colisión de versiones insoluble. Dentro de un vCluster, el inquilino interactúa con su propio servidor API virtual respaldado por un almacén de datos SQLite o etcd completamente privado. Los CRDs registrados dentro del vCluster residen exclusivamente en ese plano de control virtual. El inquilino puede recibir permisos plenos de cluster-admin dentro de su entorno virtual, permitiéndole instalar CRDs arbitrarios, charts de Helm y controladores personalizados sin requerir privilegios elevados en el clúster anfitrión y sin contaminar el etcd central ni perjudicar a otros inquilinos.
2. ¿Cómo gestiona vCluster la resolución DNS de CoreDNS y la conectividad de red entre los pods virtuales y los servicios del clúster anfitrión?
vCluster despliega su propia instancia privada de CoreDNS dentro del pod que aloja el plano de control virtual. Cuando un contenedor dentro del clúster virtual resuelve un dominio con sufijo .cluster.local, el CoreDNS virtual traduce el nombre al ClusterIP virtual correspondiente. Sin embargo, cuando el sincronizador (syncer) de vCluster programa el pod físico en el clúster anfitrión, el pod recibe una dirección IP real del plugin CNI (Container Network Interface) del anfitrión (como Calico, Cilium, AWS VPC CNI o Azure CNI). Dado que los pods virtuales se ejecutan directamente sobre los nodos de trabajo físicos y comparten la misma infraestructura de red, se comunican a través de la red física sin encapsulación adicional ni degradación de latencia por proxies intermedios. Además, vCluster admite reenvío DNS configurable (upstream DNS forwarding), permitiendo que los pods virtuales resuelvan servicios del anfitrión (como bases de datos corporativas, endpoints de Prometheus o servicios de otros namespaces) de forma totalmente transparente.
3. ¿Introduce vCluster una latencia perceptible en la programación de pods o una penalización de rendimiento en cargas de producción de alta frecuencia?
Durante la ejecución continua en tiempo de ejecución (como el ancho de banda de red, el rendimiento de sockets TCP, el acceso a memoria y las instrucciones de CPU), vCluster introduce exactamente un 0.00% de sobrecarga porque las cargas de trabajo se ejecutan como contenedores Linux nativos directamente en los nodos de trabajo anfitriones, compartiendo el mismo kernel, cgroups y CNI que los pods convencionales. No obstante, en la fase inicial del ciclo de vida de los recursos (programación y despliegues progresivos), vCluster introduce una ligera sobrecarga de sincronización. Cuando un cliente envía un manifiesto de Pod al servidor API virtual, el proceso syncer debe capturar el evento, transformar los nombres de los objetos (incorporando el namespace virtual y el identificador del clúster) y recrear una réplica en el servidor API del anfitrión para que el kube-scheduler lo asigne a un nodo físico. Las mediciones empíricas demuestran que este ciclo de sincronización introduce entre 15ms y 45ms de latencia en el percentil p50 durante la creación inicial del pod, lo cual resulta completamente imperceptible para microservicios, bases de datos y procesos batch.
4. ¿Qué sucede si un inquilino en un vCluster consume excesiva CPU, memoria o I/O de disco? ¿Cómo evitan las cuotas de recursos la saturación de los nodos anfitriones?
vCluster implementa un modelo de aislamiento multinivel. A nivel del clúster anfitrión, todo el vCluster —incluyendo el pod del plano de control virtual y todos los pods de las cargas de trabajo sincronizadas— reside dentro de un único namespace anfitrión dedicado. El equipo de plataforma puede aplicar objetos estándar ResourceQuota y LimitRange a dicho namespace anfitrión, fijando un límite máximo infranqueable de vCPU, memoria RAM y almacenamiento persistente. Simultáneamente, dentro del vCluster, los administradores del inquilino pueden configurar sub-namespaces con sus propias ResourceQuotas internas para repartir el presupuesto entre distintas ramas de desarrollo. Si un proceso descontrolado dentro del vCluster intenta superar el límite del namespace anfitrión, el controlador de admisión del clúster anfitrión rechaza la creación del pod sincronizado, garantizando que los clústeres e inquilinos vecinos jamás sufran problemas de "vecino ruidoso" (noisy neighbor).
5. ¿Es vCluster suficientemente seguro para entornos de multi-tenancy estricto (hard multi-tenancy) con código de terceros no confiable?
Ni vCluster ni los namespaces nativos de Kubernetes proporcionan por sí solos un aislamiento de multi-tenancy estricto (hard multi-tenancy) frente a código malicioso o inquilinos totalmente desconocidos. Ambas tecnologías comparten el kernel de Linux de los nodos de trabajo físicos. Una vulnerabilidad de escape de contenedor (como CVE-2024-21626 en runc, fallos en eBPF o corrupción de memoria en el kernel) ejecutada dentro de un pod virtual puede permitir a un atacante vulnerar el nodo anfitrión y comprometer todos los contenedores alojados en esa máquina. Para lograr un multi-tenancy verdaderamente estricto con código no confiable, las organizaciones deben complementar vCluster con entornos de ejecución basados en micro-hipervisores (como Kata Containers o AWS Firecracker), sandboxes de espacio de usuario (como Google gVisor) o pools de nodos físicos dedicados segregados mediante taints, tolerations y afinidad de nodos en Kubernetes. No obstante, para aislamiento corporativo interno (soft a medium multi-tenancy) entre departamentos y equipos de ingeniería, vCluster proporciona un blindaje de plano de control muy superior al de los namespaces.
6. ¿Cómo funciona mecánicamente el modo de reposo automático (auto-pause / sleep mode) de vCluster y cómo reduce entre el 60% y 70% del gasto en cómputo?
El modo de reposo automático de vCluster es una funcionalidad nativa de optimización FinOps orientada a entornos de desarrollo, pruebas y CI/CD efímero. Al configurarse mediante vcluster.yaml o Helm, el syncer monitoriza las peticiones entrantes al servidor API virtual y el tráfico de red de ingress. Si no se detectan llamadas a la API ni paquetes de red durante un periodo de inactividad configurable (por ejemplo, 30 minutos), el controlador escala automáticamente a 0 réplicas todos los Deployments, StatefulSets y DaemonSets en el clúster anfitrión, conservando intactos todos los metadatos, ConfigMaps, Secrets y volúmenes PVC en el almacenamiento virtual. Cuando un desarrollador ejecuta un comando kubectl, se activa un pipeline de CI o llega una petición HTTP a un ingress, el proxy de vCluster intercepta la petición, escala las réplicas en el anfitrión a su estado original en un lapso de 3 a 8 segundos y completa la solicitud de forma transparente. Al estar inactivos durante noches y fines de semana (~110 de las 168 horas semanales), el ahorro de cómputo oscila entre el 60% y el 70%.
7. ¿Cómo opera el aprovisionamiento de almacenamiento y la sincronización de PersistentVolumeClaims (PVC) entre los clústeres virtuales y los controladores CSI del anfitrión?
vCluster evita la complejidad de ejecutar controladores de almacenamiento dentro del clúster virtual delegando la gestión al controlador CSI (Container Storage Interface) nativo del clúster anfitrión. Cuando un inquilino en un vCluster solicita un PersistentVolumeClaim con una StorageClass específica (como gp3 en AWS EKS o pd-ssd en Google GKE), el syncer intercepta el requerimiento, mapea la StorageClass virtual con una clase homologada en el anfitrión y genera un PVC real en el namespace del anfitrión con un nombre protegido contra colisiones. El aprovisionador dinámico del anfitrión solicita el volumen a la API de almacenamiento cloud y enlaza el PVC anfitrión. El syncer refleja inmediatamente el estado enlazado y la capacidad en el PVC virtual. Al iniciarse el pod, el kubelet del anfitrión monta el volumen de bloques directamente en el contenedor, garantizando un rendimiento de I/O nativo sin intermediación.
12. Guía de Migración a Producción y Lista de Verificación
La transición desde clústeres dispersos o sobreconsolidados hacia clústeres virtuales demanda una metodología estructurada en cuatro fases probada en entornos empresariales:
Inventario de CRDs y Operadores
Catalogar todos los recursos de alcance global, controladores de ingress y webhooks de admisión en los clústeres existentes. Agrupar a las escuadras según dependencias de operadores y niveles de cumplimiento normativo.
Preparación del Anfitrión
Aprovisionar un clúster EKS/GKE robusto equipado con Karpenter para escalado elástico eficiente, Calico/Cilium para políticas de red y estándares Pod Security Standards en modo restricted.
Entornos para Pull Requests
Integrar vCluster en pipelines de GitHub Actions o GitLab CI. Instanciar vClusters temporales al abrir un PR, ejecutar pruebas de integración completas con Helm y destruir el clúster virtual al fusionar el código.
Migración de Dev y Staging
Desmantelar clústeres EKS dedicados de desarrollo. Migrar a los equipos hacia vClusters persistentes con auto-pause habilitado y comprometer ahorros mediante Compute Savings Plans con el proveedor cloud.
Lista de Verificación Previa al Despliegue
José Andrade
ArquitectoFundador y Editor Principal en CloudBizStack. José está especializado en arquitecturas multi-tenant en Kubernetes, plataformas de autoservicio para desarrolladores y optimización cuantitativa de costes cloud.