Honeycomb vs Datadog: Comparativa de Observabilidad y APM (2026)
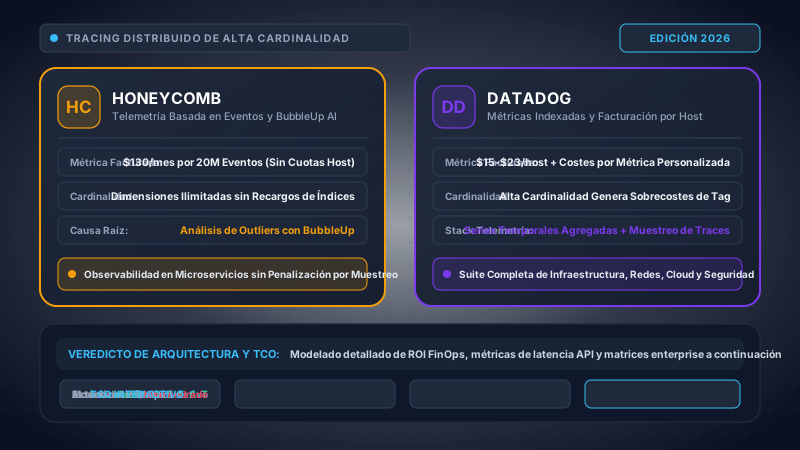
Tanto Honeycomb como Datadog facturan sus servicios en dólares estadounidenses (USD netos) bajo modelos de suscripción y consumo SaaS internacional. Para directores de tecnología (CTO), gerentes de ingeniería y líderes de FinOps en España y América Latina, la factura bruta en dólares suele diferir sustancialmente del desembolso real debido a normativas fiscales locales:
- IVA Digital y Autoliquidación Transfronteriza: En España, las empresas dadas de alta en el ROI (Registro de Operadores Intracomunitarios) pueden aplicar la inversión del sujeto pasivo, pero las compras sin NIF-IVA intracomunitario soportan el 21% de IVA. En Latinoamérica, legislaciones vigentes aplican retenciones automáticas sobre servicios digitales prestados desde el exterior: Chile (19% IVA digital), México (16% IVA transfronterizo vía RFC corporativo), Colombia (19% IVA) y Argentina (múltiples percepciones PAIS y adelantos de Ganancias).
- Retenciones en la Fuente por Pagos al Exterior: Países como Perú (retención del 30% a software importado salvo CDI con EE.UU.) y Colombia exigen justificar la naturaleza del servicio en la nube (SaaS vs asistencia técnica) mediante formularios W-8BEN-E para evitar la doble tributación corporativa.
- Diferencial Cambiario (FX Spread): Las tarjetas corporativas emitidas en la región suelen aplicar márgenes de conversión de divisa entre el 1.8% y el 3.5% sobre la tasa oficial de cambio al liquidar suscripciones en USD, lo que incrementa el coste total de propiedad en organizaciones con facturas que superan los $5,000 USD mensuales.
1. Resumen Ejecutivo y Veredicto Arquitectónico (TL;DR)
En el ecosistema tecnológico empresarial de 2026, la elección entre Honeycomb y Datadog no es una simple comparativa de características de software. Representa una discrepancia conceptual de raíz entre dos visiones contrapuestas de la ingeniería de sistemas: la telemetría exploratoria de eventos de alta cardinalidad frente a la monitorización de series temporales preagregadas integrada en una suite operativa monolítica.
Durante más de una década, la industria adoptó como verdad indiscutible el paradigma de los "tres pilares de la observabilidad": métricas para detectar desviaciones, logs para contextualizar y trazas distribuidas para aislar cuellos de botella de latencia. Datadog llevó este modelo a su máxima expresión comercial, construyendo una plataforma con más de 750 integraciones listas para usar, agentes de host automatizados, pruebas sintéticas de usuario, inspección de paquetes eBPF a nivel de red (NPM), monitorización profunda de bases de datos y un SIEM nativo en la nube. Sin embargo, esta división en tres silos obliga a los equipos de ingeniería a mantener tuberías de datos inconexas, correlacionar manualmente identificadores y recortar las etiquetas de telemetría para no incurrir en sobrecostes astronómicos por métricas personalizadas.
Por el contrario, Honeycomb desmanteló el dogma de los tres pilares desde sus cimientos. Fundada por Charity Majors y Christine Yen, Honeycomb se apoya en una estructura elemental: el evento ancho estructurado. Al almacenar cada tramo de ejecución (span) como un registro estructurado tipo JSON que contiene cientos de dimensiones contextuales —procesado en un motor columnar propio denominado Retriever que prescinde de índices invertidos tradicionales— Honeycomb permite a los ingenieros de software investigar modos de fallo totalmente inéditos ("desconocidos desconocidos") mediante consultas en submilisegundos, sin degradación por agregaciones temporales y sin límites de cardinalidad.
Matriz de Decisión Ejecutiva: ¿Dónde Vence Cada Plataforma?
| Perfil Organizacional y Caso de Uso | Honeycomb | Datadog | Veredicto Arquitectónico |
|---|---|---|---|
| Microservicios Cloud-Native e Ingeniería SRE Ágil | Eventos anchos nativos, aislamiento causal con BubbleUp en <2s, sin costes de cardinalidad | Métricas preagregadas, detección Watchdog por series temporales, trazas en silos | Honeycomb (Resolución MTTR Superior) |
| Infraestructura Híbrida, IT Ops Tradicional y Consolidación | Requiere OpenTelemetry Collector para métricas de host; carece de módulos físicos de red | 750+ integraciones turnkey, descubrimiento eBPF de hosts, VMware, bare-metal, SNMP | Datadog (Suite de Infraestructura Completa) |
| Depuración de Alta Cardinalidad (Por Tenant, Usuario o Carrito) | Dimensiones ilimitadas (UUIDs, IDs de cliente, hashes de contenedor) sin recargo | Graves penalizaciones ($5.00/100 métricas/mes) cuando la etiqueta supera el cupo por host | Honeycomb (Ganador Indiscutible) |
| Previsibilidad de Presupuesto FinOps | Tarificación exclusiva por eventos; usuarios ilimitados; control volumétrico vía Refinery | Más de 20 SKUs medidos (hosts, métricas custom, retención de logs, ejecuciones sintéticas) | Honeycomb (Cero Riesgo de Factura Sorpresa) |
| Operaciones de Seguridad (SecOps), SIEM y Pruebas Sintéticas | No dispone de motor SIEM nativo, archivado de auditoría ni pruebas en navegador | Cloud SIEM turnkey, CSM, escáner de datos sensibles y malla global de pruebas sintéticas | Datadog (Mayor Amplitud en Ciberseguridad) |
| Privacidad Estricta y Cumplimiento de Retención Cero | Proxy Secure Tenancy: datos cifrados antes de salir de la VPC del cliente; claves privadas | Sensitive Data Scanner ofuscador por regex; datos almacenados en centros Datadog | Honeycomb (Criptografía Secure Tenancy) |
Recomendación del Arquitecto: Selecciona Honeycomb si tu organización de ingeniería construye arquitecturas modernas de microservicios sobre Kubernetes, funciones serverless o flujos dirigidos por eventos, donde el tiempo medio de resolución (MTTR) depende de depurar fallos esporádicos y comportamientos anómalos ligados a identificadores específicos de clientes o versiones de despliegue. Escoge Datadog si la prioridad estratégica de la empresa es consolidar la gestión de TI corporativa —reuniendo switches de red, hipervisores VMware, cumplimiento de seguridad (SIEM), pruebas sintéticas de endpoints y paneles ejecutivos para un centro de operaciones de red (NOC) bajo un único contrato comercial.
2. Motor de Telemetría: Eventos Anchos Estructurados vs Agregación en Tres Pilares
Para comprender a fondo la brecha técnica entre ambas herramientas, es imprescindible examinar el comportamiento del almacenamiento columnar frente a las bases de datos de series temporales y las fórmulas matemáticas de la cardinalidad.
La Matemática de la Cardinalidad: Explosión Combinatoria
En una base de datos de series temporales (TSDB) tradicional como el motor Husky de Datadog o Prometheus, una métrica se identifica por su nombre y un conjunto de etiquetas (tags). El sistema genera una serie temporal independiente por cada combinación única de valores de esas etiquetas. Si una aplicación emite una métrica con $k$ dimensiones, el número total de series temporales $S$ que el sistema debe gestionar corresponde al producto cartesiano de los cardinales de cada etiqueta:
Analicemos un microservicio de comercio electrónico que registra la duración de una petición HTTP:
region: 5 valores (us-east-1,us-west-2,eu-west-1,ap-southeast-1,sa-east-1)http_status: 15 códigos HTTP comunesendpoint: 80 rutas de APIcontainer_id: 250 pods activos en el clúster de Kubernetes
Bajo esta configuración controlada, la TSDB sostiene:
5 × 15 × 80 × 250 = 1,500,000 series temporales únicas.
Si un desarrollador decide adjuntar identificadores para depurar incidentes en producción, agregando user_id (5,000,000 usuarios activos) y order_id (20,000,000 pedidos diarios), el volumen teórico de series temporales escala a:
1,500,000 × 5,000,000 × 20,000,000 = 1.5 × 10²⁰ series temporales.
En Datadog, este incremento combinatorio colapsa los índices en memoria o desencadena alertas de sobrecoste por métricas personalizadas que pueden ascender a decenas de miles de dólares en un solo fin de semana. Por este motivo, las guías de buenas prácticas de Datadog exigen eliminar identificadores unívocos de las métricas y confinarlos a los registros (logs) o a las trazas de APM.
Honeycomb Retriever: El Motor Columnar para Eventos Arbitrarios
Honeycomb resuelve este dilema mediante su base de datos distribuida Retriever. Retriever es un motor columnar diseñado desde cero para gestionar eventos anchos estructurados sin preagregación ni índices invertidos:
- Ausencia de Preagregación: La telemetría no se compacta en promedios de 10 segundos o 1 minuto en la ingesta. Cada evento conserva intactos todos sus atributos originales.
- Sin Índices Invertidos Tradicionales: Al evitar estructuras tipo B-Tree o Lucene, Honeycomb no sufre la inflación de memoria RAM que experimentan los motores de búsqueda de texto cuando la cantidad de términos únicos crece exponencialmente.
- Compresión Columnar Avanzada: Los atributos se organizan en microparticiones por columna. Dado que valores adyacentes en una misma columna (como
app.build_versionok8s.namespace) presentan gran similitud, algoritmos como Zstandard y codificación por diccionario logran ratios de compresión superiores al 85%. - Barrido Paralelo por Fuerza Bruta Distribuida: Cuando un usuario ejecuta una consulta, Retriever distribuye el trabajo entre miles de núcleos de procesamiento en AWS EC2, leyendo únicamente las columnas demandadas desde discos NVMe y almacenamiento S3, completando agregaciones complejas sobre miles de millones de eventos en menos de 2.5 segundos.
"timestamp": "2026-11-08T03:14:22.842Z",
"trace.trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
"trace.span_id": "00f067aa0ba902b7",
"name": "pagos.procesar_transaccion",
"duration_ms": 1842.15,
// Atributos de Negocio de Alta Cardinalidad (Sin Recargo en Honeycomb)
"app.cliente_id": "cli_corporativo_99214",
"app.carrito_uuid": "cart_uuid_09a8f211-92b0-4591",
"app.monto_total_usd": 4299.50,
"app.pasarela_pago": "mercadopago_enterprise",
"app.reintentos": 3,
"app.circuit_breaker_activo": true,
"app.feature_flag.motor_fraude_v3": "variante_b_latam",
// Dimensiones de Infraestructura y Entorno de Ejecución
"k8s.pod.name": "pagos-svc-78f99d6d45-k8zlw",
"k8s.node.name": "ip-10-0-142-88.ec2.internal",
"host.arch": "arm64",
"process.runtime.version": "go1.25.1",
"net.peer.name": "api.mercadopago.com",
"net.peer.latency_ms": 1790.80
}
La Pérdida del Percentil P99 por Agregación Temporal
Cuando Datadog compacta métricas a lo largo del tiempo, genera resúmenes estadísticos (promedios, mínimos, máximos y estimaciones de percentiles mediante t-digest). Sin embargo, una vez que los eventos individuales se fusionan en histogramas matemáticos, la correlación entre los distintos atributos se destruye para siempre.
Si la latencia media de un servicio es de 50ms pero el 0.1% de las transacciones experimenta bloqueos de 9,000ms, la gráfica de métricas mostrará una pequeña ondulación en la línea del p99. Lo que resulta imposible es preguntar a esa gráfica: "¿Cuáles son los IDs de cliente o qué versiones de firmware causaron esos picos de 9,000ms?" Para averiguarlo, el operador debe abandonar el panel de métricas, navegar al explorador de logs, redactar una consulta y alinear marcas de tiempo manualmente. En Honeycomb, el tramo de la traza es el evento en sí: basta hacer clic sobre los puntos atípicos en el mapa de calor para inspeccionar al instante todos los datos contextuales.
3. Motor de Consultas y Causa Raíz: BubbleUp vs Datadog Watchdog
Ambas herramientas integran algoritmos de detección de anomalías asistidos por computación avanzada, pero responden a flujos de trabajo de resolución de incidentes profundamente distintos.
Honeycomb BubbleUp: Divergencia Estadística No Paramétrica Multidimensional
El núcleo del valor diagnóstico de Honeycomb reside en BubbleUp. A diferencia de las herramientas que envían alertas automatizadas cuando un umbral se rompe, BubbleUp es un instrumento analítico interactivo que se utiliza durante la mitigación activa de incidencias.
Cuando un ingeniero detecta una agrupación sospechosa de peticiones lentas o errores en un mapa de calor, selecciona visualmente ese conjunto de eventos con el cursor. En milisegundos, BubbleUp segmenta el conjunto de datos en dos universos:
- Población de Selección ($P$): Los eventos contenidos dentro del área seleccionada (las peticiones degradadas o con errores).
- Población de Referencia ($Q$): La totalidad de eventos fuera de la selección en esa misma ventana temporal (las peticiones sanas).
A continuación, Retriever calcula la discrepancia estadística entre ambas poblaciones para todas y cada una de las dimensiones existentes en el dataset de forma simultánea. En atributos continuos, aplica el test de bondad de ajuste de Kolmogorov-Smirnov:
En menos de dos segundos, BubbleUp presenta una serie de histogramas comparativos ordenados de mayor a menor divergencia. El equipo observa de inmediato que factores como el sistema operativo, la zona de disponibilidad o el método HTTP presentan distribuciones idénticas en ambos grupos, mientras que una variable específica —por ejemplo, app.feature_flag.motor_fraude_v3 = variante_b_latam— está presente en el 100% de las peticiones lentas y en el 0% de las peticiones saludables. La causa raíz pasa de ser una hipótesis a una certeza demostrada en una única interacción.
Datadog Watchdog: Modelos de Series Temporales y Alertas Proactivas
Watchdog, el motor de inteligencia de Datadog, adopta un enfoque preventivo y macroscópico. Watchdog ejecuta modelos de aprendizaje automático (incluyendo descomposición estacional autorregresiva, filtros de Kalman y árboles de decisión potenciados por gradiente) sobre series de métricas, tasas de error y rendimiento de APM.
Su objetivo prioritario es identificar anomalías que rompan los ciclos históricos —como detectar que el tiempo de respuesta de una base de datos un martes a las 15:00 excede en un 40% la media histórica de los martes, aun sin haber superado un umbral estático de alerta—. Sus componentes destacados incluyen:
- Watchdog Insights: Distintivos visuales en los paneles que destacan etiquetas con comportamientos anómalos (por ejemplo, incremento de fallos en
availability-zone:sa-east-1a). - Historias de Causa Raíz (RCA Stories): Agrupación cronológica de alertas interconectadas entre capas de red, logs y servicios de APM.
- Asistente Bits AI: Interfaz en lenguaje natural que permite consultar estados de métricas y generar resúmenes de incidencias para equipos de guardia.
El Límite Arquitectónico: Watchdog es sumamente eficaz para advertir sobre fallos conocidos y tendencias de saturación en sistemas tradicionales. Sin embargo, durante caídas en cascada complejas provocadas por bloqueos lógicos entre microservicios, Watchdog suele generar decenas de alertas correlacionadas simultáneas sin poder demostrar causalidad directa, ya que carece de la capacidad de evaluar distribuciones no paramétricas sobre atributos dinámicos no indexados.
4. Trazado Distribuido y Estrategias de Muestreo: Honeycomb Refinery vs Datadog
En arquitecturas que procesan cientos de miles de peticiones por segundo, recopilar el 100% de las trazas distribuidas resulta inviable desde una perspectiva de costes de almacenamiento y ancho de banda. Por este motivo, el muestreo (sampling) constituye un pilar esencial del diseño de telemetría.
Muestreo en Origen (Head-based) frente a Muestreo en Cola (Tail-based)
El muestreo en origen toma la decisión en el primer punto de entrada del tráfico (por ejemplo, en el API Gateway), decidiendo mediante un algoritmo probabilístico si la traza se registra o se descarta antes de conocer el desenlace de la petición.
El Defecto del Muestreo en Origen: Si un fallo intermitente de base de datos impacta únicamente al 0.05% de los usuarios, una política de muestreo en origen del 1% descartará el 99% de las peticiones fallidas. El equipo de guardia se encontrará sin trazas diagnósticas precisamente en el momento en que ocurre la avería.
Por el contrario, el muestreo en cola (tail-based sampling) retiene todos los tramos de la traza en un búfer temporal en memoria hasta que la transacción finaliza. Una vez completada, el sistema evalúa el estado del proceso: las transacciones que culminaron en errores HTTP 5xx, excepciones no gestionadas o latencias que violan los objetivos de servicio (SLO) se conservan al 100%, mientras que las transacciones exitosas rutinarias se submuestrean.
Honeycomb Refinery: Proxy Distribuido de Muestreo en Cola
Honeycomb implementa el muestreo en cola mediante Refinery, un clúster proxy de alto rendimiento que los clientes despliegan dentro de su propia infraestructura (clústeres de Kubernetes o instancias privadas en la nube).
Refinery utiliza un mecanismo de enrutamiento basado en hash consistente para garantizar que todos los tramos que componen un mismo trace_id se envíen al mismo nodo worker. Cada nodo retiene la traza en RAM durante un periodo configurable (generalmente de 3 a 10 segundos). Una vez ensamblada la traza completa, se aplican reglas de negocio deterministas y dinámicas.
Samplers:
__default__:
DeterministicSampler:
SampleRate: 10
reglas_produccion:
RulesBasedSampler:
Rules:
# Regla 1: Retener el 100% de errores del servidor (5xx)
- Name: "retener_errores_5xx"
SampleRate: 1 # Tasa 1:1, conserva la totalidad
Conditions:
- Field: "http.status_code"
Operator: ">="
Value: 500
# Regla 2: Retener el 100% de peticiones con latencia crítica (P99)
- Name: "retener_latencias_criticas"
SampleRate: 1
Conditions:
- Field: "duration_ms"
Operator: ">="
Value: 2500
# Regla 3: Retener al 100% las cuentas corporativas estratégicas
- Name: "retener_clientes_vip"
SampleRate: 1
Conditions:
- Field: "cliente.tier"
Operator: "="
Value: "corporativo_tier_1"
# Regla 4: Submuestrear agresivamente health checks y sondas k8s
- Name: "submuestrear_healthchecks"
SampleRate: 1000 # Conserva sólo 1 de cada 1000
Conditions:
- Field: "http.target"
Operator: "in"
Value: ["/healthz", "/readyz", "/metricas"]
# Regla 5: Muestreo dinámico EMA para tráfico regular exitoso
- Name: "dinamico_trafico_general"
EMASampler:
GoalThroughputPerSec: 400
FieldList: ["http.route", "http.status_code"]
El Esquema de Datadog: Ingestión vs Indexación
En Datadog, el coste del trazado se divide en dos fases:
- Tramos Ingeridos (Ingested Spans): El agente de Datadog envía las trazas hacia la nube de Datadog. Todo gigabyte transmitido que exceda el cupo incluido de 150 GB por host se factura a $0.10 USD/GB.
- Tramos Indexados (Indexed Spans): Una vez en la nube, los Filtros de Retención deciden qué tramos se guardan para búsqueda interactiva durante 15 días, con una tarifa de $1.70 USD por millón de eventos indexados.
Diferencia de Arquitectura: En Datadog, el filtrado se produce principalmente en los servidores del proveedor después de que el tráfico ha cruzado la red pública, generando costes de transferencia de datos y consumo de ancho de banda. Con Honeycomb Refinery, el muestreo se efectúa dentro de la propia red del cliente: los datos descartados nunca abandonan la VPC corporativa, minimizando tanto la factura de salida de la nube (egress) como la tarificación del SaaS.
5. Ecosistema de Agentes: OpenTelemetry Nativo vs Agente Propietario de Datadog
El mecanismo empleado para recolectar telemetría condiciona la independencia técnica frente al proveedor (evitando el temido vendor lock-in), el consumo de recursos de los clústeres de cómputo y la complejidad del mantenimiento de software.
Honeycomb: Apuesta Total por el Estándar Abierto OpenTelemetry
Honeycomb tomó la determinación de deprecar formalmente sus librerías propietarias (como Beeline) para adoptar de manera exclusiva el estándar abierto OpenTelemetry (OTel) de la Cloud Native Computing Foundation (CNCF).
Honeycomb no requiere la instalación de ningún daemon propietario en el sistema operativo. La instrumentación se lleva a cabo mediante los SDKs oficiales de OpenTelemetry en los lenguajes de desarrollo de la empresa (Java, Go, Python, Node.js, C#, Rust) y se transmite mediante el protocolo estándar OTLP sobre gRPC o HTTP. Si una organización decide cambiar de plataforma en el futuro, no es necesario modificar ni una sola línea de código fuente; basta con actualizar la dirección del exportador OTLP en el colector.
Datadog Agent (v7): Integración Profunda pero Pesada
El agente de Datadog ofrece una cobertura funcional inmensa, pero su arquitectura monolítica implica un impacto no desdeñable en los nodos de Kubernetes. Desplegado comúnmente como un DaemonSet, integra simultáneamente:
core-agent: Recopila métricas de host, contenedores y servicios en la nube.trace-agent: Ingesta tramos propietarios de APM y aplica agregaciones locales.process-agent: Inspecciona procesos activos, hilos de ejecución y grupos de control (cgroups).system-probe: Ejecuta programas eBPF a nivel de kernel para monitorizar flujos de red y conexiones TCP.security-agent: Realiza monitorización de integridad de archivos y auditorías de seguridad en contenedores.
Aunque Datadog permite la ingesta de telemetría OTLP, su modelo interno convierte los atributos a su esquema de etiquetas propio. Además, ejecutar el conjunto completo del agente de Datadog suele requerir entre 450 MB y 900 MB de RAM por nodo de Kubernetes, en contraste con un DaemonSet del OpenTelemetry Collector optimizado, cuyo consumo oscila entre 80 MB y 160 MB de RAM.
otlp:
protocols:
grpc: { endpoint: "0.0.0.0:4317" }
http: { endpoint: "0.0.0.0:4318" }
processors:
batch:
timeout: 1s
send_batch_size: 1024
memory_limiter:
check_interval: 1s
limit_percentage: 75
exporters:
# Destino 1: Honeycomb OTLP Seguro
otlp/honeycomb:
endpoint: "api.honeycomb.io:443"
headers:
"x-honeycomb-team": "${env:HONEYCOMB_API_KEY}"
"x-honeycomb-dataset": "produccion-microservicios"
# Destino 2: Datadog Exporter Oficial
datadog:
api:
key: "${env:DATADOG_API_KEY}"
site: "datadoghq.com"
service:
pipelines:
traces:
receivers: [otlp]
processors: [memory_limiter, batch]
exporters: [otlp/honeycomb, datadog]
6. Monitorización de Infraestructura, Pruebas Sintéticas y Amplitud de Suite
En esta comparativa cobra especial relevancia el dilema entre adoptar una herramienta hiperespecializada en depuración de código distribuido frente a una suite monolítica para todas las operaciones de TI.
El Ecosistema Total de Datadog
El punto fuerte de Datadog radica en su capacidad para abarcar la totalidad de las necesidades del departamento de tecnología bajo un único paraguas:
- 750+ Integraciones Oficiales: Conectores llave en mano para servicios cloud en AWS, Azure y Google Cloud, así como para bases de datos relacionales, clústeres de Kafka, almacenamiento en Redis y conmutadores de red tradicionales.
- Inspección de Redes con eBPF (NPM): Monitorización de latencias de conexión a nivel de socket, retransmisiones de paquetes TCP y saturaciones en el tráfico entre pods y pasarelas de pago externas.
- Monitorización Sintética Global: Ejecución automatizada de recorridos completos de compra mediante navegadores Chromium en más de 25 regiones geográficas para detectar fallos en endpoints antes que los usuarios.
- Monitorización de Bases de Datos (DBM): Análisis visual de planes de ejecución de consultas SQL, contenciones por bloqueos y perfiles de consumo para PostgreSQL, MySQL y Oracle.
- Seguridad en la Nube y SIEM: Detección de intrusiones en tiempo real cruzando registros de auditoría de AWS CloudTrail y eventos de contenedores con los marcos de trabajo de MITRE ATT&CK y CIS Benchmarks.
El Foco Especializado de Honeycomb
Honeycomb renuncia de forma deliberada a convertirse en un SIEM o en un gestor de conmutadores de red físicos.
Su tesis sostiene que todo dato operativo debe tratarse como un evento. Las métricas de host (uso de memoria, saturación de disco o CPU) se ingieren mediante OpenTelemetry y se visualizan a la par de las trazas de ejecución en Retriever. Honeycomb destaca además en la definición rigurosa de Objetivos de Nivel de Servicio (SLO) vinculados al consumo de presupuesto de error (Burn Rate), evitando que las alertas saturen al equipo con avisos por picos transitorios de CPU que no afectan a la experiencia del usuario final.
7. Modelado Financiero FinOps y Simulación de TCO a 3 Años
Las discrepancias económicas entre ambas herramientas son determinantes: mientras Honeycomb cobra en función de un único parámetro transparente (volumen de eventos ingeridos), Datadog suma múltiples conceptos medibles independientes que pueden generar desviaciones presupuestarias imprevisibles.
Anatomía de los Sobrecostes Ocultos en Datadog
En una propuesta comercial de Datadog, el precio base de $15 USD por host de infraestructura o $31 USD por host de APM parece moderado. No obstante, las partidas secundarias son las que habitualmente multiplican la factura:
- Recargo por Métricas Personalizadas: Tras consumir las 100 métricas incluidas por host, cada bloque adicional de 100 series temporales cuesta $5.00 USD mensuales:
Coste_{metricas} = \max\left(0, \frac{M_{totales} - (100 \times N_{hosts})}{100}\right) \times \$5.00En entornos con pods efímeros en Kubernetes, la multiplicación de etiquetas dinámicas suele derivar en desvíos presupuestarios imprevistos.
- Ingesta e Indexación de Registros: La ingesta sin indexar cuesta $0.10 USD/GB. Retener e indexar logs para consulta cuesta entre $1.06 y $2.50 USD por cada millón de registros según el plazo de retención elegido (3 a 30 días).
- Pruebas Sintéticas y Trazas: $5.00 USD por cada 10,000 llamadas a APIs y $1.70 USD por cada millón de tramos de APM indexados.
La Economía Predecible de Honeycomb
Honeycomb factura exclusivamente por una única unidad de medida: el volumen de eventos.
- Nivel Gratuito: 20 millones de eventos al mes con acceso a todas las funcionalidades clave y usuarios ilimitados.
- Nivel Pro: Desde $130 USD al mes por 20 millones de eventos, con ampliaciones por bloques volumétricos claramente estipulados.
- Nivel Enterprise: Contratos anuales con compromisos de volumen y descuentos escalonados.
- Usuarios y Asientos Ilimitados: No existe coste por usuario; toda la plantilla de ingeniería puede acceder a la herramienta sin barreras de licenciamiento.
- Sin Penalización por Cardinalidad: Cada evento puede almacenar cientos de etiquetas complejas sin recargo adicional.
Simulación de Coste Total de Propiedad (TCO) a 3 Años
La siguiente tabla proyecta el coste total acumulado en tres años para tres escalas empresariales habituales:
| Escenario Operativo | Perfil de Infraestructura | Honeycomb (3 Años) | Datadog (3 Años) | Ahorro FinOps |
|---|---|---|---|---|
| Escenario A: Scale-Up Cloud Native | 50 nodos K8s, 15 microservicios, 40 ingenieros, 60M eventos/día (muestreados 10:1 a 6M/día). | $78,400 USD | $164,200 USD | Honeycomb 52% más económico |
| Escenario B: FinTech en Expansión | 250 nodos K8s, 80 microservicios, 150 ingenieros, 600M eventos/día (Refinery a 45M/día). | $324,000 USD | $785,000 USD | Honeycomb 58% más económico |
| Escenario C: Corporación Multinacional | 1,200 hosts/VMs, 350 microservicios, 500 ingenieros, 3B eventos/día (Refinery a 220M/día). | $1,180,000 USD | $2,890,000 USD | Honeycomb 59% más económico |
8. Matriz Comparativa Exhaustiva de 25 Dimensiones Técnicas
Desglose pormenorizado que evalúa ambos sistemas en veinticinco variables críticas de arquitectura, muestreo, experiencia de usuario, seguridad corporativa y previsibilidad económica.
| Dimensión Evaluada | Honeycomb | Datadog | Ventaja |
|---|---|---|---|
| 1. Filosofía de Telemetría | Eventos anchos estructurados unificados; dimensionalidad JSON arbitraria; depuración exploratoria. | Tres pilares separados (métricas de series temporales, logs en texto, tramos APM) correlacionados en paneles. | Honeycomb |
| 2. Unidad Primaria de Facturación | Métrica volumétrica única (cantidad de eventos ingeridos); sin cobro por asientos de usuario. | Múltiples unidades: hosts + series de métricas custom + logs ingeridos/indexados + tramos APM. | Honeycomb |
| 3. Soporte de Cardinalidad | Prácticamente ilimitada. Miles de millones de valores únicos por campo sin merma de velocidad. | Límites estrictos de cardinalidad. Cuota de 100 métricas custom por host antes de fuertes sobrecostes. | Honeycomb |
| 4. Mantenimiento de Índices | Cero indexación requerida. El motor Retriever ejecuta búsquedas directas en paralelo sobre datos en bruto. | Requiere configurar índices Lucene, filtros de retención de logs y exclusión de etiquetas complejas. | Honeycomb |
| 5. Motor de Causa Raíz Automatizado | BubbleUp: Cálculo de divergencia estadística multidimensional simultánea sobre todos los campos. | Watchdog: Pronósticos ML de series temporales, detección de anomalías y agrupación por correlación. | Honeycomb |
| 6. Detección Proactiva de Anomalías | Comparación de distribuciones guiada por el usuario (Kolmogorov-Smirnov) en consultas ultrarrápidas. | Alertas automáticas en segundo plano basadas en la estacionalidad y comportamiento cíclico histórico. | Datadog |
| 7. Arquitectura de Muestreo de Trazas | Clúster proxy Refinery: Muestreo en cola dentro de la VPC corporativa antes de emitir a la nube SaaS. | Muestreo en origen por agente + control de ingesta en la nube ($0.10/GB) + filtros de retención ($1.70/M). | Honeycomb |
| 8. Fidelidad de Trazado Distribuido | Cada span es un evento ancho completo con todos sus atributos intactos sin recortes de texto. | Gran detalle de traza, aunque se suelen suprimir etiquetas secundarias para mitigar el tamaño del índice. | Honeycomb |
| 9. Soporte de OpenTelemetry (OTel) | 100% nativo. SDKs propietarios deprecados; ingesta OTLP pura sobre gRPC y HTTP. Cero lock-in. | Admite ingesta OTLP, pero traduce atributos a esquemas propios y prioriza el uso de su agente dedicado. | Honeycomb |
| 10. Huella de Memoria del Agente | Sin daemon propietario. DaemonSet de OpenTelemetry Collector consume ~80MB–160MB de RAM por nodo. | DaemonSet de Datadog Agent (system-probe, trace, core, security) consume de 450MB a 900MB de RAM. | Honeycomb |
| 11. Monitorización de Infraestructura | Métricas de host como eventos OTel; carece de descubrimiento automatizado de hardware de red físico. | 750+ integraciones, paneles de host prediseñados, descubrimiento eBPF, VMware, conmutadores SNMP. | Datadog |
| 12. Visibilidad en Clústeres Kubernetes | Ingesta de k8sclusterreceiver en OTel; excelente correlación entre tramos y pods. | Kubernetes Explorer dedicado, mapa de contenedores en vivo, mapas de red eBPF y charts Helm oficiales. | Datadog |
| 13. Gestión de Registros (Logs) | Los logs se ingieren como eventos estructurados en Retriever; consultas conjuntas con trazas y métricas. | Módulo de gestión de logs integral con sintaxis Lucene, pipelines de grok parsing y archivado externo. | Datadog |
| 14. Preagregación de Métricas | Nula. Las consultas operan sobre los eventos en bruto; la resolución no se degrada con el paso de los meses. | Las métricas se compactan en cubos temporales (10s, 1m, 1h); el detalle de las transacciones individuales se pierde. | Honeycomb |
| 15. Lenguaje y Flexibilidad de Consultas | Columnas derivadas con sintaxis tipo JavaScript, expresiones matemáticas y constructor visual rápido. | Operaciones DogStatsD, sintaxis de logs, DQL y fórmulas cruzadas sobre series temporales múltiples. | Empate |
| 16. Mapas de Calor y Precisión de Percentiles | Mapas de calor interactivos directos sobre eventos reales con salto automático a BubbleUp. | Estimaciones mediante t-digest; mapas de calor disponibles pero desvinculados de correlación dimensional instantánea. | Honeycomb |
| 17. Gestión de SLOs y Presupuesto de Error | Alertas en tiempo real por ritmo de agotamiento de presupuesto (Burn Rate) vinculadas a BubbleUp. | Objetivos de Nivel de Servicio configurables basados en monitores y métricas con amplia variedad de widgets. | Empate |
| 18. Paneles Prediseñados (Dashboards) | Plantillas esenciales; la filosofía de uso promueve la consulta ad-hoc sobre el mantenimiento de paneles estáticos. | Miles de cuadros de mando preconfigurados para cualquier tecnología con gran flexibilidad visual. | Datadog |
| 19. Monitorización Sintética | No dispone de motor nativo de pruebas sintéticas basadas en navegadores o llamadas periódicas. | Malla sintética completa con navegadores Chrome headless, validación de certificados SSL y pruebas multi-paso. | Datadog |
| 20. Monitorización de Usuario Real (RUM) | Honeycomb for Frontend (instrumentación OTel en cliente web); mide Core Web Vitals como eventos. | RUM avanzado con reproducción simulada de sesiones (Session Replay), clics de frustración y SDKs móviles. | Datadog |
| 21. Rendimiento de Bases de Datos y Red (DBM/NPM) | Tramos de bases de datos vía OTel; no dispone de módulo eBPF para inspección de paquetes de red. | Módulos avanzados de DBM (análisis de planes de consulta SQL) y NPM por eBPF. | Datadog |
| 22. Ciberseguridad y SIEM (SecOps) | Carece de módulo para gestión de información de seguridad o auditoría de cumplimiento. | Cloud SIEM integrado, gestión de postura de seguridad (CSPM) y seguridad en tiempo de ejecución (CWS). | Datadog |
| 23. Privacidad y Retención Cero | Secure Tenancy: Proxy KMS en la VPC del cliente. La información viaja cifrada y el SaaS nunca ve texto claro. | Sensitive Data Scanner: Ofuscación por expresiones regulares en la ingesta en centros de datos del proveedor. | Honeycomb |
| 24. Licenciamiento de Usuarios | Asientos ilimitados en todos los planes. Democratiza la observabilidad en todo el equipo sin canon por usuario. | Gestión por cuenta; algunas funciones avanzadas e integraciones están sujetas a roles o licencias por usuario. | Honeycomb |
| 25. Previsibilidad FinOps a 3 Años | Muy alta. Un solo parámetro volumétrico regulable mediante las reglas de muestreo de Refinery. | Baja a moderada. Riesgo habitual de desviaciones presupuestarias por etiquetas dinámicas y volumen de logs. | Honeycomb |
9. Seguridad Corporativa, Privacidad de Datos y Cumplimiento Normativo
En entornos donde se procesan operaciones bancarias, historias clínicas o datos personales bajo el RGPD europeo o normativas de protección de datos en Iberoamérica, transmitir trazas de ejecución a la nube pública plantea retos de cumplimiento legal que requieren arquitecturas de aislamiento sólidas.
Honeycomb Secure Tenancy: Aislamiento Criptográfico en Origen
Para organizaciones sujetas a estrictas obligaciones de soberanía de datos (HIPAA, PCI-DSS Nivel 1 o RGPD), Honeycomb ofrece la opción de desplegar Secure Tenancy.
Bajo este esquema, la telemetría no se envía de forma directa a los puntos de ingesta de Honeycomb, sino que pasa por un proxy gestionado por el propio cliente dentro de su VPC privada:
- Claves de Cifrado Exclusivas del Cliente: El proxy se integra con gestores de secretos como AWS KMS o HashiCorp Vault. Las claves maestras de cifrado nunca abandonan el perímetro corporativo.
- Tokenización en Tránsito: Todos los valores de atributos, nombres de transacciones y cargas de texto se cifran mediante algoritmos simétricos antes de salir a Internet.
- Almacenamiento de Texto Cifrado: El motor Retriever de Honeycomb almacena y realiza las agregaciones exclusivamente sobre los tokens cifrados. Los empleados de Honeycomb y los operadores del servicio en la nube no pueden acceder a los datos en texto claro bajo ninguna circunstancia.
- Descifrado en Memoria Local: Cuando un ingeniero autorizado realiza una consulta en la interfaz web de Honeycomb, una extensión en el navegador web descifra los identificadores localmente en la memoria de su estación de trabajo, garantizando el aislamiento total.
Datadog Sensitive Data Scanner (SDS) y Acreditaciones Globales
Datadog aborda la privacidad corporativa mediante el Sensitive Data Scanner (SDS), un motor de inspección basado en patrones que actúa en la fase de ingesta en la nube:
- Ofuscación por Expresiones Regulares: SDS examina registros, tramos de APM y sesiones de usuario real contra patrones predefinidos (números de tarjeta de crédito, números de seguridad social, tokens JWT, claves API), aplicando máscaras o eliminando los campos antes de persistirlos en el almacenamiento del proveedor.
- Certificaciones Internacionales: Datadog acredita certificaciones de máximo nivel, incluyendo SOC 2 Tipo II, ISO 27001, ISO 27017, ISO 27018 y acuerdos BAA para cumplimiento de la normativa HIPAA en el sector de la salud.
- FedRAMP High y Datadog GovCloud: Para instituciones gubernamentales y entidades de defensa, Datadog dispone de regiones soberanas aisladas autorizadas bajo FedRAMP High, mientras que Honeycomb cuenta con certificación FedRAMP Moderate.
10. Preguntas Frecuentes (FAQ)
11. Hoja de Ruta de Migración: De Datadog a Honeycomb sin Fricción
La sustitución de un sistema de monitorización en aplicaciones de producción exige un plan por fases para evitar interrupciones de visibilidad operativa y facilitar la adaptación del equipo técnico.
Fase 1: Desacoplamiento mediante OpenTelemetry y Envío Dual (Días 1 a 30)
No desinstales el agente de Datadog al inicio. En su lugar, despliega un clúster de OpenTelemetry Collector como pasarela en tus clústeres de Kubernetes. Comienza a migrar las librerías de aplicación propietarias (dd-trace-py, dd-trace-java) hacia los SDKs oficiales de OpenTelemetry configurados para exportar por OTLP.
Configura el OpenTelemetry Collector para bifurcar el tráfico: envía las trazas hacia Honeycomb mediante el exportador OTLP oficial y simultáneamente hacia Datadog con datadogexporter. Esto garantiza que todos los monitores de Datadog continúen operando con normalidad mientras los desarrolladores comienzan a explorar las capacidades de Honeycomb.
Fase 2: Despliegue de Honeycomb Refinery y Ajuste del Muestreo (Días 31 a 45)
Despliega un clúster redundante de Refinery en tu red privada (mínimo 2 nodos tras un balanceador interno). Apunta el exportador del OpenTelemetry Collector hacia Refinery. Configura reglas iniciales que retengan el 100% de errores, excepciones y trazas que sobrepasen el percentil p95 de latencia, activando el muestreador dinámico EMA para las rutas rutinarias de alta frecuencia. Supervisa el consumo en el panel de uso de Honeycomb para calibrar el volumen mensual definitivo.
Fase 3: Adopción de SLOs y Retirada Gradual de Paneles en Datadog (Días 46 a 60)
Sustituye los monitores basados en umbrales estáticos por Objetivos de Nivel de Servicio (SLO) basados en el ritmo de consumo de presupuesto de error en Honeycomb. Capacita a los ingenieros de guardia para utilizar BubbleUp como primera acción diagnóstica en cada alerta. Una vez que el equipo resuelva incidentes rutinarios en Honeycomb con mayor agilidad, cancela los módulos de APM y métricas personalizadas en Datadog, conservando este último únicamente si se precisa para supervisión de servidores físicos o SIEM de seguridad.
José Andrade
Arquitecto de Sistemas Cloud y Modelador FinOpsFundador y Editor Principal en CloudBizStack. José está especializado en arquitecturas de observabilidad distribuida, pipelines de telemetría de alta cardinalidad con OpenTelemetry y modelos cuantitativos de coste total de propiedad (TCO) para infraestructura SaaS y cloud computing.