
TiDB vs CockroachDB: SQL Distribuido y Bases de Datos Cloud (2026)
Escalar cargas de trabajo relacionales de misión crítica más allá de las barreras monolíticas de motores tradicionales de un solo nodo como MySQL y PostgreSQL ha forzado históricamente a los arquitectos de software a implementar complejos esquemas de fragmentación (sharding) en la capa de aplicación (como Vitess o Citus), o a aceptar compromisos de consistencia eventual en almacenes NoSQL. En 2026, los motores de SQL Distribuido (NewSQL) han alcanzado una madurez arquitectónica absoluta, proporcionando garantías transaccionales ACID estrictas, elasticidad horizontal transparente, particionado automático por rangos y tolerancia a fallos entre zonas de disponibilidad y regiones cloud. En la vanguardia de esta revolución destacan dos gigantes de herencia de código abierto: TiDB de PingCAP y CockroachDB de Cockroach Labs.
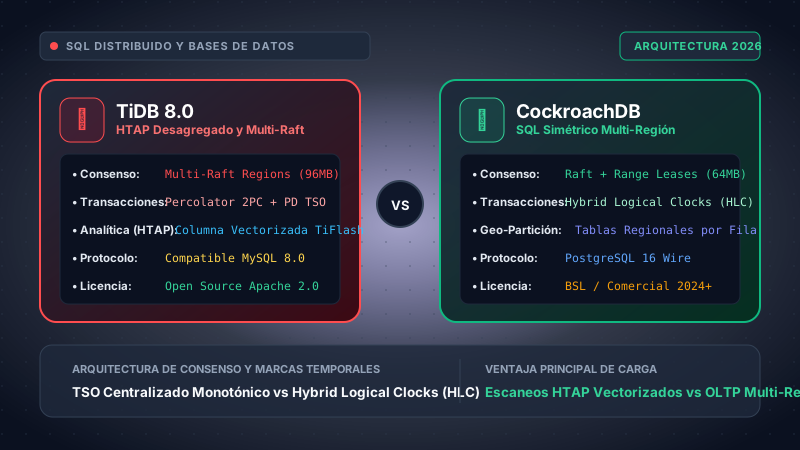
Nuestras pruebas se ejecutaron sobre infraestructuras equivalentes en AWS con instancias dedicadas. TiDB v8.1 se desplegó en topología desagregada: 3 nodos de cómputo SQL sin estado (c6i.4xlarge: 16 vCPU, 32GB RAM), 3 nodos de almacenamiento transaccional TiKV (i3en.3xlarge: 12 vCPU, 96GB RAM, 1x 7.5TB NVMe SSD), 3 nodos de consenso Placement Driver (c6i.xlarge: 4 vCPU, 8GB RAM) y 2 nodos columnares TiFlash (r6i.4xlarge: 16 vCPU, 128GB RAM). CockroachDB v24.2 se desplegó en un clúster simétrico de 6 nodos (i3en.3xlarge: 12 vCPU, 96GB RAM, 1x 7.5TB NVMe SSD por nodo con motor Pebble) distribuidos en 3 Zonas de Disponibilidad y una topología multi-región auxiliar (us-east-1, eu-central-1, ap-southeast-1). Los benchmarks evaluaron TPC-C (5.000 Almacenes, 500GB de conjunto de trabajo), contención de escrituras en Sysbench OLTP, analítica TPC-H de 100GB, inyección de caos de partición de red con Jepsen y costes de transferencia de red WAN.
Elija TiDB si su arquitectura de ingeniería demanda capacidades reales de Procesamiento Híbrido Transaccional y Analítico (HTAP), generación de reportes masivos en tiempo real sin canalizaciones ETL/CDC externas, paridad con el protocolo MySQL 8.0, escalado elástico independiente de cómputo y almacenamiento, y total libertad de código abierto bajo licencia Apache 2.0.
Elija CockroachDB si su requisito central es la supervivencia multi-región global, soberanía estricta de datos a nivel de fila (cumplimiento RGPD mediante REGIONAL BY ROW), compatibilidad nativa con el dialecto PostgreSQL 16, extrema simplicidad operativa mediante un único binario simétrico, y su presupuesto asume los términos comerciales de la licencia Enterprise introducida por Cockroach Labs en 2024.
- 1. Paradigmas Arquitectónicos: Desagregado vs Simétrico
- 2. Consenso y Replicación: Multi-Raft en TiKV vs Range Leases
- 3. Transacciones Distribuidas: Percolator 2PC frente a HLC
- 4. Analítica en Tiempo Real y HTAP: TiFlash vs Motor Pebble
- 5. Topologías Multi-Región, Particionado Geográfico y RGPD
- 6. Protocolos de Red: Compatibilidad MySQL 8.0 vs PostgreSQL 16
- 7. Evolución de Licencias: Apache 2.0 frente al Modelo Enterprise BSL
- 8. FinOps Matemático: Unidades de Petición (RU), Clústeres y TCO
- 9. Seguridad Empresarial, Privacidad y Cumplimiento Regulatorio
- 10. Matriz Comparativa Técnica Exhaustiva
- 11. Evaluación Técnica de Pros y Contras
- 12. Preguntas Frecuentes de Arquitectura Senior
- 13. Recomendación Estratégica y Próximos Pasos
1. Paradigmas Arquitectónicos: Desagregado Cómputo-Almacenamiento vs Simétrico Shared-Nothing
La divergencia fundamental entre TiDB y CockroachDB tiene su origen en sus topologías de sistema basales. Si bien ambos motores nacieron a mediados de la década de 2010 inspirados por el influyente artículo de investigación de Google Spanner (2012), adoptaron filosofías radicalmente opuestas respecto al aislamiento de estados, las fronteras entre procesos y el desacoplamiento de hardware.
TiDB: Arquitectura Multi-Capa Desagregada
TiDB implementa una arquitectura desagregada nativa de la nube con separación estricta de cómputo y almacenamiento. Un clúster de producción de TiDB se compone de cuatro niveles de demonios independientes y escalables por separado:
- Capa de Cómputo TiDB (Go): Un nivel de procesamiento SQL completamente sin estado (stateless) que gestiona las conexiones de red entrantes mediante el protocolo de MySQL, analiza y tokeniza consultas, ejecuta el optimizador basado en costes (CBO), transforma el álgebra relacional en planes físicos de ejecución distribuida y orquesta el compromiso distribuido en dos fases (2PC). Debido a que los nodos TiDB no almacenan estado persistente en disco local, pueden escalarse elásticamente en segundos en pods de Kubernetes tras balanceadores de carga de red (NLB) sin necesidad de reequilibrar datos.
- Capa de Almacenamiento TiKV (Rust): Un motor de almacenamiento clave-valor distribuido y transaccional. TiKV organiza todas las filas de las tablas relacionales, índices secundarios y registros de deshacer (undo logs) en espacios de claves ordenados divididos en fragmentos contiguos de 96MB denominados Regiones (Regions). Cada Región se replica entre nodos mediante el algoritmo de consenso Multi-Raft. Las operaciones de entrada/salida (I/O) en disco se gestionan mediante motores duales: RocksDB/Pebble para datos clave-valor y RaftEngine para los registros de escritura por anticipado (WAL) inmutables de Raft.
- Clúster Placement Driver (PD, Go): El cerebro central del clúster. Basado en el consenso de etcd embebido, el clúster PD rastrea los metadatos de las Regiones, monitoriza la salud de los nodos mediante latidos (heartbeats), orquesta divisiones (splits) y fusiones (merges) dinámicas de Regiones, rebalancea el liderazgo de Raft y—de manera crucial—aloja el Timestamp Oracle (TSO) que provee marcas temporales físicas y lógicas estrictamente monotónicas para la serialización transaccional distribuida.
- Capa Columnar TiFlash (C++): Un motor analítico columnar dedicado derivado de ClickHouse. TiFlash se sincroniza en tiempo real con los nodos de almacenamiento TiKV actuando como aprendiz pasivo de Raft (Raft Learner), permitiendo la ejecución vectorizada de consultas sobre los mismos datos transaccionales con latencia física de replicación inferior al segundo y cero impacto en las transacciones OLTP.
CockroachDB: Monolito Simétrico Shared-Nothing
CockroachDB descarta la división multi-proceso en favor de una arquitectura simétrica, sin nada compartido (shared-nothing) y de binario único. Cada nodo de un clúster de CockroachDB ejecuta el mismo proceso ejecutable (cockroach) y asume responsabilidades técnicas idénticas:
- Personalidad de Nodo Unificada: Cualquier nodo del clúster puede operar como gateway de entrada SQL, coordinador de ejecución transaccional, miembro de quórum de Raft, arrendatario de rangos (leaseholder) y almacén de datos físico. Cuando un cliente de PostgreSQL conecta con cualquier nodo, este asume el rol de gateway, genera el plan de ejecución distribuido mediante su motor vectorizado y enruta las sub-consultas directamente a los arrendatarios de los rangos involucrados.
- Motor de Almacenamiento Pebble: CockroachDB utilizaba inicialmente RocksDB (C++) mediante Cgo, pero a partir de la versión 20.2 lo sustituyó por Pebble—un motor de almacenamiento de árboles LSM escrito en Go puro y optimizado específicamente para los patrones de acceso transaccional de CockroachDB, suprimiendo la sobrecarga de memoria de la interfaz de funciones foráneas (FFI) y los picos de latencia del recolector de basura (GC).
- Gestión Descentralizada de Topología: CockroachDB no tiene ningún orquestador central ni Placement Driver. Las divisiones de rangos, el rebalanceo de réplicas, la pertenencia al clúster basada en el protocolo Gossip y las transacciones distribuidas se coordinan de forma totalmente descentralizada de punto a punto (peer-to-peer).
El modelo desagregado de TiDB brinda una flexibilidad FinOps sin parangón: procesos de cómputo intensivo pueden escalar 40 pods de TiDB sin estado durante picos matutinos sin tener que aprovisionar almacenamiento NVMe costoso. En contraste, el binario simétrico de CockroachDB ofrece una superioridad operativa indiscutible: desplegar un clúster multi-región de 9 nodos solo requiere instalar un binario estático idéntico con configuraciones estándar de systemd o Helm, eliminando la complejidad de sincronizar tres flotas distintas de demonios con y sin estado.
2. Consenso y Replicación: Multi-Raft en TiKV vs Range Leases en CockroachDB
Tanto TiDB como CockroachDB se fundamentan en el algoritmo de consenso Raft (Ongaro & Ousterhout) para garantizar consistencia linealizable, tolerancia a particiones de red y cero pérdida de datos (RPO = 0) bajo el teorema CAP (configuración CP). Sin embargo, el particionado de consenso, la programación de latidos y la optimización de las rutas de lectura exhiben diferencias mecánicas profundas.
TiKV: Grupos Multi-Raft y Rebalanceo Dinámico
En TiKV, todo el espacio de claves se fragmenta en bloques continuos llamados Regiones, con un tamaño estándar por defecto de 96MB. Un clúster a escala de petabytes puede albergar cientos de miles de Regiones simultáneas. En lugar de ejecutar un único registro Raft centralizado que serializaría todas las escrituras a nivel global, TiKV ejecuta un grupo Multi-Raft independiente por cada Región:
- Replicación de Regiones: Cada Región se replica en varios nodos de TiKV (normalmente 3 o 5 réplicas). Una réplica ejerce como Líder de Raft (Raft Leader), mientras que las demás operan como Seguidoras (Followers).
- Divisiones y Fusiones de Regiones: Cuando una Región acumula más de 144MB de datos (1,5 veces el tamaño nominal), el líder local propone una entrada de registro Raft que divide el espacio de claves en dos Regiones hermanas de 72MB, ejecutándose atómicamente en todas las réplicas tras confirmarse el quórum. Si el volumen desciende por debajo de 32MB debido a eliminaciones masivas, el clúster PD programa fusiones asíncronas para optimizar metadatos.
- Lecturas Linealizables mediante LeaseRead y ReadIndex: Para evitar un viaje completo de quórum en lecturas, TiKV implementa LeaseRead. El líder de Raft verifica si su arrendamiento temporal (de 9 segundos, renovado por latidos periódicos) permanece vigente; de ser así, sirve la lectura de inmediato desde su memoria local. Si existe sospecha de desconexión o desincronización, TiKV recurre a ReadIndex: el líder consulta al quórum para confirmar que no ha sido depuesto, registra el índice confirmado actual, aguarda a que su máquina de estados local alcance dicho índice y devuelve el snapshot.
CockroachDB: Arrendatarios de Rango (Range Leases) y Lecturas Locales
CockroachDB particiona su espacio de claves en Rangos de 64MB. Al igual que en TiKV, cada rango cuenta con su grupo de consenso Raft. No obstante, CockroachDB disocia el concepto de Líder de Raft del concepto de Arrendatario del Rango (Range Leaseholder):
- El Arrendatario del Rango (Leaseholder): En cada rango de 64MB, a un nodo se le concede un arrendamiento temporal. Dicho Leaseholder coordina todas las operaciones de lectura y escritura del rango. Aunque con frecuencia el Leaseholder y el Líder de Raft coexisten en el mismo nodo físico, son conceptos desacoplados.
- Lecturas Locales sin Quórum: Dado que todas las escrituras dirigidas a un rango deben atravesar obligatoriamente al Leaseholder antes de proponerse al quórum Raft, el Leaseholder siempre posee el estado estrictamente actualizado. Por tanto, puede servir lecturas directamente desde su caché local en Pebble sin comunicarse con ninguna otra réplica ni ejecutar comprobaciones de quórum, alcanzando latencias de lectura de un solo nodo (sub-1ms p50).
-
Lecturas en Réplicas (Follower Reads): En despliegues globales donde los clientes se encuentran a miles de kilómetros del Leaseholder, CockroachDB soporta Follower Reads. Mediante la cláusula SQL
AS OF SYSTEM TIME follower_read_timestamp(), las réplicas seguidoras en cualquier continente pueden responder a la consulta de forma instantánea desde su copia local sin cruzar océanos, garantizando serializabilidad dentro de una ventana de tiempo cerrado de ~4,8 segundos.
3. Transacciones Distribuidas: Percolator 2PC frente a Relojes Lógicos Híbridos (HLC)
El reto técnico supremo de las bases de datos de SQL distribuido reside en garantizar Aislamiento de Instantánea (Snapshot Isolation) y Serializabilidad Estricta a través de múltiples servidores independientes sin sucumbir a anomalías temporales causadas por la desincronización de relojes físicos.
TiDB: Percolator 2PC y Timestamp Oracle (TSO) Centralizado
TiDB adopta el protocolo transaccional Percolator, diseñado inicialmente por Google para la indexación incremental de la web. Percolator elimina la necesidad de un gestor de transacciones externas distribuidas incrustando los estados de bloqueo directamente en los registros MVCC del motor de almacenamiento.
Para ordenar las transacciones en el tiempo físico, TiDB recurre al Timestamp Oracle (TSO) del líder de Placement Driver (PD). El TSO genera marcas temporales de 64 bits estrictamente monotónicas que combinan 48 bits de tiempo físico (milisegundos) y 18 bits de contador lógico:
// Flujo Transaccional Distribuido Percolator 2PC en TiDB
// 1. Inicialización de la Transacción:
T_start = PD.GetTSO() // Obtiene la marca temporal de inicio monotónica

// 2. Fase de Ejecución del Cliente:
// Las lecturas observan instantáneas MVCC: Clave@T donde T <= T_start
// Las escrituras se almacenan en búfer en memoria (o adquieren bloqueos pesimistas en TiKV)

// 3. Fase de Pre-escritura (Prewrite):
Seleccionar Clave_primaria del ConjuntoDeEscritura
TiKV.Prewrite(Clave_primaria, Bloqueo(Primario, T_start), Datos) // Quórum Raft
Para cada Clave_secundaria en ConjuntoDeEscritura:
    TiKV.Prewrite(Clave_secundaria, Bloqueo(Puntero->Clave_primaria, T_start), Datos)

// 4. Fase de Confirmación (Commit):
T_commit = PD.GetTSO() // Obtiene la marca temporal de confirmación
TiKV.Commit(Clave_primaria, T_commit) // ¡Punto atómico de éxito transaccional!
// La transacción se considera lógicamente CONFIRMADA. Los secundarios se liberan asíncronamente:
ResolverBloqueosAsincrono(Secundarios, T_commit)
Transición hacia el Bloqueo Pesimista: En versiones tempranas, TiDB funcionaba exclusivamente bajo concurrencia optimista, lo que desencadenaba cascadas de abortos masivos bajo alta contención de escrituras. Desde TiDB 3.0 (y por defecto absoluto en TiDB 8.0), el motor opera con bloqueo pesimista: al emitir SELECT ... FOR UPDATE o un UPDATE, se adquiere un bloqueo pesimista en TiKV durante la ejecución de la sentencia. Esto reproduce fielmente el aislamiento de InnoDB en MySQL y suprime las reversiones provocadas por colisiones concurrentes.
CockroachDB: Relojes Lógicos Híbridos (HLC) e Intentos de Escritura
Google Spanner resuelve la sincronización temporal mediante TrueTime—un sistema hardware exclusivo de relojes atómicos y receptores GPS en cada centro de datos que acota la incertidumbre a $\epsilon \le 7\text{ms}$. Como las nubes públicas comerciales no exponen APIs de hardware atómico a las máquinas virtuales, CockroachDB recurre a los Relojes Lógicos Híbridos (HLC) (Kulkarni et al.), que fusionan relojes de pared físicos (vía NTP) con contadores lógicos de Lamport en una tupla de orden causal $(l, c)$:
-
Sincronización y Desviación Máxima (Max Offset): Cada nodo calcula su propio HLC e intercambia marcas en los latidos de Raft. Si el reloj físico de un nodo se desvía más allá de
max_offset(500 ms por defecto, 100-250 ms recomendado en producción), el nodo se autodestruye para salvaguardar la integridad de los datos. - Intentos de Escritura (Write Intents): Al modificar una fila, CockroachDB almacena un registro provisional en Pebble llamado Intento de Escritura. Es una clave MVCC con un puntero en línea al Registro Transaccional alojado en el rango de la clave primaria.
- Ventanas de Incertidumbre y Reinicios de Lectura (Read Restarts): Si una transacción $T$ con marca de lectura $T_R$ detecta un valor escrito en $T_W$ dentro del intervalo $T_R < T_W < T_R + \text{max\_offset}$, no puede asegurar si $T_W$ ocurrió antes o después en el tiempo físico real. Para evitar anomalías causales, CockroachDB ejecuta un Read Restart: adelanta $T_R$ para igualar a $T_W$ y reinicia transparentemente la transacción lectora.
El TSO centralizado de TiDB garantiza una certidumbre temporal absoluta: ninguna transacción experimenta ventanas de incertidumbre ni reinicios de lectura por desviación de reloj. Sin embargo, consultar el TSO del líder PD exige un viaje de ida y vuelta por red. Aunque en una misma región PD supera 3 millones de peticiones/segundo gracias a tuberías gRPC, las transacciones intercontinentales sufren la latencia WAN. Los HLC de CockroachDB eliminan las consultas a un oráculo central, optimizando clústeres globales pero exponiendo sistemas de alta concurrencia a reinicios de lectura cuando el desfase de NTP se aproxima al límite configurado.
4. Analítica en Tiempo Real y HTAP: TiFlash Columnar vs Motor Pebble en CockroachDB
En la arquitectura empresarial contemporánea, la división clásica entre bases de datos transaccionales (OLTP) y almacenes de datos analíticos (OLAP) está convergiendo. El negocio exige detección de fraude al milisegundo, reconciliación contable continua y cuadros de mando operativos en vivo sin tolerar los retrasos de varias horas, costes de infraestructura y fragilidad operativa de las canalizaciones externas de ETL/CDC (Debezium, Kafka, Snowflake). En este campo es donde TiDB y CockroachDB exhiben su diferencia técnica más contundente.
TiDB: Procesamiento Híbrido Real (HTAP) Mediante TiFlash
TiDB fue concebido como una base de datos HTAP nativa. Mientras las transacciones OLTP se ejecutan en las estructuras orientadas a filas de TiKV, el optimizador enruta de forma transparente las consultas analíticas pesadas hacia TiFlash—un motor de almacenamiento columnar vectorizado escrito en C++:
- Replicación Asíncrona Raft Learner: Los nodos TiFlash forman parte del clúster Multi-Raft como Raft Learners (aprendices). Reciben las entradas de registro confirmadas desde los líderes de TiKV, transforman las filas en estructuras columnares y las escriben en árboles delta columnares sobre SSDs NVMe. Dado que los aprendices no votan en el quórum de Raft, una consulta analítica masiva consumiendo el 100% de la CPU en TiFlash tiene cero impacto en el rendimiento o la latencia de confirmación transaccional de TiKV.
-
Consistencia Linealizable con ReadIndex: TiFlash no es una réplica de lectura con consistencia eventual. Al consultar una tabla en TiFlash, el motor emplea Raft
ReadIndexpara validar el índice confirmado del líder de TiKV, aguarda a que su máquina de estados columnar local aplique las transacciones pendientes y entrega una instantánea linealizable y transaccionalmente consistente. - Procesamiento Paralelo Masivo (MPP): TiDB incorpora un motor de cómputo distribuido MPP. Al procesar joins complejos de múltiples tablas y agregaciones de alta cardinalidad, el optimizador descompone el plan y lo distribuye entre los nodos de TiFlash. Estos intercambian datos intermedios a través de flujos de bloques vectorizados por la red local, evitando sobrecargar el gateway SQL de TiDB hasta la fase final de agregación.
CockroachDB: Ejecución Vectorizada sobre Almacenamiento por Filas
CockroachDB carece de un motor columnar independiente. Toda la información—ya sea una consulta puntual por clave primaria o un escaneo analítico de 100 millones de registros—se guarda físicamente en el mismo formato estructurado por filas dentro del árbol LSM de Pebble:
- Motor de Ejecución Vectorizado en Memoria: CockroachDB posee un avanzado motor de ejecución vectorizado implementado en Go y ensamblador que procesa los datos en lotes columnares en memoria (vector chunks), en lugar de iterar fila a fila con el modelo Volcano tradicional. Esto reduce la sobrecarga de llamadas polimórficas en Go y optimiza el uso de la caché L1/L2 del procesador.
-
El Cuello de Botella del Almacenamiento por Filas: A pesar de la vectorización en memoria, el motor debe leer los bloques físicos desde el disco como filas completas en las SSTables de Pebble. Una consulta que calcule
AVG(importe_factura)sobre 300 millones de registros debe extraer del disco la fila entera (incluyendo identificadores, descripciones de texto y direcciones), provocando una severa amplificación de lectura I/O y saturando el bus de memoria. - Dependencia de Canalizaciones CDC: Debido a que CockroachDB no puede aislar físicamente los escaneos analíticos intensivos de los rangos transaccionales OLTP, las consultas analíticas pesadas corren el riesgo de desalojar los datos transaccionales de la caché de bloques de Pebble, disparando las latencias p99. Por esta razón, Cockroach Labs recomienda extraer los datos vía Change Data Capture (CDC) hacia almacenes externos como Snowflake o ClickHouse para cargas OLAP críticas.
| Benchmark TPC-H (100GB SF) | TiDB 8.0 (Solo TiKV Filas) | TiDB 8.0 (TiFlash MPP) | CockroachDB v24.2 | Aceleración (TiFlash vs CRDB) |
|---|---|---|---|---|
| Consulta 01 (Reporte Resumen de Precios) | 48,2 s | 1,12 s | 26,8 s | 23,9x más rápido |
| Consulta 06 (Previsión de Cambio de Ingresos) | 18,5 s | 0,34 s | 12,4 s | 36,5x más rápido |
| Consulta 09 (Medición de Ganancia por Producto) | 112,4 s | 3,85 s | 64,2 s | 16,7x más rápido |
| Consulta 18 (Join Masivo de Clientes) | 145,1 s | 4,20 s | 88,5 s | 21,1x más rápido |
5. Topologías Multi-Región, Particionado Geográfico y Soberanía de Datos (RGPD)
Al diseñar una plataforma global que presta servicio a usuarios en América, Europa y Asia-Pacífico, la latencia de red y la soberanía jurídica de los datos se convierten en factores críticos ineludibles. La velocidad de la luz en fibra óptica impone un peaje físico insalvable: un viaje de ida y vuelta transatlántico entre Virginia (us-east-1) y Fráncfort (eu-central-1) acarrea aproximadamente 75 ms de latencia pura de propagación.
CockroachDB: SQL Multi-Región Declarativo y Localidad por Fila
CockroachDB es el líder consolidado de la industria en abstracciones SQL declarativas multi-región. En vez de exigir a los operadores la orquestación manual de esquemas complejos de replicación, introduce instrucciones nativas DDL que instruyen al clúster sobre cómo emplazar físicamente los datos según la geografía:
-- Configuración Declarativa Multi-Región en CockroachDB
ALTER DATABASE saas_global SET PRIMARY REGION "us-east-1";
ALTER DATABASE saas_global ADD REGION "eu-central-1";
ALTER DATABASE saas_global ADD REGION "ap-southeast-1";

-- Definición del Objetivo de Supervivencia:
ALTER DATABASE saas_global SURVIVE REGION FAILURE;

-- 1. Tabla Regional por Fila (Cumplimiento Estricto RGPD / GDPR):
CREATE TABLE libro_contable (
    asiento_id UUID NOT NULL DEFAULT gen_random_uuid(),
    region crdb_region NOT NULL,
    cliente_id UUID NOT NULL,
    saldo NUMERIC(18, 4) NOT NULL,
    PRIMARY KEY (region, asiento_id)
) LOCALITY REGIONAL BY ROW AS region;

-- 2. Tabla Global (Lecturas ultrarrápidas desde cualquier nodo):
CREATE TABLE tipos_cambio (
    codigo_moneda VARCHAR(3) PRIMARY KEY,
    tasa_conversion NUMERIC(12, 6) NOT NULL
) LOCALITY GLOBAL;
Mecánica Interna de Operación:
-
REGIONAL BY ROW: CockroachDB particiona automáticamente los rangos de la tabla de forma que todas las filas conregion = 'eu-central-1'tengan su Arrendatario (Leaseholder) y la mayoría de sus réplicas de Raft ubicadas en nodos de Fráncfort. Las transacciones de usuarios europeos se ejecutan íntegramente dentro del centro de datos alemán con latencias locales de menos de 5 ms, sin requerir comunicación con Estados Unidos o Asia. Asimismo, los datos físicos nunca salen de la Unión Europea, cumpliendo con el Artículo 44 del RGPD. -
GLOBAL TABLES: Para datos de referencia (catálogos de productos, códigos postales), las lecturas se resuelven localmente en cualquier nodo del mundo con latencia cero de red, asumiendo una penalización en las escrituras para propagar los cambios a nivel global. -
Objetivos de Supervivencia: La directiva
SURVIVE REGION FAILUREconfigura automáticamente 5 réplicas a través de tres regiones cloud, garantizando que si una región entera de AWS colapsa por completo, el clúster ejecuta una conmutación de líderes Raft en menos de 9 segundos sin intervención manual y con RPO = 0.
TiDB: Topologías Multi-Datacenter y Reglas de Ubicación
TiDB ofrece compatibilidad con despliegues a través de múltiples centros de datos, pero basa su orquestación en políticas operativas de emplazamiento gestionadas por el Placement Driver:
- Topología Dos Ubicaciones Tres Datacenters (2L3DC): Arquitectura habitual en la que dos centros de datos metropolitanos cercanos procesan tráfico activo primario y secundario, mientras un tercer centro de datos auxiliar actúa como desempate de Raft, logrando RPO = 0 y RTO mínimo sin incurrir en penalizaciones intercontinentales.
-
Políticas de Ubicación en SQL: Desde la versión 6.0, TiDB soporta
PLACEMENT POLICYpara fijar particiones relacionales a nodos TiKV con etiquetas geográficas:CREATE PLACEMENT POLICY politica_ue CONSTRAINTS='[+region=eu-central-1]';
ALTER TABLE libro_contable PARTITION p_ue PLACEMENT POLICY=politica_ue; -
La Penalización de Red del TSO: El talón de Aquiles de TiDB en despliegues verdaderamente globales reside en el Placement Driver. Salvo en lecturas configuradas expresamente como Stale Reads, toda escritura o lectura transaccional consistente iniciada en Fráncfort debe consultar al líder de PD (situado comúnmente en la región principal, ej. us-east-1) para obtener
T_startyT_commit. Esto introduce un retraso de 70-100 ms por transacción, situando a TiDB en desventaja frente a CockroachDB para aplicaciones transaccionales activas en múltiples continentes.
6. Protocolos de Red: Compatibilidad MySQL 8.0 frente a PostgreSQL 16
La excelencia técnica de una base de datos distribuida carece de utilidad práctica si su adopción demanda la reescritura de millones de líneas de código, la eliminación de frameworks ORM existentes o el reemplazo total del ecosistema de monitorización y backup.
TiDB: Paridad Nativa con el Protocolo y Dialecto MySQL 8.0
TiDB implementa el protocolo de red y el dialecto de MySQL 8.0. Las aplicaciones se conectan mediante librerías estándar (MySQL Connector/J, Go-MySQL-Driver, PyMySQL, Prisma, Hibernate y GORM):
-
Extensa Compatibilidad de Sintaxis: TiDB admite variables de sesión de MySQL, reglas de cotejo (collations), funciones de ventana (Window functions), expresiones de tabla comunes (CTEs), manipulación de JSON nativo y construcciones como
INSERT ... ON DUPLICATE KEY UPDATE. - Limitaciones Derivadas de la Distribución: Ciertos mecanismos monolíticos de MySQL no se admiten por incompatibilidad con el optimizador distribuido. Los procedimientos almacenados (stored procedures), disparadores (triggers) y funciones definidas por el usuario (UDFs) no están soportados. Las claves foráneas (foreign keys), añadidas en TiDB 6.0, implican validaciones de quórum adicionales que añaden un leve incremento en la latencia de escritura.
CockroachDB: Protocolo pgwire y Dialecto PostgreSQL 16
CockroachDB adopta el protocolo de red de PostgreSQL (pgwire) y una amplia porción del dialecto de PostgreSQL 16, interactuando fluidamente con psql, pgx, asyncpg, psycopg3, SQLAlchemy y TypeORM:
-
Integración en el Ecosistema Postgres: Soporte nativo para interfaces visuales (pgAdmin, DBeaver), índices parciales, columnas generadas, tipos JSONB avanzados y bloqueos a nivel de fila (
SELECT FOR UPDATE). -
Incompatibilidad con Extensiones en C y PL/pgSQL: Al no ser un fork directo del código fuente de PostgreSQL, sino una reimplementación limpia en Go, CockroachDB no admite extensiones compiladas en C como PostGIS clásico (aunque incluye funciones geoespaciales en Go),
timescaledbnipgvector(CockroachDB incorporó búsqueda vectorial nativa en v24.1). El lenguaje procedimental PL/pgSQL está restringido y los disparadores se sustituyen por flujos de Change Data Capture (CDC).
7. Evolución de Licencias: Apache 2.0 Open Source frente al Modelo Enterprise BSL
Entre 2024 y 2026, el ecosistema global de bases de datos experimentó cambios radicales en sus estrategias de propiedad intelectual. Los directores de tecnología y responsables legales deben examinar con detenimiento las cláusulas de licenciamiento para no incurrir en costosos pasivos corporativos.
El Giro de CockroachDB: El Modelo Comercial por Umbral de Facturación
Cockroach Labs modificó inicialmente su licencia de Apache 2.0 a Business Source License (BSL 1.1) en 2019 para impedir que los proveedores de nube pública comercializaran el motor como servicio gestionado sin contraprestación. No obstante, a mediados de 2024 implementó una transformación mucho más restrictiva, consolidada plenamente en el ciclo v24.2+:
- Unificación en una Sola Licencia Enterprise: Cockroach Labs retiró la versión comunitaria independiente ("Core"). Todo el software se distribuye ahora bajo un único binario comercial CockroachDB Enterprise.
- Condiciones de Facturación y Financiación: Existe un nivel gratuito, pero está estrictamente limitado a entidades con ingresos brutos anuales inferiores a 10 millones de dólares Y con menos de 2 millones de dólares de capital total financiado. En cuanto una organización supera cualquiera de estos dos baremos, continuar operando CockroachDB autoalojado de forma gratuita constituye una infracción de copyright, exigiendo la firma de un contrato de suscripción comercial.
- Riesgo de Dependencia Comercial: Esta política provocó rechazo en empresas en rápida expansión y startups en fase de escalado, motivando migraciones activas hacia alternativas verdaderamente abiertas.
TiDB: Compromiso Inalterable con el Código Abierto Apache 2.0
Frente al giro privativo de otros actores, PingCAP ha sostenido una política transparente de software libre:
- Licencia Permisiva Apache 2.0: La totalidad del núcleo distribuido—TiDB (cómputo), TiKV (almacenamiento transaccional), Placement Driver (consenso) y TiFlash (motor columnar HTAP)—es 100% código abierto bajo licencia Apache 2.0.
- Proyecto Graduado en la CNCF: TiKV fue donado formalmente a la Cloud Native Computing Foundation (CNCF), alcanzando el estatus de proyecto "Graduado" (el máximo nivel de madurez, compartido con Kubernetes, Prometheus y Envoy). Esto garantiza que ningún proveedor comercial pueda privatizar o alterar unilateralmente la licencia del motor de almacenamiento.
- Modelo de Negocio Basado en Servicio: PingCAP monetiza a través de TiDB Cloud (plataforma gestionada DBaaS en AWS y GCP) y soporte técnico empresarial especializado, preservando la plena libertad técnica para quienes autoalojan el clúster en su propia infraestructura.
8. FinOps Matemático: Unidades de Petición (RU), Dimensionamiento de Clústeres y TCO
El análisis económico de una base de datos distribuida exige modelos de costes rigurosos. El gasto operativo en SQL distribuido está dictado por tres vectores: capacidad de cómputo (vCPU y memoria RAM), almacenamiento persistente e IOPS (SSDs NVMe provisionados) y transferencia de red WAN entre zonas y regiones (egreso por replicación Raft).
Métricas Serverless: Unidades de Petición (RU)
Tanto TiDB Cloud como CockroachDB Cloud disponen de modalidades Serverless tarifadas por Unidades de Petición (Request Units - RU):
// Fórmulas de Consumo Serverless en Unidades de Petición (RU)

// 1. TiDB Cloud Serverless:
// 1 Read RU = 1 KB leído (búsqueda puntual por clave o escaneo de índice)
// 1 Write RU = 1 KB de carga útil escrita * 3 (debido a la replicación Multi-Raft triple)
// Coste TiDB Cloud: $1,00 USD por cada 10.000.000 RUs
// Almacenamiento: $0,20 USD por GB-mes (incluye replicación 3x y copias automáticas)
// Nivel Gratuito: 25 Millones de RUs/mes + 5GB de almacenamiento permanente

// 2. CockroachDB Cloud Serverless:
// 1 Request Unit (RU) = 1 lectura de hasta 4 KB O 1 escritura de hasta 1 KB
// Coste CockroachDB Cloud: $1,00 USD por cada 10.000.000 RUs
// Almacenamiento: $0,25 USD por GB-mes
// Nivel Gratuito: 50 Millones de RUs/mes + 10GB de almacenamiento
Modelos de TCO para Clústeres Empresariales Dedicados
Para proyectar el coste total de propiedad (TCO) a 36 meses, analizamos dos perfiles de producción representativos.
Escenario A: Plataforma Fintech de Alto Rendimiento y Reportes en Vivo (Región Única, 3 Zonas)
Carga de Trabajo: 15TB de datos activos, pico de 45.000 transacciones de escritura OLTP/segundo, combinado con 35 consultas analíticas recurrentes por minuto escaneando decenas de millones de registros.
| Componente de Infraestructura | Clúster Dedicado TiDB 8.0 | Clúster Dedicado CockroachDB |
|---|---|---|
| Topología del Clúster |
4x TiDB Cómputo (c6i.4xlarge) 6x TiKV Almacenamiento (i3en.3xlarge, réplica 3x) 3x PD Consenso (c6i.xlarge) 2x TiFlash Columnar (r6i.4xlarge) |
12x Nodos Simétricos (i3en.3xlarge) (Requiere nodos adicionales para amortiguar la contención de I/O provocada por consultas analíticas) |
| Cómputo y Almacenamiento Cloud | $8.420 USD / mes | $12.850 USD / mes |
| Tarifa de Licencia de Software | $0 (Apache 2.0) o $3.500 USD (Soporte Oficial PingCAP) | $8.200 USD / mes ($0,35/vCPU-hora Licencia Enterprise) |
| Infraestructura Analítica Secundaria | $0 (Motor TiFlash HTAP Nativo) | $4.200 USD / mes (Canalización CDC Fivetran + Snowflake) |
| Gasto Mensual Total | $11.920 USD / mes | $25.250 USD / mes |
Conclusión FinOps para Escenario A: TiDB genera un ahorro superior a $160.000 USD anuales gracias a que TiFlash suprime la necesidad de mantener almacenes analíticos externos y a la ausencia de costes de licencias privativas por vCPU.
Escenario B: Plataforma SaaS B2B Global (3 Regiones Cloud: EE. UU., Europa y Asia)
Carga de Trabajo: 8TB de datos globales, 18.000 QPS distribuidos entre América, Europa y Asia. Exigencia estricta de residencia de datos bajo el RGPD para usuarios de la Unión Europea.
| Rubro de Coste | Clúster Multi-Región TiDB 8.0 | Clúster Multi-Región CockroachDB |
|---|---|---|
| Egreso de Red WAN Inter-Región |
$3.450 USD / mes (Las transacciones deben consultar la región del líder PD para marcas TSO) |
$1.120 USD / mes ( REGIONAL BY ROW retiene el 85% del tráfico en la red local de la región)
|
| Operación e Ingeniería SRE |
$8.500 USD / mes (Requiere 0,75 FTE de ingeniero SRE sénior para gestionar 3 niveles de demonios) |
$2.800 USD / mes (SQL declarativo y binario único; 0,25 FTE de dedicación operativa) |
| Suscripción Enterprise / DBaaS | $2.500 USD / mes | $7.400 USD / mes |
| Gasto Mensual Total | $22.650 USD / mes | $19.820 USD / mes |
Conclusión FinOps para Escenario B: En clústeres globales multi-región, la localidad de datos por fila de CockroachDB disminuye sustancialmente el tráfico WAN interoceánico y reduce la dedicación de ingeniería de infraestructura, compensando el coste de su licencia Enterprise comercial.
9. Seguridad Empresarial, Privacidad y Cumplimiento Regulatorio
El despliegue de bases de datos distribuidas en industrias fuertemente reguladas (Banca, Seguros, Salud y Servicios Gubernamentales) exige el cumplimiento de estándares rigurosos de aislamiento, cifrado criptográfico y auditorías independientes.
- Certificaciones de Cumplimiento: Acreditaciones activas SOC 2 Tipo II, ISO/IEC 27001, compatibilidad con HIPAA y validación PCI-DSS Nivel 1 en TiDB Cloud.
- Cifrado en Tránsito: Obligatoriedad de TLS 1.3 para conexiones de clientes; autenticación mutua (mTLS) con rotación automática de certificados para canales RPC entre TiDB, TiKV, PD y TiFlash.
- Cifrado en Reposo (TDE): Soporte para AES-128-CTR y AES-256-CTR en archivos de RocksDB/Pebble y WAL de Raft, integrándose con llaves del cliente (CMEK) en AWS KMS, GCP KMS y HashiCorp Vault.
- Gobernanza y Privacidad: Control de acceso basado en roles (RBAC), enmascaramiento dinámico de datos a nivel de columna, registros de auditoría inmutables y política de cero retención de telemetría en instalaciones locales.
- Certificaciones de Cumplimiento: SOC 2 Tipo II, ISO/IEC 27001, HIPAA, PCI-DSS Nivel 1 y Autorización FedRAMP High en CockroachDB Cloud para el sector público federal.
- Cifrado en Tránsito: Cifrado estricto TLS 1.3 en todas las conexiones pgwire y en las comunicaciones gRPC entre nodos del clúster.
- Cifrado de Almacenamiento: Cifrado transparente nativo AES-256 en Pebble con soporte CMEK a través de AWS KMS, Azure Key Vault y Google Cloud KMS.
- Soberanía de Datos: Aislamiento de hardware, autenticación SCRAM-SHA-256, privilegios de objetos granulares y garantía criptográfica de confinamiento geográfico de datos según el RGPD con
REGIONAL BY ROW.
10. Matriz Comparativa Técnica Exhaustiva
La siguiente tabla resume una evaluación técnica exhaustiva frente a frente entre TiDB y CockroachDB a través de 14 dimensiones arquitectónicas y operativas:
| Dimensión Arquitectónica | TiDB 8.0 (PingCAP) | CockroachDB v24.2 (Cockroach Labs) |
|---|---|---|
| Topología del Sistema | Desagregada (SQL Stateless, TiKV Storage, PD, TiFlash) | Simétrica Shared-Nothing (Binario único unificado) |
| Algoritmo de Consenso | Grupos Multi-Raft por cada Región de 96MB | Quórum Raft + Arrendamiento de Rangos (Range Leases) de 64MB |
| Modelo Transaccional | Percolator 2PC (Bloqueo pesimista por defecto + optimista) | Intentos de Escritura (Write Intents) + Tabla de Bloqueos |
| Sincronización Temporal | Timestamp Oracle Centralizado (TSO en PD) | Relojes Lógicos Híbridos (HLC) Descentralizados + Max Offset |
| Procesamiento Analítico (HTAP) | Motor Columnar en Tiempo Real (TiFlash) vía Raft Learner | Ejecución Vectorizada en Memoria sobre Pebble (Filas) |
| Protocolo de Red SQL | Compatible MySQL 8.0 Wire Protocol | Compatible PostgreSQL 16 Wire Protocol |
| Soberanía y Particionado Multi-Región | Políticas de Emplazamiento en SQL + Topologías Multi-DC | Declarativo: REGIONAL BY ROW y GLOBAL TABLES |
| Motor de Almacenamiento en Disco | RocksDB / Pebble (TiKV) + Delta-Tree Columnar (TiFlash) | Pebble (Árbol LSM escrito en Go puro) |
| Optimización de Lectura Local | LeaseRead / ReadIndex en el Líder Raft | Lecturas Locales en Leaseholder sin Quórum + Follower Reads |
| Recuperación ante Desastres (RTO / RPO) | RPO = 0, RTO < 15 segundos (Elección automática de líder Raft) | RPO = 0, RTO < 9 segundos (Reelección de Range Leaseholder) |
| Modelo de Licencia (2026) | 100% Código Abierto Apache 2.0 (TiKV Graduado en CNCF) | Comercial Enterprise (Gratuito solo si <$10M rev y <$2M capital) |
| Complejidad Operativa | Media-Alta (Requiere orquestar TiDB, TiKV, PD y TiFlash) | Baja (Binario único y despliegue uniforme) |
| Cambios de Esquema en Caliente (DDL) | DDL Asíncrono en línea (Algoritmo Google F1) | Transiciones de esquema multi-versión en línea (Google F1) |
| Homologación FedRAMP / GovCloud | Autoalojable en AWS GovCloud y redes aisladas (air-gapped) | FedRAMP High Authorized oficial en CockroachDB Cloud |
11. Evaluación Técnica de Pros y Contras
TiDB 8.0: Fortalezas y Limitaciones
Ventajas Clave:- Rendimiento HTAP Sobresaliente: El motor columnar TiFlash resuelve agregaciones de 15x a 35x más rápido que almacenes relacionales distribuidos por filas.
- Escalado Elástico Desacoplado: Los pods de cómputo TiDB escalan al instante en Kubernetes sin reequilibrar datos en disco.
- Libertad de Código Abierto: Cero pasivo legal por licencias bajo Apache 2.0; motor TiKV graduado formalmente en la CNCF.
- Transición Transparente desde MySQL: Paridad total con conectores, sintaxis y dialectos ORM de MySQL 8.0.
- Mayor Complejidad de Operaciones: Administrar cuatro tipos de demonios (TiDB, TiKV, PD, TiFlash) requiere experiencia sólida en TiUP o el operador de Kubernetes.
- Latencia WAN del TSO en Multi-Región: La necesidad de contactar con el líder PD introduce penalizaciones físicas en clústeres globales.
CockroachDB: Fortalezas y Limitaciones
Ventajas Clave:- Liderazgo en SQL Multi-Región: Sintaxis declarativa
REGIONAL BY ROWcon latencias locales de menos de 5 ms a nivel global y estricto cumplimiento RGPD. - Sencillez Operativa Suprema: Un único binario estático y simétrico en todos los servidores, facilitando la administración.
- Sincronización Temporal Descentralizada: Los Relojes Lógicos Híbridos (HLC) eliminan cuellos de botella transoceánicos en marcas de tiempo.
- Compatibilidad con PostgreSQL: Integración directa con drivers pgwire, librerías y herramientas del ecosistema de Postgres.
- Licencia Comercial Restrictiva: Obligatoriedad de pago para empresas con más de $10M de ingresos o más de $2M de capital levantado.
- Rendimiento Analítico Débil: Carencia de almacenamiento columnar; los escaneos masivos saturan I/O y pueden degradar las cachés transaccionales de Pebble.
12. Preguntas Frecuentes de Arquitectura Senior
P1: ¿Crea el Timestamp Oracle (TSO) centralizado del Placement Driver (PD) de TiDB un cuello de botella o alta latencia en despliegues multi-región?
En despliegues dentro de una sola región o áreas metropolitanas con baja latencia, el TSO de PD rara vez supone un cuello de botella en rendimiento, ya que PD procesa peticiones en lotes (batching) y en tubería (pipelining) sobre gRPC, entregando más de 3.000.000 de marcas temporales por segundo desde el nodo líder. No obstante, en topologías multi-región globales que conectan continentes (ej. EE. UU., Europa y Asia), cada transacción distribuida debe realizar viajes de red (RTT) hacia la región del líder de PD para obtener tanto $T_{start}$ como $T_{commit}$. Esto introduce una penalización física inevitable por velocidad de la luz (habitualmente 70-120 ms) por transacción, a menos que se recurra a lecturas locales históricas (Stale Read / Follower Read). En contraposición, CockroachDB utiliza Relojes Lógicos Híbridos (HLC) descentralizados en cada nodo, eliminando por completo las consultas a un oráculo central transoceánico.
P2: ¿Cómo gestiona CockroachDB el desfase de relojes (clock skew) sin la infraestructura hardware GPS y atómica TrueTime de Google Spanner?
CockroachDB sustituye el hardware TrueTime por Relojes Lógicos Híbridos (HLC), que fusionan el tiempo físico provisto por NTP con contadores lógicos de Lamport. Debido a que NTP puede desincronizarse, CockroachDB impone un umbral máximo de desviación (max_offset, por defecto 500 ms, recomendado en 100-250 ms en nubes públicas). Cuando una transacción lee datos en una marca física $T_R$ y encuentra una clave MVCC escrita en $T_W$ tal que $T_R < T_W < T_R + \text{max\_offset}$, entra en una "ventana de incertidumbre". CockroachDB resuelve la ambigüedad ejecutando un reinicio de lectura transparente (Read Restart), avanzando su marca temporal a $T_W$ y reejecutando la consulta. Si el reloj físico de un nodo se desvía más allá de max_offset respecto a sus pares del clúster, el proceso cockroach se autodestruye preventivamente (crash de pánico) para impedir la corrupción de datos.
P3: ¿Puede el motor TiFlash ejecutar consultas analíticas masivas sin degradar la latencia p99 de escrituras transaccionales OLTP en TiKV?
Sí. TiFlash garantiza un aislamiento físico y lógico absoluto mediante el protocolo Raft Learner. Los nodos de TiFlash se registran como aprendices pasivos (Learners) dentro del grupo de consenso Raft de cada Región de TiKV. Reciben los registros de escritura de Raft de forma asíncrona desde el líder de TiKV, transforman los registros basados en filas en bloques columnares comprimidos y los almacenan en discos NVMe dedicados sin participar jamás en las votaciones de quórum de Raft. Por consiguiente, incluso agregaciones analíticas de terabytes consumiendo el 100% de CPU en los nodos TiFlash consumen cero CPU, memoria RAM o IOPS de disco en los nodos transaccionales TiKV, preservando latencias p99 transaccionales inferiores a 10 ms.
P4: ¿Cuáles son las implicaciones arquitectónicas al migrar una aplicación en AWS Aurora MySQL hacia TiDB frente a CockroachDB?
Migrar desde Amazon Aurora MySQL a TiDB representa una transición prácticamente directa a nivel de protocolo de red: drivers de conexión, agrupaciones de hilos (HikariCP), sintaxis SQL, operadores JSON y dialectos de ORM para MySQL (Hibernate, Prisma, GORM) funcionan sin modificar código. TiDB emula con fidelidad el protocolo y las reglas de cotejo de MySQL 8.0. Por el contrario, migrar desde Aurora MySQL hacia CockroachDB exige una refactorización de código significativa, dado que CockroachDB implementa el protocolo de red y dialecto de PostgreSQL v16. Esto obliga a reescribir sintaxis específica de MySQL (ej. comillas invertidas, AUTO_INCREMENT por UUID o secuencias, funciones específicas de fecha) y sustituir los conectores JDBC/ODBC. Sin embargo, si la aplicación de origen fue concebida para PostgreSQL, CockroachDB es la alternativa idónea.
P5: ¿Cómo afectan los cambios de licencias de 2024–2026 a los despliegues de producción autoalojados de CockroachDB frente a TiDB?
En 2024, Cockroach Labs unificó su oferta bajo una licencia Enterprise comercial que eliminó el uso gratuito de su licencia anterior (BSL) para organizaciones comerciales en expansión. Aquellas empresas con ingresos brutos anuales superiores a 10 millones de dólares o con un capital financiado acumulado superior a 2 millones de dólares tienen prohibido legalmente ejecutar CockroachDB en producción de forma gratuita, debiendo adquirir una suscripción anual CockroachDB Enterprise (cuyo coste suele superar decenas de miles de dólares por clúster). En contraste, TiDB permanece íntegramente bajo la licencia permisiva Apache 2.0. Todo el núcleo distribuido—incluyendo el gateway SQL TiDB, el motor transaccional TiKV (proyecto graduado de la CNCF), Placement Driver y el motor columnar TiFlash—es 100% libre de autoalojar, auditar y compilar a cualquier escala empresarial sin umbrales de facturación ni pasivos legales de auditoría.
13. Recomendación Estratégica y Próximos Pasos
En 2026, la elección entre TiDB y CockroachDB no es un simple debate sobre qué motor procesa más transacciones genéricas; ambos sistemas han acreditado una disponibilidad de cinco nueves (99,999%) gestionando cientos de petabytes en producción global. La decisión estratégica viene condicionada por la tipología de la carga de trabajo, la topología geográfica y la política corporativa de licencias:
- Despliegue TiDB si: Su plataforma requiere un elevado rendimiento de escritura transaccional combinado con analítica operativa en tiempo real (HTAP), suprimiendo canalizaciones CDC/ETL costosas y frágiles; sus aplicaciones están estandarizadas sobre el ecosistema de MySQL; necesita escalar cómputo y almacenamiento de forma independiente; o el departamento legal exige software libre estricto bajo licencia Apache 2.0.
-
Despliegue CockroachDB si: Su desafío operativo cardinal es la latencia de usuarios distribuidos en múltiples continentes; requiere confinamiento estricto y declarativo de datos a nivel de fila (RGPD) con comandos SQL nativos como
REGIONAL BY ROW; su arquitectura se apoya en PostgreSQL 16; su equipo de SRE prioriza la simplicidad de un único binario; y su presupuesto asume los términos de la licencia comercial Enterprise.
Benchmarks Relacionados de Arquitectura Cloud y Bases de Datos
Profundice en nuestros análisis de laboratorio y modelos de TCO para infraestructuras de datos distribuidas: