Guía de FinOps Cloud: Optimización de Costes en AWS, GCP y K8s (2026)
La era del gasto en la nube descontrolado y del crecimiento a fuerza bruta ha terminado definitivamente. En 2026, el liderazgo de ingeniería no se evalúa únicamente por la velocidad de despliegue, sino por la economía unitaria, la sostenibilidad de los márgenes brutos y la eficiencia de capital. A medida que la dispersión de microservicios, las canalizaciones de observabilidad de alta cardinalidad, el tráfico de red inter-AZ y los clústeres sobredimensionados de Kubernetes erosionan los presupuestos operativos, las organizaciones necesitan intervenciones arquitectónicas de raíz. Esta guía estratégica y técnica proporciona un marco definitivo de ingeniería para auditar, redimensionar, refactorizar y gobernar la infraestructura en AWS, Google Cloud Platform (GCP) y Kuberneteslogrando reducciones netas sostenidas de entre el 35% y el 48% sin comprometer la fiabilidad ni los acuerdos de nivel de servicio (SLAs) de latencia p99.
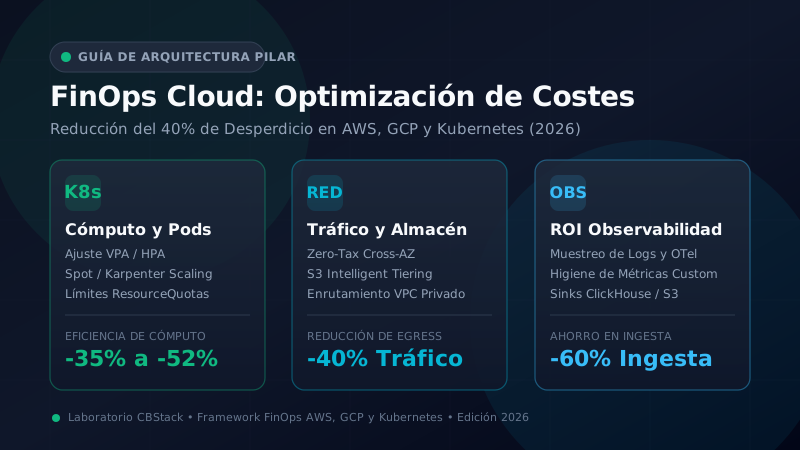
Nivel Inicial y Crecimiento ($10k$30k/mes de gasto): Concentrate sin contemplaciones en el desperdicio evidente. Apaga automáticamente los entornos de desarrollo y staging fuera de horario mediante crons de escalado a cero, convierte todos los volúmenes EBS gp2 antiguos a gp3 con scripts de Boto3 para un ahorro instantáneo del 20%, despliega S3 Gateway Endpoints (100% gratuitos) para eludir la tasa de $0.045/GB de los NAT Gateways, y compromete el 70% del cómputo base estático en Compute Savings Plans a 1 o 3 años. Ahorro proyectado inmediato: 32% al 38%.
Nivel Mid-Market SaaS ($50k$150k/mes de gasto): Moderniza la infraestructura de Kubernetes. Sustituye el viejo Cluster Autoscaler por Karpenter, habilitando empaquetado dinámico multiarquitectura en nodos Graviton c7g/m7g (ARM64) y orquestación agresiva de instancias Spot para pods sin estado con controladores de terminación ordenada. Despliega canalizaciones de filtrado en el borde (Vector u OpenTelemetry Collector) para suprimir health checks masivos antes de enviarlos a Datadog, recortando a la mitad la factura de observabilidad. Ahorro proyectado: 40% al 45%.
Nivel Enterprise & Scale-Up ($250k$1M+/mes de gasto): Aplica gobernanza de red y datos de gran escala. Implementa Kubernetes Topology-Aware Routing y redes eBPF con Cilium eBPF para erradicar más del 75% del tráfico cross-AZ ($0.02/GB ida y vuelta), reemplaza los enlaces de datos intensivos en Transit Gateway por Direct VPC Peering sin comisiones de procesamiento, desacopla la analítica histórica de logs hacia ClickHouse y Glacier Deep Archive, y automatiza la evaluación de costes en PRs mediante Infracost en CI/CD. Ahorro corporativo anual proyectado: $1.2M a $4.8M+.
Para organizaciones y empresas tecnológicas que gestionan infraestructuras cloud desde España, México, Colombia, Chile, Perú o Argentina, los costes de nube están fuertemente impactados por particularidades cambiarias, fiscales y regionales:
- Impuestos Digitales e IVA Transfronterizo: Los proveedores de nube y herramientas SaaS facturan sus servicios en dólares estadounidenses (USD) netos. En contrataciones directas, España aplica un 21% de IVA, México aplica el 16% de IVA y Chile y Colombia retienen el 19%, a menos que se cuente con estructura de inversión del sujeto pasivo o NIF-IVA intracomunitario.
- Retenciones en la Fuente por Pagos al Exterior: Países como Perú (retención del 30% por servicios digitales), Colombia (retención en la fuente de hasta el 20%) y Argentina (múltiples percepciones cambiarias y sobrecargos) gravan fuertemente los giros de divisas al exterior. Es esencial tramitar los certificados de residencia fiscal (W-8BEN-E) al amparo de convenios para evitar la doble tributación.
- Diferenciales Cambiarios (FX Spreads): Las líneas de crédito corporativas y tarjetas de empresa aplican recargos de conversión de moneda de entre el 1.5% y el 3.8% sobre el tipo de cambio interbancario oficial, encareciendo inadvertidamente cada dólar de gasto cloud.
- Sobrecoste de Regiones de Nube en LATAM: En regiones como AWS São Paulo (
sa-east-1) o las nuevas zonas de Google Cloud y Azure en Santiago de Chile y Querétaro (México), las tarifas de cómputo y transferencia cross-AZ son entre un 35% y un 65% más caras que enus-east-1(Norte de Virginia). La optimización de redes y el empaquetado de contenedores son aún más rentables en estas geografías. - Arbitraje de Costes de Ingeniería FinOps: Dedicar un equipo de ingeniería de plataformas en LATAM o España a optimizar infraestructura cloud genera un retorno sobre la inversión (ROI) colosal. Reducir $40.000 USD mensuales de factura cloud financia sobradamente el coste anual de múltiples ingenieros senior especializados.
Tabla de Contenidos
- 1. La Macroeconomía del Cloud en 2026
- 2. Las 4 Dimensiones del Desperdicio Cloud
- 3. Optimización de Cómputo en K8s y Karpenter
- 4. El Impuesto de Red Cross-AZ y Egress
- 5. FinOps en Almacenamiento: S3 y EBS gp3
- 6. FinOps en Observabilidad y Telemetría
- 7. Ingeniería de Descuentos por Compromiso
- 8. Panorama de Herramientas FinOps 2026
- 9. Sinergia Arquitectónica y Enlaces Cruzados
- 10. Modelos Matemáticos de TCO a 3 Años
- 11. Plan de Implementación en 90 Días
- 12. Gobernanza, Asignación y Cultura FinOps
- 13. Preguntas Frecuentes Técnicas (FAQ)
1. La Macroeconomía del Cloud en 2026: Por Qué la Economía Unitaria Sustituyó a la Expansación Bruta
Entre 2018 y 2022, el paradigma dominante en las empresas de software de alto crecimiento y en los programas corporativos de transformación digital fue la velocidad a cualquier precio. La infraestructura cloud se consideraba un recurso inagotable de elasticidad infinita donde el tiempo de salida al mercado eclipsaba por completo cualquier consideración de márgenes. Si una consulta de base de datos carecía de índices o un microservicio acumulaba fugas de memoria, la solución habitual era duplicar el tamaño de la instancia, escalando alegremente de una m5.xlarge a una m5.4xlarge.
En 2026, la realidad macroeconómica se ha invertido de manera radical. El encarecimiento del coste de capital, la disciplina de los mercados financieros y la contracción de los múltiples de valoración han obligado a directores financieros (CFOs) y vicepresidentes de ingeniería a fiscalizar el gasto en la nube como el mayor componente variable del coste de las ventas (COGS). Una empresa SaaS que opera con un 65% de margen bruto sufre un descuento severo de valoración frente a un competidor con un 82% de margen bruto sobre idéntico volumen de ingresos recurrentes (ARR).
Modelo Heredado Expansión Bruta (20182022)
- Crecimiento a toda costa; la nube vista como un gasto operativo ineludible.
- Sobreasignación de peticiones (requests) de CPU en pods del 300% al 500% por miedo a alertas nocturnas.
- Revisión pasiva de la factura mensual sin correlación con métricas de negocio.
- Ingesta desmedida de petabytes de registros JSON no comprimidos en plataformas SaaS de APM.
- Nula responsabilidad: Ausencia total de retroalimentación para desarrolladores al fusionar código.
Modelo Moderno Economía Unitaria (2026)
- Madurez FinOps: Alineación matemática entre finanzas, operaciones e ingeniería de plataformas.
- Empaquetado autónomo con Karpenter, procesadores ARM Graviton y orquestación de instancias Spot.
- Coste de infraestructura imputado directamente a unidades generadoras de ingresos.
- Canalizaciones de telemetría en el borde (Vector/OTel) enviando el 90% de los datos a S3 frío.
- Shift-left FinOps: Diferenciales automáticos de coste con Infracost bloqueando código costoso en CI/CD.
La Evolución del Marco FinOps Foundation
La FinOps Foundation define FinOps como la práctica cultural y operativa que maximiza el valor del negocio en la nube mediante decisiones respaldadas por datos y responsabilidad compartida entre finanzas, tecnología y negocio. Clásicamente estructurado en tres fasesInformar, Optimizar y Operarel estándar empresarial de 2026 ha dejado atrás las auditorías retrospectivas en hojas de cálculo para consolidar sistemas autónomos de bucle cerrado.
En organizaciones con alta madurez, la fase de información ya no depende de facturas PDF recibidas a mitad de mes. Motores de asignación en clúster como OpenCost y herramientas analizadas en nuestra comparativa Kubecost vs CAST AI consumen en tiempo real las APIs de facturación de AWS y GCP, imputando ciclos de CPU, gigabytes de memoria y tráfico de red a nivel de namespaces, StatefulSets e identificadores de clientes (tenants). La fase de optimización opera de manera continua: controladores de software modifican peticiones de recursos, adquieren compromisos y migran volúmenes en línea sin intervención humana.
Formulación Rigurosa de Economía Unitaria en la Nube
El error más peligroso de la gestión de infraestructura es vigilar el gasto agregado de forma aislada. Si la factura de una empresa pasa de $100.000 a $160.000 mensuales, la directiva suele alarmarse por un incremento del 60%. Sin embargo, si en ese mismo período el número de usuarios activos transaccionales creció un 250%, el coste por transacción se redujo en realidad un 43%. Por el contrario, una factura congelada en $80.000 mensuales representa un fracaso operativo estrepitoso si el volumen de clientes cayó a la mitad.
Toda organización técnica debe definir y monitorizar cuatro métricas maestras de economía unitaria:
Métrica 2: Coste Unitario por Cliente Activo Mensual ($/Tenant) U_{\text{Tenant}} = \frac{C_{\text{InfraDedicada}} + (C_{\text{InfraCompartida}} \times \omega_{\text{Ponderación}})}{N_{\text{ClientesActivos}}}
Métrica 3: Ratio del Impuesto de Telemetría y Observabilidad (Objetivo: < 8% a 10%) R_{\text{Observabilidad}} = \frac{C_{\text{Datadog}} + C_{\text{Dynatrace}} + C_{\text{CloudWatch}} + C_{\text{PrometheusManaged}}}{C_{\text{CómputoTotal}}} \times 100\%
El seguimiento del Ratio de Telemetría respecto al Cómputo es crucial. En auditorías reales sobre plataformas con facturas entre $50k y $200k mensuales, el coste conjunto de monitorización APM, trazas distribuidas y gestión de logs supera sistemáticamente el 25% del gasto en servidores EC2 o EKS. Cuando una empresa gasta $30.000 en máquinas virtuales y $12.000 en Datadog para monitorizar esas mismas máquinas, la observabilidad ha dejado de ser una garantía operativa para convertirse en una hemorragia de margen bruto.
El Triángulo Ejecutivo de Alineación FinOps
El éxito de una estrategia FinOps exige erradicar el histórico antagonismo entre el área de finanzas y los equipos de desarrollo. Los incentivos de las tres partes deben acoplarse con precisión:
- El Director Financiero (CFO): Exige previsiones de gasto operativo (OPEX) predecibles, eliminación de sorpresas en factura, amortizaciones transparentes y maximización de coberturas de descuento (Savings Plans y CUDs) para defender los márgenes brutos corporativos.
- El Vicepresidente de Ingeniería / Responsable de Plataforma: Exige proteger estrictamente los SLAs de latencia p99, garantizar cero caídas durante eventos de autoescalado, mantener alta velocidad de despliegue y evitar cargas burocráticas para los desarrolladores.
- El Arquitecto FinOps Principal: Actúa de puente entre el código y el balance contable. Traduce los compromisos financieros en políticas técnicas autónomas, construye cuadros de mando de coste unitario, impone higiene de etiquetado con Policy-as-Code y refactoriza la topología de red y cómputo.
2. Las 4 Dimensiones del Desperdicio Cloud: Anatomía de una Factura de $100.000/mes
Para desmontar de forma metódica el sobrecoste en la nube, los arquitectos de sistemas deben comprender dónde se fuga el capital. El desperdicio casi nunca procede de una única gran anomalía; es el resultado acumulativo de microineficiencias repartidas en cuatro vectores técnicos fundamentales: Cómputo Ocioso, Impuesto de Red Cross-AZ y Egress, Niveles de Almacenamiento Huérfano e Impuesto de Observabilidad.
Distribución del Desperdicio Estructural en una Factura Típica de $100.000/mes
Dimensión 1: Cómputo Ocioso y Sobredimensionado
El cómputo es el mayor concepto en cualquier factura de infraestructura, representando del 45% al 65% del total. El despilfarro en cómputo se manifiesta en tres fallas estructurales:
- La Brecha entre Asignación y Uso Real: Las auditorías revelan que la utilización media de CPU en clústeres de Kubernetes ronda un exiguo 12% a 18%, mientras la memoria permanece en torno al 35%. Los desarrolladores configuran peticiones (requests) de CPU desmesuradas (por ejemplo, pidiendo 4 vCPU y 8 GiB para un servicio que en picos máximos consume 350m vCPU y 1.2 GiB) para blindarse frente a desalojos. Dado que el planificador (kube-scheduler) vincula nodos basándose en las peticiones y no en el uso real, el clúster despliega decenas de servidores físicos innecesarios.
- Entornos Fantasma y Cargas Zombi: Entornos de desarrollo, control de calidad, integración y previsualizaciones de pull requests que se ejecutan las 24 horas del día, los 7 días de la semana. Un entorno de desarrollo se utiliza activamente sólo 45 de las 168 horas semanales. Mantener clústeres ociosos noches y fines de semana tira a la basura el 70% del gasto de desarrollo.
- Grupos de Nodos Homogéneos y Rígidos: El empleo de Auto Scaling Groups tradicionales basados en un único tipo de instancia (ej. exclusivamente
m6i.2xlarge), impidiendo que el clúster aproveche tipos más ágiles, procesadores ARM64 o instancias con descuento por ráfagas.
Dimensión 2: El Impuesto de Red Cross-AZ y Egress
Los proveedores presentan las arquitecturas multi-AZ como una buena práctica indiscutible de resiliencia. Lo que rara vez explicitan es que cada gigabyte transferido a través de una frontera de zona de disponibilidad se factura en ambos sentidos. En AWS, cruzar de zona cuesta $0.01/GB de salida más $0.01/GB de entrada, sumando $0.02 por GB ($20 por TB).
En un clúster desplegado en tres zonas (us-east-1a, 1b, 1c) con enrutamiento estándar round-robin de kube-proxy, cualquier comunicación entre dos pods tiene un 66.7% de probabilidad matemática de cruzar la frontera física de zona. En un sistema que genera 200 TB mensuales de tráfico interno entre microservicios y bases de datos, sólo el tráfico cross-AZ cuesta $2.680 al mes, a lo que se añade el peaje de NAT Gateways y Transit Gateways.
Dimensión 3: Almacenamiento Huérfano y Niveles Obsoletos
El despilfarro en almacenamiento tiene un carácter acumulativo, silencioso y perpetuo a menos que se elimine mediante automatización:
- Discos EBS Huérfanos: Al suprimir un nodo o un StatefulSet, los volúmenes EBS asociados suelen conservarse por la política por defecto de seguridad (
DeleteOnTermination = false). Cientos de volúmenes SSD quedan en estadoavailable, facturando íntegramente su capacidad aprovisionada ($0.08 a $0.10 por GB-mes) a perpetuidad. - Cadenas de Snapshots Abandonadas: Tareas programadas de copia de seguridad que crean snapshots diarios sin fijar políticas de caducidad. Copias generadas hace años de sistemas ya retirados siguen devengando costes mensuales en S3 ($0.05/GB-mes).
- Inercia con Volúmenes gp2: Mantener millones de gigabytes en discos EBS gp2 en lugar de convertirlos a gp3, perdiendo un 20% de descuento directo y acoplando artificialmente el rendimiento de IOPS a la capacidad en disco.
- Data Lakes en S3 sin Reglas de Ciclo de Vida: Almacenar petabytes de datos fríos y copias de bases de datos en S3 Standard ($0.023/GB) sin migrarlos a Glacier Flexible Archive ($0.0036/GB) o Glacier Deep Archive ($0.00099/GB).
Dimensión 4: El Impuesto de Observabilidad y Telemetría
Las plataformas comerciales de observabilidad cobran en base a la ingesta masiva de datos. Con el auge de los microservicios, el volumen de logs crece de forma cuadrática. Los desarrolladores emiten trazas de depuración en JSON, health checks masivos y métricas de Prometheus con etiquetas de alta cardinalidad (identificadores de usuario, UUIDs de transacción o IPs).
Facturar a razón de $0.10 a $0.50 por GB ingerido, $1.70 por millón de eventos indexados y $5.00 por cada 100 métricas personalizadas provoca que la factura de monitorización crezca a un ritmo descontrolado, superando en ocasiones el coste del propio software productivo.
3. Optimización del Cómputo en Kubernetes: Bin-Packing Autónomo, Autoescalado y Arquitectura de Silicio
Kubernetes se ha consolidado como el estándar operativo del cómputo moderno. Por tanto, lograr eficiencia en Kubernetes determina la salud financiera de toda la infraestructura cloud. Conseguir alta densidad requiere sustituir el aprovisionamiento manual por bin-packing autónomo, dimensionar correctamente los pods, escalar por eventos de negocio, orquestar instancias Spot con seguridad y migrar a silicio ARM64.
Peticiones vs. Límites de CPU: La Trampa de las Cuotas CFS
Uno de los errores conceptuales más extendidos en ingeniería de plataformas es cómo el kernel Linux gestiona las peticiones y límites de CPU en Kubernetes:
- CPU Requests: Se articulan a través del parámetro
cpu.sharesde los cgroups en Linux. Definen la prioridad relativa de planificación cuando la CPU está disputada. Fundamentalmente, el planificador (kube-scheduler) suma las peticiones (y no el uso real) para decidir si un pod cabe en un nodo. - CPU Limits: Se implementan con el Completely Fair Scheduler (CFS) bandwidth control mediante
cpu.cfs_quota_usycpu.cfs_period_us(por defecto 100ms). Si el límite es de 1 vCPU (1000m), el contenedor tiene derecho a 100ms de ejecución por cada ventana de 100ms.
Cuando aplicaciones multihilo (Java, Go, Node.js) reparten tareas concurrentes en 8 o 16 hilos del sistema operativo, pueden consumir su cuota asignada en los primeros 12 milisegundos de la ventana. El kernel Linux suspende forzosamente la ejecución durante los 88ms restantes. Este estrangulamiento (CFS CPU throttling) dispara la latencia p99 y provoca caídas por timeout a pesar de que el nodo tenga el 70% de la CPU física desocupada.
El Estándar FinOps Moderno para Diseño de Pods:
- Configura CPU Requests en base al consumo real p95/p99 histórico con un margen de seguridad del 20% al 30%.
- Elimina los CPU Limits en microservicios generales de aplicación o recurre a CFS Quota Bursting. Suprimir los límites permite aprovechar la CPU ociosa del servidor sin estrangulamientos artificiales de latencia.
- Define siempre límites de memoria estrictos e iguales a las peticiones (requests == limits). A diferencia de la CPU, la memoria no se puede estrangular. Cuando se agota, el OOMKiller liquida el proceso inmediatamente. Al fijar
requests.memory == limits.memory, el pod adquiere la clase de servicio Guaranteed QoS, protegiéndose de desalojos involuntarios.
Autoescalado Dirigido por Eventos de Negocio con KEDA
El Horizontal Pod Autoscaler (HPA) habitual escala por uso medio de CPU o Memoria. En sistemas dirigidos por eventos, la CPU es un indicador tardío. Para cuando los microservicios registran picos de CPU por una avalancha de mensajes en Kafka, la cola ya ha acumulado miles de operaciones pendientes.
KEDA (Kubernetes Event-driven Autoscaling) permite escalar pods desde cero hasta cientos de réplicas en función del retraso de consumo en Kafka, la profundidad de listas en Redis o los mensajes en Amazon SQS. Cuando las colas se vacían, KEDA repliega las cargas a cero o a una réplica mínima, eliminando el coste de servidores ociosos fuera de hora punta:
Karpenter vs. Cluster Autoscaler: La Revolución del Empaquetado
El upstream Cluster Autoscaler ha sido la norma durante años. No obstante, dependía rígidamente de los grupos de autoescalado (ASGs) del proveedor cloud: detectaba pods en espera y sumaba nodos idénticos de forma lenta (3 a 7 minutos de retardo) y con fragmentación insalvable de memoria y CPU.
Karpenter revoluciona el aprovisionamiento. Trabaja directamente con la API de flotas de AWS (EC2 Fleet API), evalúa las necesidades exactas de los pods pendientes, selecciona la instancia óptima entre más de 40 familias y levanta el nodo en menos de 45 segundos. Además, ejecuta consolidación continua (WhenEmptyOrUnderutilized): cuando detecta que los pods de dos nodos dispersos caben en uno más pequeño y barato, los migra en caliente y apaga los servidores sobrantes de inmediato:
Orquestación de Instancias Spot sin Caídas en Producción
Las instancias Spot ofrecen un 60% a 80% de descuento sobre las tarifas On-Demand. Su uso en producción con alta disponibilidad exige tres defensas sincronizadas:
- Gran Diversificación de Familias: Configurar Karpenter para alternar entre más de 25 tipos de instancia (mezclando c7g, m7g, r7g, c6g, c6i). La probabilidad de que AWS reclame simultáneamente todos los grupos de instancias en una zona es casi nula.
- Controladores de Terminación Ordenada: Capturar en tiempo real el aviso de interrupción de 2 minutos emitido por AWS vía EventBridge. Karpenter acorda el nodo, inicia el drenado de pods y aprovisiona el sustituto antes de que el servidor sea retirado.
- Presupuestos de Disrupción (PDBs): Obligar a cada microservicio a declarar un PodDisruptionBudget (
minAvailable: 80%), sumado a ganchospreStopy periodos de gracia de 60 segundos para cerrar conexiones activas.
Economía del Silicio ARM64: Migración a AWS Graviton
Las instancias equipadas con chips ARM Graviton3 y Graviton4 reducen directamente un 20% el coste horario y mejoran entre un 15% y un 25% el rendimiento computacional por vCPU frente a máquinas Intel o AMD equivalentes.
Generar contenedores compatibles es sumamente sencillo en CI/CD mediante Docker Buildx:
4. El Impuesto de Red Cross-AZ y Egress: Eliminando el Multiplicador Oculto
La transferencia de datos inter-AZ y el tráfico de salida (egress) son los conceptos más peligrosos de la factura cloud: crecen linealmente con el tráfico y carecen de cuotas fijas previsibles.
Análisis del Paquete en Tránsito: El Peaje de $0.02/GB
La comunicación entre zonas de disponibilidad de la misma región acarrea $0.01 por GB de salida y $0.01 por GB de entrada, totalizando $0.02 por GB ($20.48 por TB) ida y vuelta.
\text{Tráfico Cross-AZ sin optimizar (66.7\%): } 6 \text{ TB/hora cruzando fronteras de zona}
6 \text{ TB/h} \times 730 \text{ h/mes} \times \$20.48\text{/TB} = \mathbf{\$89.702,40 \text{ al mes en puro impuesto de red cross-AZ!}}
Kubernetes Topology-Aware Routing: Rescate del 80% del Gasto
Para cortar esta sangría, Kubernetes provee Topology-Aware Routing. Al activar la anotación service.kubernetes.io/topology-mode: Auto, el controlador de endpoints comprueba la distribución de pods y programa kube-proxy y motores CNI eBPF (Cilium eBPF) para enrutar el tráfico únicamente a pods situados en la misma zona de disponibilidad física del emisor, eliminando entre el 70% y el 85% del coste de red.
AWS Transit Gateway vs. Direct VPC Peering
AWS Transit Gateway (TGW) impone una tarifa horaria ($0.05/hora por VPC, ~$36.50/mes) más una tarifa de procesamiento de datos de $0.02 por GB. En cambio, Direct VPC Peering tiene coste cero de instalación y $0.00 por procesamiento de datos. Conectar los clústeres de alto tráfico (Kafka, analítica, bases de datos) mediante emparejamiento directo de VPC elimina íntegramente la tasa de procesamiento de Transit Gateway.
Bypass de NAT Gateway: Gateway VPC Endpoints Gratuitos para S3
El tráfico de subredes privadas hacia S3 y DynamoDB a través de NAT Gateway paga la tasa de $0.045 por GB procesado. Configurar un Gateway VPC Endpoint para Amazon S3 es 100% GRATUITO y deriva el tráfico directamente por la red interna de AWS, eliminando facturas de miles de dólares en descargas de imágenes o copias de seguridad:
Calcula tu TCO de Egress y Almacenamiento en Vivo: AWS S3 vs Cloudflare R2 vs Backblaze B2
¿Las comisiones de transferencia de datos salientes inflan tu factura mensual? Utiliza nuestra calculadora de TCO en producción para simular cargas de trabajo reales ajustando almacenamiento, ratio de lectura y peticiones API. Compara AWS S3, Cloudflare R2, Google Cloud Storage y Backblaze B2 con tarifas oficiales 2026.
5. FinOps en el Ciclo de Vida del Almacenamiento: S3, EBS y Archivo Frío
El gasto en almacenamiento en la nube presenta un perfil económico engañoso: aunque las tarifas por gigabyte aparentan ser insignificantes en las listas de precios (fracciones de centavo), la capacidad agregada crece de manera implacable. A diferencia de las instancias de cómputo, que pueden apagarse cuando desciende el tráfico, los lagos de datos sin gestionar, los snapshots de bases de datos y los volúmenes en bloque persisten indefinidamente.
El Espectro Económico de Niveles de Amazon S3
Amazon S3 ofrece siete clases de almacenamiento principales, cubriendo un diferencial de coste de 23 veces entre datos calientes transaccionales y archivos fríos de retención legal:
| Nivel de S3 | Coste de Almacén (us-east-1) | Coste de Recuperación / GB | Duración Mínima Facturable | Carga de Trabajo Ideal |
|---|---|---|---|---|
| S3 Standard | $0.0230 / GB-mes | $0.00 (Gratis) | Sin mínimo | Activos dinámicos, contenido web activo, datos menores a 30 días. |
| S3 Intelligent-Tiering | $0.0230 bajando a $0.0040 | $0.00 (Gratis) | 30 Días | Patrones de acceso impredecibles, analítica mixta (archivos > 128 KB). |
| S3 Standard-IA | $0.0125 / GB-mes | $0.0100 / GB | 30 Días | Copias de seguridad periódicas, recuperación ante desastres, informes mensuales. |
| S3 One Zone-IA | $0.0100 / GB-mes | $0.0100 / GB | 30 Días | Copias secundarias reproducibles, almacenamiento temporal de transcodificación. |
| S3 Glacier Instant Retrieval | $0.0040 / GB-mes | $0.0300 / GB | 90 Días | Imágenes médicas o archivos legales con necesidad de acceso en milisegundos. |
| S3 Glacier Flexible Archive | $0.0036 / GB-mes | $0.0100 / GB | 90 Días | Auditorías trimestrales, logs históricos (recuperación: 15 min a 5 horas). |
| S3 Glacier Deep Archive | $0.00099 / GB-mes | $0.0200 / GB | 180 Días | Retención regulatoria de 7 a 10 años, registros fiscales (recuperación: 12 horas). |
S3 Intelligent-Tiering: Cuándo Ahorra y Cuándo se Vuelve Ruinoso
S3 Intelligent-Tiering se comercializa como una solución mágica que traslada automáticamente los objetos entre niveles según su frecuencia de consulta. Sin embargo, encierra dos trampas económicas severas:
- La Tasa Mensual de Automatización ($0.0025 por cada 1.000 objetos): En buckets con 100 millones de objetos pequeños (miniaturas o eventos JSON de 20 KB), la tarifa de supervisión fija cuesta $250.00 mensuales con independencia de las consultas.
- El Límite Mínimo de 128 KB: Los objetos de tamaño inferior a 128 KB jamás se mueven a niveles infrecuentes; pagan permanentemente la tarifa completa de S3 Standard ($0.023/GB) más la tasa de supervisión.
Regla Arquitectónica: No actives Intelligent-Tiering para archivos pequeños. Agrúpalos previamente en ficheros compactados Parquet o Tar, o utiliza políticas deterministas de S3 Lifecycle hacia Glacier Flexible Archive pasados 90 días.
S3 Express One Zone: Cómputo de Inteligencia Artificial vs. Almacenamiento
Diseñado para cargas de baja latencia (entrenamiento de modelos de IA y GPU checkpoints), S3 Express One Zone almacena datos en un directorio de una única zona a $0.16 por GB-mes (casi 7 veces más caro que S3 Standard).
Sin embargo, su ventaja FinOps está en las peticiones API: las operaciones PUT, COPY, POST y LIST son un 50% más baratas ($0.0025 frente a $0.005 por 1.000 peticiones). En sistemas de procesamiento masivo con cientos de millones de llamadas diarias, el ahorro masivo en peticiones compensa con creces el sobrecoste de almacenamiento.
Migración Automatizada de EBS gp2 a gp3 en Producción
Los volúmenes gp2 acoplaban el rendimiento de IOPS a la capacidad (3 IOPS por GB). Para conseguir 3.000 IOPS, los ingenieros debían contratar un disco de 1.000 GB aunque la aplicación utilizase 40 GB.
Los discos gp3 brindan 3.000 IOPS y 125 MB/s de rendimiento base totalmente gratuitos a cualquier tamaño y reducen la tarifa de almacenamiento de $0.10/GB a $0.08/GB (un 20% de rebaja directa). AWS Elastic Block Store permite migrar volúmenes en línea con cero tiempo de inactividad:
Detección de Volúmenes Huérfanos y Limpieza de Snapshots
Los volúmenes EBS en estado available continúan devengando costes aunque no estén montados en ninguna máquina. Los equipos de ingeniería deben ejecutar revisiones automáticas periódicas:
6. FinOps en Observabilidad y Telemetría: Desacoplando Búsqueda en Caliente y Analítica Fría
La observabilidad se ha transformado en el tercer centro de coste en infraestructuras cloud-native, sólo por detrás de los servidores físicos y las bases de datos transaccionales. El "Impuesto de Observabilidad" se produce cuando la ingesta desordenada de logs, trazas y métricas crece a mayor velocidad que la facturación de la empresa.
Desacoplamiento con Vector u OpenTelemetry Collector
Las aplicaciones jamás deben emitir logs brutos directamente a las APIs comerciales de plataformas como Datadog o Dynatrace (Datadog vs Dynatrace). La solución radica en interponer una canalización en el borde con Vector o el OpenTelemetry Collector para:
- Descartar Health Checks: Suprimir logs de sondas
/healthzy/metrics, que suponen entre el 40% y el 60% del volumen total de registros en clústeres densos. - Sanitización y Filtrado: Eliminar trazas de depuración no deseadas en producción y ocultar datos sensibles.
- Muestreo Dinámico: Conservar el 100% de los errores 4xx y 5xx, muestreando sólo el 5% de las respuestas 200 satisfactorias:
Desacoplamiento de Búsqueda Caliente y Analítica Fría con ClickHouse
Indexar petabytes de texto en bruto en motores como Elasticsearch o Datadog durante un año entero genera costes insostenibles. Almacenar el 100% de los logs comprimidos con Zstandard (ZSTD) en Amazon S3 y consultarlos mediante bases de datos analíticas columnares de alto rendimiento como ClickHouse vs StarRocks o Amazon Athena, reduce el coste de retención a largo plazo en un 99.5%.
7. Ingeniería de Descuentos por Compromiso: Savings Plans, RIs y CUDs sin Bloqueo
Una vez erradicado el desperdicio estructural en cómputo, redes, almacenamiento y telemetría, las organizaciones desbloquean la palanca más potente de negociación con los proveedores cloud: los instrumentos de descuento por compromiso. Los proveedores intercambian rebajas de hasta el 72% a cambio de certidumbre contractual plurianual.
El Espectro de Compromisos en 2026
Los arquitectos cloud deben dominar las particularidades de cada figura contractual:
| Instrumento | Proveedor | Descuento Máx. | Flexibilidad entre Familias | Flexibilidad entre Regiones | Mercado Secundario |
|---|---|---|---|---|---|
| AWS Compute Savings Plans | AWS | Hasta el 66% | Total (EC2, Fargate, Lambda) | Total (Cualquier región) | No |
| AWS EC2 Instance Savings Plans | AWS | Hasta el 72% | Bloqueado a una familia (ej. c7g) | Bloqueado a una región | No |
| AWS Standard RIs | AWS | Hasta el 72% | Rígido a tipo de instancia | Bloqueado a una región | Sí (Mercado de RIs de AWS) |
| GCP Flexible CUDs | GCP | Hasta el 46% | Total en Compute Engine | Total entre regiones | No |
| GCP Resource-Based CUDs | GCP | Hasta el 57% | Bloqueado a familia de máquina | Bloqueado a una región | No |
La Estrategia de Cobertura Escalonada (Watermarking)
Para maximizar los descuentos sin arriesgarse a comprometer infraestructura que posteriormente se suprima, los equipos de FinOps aplican la Regla del 70/80:
\text{1. Base Mínima Continua (70% al 75%):} \quad \text{Cubierta por Compute Savings Plans a 3 Años (No-Upfront).}
\text{2. Crecimiento Predecible a Medio Plazo (10% al 15%):} \quad \text{Cubierto por Savings Plans a 1 Año.}
\text{3. Picos Elásticos y Procesos en Lote (10% al 20%):} \quad \text{Atendidos con Instancias Spot (60%-80% descuento) y On-Demand.}
Por qué los Compute Savings Plans superan a los EC2 Instance Savings Plans: Aunque los planes vinculados a una familia concreta de instancias ofrecen un 6% de descuento adicional aparente, impiden migrar de silicio. Si te comprometes rígidamente a instancias Intel m6i durante 3 años, renuncias a adoptar procesadores ARM Graviton3 (c7g/m7g), perdiendo el 20% al 35% de mejora directa en precio-rendimiento. Prioriza siempre Compute Savings Plans para preservar la agilidad técnica.
8. Panorama Exhaustivo de Herramientas FinOps: Auditoría Arquitectónica 2026
El ecosistema de gestión financiera de la nube se divide en cuatro categorías principales: asignación de costes en Kubernetes, plataformas autónomas de optimización, portales multicloud y gobernanza de código con políticas shift-left.
Asignación en Clúster Kubecost & OpenCost
Se despliegan dentro del clúster vía Helm. Cruza las métricas de cgroups de Prometheus con las listas de precios reales del proveedor para calcular el coste exacto por pod, etiqueta, volumen persistente y tráfico de red. OpenCost es la especificación abierta avalada por la CNCF.
Optimización Autónoma CAST AI
Un motor de automatización de bucle cerrado. Más allá de la observabilidad, ejecuta redimensionamiento dinámico de cargas, bin-packing continuo de nodos, conmutación por error garantizada ante interrupciones Spot y desfragmentación del clúster en tiempo real con cero intervención manual.
Portal Multicloud Vantage
Plataforma SaaS que unifica la facturación de AWS, GCP, Azure, Snowflake, Datadog y Kubernetes. Incorpora etiquetado virtual unificado, modelos de economía unitaria e informes ejecutivos de gobernanza financiera sin requerir agentes pesados en los nodos de producción.
Gobernanza Shift-Left Infracost
Se integra en los flujos de CI/CD (GitHub Actions, GitLab CI) para analizar planes de Terraform, OpenTofu y CloudFormation. Genera comentarios automáticos en cada Pull Request detallando el incremento o decremento exacto en dólares antes de aplicar los cambios en producción.
Matriz Comparativa de Herramientas FinOps (25 Filas)
| Herramienta | Categoría | Punto Fuerte Arquitectónico | Limitación Técnica | Modelo de Despliegue | Granularidad en K8s | Esquema de Precios | Perfil Empresarial Idóneo |
|---|---|---|---|---|---|---|---|
| Kubecost Enterprise | Asignación de Costes K8s | Atribución profunda por pod y namespace; seguimiento de tráfico de red; soporte multicloud y on-premise. | Requiere gestionar Prometheus; alto consumo de memoria en clústeres gigantes (>100k pods). | Agente en clúster (Helm) | Pod / Contenedor / Etiqueta | Suscripción mensual por nodo | Empresas con clústeres compartidos multicliente y entornos Kubernetes densos. |
| OpenCost (CNCF) | FinOps de Código Abierto | 100% neutral respecto a proveedores; ultraligero; sin exfiltración de datos a terceros; estándar CNCF. | Carece de cuadros de mando ejecutivos avanzados, previsiones y gestión de compromisos. | Autohospedado en clúster | Pod / Contenedor / Namespace | Gratuito / Open Source (Apache 2.0) | Equipos de ingeniería celosos de la soberanía de sus datos y telemetría interna. |
| CAST AI | Optimización Autónoma | Bin-packing automatizado en tiempo real; protección frente a interrupciones Spot; desfragmentación en vivo. | Exige permisos de administrador de clúster (webhooks mutadores); plano de control SaaS propietario. | Híbrido (Agente + Motor SaaS) | Cargas de trabajo y Nodos | % del ahorro neto certificado | Empresas SaaS en rápido crecimiento que buscan ahorros inmediatos sin contratar personal FinOps dedicado. |
| Vantage | SaaS FinOps Multicloud | Etiquetado virtual unificado; cruce de costes con Snowflake y Datadog; interfaz moderna e intuitiva. | Menor resolución a nivel de red del kernel que herramientas CNI eBPF dedicadas. | SaaS (APIs de sólo lectura) | Namespace / Etiqueta / Clúster | Escalonado por volumen cloud | Compañías tecnológicas operando en entornos híbridos (AWS + GCP) y almacenes de datos SaaS. |
| Infracost | Gobernanza Shift-Left IaC | Bloquea PRs costosas antes de la fusión; interpreta Terraform y Terragrunt; orientado al desarrollador. | No detecta desperdicio en tiempo de ejecución, servidores zombi ni volúmenes huérfanos. | Extensión para canalizaciones CI/CD | Recursos de IaC | Freemium / Por desarrollador | Organizaciones con cultura GitOps madura que gestionan toda la infraestructura como código. |
| AWS Cloud Intelligence Dashboards (CID) | BI Nativa en la Nube | Cero tarifas de licencias SaaS externas; se ejecuta en Athena y QuickSight; máxima fidelidad CUR 2.0. | Despliegue inicial laborioso con CloudFormation; exige mantener consultas SQL propias. | Cuenta nativa de AWS | Cuenta / Servicio / Etiqueta | Sólo consumo de Athena y QuickSight | Grandes corporaciones centradas en AWS que priorizan la soberanía absoluta de sus datos financieros. |
9. Sinergia Arquitectónica y Enlaces Cruzados Contextuales
FinOps no es un ejercicio contable aislado en un departamento financiero; es el reflejo económico directo de la arquitectura técnica. Cada decisión de infraestructura, desde la elección del plugin CNI de Kubernetes hasta el motor de caché o el plano de control IaC, incide de inmediato en los márgenes unitarios de la organización:
Redes eBPF: Cilium vs Calico
Como evaluamos en nuestro benchmark exhaustivo Cilium vs Calico, sustituir kube-proxy y las cadenas secuenciales de iptables por eBPF puro reduce la latencia entre pods un 40% y permite enrutar tráfico confinado a la zona de disponibilidad física local, eliminando cientos de miles de dólares en recargos de red cross-AZ.
Consolidación Multicliente: vCluster vs Namespaces
En nuestro análisis vCluster vs Kubernetes Namespaces, exploramos cómo ejecutar clústeres virtuales dentro de un clúster anfitrión compartido erradica las tarifas fijas del plano de control de EKS ($73/mes por clúster físico) y maximiza la densidad de empaquetado de hardware.
Almacenes Analíticos de Logs: ClickHouse vs StarRocks
Tal como documentamos en ClickHouse vs StarRocks, los motores columnares modernos proporcionan factores de compresión de entre 10:1 y 14:1 en registros de telemetría. Desacoplar la retención de Elasticsearch hacia ClickHouse y Amazon S3 recorta los costes de almacenamiento histórico en más del 90%.
Impuesto de Observabilidad: Datadog vs Dynatrace
Nuestra guía comparativa sobre Datadog vs Dynatrace expone los mecanismos de facturación por volumen que inflan las facturas de APM. Implementar Vector en el borde salvaguarda a la empresa frente a tarifas de ingesta abusivas.
Planos de Control Cloud: Crossplane vs Terraform
En Crossplane vs Terraform, comparamos la reconciliación continua frente a la detección de desviaciones estática. Crossplane permite exponer abstracciones de infraestructura autocontenidas y optimizadas para los desarrolladores directamente a través de la API de Kubernetes.
Caché Serverless en Memoria: Upstash vs Redis Cloud
Nuestro benchmark Upstash vs Redis Cloud contrasta modelos serverless de pago por petición con instancias tradicionales de memoria aprovisionada. Para cargas con picos erráticos, el pago por operación elimina por completo el coste de servidores inactivos.
Optimización K8s: Kubecost vs CAST AI
En Kubecost vs CAST AI, contrastamos la observabilidad pasiva de costes con el escalado autónomo guiado por inteligencia artificial. Mientras Kubecost destaca en la imputación y showback, CAST AI sobresale en el bin-packing automático en tiempo real.
FinOps en Almacenes de Datos: Snowflake vs Databricks
En Snowflake vs Databricks, desgranamos el consumo de créditos, la suspensión automática de almacenes y las arquitecturas lakehouse para optimizar canalizaciones de macrodatos multimillonarias.
10. Modelos Matemáticos de TCO a 3 Años: Escenarios para $25k, $100k y $500k/mes
Para justificar el tiempo de ingeniería necesario para acometer una transformación FinOps, los arquitectos de sistemas deben presentar modelos financieros rigurosos. A continuación se detallan tres escenarios empresariales concretos:
\text{Ahorro Neto Anual: } S_{\text{neto}} = \sum_{m=1}^{12} \left( C_{\text{sin\_optimizar}}^{(m)} - C_{\text{optimizado}}^{(m)} \right) - C_{\text{herramientas}} - C_{\text{ingeniería}}
\text{Valor Actual Neto (VAN): } \text{VAN} = \sum_{t=1}^{3} \frac{S_{\text{neto}}^{(t)}}{(1 + r)^t} - I_0, \quad \text{donde } r = 0.08 \text{ (tasa de descuento)}, \, I_0 = \text{inversión inicial}.
\text{Periodo de Retorno (Payback): } P = \frac{I_0 + C_{\text{herramientas}} + C_{\text{ingeniería}}}{\text{Ahorro Mensual Bruto}}
Escenario A: Startup SaaS en Crecimiento
- Nodos de EKS sobredimensionados en arquitectura x86.
- Buckets de S3 Standard sin ciclo de vida configurado.
- Discos EBS gp2 huérfanos tras borrar entornos de prueba.
- Todo el tráfico de S3 pasando por el costoso NAT Gateway.
Escenario B: Empresa Mid-Market SaaS
- Factura masiva de observabilidad en Datadog ($15k/mes).
- Fuerte tráfico de red inter-AZ no coordinado ($14k/mes).
- Nula adopción de Spot y escalado rígido tradicional.
- Cómputo On-Demand fragmentado sin Savings Plans.
Escenario C: Corporación Escala Enterprise
- Despliegue multiregión y multinube (AWS y Google Cloud).
- Tasas de procesamiento en Transit Gateway desorbitadas ($35k/mes).
- Lagos de datos en S3 Standard superando los 4 Petabytes.
- Límites de memoria desproporcionados causando desalojos continuos.
Tabla de Proyección Financiera a 3 Años: Escenario B ($100k/mes Mid-Market)
| Dimensión Financiera | Año 0 (Status Quo) | Año 1 (Despliegue) | Año 2 (Consolidación) | Año 3 (Autónomo) |
|---|---|---|---|---|
| Gasto Bruto de Infraestructura | $1.200.000 | $740.000 | $672.000 | $672.000 |
| Coste de Herramientas FinOps | $0 | $24.000 | $24.000 | $24.000 |
| Inversión de Ingeniería de Plataforma | $0 | $45.000 (Sprints Iniciales) | $15.000 (Mantenimiento) | $15.000 (Mantenimiento) |
| Gasto Operativo Neto (OpEx) | $1.200.000 | $809.000 | $711.000 | $711.000 |
| Ahorro Neto Anual de Caja | $0 | $391.000 | $489.000 | $489.000 |
| Ahorro Neto Acumulado a 3 Años | $0 | $391.000 | $880.000 | $1.369.000 (VAN: $1.215.400) |
11. Plan de Implementación en 90 Días para Reducción de Costes Cloud
Un proyecto de optimización de costes en la nube debe abordarse con una metodología estricta por etapas. Firmar compromisos plurianuales antes de depurar el cómputo genera capacidad ociosa atrapada, mientras que alterar el autoescalado sin presupuestos de disrupción provoca caídas del servicio.
Fase 1: Días 115 Descubrimiento, Limpieza y Huérfanos
- Activar AWS CUR 2.0 / GCP BigQuery Export: Ingestar datos detallados con etiquetas en Amazon Athena o BigQuery para trazabilidad total.
- Purgar Discos y Direcciones IP Huérfanas: Eliminar mediante scripts volúmenes EBS en estado
availablee IPs elásticas desvinculadas. - Limpiar Snapshots Antiguos: Definir ventanas de caducidad máxima de 90 días para copias de seguridad de EBS y RDS huérfanas.
- Apagado Programado de Staging: Instalar controladores de escalado a cero automático (como
kube-downscaler) fuera del horario laboral.
Fase 2: Días 1645 Modernización de Cómputo K8s
- Desplegar Karpenter y NodePools: Sustituir Auto Scaling Groups antiguos por Karpenter con consolidación continua habilitada.
- Calibrar Peticiones de Pods con VPA: Ajustar los CPU/Memory requests al consumo real p95 y eliminar límites rígidos de CPU.
- Orquestar Instancias Spot: Configurar PDBs, controladores de terminación de 2 minutos y diversificación en más de 25 familias.
- Migrar a Nodos Graviton3/4 (ARM64): Publicar imágenes Docker multiarquitectura y cosechar un 20% de rebaja directa en cómputo.
Fase 3: Días 4670 Impuesto de Red y Almacenamiento
- Desplegar S3 Gateway VPC Endpoints: Evitar la tasa de $0.045/GB de NAT Gateway enrutando S3 de forma privada y 100% gratuita.
- Habilitar Topology-Aware Routing: Marcar los Services con
service.kubernetes.io/topology-mode: Autopara suprimir el tráfico cross-AZ. - Conversión Masiva de EBS gp2 a gp3: Ejecutar scripts de Boto3 para transformar todos los volúmenes en caliente con un 20% de descuento.
- Políticas S3 Lifecycle: Programar transiciones a Glacier Flexible Archive pasados 90 días y a Deep Archive pasados 180 días.
Fase 4: Días 7190 Telemetría, Compromisos y CI/CD
- Instalar Vector u OpenTelemetry Collector: Suprimir logs de health checks HTTP y muestrear dinámicamente eventos de éxito.
- Limpiar Cardinalidad de Métricas: Sanitizar etiquetas de Prometheus para erradicar UUIDs e identificadores de usuario efímeros.
- Adquirir Compute Savings Plans: Asegurar el 70% al 75% del consumo basal continuo en planes a 3 años con máximo descuento.
- Integrar Infracost en CI/CD: Evaluar el impacto económico de cada Pull Request en GitHub Actions antes de desplegar.
12. Gobernanza, Asignación y Cultura FinOps Empresarial
La optimización de la nube sólo se mantiene si está respaldada por una cultura sólida y políticas como código. Sin disciplina de gobernanza, los clústeres vuelven a inflarse en cuestión de meses a medida que se entregan nuevas funcionalidades.
Evolución de Showback a Chargeback
En etapas iniciales, las compañías usan Showback (informar a los equipos de lo que han gastado). Sin embargo, el showback carece de consecuencias prácticas. La madurez exige pasar a un Chargeback real, donde los costes de infraestructura se descuentan del presupuesto operativo de cada área de producto y los costes compartidos se prorratean en función del uso relativo de CPU:
Higiene Obligatoria de Etiquetado con Kyverno
Intentar que los ingenieros etiqueten recursos manualmente a través de manuales en la wiki siempre fracasa. La asignación de costes debe blindarse en el plano de control mediante Kyverno o OPA Gatekeeper, rechazando automáticamente cualquier despliegue que carezca de etiquetas contables obligatorias:
13. Preguntas Frecuentes Técnicas (FAQ)
Respuestas técnicas a los dilemas arquitectónicos más comunes al desplegar programas de optimización FinOps en AWS, GCP y Kubernetes:
service.kubernetes.io/topology-mode: Auto) o enrutamiento eBPF con Cilium, el tráfico se confina estrictamente a pods en la misma zona de disponibilidad física del emisor, reduciendo el tráfico cross-AZ entre un 70% y un 85% sin degradar la alta disponibilidad.
WhenEmptyOrUnderutilized), vaciando nodos subutilizados y migrando dinámicamente las cargas hacia instancias más compactas y económicas.
cpu.cfs_quota_us y periodos de 100ms. Cuando una aplicación multihilo (Java, Go, Node.js) ejecuta ráfagas en paralelo, consume rápidamente su cuota en los primeros 15ms a 20ms del periodo. El kernel suspende forzosamente los hilos durante los 80ms restantes, provocando picos de latencia p99 y timeouts HTTP a pesar de que el nodo físico tenga 60% de CPU libre. Los ingenieros suelen interpretar este fenómeno como falta de recursos y sobredimensionan los nodos. El estándar FinOps moderno dicta eliminar los CPU limits en cargas generales y basar la planificación en CPU requests bien calibrados.
Calculadora Interactiva de TCO y ROI en FinOps Cloud
Calcula el impacto económico inmediato de aplicar empaquetado autónomo con Karpenter, migración a procesadores Graviton ARM64, eliminación de tráfico cross-AZ y gestión de Savings Plans: