Guía de Modern Data Stack: Lakehouses y OLAP en Tiempo Real (2026)
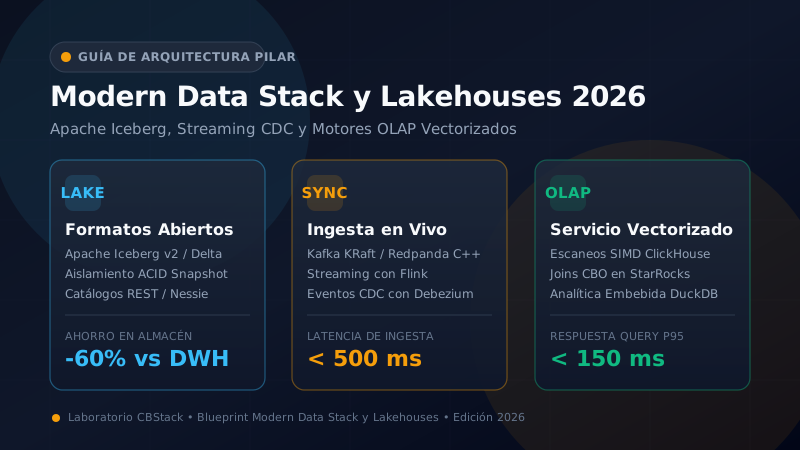
La tradicional dualidad entre lagos de datos (data lakes) lentos y económicos frente a almacenes de datos cloud (data warehouses) rígidos y sumamente costosos ha colapsado. En 2026, las arquitecturas de datos empresariales han convergido en el Lakehouse Abierto en Tiempo Real: formatos abiertos de tabla (Apache Iceberg, Delta Lake 3.x), catálogos de metadatos REST independientes de proveedor (Polaris, Nessie), ingestión continua por streaming CDC (Kafka KRaft, Redpanda, Flink), motores de consulta OLAP con vectorización SIMD (ClickHouse, StarRocks, DuckDB) y gobernanza métrica desacoplada mediante capas semánticas. Esta guía técnica exhaustiva proporciona a Chief Data Officers, Arquitectos Principales e Ingenieros de Plataforma el manual definitivo para desplegar arquitecturas analíticas a escala de petabytes, reduciendo el TCO de computación y almacenamiento entre un 52% y un 68%.
Nivel Early-Stage y Crecimiento (10TB–50TB de Huella Analítica / $5k–$25k/mes de gasto): No despliegues clústeres distribuidos sobre la JVM ni infraestructuras pesadas de Spark. Estandariza el almacenamiento físico en Apache Iceberg sobre almacenamiento de objetos económico (Amazon S3 Standard o Cloudflare R2 para eliminar costes de transferencia de salida). Utiliza analítica vectorizada en el propio proceso mediante DuckDB (o MotherDuck cloud) combinado con una instancia gestionada de ClickHouse Cloud para los cuadros de mando interactivos orientados a usuarios externos. Orquesta las transformaciones con dbt Core e ingesta registros de aplicaciones SaaS mediante herramientas ELT de código abierto (Airbyte Open Source vs Fivetran). Resultado inmediato: Consultas analíticas sub-segundo sin mantenimiento de servidores de computación y un 72% de ahorro frente a Snowflake/BigQuery.
Nivel Mid-Market SaaS (50TB–250TB de Huella Analítica / $25k–$100k/mes de gasto): Erradica por completo los retrasos de los procesos ETL nocturnos. Despliega una infraestructura de eventos en streaming en tiempo real basada en Redpanda C++ o Apache Kafka KRaft (Benchmark Redpanda vs Kafka) con Apache Flink para procesamiento de flujos con estado e ingestión directa de CDC (Debezium/PeerDB) hacia tablas Iceberg con Merge-on-Read (MOR). Gestiona la ramificación y el aislamiento de entornos mediante Project Nessie o Apache Polaris. Atiende consultas analíticas complejas con StarRocks C++ MPP (Benchmark ClickHouse vs StarRocks) ejecutando joins vectorizados directamente sobre el modelo dimensional del Lakehouse. Desacopla la lógica de negocio mediante una capa semántica centralizada (Cube o dbt Semantic Layer / MetricFlow). Resultado proyectado: Latencias P99 inferiores a 250ms con un TCO un 58% menor que los data warehouses tradicionales.
Nivel Enterprise y Gran Escala (500TB–10PB+ de Huella Analítica / $100k–$500k+/mes de gasto): Implementa una malla de Lakehouse abierta federada y multi-motor. Exige el cumplimiento del estándar OpenAPI de Catálogo REST de Apache Iceberg en todas las regiones y nubes (AWS, Azure, GCP). Ingesta eventos con intervalos de confirmación sub-segundo, programando rutinas automáticas de compactación de archivos (rewrite_data_files) y expiración de instantáneas. Emplea Trino para SQL federado masivo y exploración ad-hoc, Apache Spark / Databricks Photon para procesamiento de Machine Learning por lotes (Benchmark Snowflake vs Databricks), y StarRocks / ClickHouse para las APIs analíticas externas. Aplica Contratos de Datos estrictos en CI/CD (Protobuf/Avro, Soda Core), linaje a nivel de columna con OpenLineage / DataHub y control de acceso RBAC granular con Apache Ranger. Ahorro empresarial proyectado a 3 años: De $2.8M a $7.4M mediante la eliminación de sobrecostes propietarios de almacenamiento y computación.
Impacto Fiscal, IVA Digital y Retenciones en la Fuente: Las plataformas gestionadas de datos en la nube (Snowflake, Databricks, Confluent Cloud, ClickHouse Cloud, Fivetran) facturan habitualmente en dólares estadounidenses (USD) desde subsidiarias en EE.UU. o Irlanda. En España y la Unión Europea, las empresas deben aplicar el 21% de IVA bajo el mecanismo de inversión del sujeto pasivo intracomunitario (comprobando la validez en el censo VIES). En Latinoamérica, las organizaciones deben provisionar los impuestos sobre servicios digitales extranjeros y retenciones en la fuente: 16% de IVA en México (con retención del impuesto si el proveedor no está registrado en el SAT), 19% de IVA en Colombia (sumado a la retención por servicios técnicos internacionales del 20% si no aplica un convenio de doble imposición), 19% de IVA a plataformas digitales en Chile, y en Argentina el complejo esquema cambiario con impuestos sobre compras al exterior y restricciones en el acceso al mercado de divisas.
Volatilidad Cambiaria y Riesgo de Facturación en USD: Operar almacenes de datos propietarios cuyos modelos de precios cobran créditos por segundo de computación en USD introduce un riesgo cambiario (FX risk) permanente en los presupuestos de ingeniería de datos. Una devaluación del 15% al 25% en el peso mexicano, colombiano o chileno encarece drásticamente las facturas de Snowflake o BigQuery sin que el volumen de consultas haya variado. La adopción de un Lakehouse Abierto basado en Apache Iceberg sobre Amazon S3 o Cloudflare R2 reduce de forma estructural el coste de infraestructura entre un 55% y un 68%, atenuando radicalmente la exposición cambiaria de la compañía.
Arbitraje de Costes de Ingeniería de Datos en España y LATAM: Frente a los costes de personal en San Francisco o Londres (donde un Staff Data Architect supera los $280,000–$350,000 USD anuales), las empresas con centros de excelencia de datos en Madrid, Barcelona, Bogotá, Ciudad de México, Buenos Aires o Santiago pueden contratar ingenieros senior de plataformas de datos y arquitectos de Lakehouse con salarios altamente competitivos de $45,000 a $85,000 USD anuales. Esto representa una ventaja de arbitraje de costes del 50% al 65%, permitiendo a las organizaciones hispanohablantes implementar y mantener arquitecturas de Lakehouse de vanguardia basadas en código abierto (Iceberg, StarRocks, Redpanda, dbt, Nessie) con una rentabilidad de TCO sustancialmente superior.
Tabla de Contenidos
- 1. La Gran Convergencia de Datos de 2026
- 2. La Batalla de Formatos Abiertos: Iceberg vs Delta vs Hudi
- 3. El Plano de Control de Metadatos y Catálogos REST
- 4. Ingestión en Tiempo Real y Streaming CDC
- 5. Motores OLAP Vectorizados: ClickHouse vs StarRocks vs DuckDB
- 6. La Capa Semántica y Gobernanza de Métricas
- 7. Contratos de Datos y Calidad Shift-Left
- 8. Economía FinOps de Almacenamiento y Optimización Parquet
- 9. Matriz Comparativa Empresarial de 25 Criterios
- 10. Sinergia de Benchmarks y Navegación Contextual
- 11. Gobernanza, Linaje de Columna y Cumplimiento RGPD
- 12. Modelos Matemáticos de TCO a 3 Años (10TB, 100TB, 1PB)
- 13. Playbook de Migración al Lakehouse en 90 Días
- 14. Modelo Operativo, Data Mesh y KPIs Operativos
- 15. Preguntas Frecuentes Técnicas (FAQ)
1. La Gran Convergencia de Datos de 2026: Por Qué Colapsó la Dualidad entre Data Lake y Data Warehouse
Durante más de una década, la arquitectura de datos empresarial estuvo supeditada a una dicotomía costosa e ineficiente: la arquitectura de datos en dos niveles. Bajo este esquema heredado, las organizaciones mantenían dos infraestructuras completamente aisladas. Por un lado se encontraba el Data Lake, desplegado sobre almacenamiento de objetos barato como Amazon S3, Azure Data Lake Storage (ADLS) o Google Cloud Storage, repleto de volcados desestructurados en formatos Parquet, ORC o CSV. El lago de datos ofrecía una escalabilidad prácticamente infinita y una economía de almacenamiento inigualable ($0.023 por GB-mes), pero adolecía de graves deficiencias operativas: ausencia de transacciones ACID atómicas, frecuentes corrupciones por escrituras parciales fallidas, imposibilidad de realizar mutaciones a nivel de fila, carencia de esquemas forzados y una brutal lentitud en la planificación de consultas provocada por las llamadas recursivas LIST en la API de los sistemas de almacenamiento de objetos.
En el extremo opuesto operaba el Data Warehouse Cloud propietario (Snowflake, Google BigQuery, AWS Redshift). Los almacenes ofrecían una ejecución SQL de alto rendimiento, sólidas garantías de aislamiento transaccional, gobernanza centralizada y optimización automática. No obstante, estas ventajas exigían una hipoteca arquitectónica insostenible: formatos propietarios de micro-particionado que bloqueaban los datos en el motor de computación del proveedor, tarifas de computación desorbitadas ($2.00 a más de $4.00 por crédito de computación), continua duplicación de datos mediante frágiles pipelines ETL/ELT nocturnos y elevadas tarifas de transferencia de salida (data egress) cada vez que se requería entrenar modelos externos de Machine Learning.
Modelo Obsoleto Arquitectura en Dos Niveles (Lake + DWH)
- Coste de Almacenamiento Duplicado: Los datos se almacenan dos veces: primero en S3 como Parquet crudo y luego en formatos propietarios del DWH con recargos del 300%.
- Pipelines ETL Frágiles: Fuerte dependencia de procesos nocturnos por lotes (Airflow, scripts en Python) generando entre 12 y 24 horas de desfase en la información.
- Bloqueo de Computación: Los datos del warehouse no pueden ser leídos por motores externos sin pagar computación o costes de extracción al proveedor.
- Gobernanza Fragmentada: Las políticas de seguridad y enmascaramiento se definen por separado en los roles de IAM de la nube y en el RBAC del warehouse.
- Conflictos de Escritura y Corrupción: Escritores concurrentes sobrescriben particiones o dejan archivos huérfanos sin confirmar en el almacenamiento de objetos.
Modelo Moderno Lakehouse Unificado en Tiempo Real (2026)
- Única Fuente de la Verdad: Los datos físicos se almacenan una sola vez en archivos Parquet abiertos gobernados por formatos estándar (Iceberg / Delta Lake).
- Interoperabilidad Multi-Motor: Consulta la misma tabla de forma concurrente desde Trino (SQL masivo), Spark (ML/ETL), ClickHouse/StarRocks (servicio) y DuckDB (exploración).
- Streaming Continuo en Tiempo Real: Ingestión de CDC y eventos confirmando micro-lotes cada 500ms directamente sobre el almacenamiento de objetos.
- Catálogos de Metadatos REST Abiertos: Estándares de catálogo abiertos (Polaris, Nessie) que ofrecen ramificación tipo Git y gobernanza global de accesos.
- Reducción de TCO del 50% al 68%: Elimina por completo los sobrecostes de computación propietaria y los pipelines de duplicación de datos.
Los Tres Catalizadores Tecnológicos de la Convergencia
Entre 2023 y 2026, tres hitos de ingeniería pulverizaron la necesidad arquitectónica de mantener almacenes de datos propietarios aislados:
-
Formatos de Tabla Abiertos con Aislamiento Transaccional ACID Completo: Especificaciones como Apache Iceberg, Delta Lake 3.x y Apache Hudi introdujeron capas jerárquicas de metadatos que proporcionan semántica transaccional ACID de base de datos, aislamiento de instantáneas serializable, evolución oculta de particiones y eliminaciones a nivel de fila mediante Merge-on-Read (MOR) sobre almacenamiento de objetos ordinario. Los motores de consulta ya no ejecutan costosas llamadas
LISTa la API de S3; el estado de la tabla se determina de forma matemática a partir de archivos manifiesto Avro y JSON. - Motores de Consulta Vectorizados con SIMD y MPP en C++: Motores de ejecución reconstruidos íntegramente en C++ nativo y Rust (ClickHouse, StarRocks, Databricks Photon, DuckDB) explotan registros vectoriales SIMD (AVX-512 y ARM Neon). Estos motores filtran, proyectan y agregan columnas Parquet a velocidades limitadas únicamente por el ancho de banda del bus de memoria física, cerrando definitivamente la brecha de rendimiento entre el almacenamiento abierto y los almacenes propietarios.
- Catálogos de Metadatos Desacoplados (Estándar OpenAPI REST Catalog): La consolidación del estándar OpenAPI de Catálogo REST de Apache Iceberg y la liberación de catálogos abiertos como Apache Polaris y Project Nessie desmantelaron el monopolio de metadatos de los proveedores cloud. Una empresa ya no depende del catálogo cerrado de Snowflake ni de AWS Glue; cualquier motor certificado puede leer, ramificar y confirmar transacciones en el catálogo corporativo mediante interfaces HTTP abiertas.
La consecuencia directa de estos avances es el Lakehouse Abierto en Tiempo Real: un estado de madurez donde la frescura de los datos se mide en segundos, el almacenamiento físico es 100% propiedad de la empresa bajo estándares abiertos, y los motores de computación pueden intercambiarse o escalarse libremente en función de las necesidades de latencia y la optimización de costes.
2. La Batalla de Formatos Abiertos: Apache Iceberg v2 vs Delta Lake 3.x vs Apache Hudi
En la base de cualquier Lakehouse moderno reside el formato abierto de tabla. Un formato de tabla no es un formato de archivo; mientras que los bloques de datos físicos continúan almacenándose en archivos estándar como Apache Parquet, ORC o Avro, el formato de tabla constituye la capa de abstracción de metadatos que determina cómo múltiples archivos de datos, vectores de borrado, esquemas tipados y límites de partición representan una única tabla transaccional. En 2026, tres especificaciones lideran el panorama corporativo: Apache Iceberg, Delta Lake y Apache Hudi.
Anatomía del Árbol de Metadatos: Iceberg vs Delta Lake
La discrepancia arquitectónica esencial entre Iceberg y Delta Lake radica en cómo estructuran sus metadatos:
-
Apache Iceberg (Árbol Jerárquico de Instantáneas): Iceberg estructura los metadatos como un árbol jerárquico inmutable. En la raíz se ubica el Puntero del Catálogo, que apunta al URI del archivo de metadatos activo
vN.metadata.json. Este archivo contiene el esquema, las especificaciones de partición y una lista de todas las Instantáneas (Snapshots) históricas. Cada instantánea referencia una Lista de Manifiestos (archivo Avro con todas las particiones activas), la cual a su vez apunta a múltiples Archivos Manifiesto (archivos Avro que enumeran los archivos de datos Parquet individuales junto con estadísticas de valores mínimos/máximos, recuentos de nulos y desplazamientos en bytes por columna). Debido a que Iceberg almacena estos rangos dentro de los manifiestos, la fase de planificación de consultas poda más del 90% de los archivos Parquet en memoria a nivel de catálogo sin realizar una sola llamadaGETa S3. -
Delta Lake 3.x (Registro Transaccional Monotónico Commit Log): Delta Lake organiza sus metadatos en torno a un registro de transacciones ordenado situado en el directorio
_delta_log/. Cada confirmación atómica escribe un archivo JSON numerado correlativamente (ej.000001.json) que detalla acciones comoadd(nuevo archivo Parquet incorporado) oremove(archivo Parquet marcado para supresión). Cada 10 confirmaciones, Delta genera un archivo Parquet de Punto de Control (Checkpoint) que consolida el historial del registro hasta ese instante. Delta Lake 3.0 introdujo UniForm (Universal Format), que genera automáticamente envoltorios de metadatos de Iceberg y Hudi de manera asíncrona tras cada confirmación, permitiendo que motores nativos de Iceberg lean tablas Delta sin duplicar datos. -
Apache Hudi (Línea de Tiempo Orientada al Streaming): Hudi estructura sus metadatos en torno a una Línea de Tiempo centralizada en el directorio
.hoodie/, supervisando estados de instantes (REQUESTED, INFLIGHT, COMPLETED). Hudi destaca en operaciones continuas de inserción y actualización (upserts) de altísima frecuencia mediante índices a nivel de registro (HFile, filtros Bloom o indexación por buckets dinámicos), si bien conlleva una complejidad operativa superior y un mayor acoplamiento con la JVM que Iceberg o Delta.
Particionado Oculto vs Liquid Clustering
El particionado tradicional de directorios estilo Apache Hive (ej. /year=2026/month=03/day=15/) originó graves problemas en los data lakes de producción. Los analistas debían incluir obligatoriamente las columnas de partición en las cláusulas WHERE, y modificar la estrategia de particionado exigía reescribir petabytes enteros de datos. Iceberg y Delta Lake resuelven esta limitación mediante enfoques conceptualmente distintos:
Particionado Oculto y Evolución de Particiones en Apache Iceberg: Iceberg aísla el particionado de la consulta del usuario. Cuando una tabla se particiona mediante days(event_time), las consultas que filtran por WHERE event_time >= '2026-03-01' podan automáticamente los archivos de datos sin que el usuario necesite conocer la existencia física de una partición por día. Además, Iceberg soporta Evolución de Particiones: un arquitecto puede cambiar la estrategia de mensual a diaria simplemente actualizando los metadatos. Los archivos históricos permanecen intactos en su ubicación original; únicamente los nuevos archivos de datos siguen la nueva especificación, y los motores de consulta evalúan dinámicamente múltiples especificaciones de partición activas de forma simultánea.
Liquid Clustering en Delta Lake 3.0: Delta Lake abandonó por completo el particionado físico en subdirectorios en favor de Liquid Clustering. Los archivos de datos se almacenan en una estructura plana y se agrupan a lo largo de 1 a 4 columnas designadas empleando curvas de Hilbert que rellenan el espacio. En lugar de crear rígidas barreras físicas, Liquid Clustering organiza los bloques de datos de forma dinámica. Conforme evolucionan los patrones de consulta, los ingenieros actualizan las claves de clúster mediante un comando ALTER TABLE sin necesidad de reescribir datos históricos; trabajos automáticos de mantenimiento OPTIMIZE reorganizan progresivamente los bloques de datos hacia la nueva distribución.
Mecánica de Mutaciones a Nivel de Fila: Copy-on-Write (COW) vs Merge-on-Read (MOR)
Modificar registros (actualizaciones y borrados) en archivos columnares Parquet sobre almacenamiento inmutable de objetos resulta extremadamente costoso. Los formatos abiertos abordan las mutaciones a través de dos arquitecturas:
| Mecánica de Mutación | Amplificación de Escritura (Ingestión) | Sobrecarga en Lectura (Consultas) | Representación de Eliminaciones | Carga de Trabajo Ideal en Producción |
|---|---|---|---|---|
| Copy-on-Write (COW) | Extrema (10x–100x). Modificar 1 fila reescribe el archivo Parquet completo de 128MB. | Cero sobrecarga. Escaneos Parquet puros y limpios sin operaciones de cruce en memoria. | Ninguna. Los archivos Parquet antiguos se reemplazan por nuevos archivos con los cambios consolidados. | Dimensiones que cambian lentamente (SCD Tipo 1/2), actualizaciones regulatorias mensuales por lotes, data marts orientados a lectura. |
| Merge-on-Read (MOR) — Position Deletes | Baja (1.05x–1.15x). Escribe archivos ligeros de borrado que registran el URI del archivo y el ordinal de la fila. | Moderada (15%–35%). El motor ejecuta un join hash en memoria entre los archivos de datos y los archivos de eliminación. | Archivos Parquet de borrado que contienen tuplas (file_path: VARCHAR, pos: BIGINT). |
Ingestión masiva por streaming CDC, actualizaciones de eventos en tiempo real, upserts continuos con compactación programada. |
| Merge-on-Read (MOR) — Equality Deletes | Mínima (1.01x). Añade un archivo de borrado indicando el valor de la columna (ej. user_id = 94821). |
Alta (30%–60%+). El motor debe transmitir y comparar los valores de igualdad contra todas las filas leídas. | Archivos Parquet/Avro que especifican los nombres de columna y los valores exactos a suprimir. | Motores de ingestión en streaming (ej. Apache Flink) donde se desconoce la ubicación del archivo físico y el ordinal de la fila. |
| Vectores de Eliminación (Delta Lake DVs) | Baja (1.02x–1.08x). Añade bitmaps serializados Roaring que indican las posiciones de filas eliminadas. | Muy Baja (5%–12%). El motor aplica filtros bitwise ultrarrápidos con SIMD durante la decodificación Parquet. | Archivos binarios serializados Roaring Bitmap (o integrados directamente en el registro transaccional). | Analítica interactiva sobre tablas CDC en tiempo real; operaciones transaccionales con mutaciones de muy alta frecuencia. |
Código de Producción: DDL y Mantenimiento de Tablas con PySpark
El siguiente script de PySpark configura una tabla corporativa en Apache Iceberg v2 con particionado oculto, Merge-on-Read con archivos Position Delete, evolución de esquemas y compactación automática mediante bin-packing:
# Configuración de sesión PySpark con Catálogo REST de Iceberg y AWS S3 IO
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("LakehouseCorporativoIceberg") \
    .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions") \
    .config("spark.sql.catalog.lakehouse", "org.apache.iceberg.spark.SparkCatalog") \
    .config("spark.sql.catalog.lakehouse.type", "rest") \
    .config("spark.sql.catalog.lakehouse.uri", "https://polaris.internal/api/catalog") \
    .config("spark.sql.catalog.lakehouse.io-impl", "org.apache.iceberg.aws.s3.S3FileIO") \
    .config("spark.sql.catalog.lakehouse.warehouse", "s3://empresa-lakehouse-gold-us-east-1/warehouse/") \
    .config("spark.sql.defaultCatalog", "lakehouse") \
    .getOrCreate()

# 1. Crear tabla Iceberg v2 con particionado oculto y Merge-on-Read
spark.sql("""
CREATE TABLE IF NOT EXISTS lakehouse.telemetria.eventos_stream (
    event_id STRING NOT NULL,
    tenant_id STRING NOT NULL,
    event_timestamp TIMESTAMP NOT NULL,
    device_type STRING,
    payload_json STRING,
    latency_ms DOUBLE
)
USING iceberg
PARTITIONED BY (days(event_timestamp), bucket(16, tenant_id))
TBLPROPERTIES (
    'format-version' = '2',
    'write.delete.mode' = 'merge-on-read',
    'write.update.mode' = 'merge-on-read',
    'write.merge.mode' = 'merge-on-read',
    'write.parquet.compression-codec' = 'zstd',
    'write.parquet.compression-level' = '3',
    'write.target-file-size-bytes' = '134217728',
    'history.expire.max-snapshot-age-ms' = '604800000'
)
""")

# 2. Evolución fluida del esquema sin reescribir los archivos Parquet físicos
spark.sql("""
ALTER TABLE lakehouse.telemetria.eventos_stream
ADD COLUMN geo_region STRING AFTER device_type
""")

# 3. Compactación bajo demanda mediante algoritmo de empaquetado (Bin-Packing)
spark.sql("""
CALL lakehouse.system.rewrite_data_files(
    table => 'telemetria.eventos_stream',
    strategy => 'binpack',
    options => map(
        'target-file-size-bytes', '134217728',
        'min-file-size-bytes', '33554432',
        'max-file-group-size-bytes', '10737418240'
    )
)
""")
3. El Plano de Control de Metadatos y Catálogos REST: Project Nessie, Polaris y Unity
En los lagos de datos tradicionales, el Hive Metastore (HMS) operaba como el directorio central que asociaba los nombres lógicos de las tablas con las rutas físicas de S3. Al superar las 100,000 particiones y millones de archivos, el HMS se transformaba en un cuello de botella crítico: soportado por una base de datos relacional única (PostgreSQL/MySQL), sufría bloqueos por saturación del pool de conexiones, carecía de mecanismos de concurrencia optimista, exigía listados recursivos en el sistema de archivos y no brindaba soporte transaccional atómico para operaciones multi-tabla.
El Estándar OpenAPI de Catálogo REST de Apache Iceberg
En 2026, el Modern Data Stack ha adoptado unánimemente la especificación de Catálogo REST de Apache Iceberg. Formulada como un estándar abierto OpenAPI bajo HTTP, el catálogo REST desacopla de forma total los motores de computación de la implementación del catálogo. Motores como Trino, Spark, Flink, DuckDB, ClickHouse y StarRocks se comunican con cualquier catálogo compatible mediante cargas JSON sobre HTTP. El endpoint resuelve:
- Resolución de Espacios de Nombres y Tablas: Vinculación de nombres lógicos jerárquicos (ej.
corporativo.finanzas.ebitda_mensual) con los punteros URI del archivo de metadatos activo. - Control de Concurrencia Optimista (OCC): Validación de colisiones de confirmación mediante operaciones swap atómicas (garantizando que la instantánea base no haya variado antes de registrar un nuevo snapshot).
- Entrega Dinámica de Credenciales (Credential Vending): Generación automática de credenciales de acceso cloud efímeras y con privilegios mínimos (tokens AWS STS o credenciales OAuth downscoped de GCP) restringidas al prefijo exacto de la tabla, eliminando la distribución de credenciales maestras a los motores de computación.
Ramificación de Datos Tipo Git con Project Nessie
Project Nessie trasladó la semántica de Git (ramas, etiquetas, confirmaciones y fusiones) a los metadatos del Lakehouse. Tradicionalmente, probar un pipeline de transformación modificado o entrenar un modelo de Machine Learning requería clonar petabytes de datos productivos hacia entornos de pruebas, disparando los costes de almacenamiento y computación. Con Nessie, la ramificación es 100% virtual y sin copia física de datos (zero-copy):
# 1. Crear una rama de desarrollo aislada sin copiar datos a partir de 'main'
nessie branch create rama_desarrollo_pipeline main --uri https://nessie.internal/api/v2

# 2. En Spark, escribir los datos procesados directamente en la rama de desarrollo
spark.sql("""
USE REFERENCE rama_desarrollo_pipeline IN catalogo_lakehouse;

MERGE INTO catalogo_lakehouse.analitica.agregados_usuarios AS destino
USING stream_staging_transformado AS origen
ON destino.user_id = origen.user_id
WHEN MATCHED THEN UPDATE SET *
WHEN NOT MATCHED THEN INSERT *;
""")

# 3. Ejecutar contratos de datos y aserciones de calidad sobre la rama aislada
# (Las consultas en la rama 'main' de producción no sufren impacto alguno)

# 4. Fusionar atómicamente la rama validada hacia 'main' de forma instantánea
nessie merge rama_desarrollo_pipeline --onto main --uri https://nessie.internal/api/v2
El Ecosistema de Catálogos Abiertos: Apache Polaris vs Unity Catalog
El panorama de control de metadatos se transformó de manera definitiva cuando Snowflake liberó como código abierto Apache Polaris (incubating) y Databricks liberó Unity Catalog. Apache Polaris implementa la especificación pura de Catálogo REST de Iceberg, facilitando a las arquitecturas multi-cloud el despliegue de un plano de control sin estado altamente escalable respaldado por bases de datos distribuidas. Unity Catalog ofrece un modelo unificado que abarca Delta Lake e Iceberg (mediante UniForm), integrando linaje a nivel de columna y control de acceso basado en atributos (ABAC). La estandarización en torno al Catálogo REST neutraliza el riesgo de bloqueo comercial: si un proveedor de computación incrementa sus tarifas o degrada su servicio, la totalidad de los datos físicos puede reasignarse a un motor alternativo en cuestión de minutos.
4. Ingestión en Tiempo Real y Change Data Capture (CDC)
La época de los pipelines ETL ejecutados a las 2:00 AM ha terminado. En 2026, la toma de decisiones empresariales exige que la información operativa esté disponible en segundos para análisis de fraude, logística en tiempo real, tarificación dinámica y cuadros de mando ejecutivos. Construir un pipeline de ingestión continuo directamente sobre el Lakehouse requiere coordinar tres componentes esenciales: transporte de eventos de alto rendimiento, procesamiento distribuido de flujos con estado y confirmaciones atómicas en las tablas abiertas.
Eje Central de Streaming: Apache Kafka KRaft vs Redpanda C++
En la frontera de entrada, los registros de confirmación distribuida absorben los picos masivos de transacciones:
Apache Kafka KRaft: La sustitución definitiva de Apache ZooKeeper por el protocolo de consenso KRaft (Kafka Raft) modernizó el perfil operativo de Kafka. KRaft consolida la gestión de metadatos dentro de los propios intermediarios (brokers), permitiendo a los clústeres superar el millón de particiones y reduciendo el tiempo de recuperación ante fallos de líderes de partición de minutos a milisegundos. Kafka permanece como el estándar empresarial consolidado con soporte en todos los proveedores de nube (AWS MSK, Confluent Cloud, Aiven).
Redpanda (Arquitectura Thread-Per-Core en C++): Redpanda fue diseñado desde sus cimientos en C++ nativo utilizando el framework asíncrono Seastar. Al prescindir totalmente de la JVM, Redpanda elimina las pausas por recolección de basura, ofreciendo latencias P99 sub-5ms totalmente predecibles bajo saturación extrema de escrituras. Asimismo, Redpanda elude la caché de páginas del kernel de Linux utilizando acceso directo a discos NVMe mediante io_uring, alcanzando hasta 3 veces mayor rendimiento por núcleo de CPU en comparación con Kafka. Para arquitecturas de Lakehouse que superan los 500,000 eventos/segundo, Redpanda reduce drásticamente la factura de servidores y computación. (Revisa nuestras comparativas en profundidad: Redpanda vs Apache Kafka y Apache Kafka vs RabbitMQ).
Streaming CDC Directo al Lakehouse: Debezium y Apache Flink
Capturar las modificaciones de estado desde bases de datos transaccionales (PostgreSQL, MySQL, Oracle, MongoDB) sin degradar su rendimiento exige Change Data Capture (CDC) basado en registros. Debezium decodifica los registros de escritura previa (WAL/binlog) generando flujos de eventos estructurados que detallan los estados BEFORE y AFTER junto con los números de secuencia de registro (LSN).
Para canalizar estos flujos de CDC directamente hacia tablas Apache Iceberg o Delta Lake con latencias sub-segundo, las arquitecturas modernas recurren a Apache Flink. Flink proporciona procesamiento con estado y garantías de entrega exactamente-una-vez (EOS) gracias al algoritmo de instantáneas distribuidas de Chandy-Lamport. A diferencia de las micro-tandas de Spark Structured Streaming (que suelen confirmar cada 10 a 30 segundos), el conector sink de Iceberg en Flink procesa flujos continuos y confirma instantáneas en intervalos configurables de 500ms a 5 segundos:
-- Ingestión Continua de CDC hacia Apache Iceberg mediante Flink SQL
CREATE CATALOG catalogo_lakehouse WITH (
    'type' = 'iceberg',
    'catalog-type' = 'rest',
    'uri' = 'https://polaris.internal/api/catalog',
    'warehouse' = 's3://empresa-lakehouse-gold-us-east-1/'
);

-- Definición de tabla fuente Kafka/Redpanda con eventos CDC Debezium PostgreSQL
CREATE TABLE kafka_postgres_pedidos_cdc (
    order_id BIGINT,
    customer_id BIGINT,
    order_amount DECIMAL(10, 2),
    order_status STRING,
    updated_at TIMESTAMP(3),
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'connector' = 'kafka',
    'topic' = 'dbserver1.public.orders',
    'properties.bootstrap.servers' = 'redpanda-cluster:9092',
    'properties.group.id' = 'flink-lakehouse-pedidos-cdc',
    'format' = 'debezium-json'
);

-- Inserción y actualización continua en Iceberg con Merge-on-Read y commits cada 2s
INSERT INTO catalogo_lakehouse.ventas.pedidos_tiempo_real
SELECT
    order_id,
    customer_id,
    order_amount,
    order_status,
    updated_at
FROM kafka_postgres_pedidos_cdc;
5. Motores OLAP Vectorizados para Servicio Sub-Segundo: ClickHouse vs StarRocks vs DuckDB
Si bien los motores de consulta SQL distribuida de propósito general (Trino, Apache Spark SQL, Presto) destacan en escaneos masivos de terabytes y transformaciones federadas, fracasan estrepitosamente cuando se les exige atender cuadros de mando interactivos orientados al cliente con alta concurrencia. Trino conlleva una latencia de arranque y coordinación de consultas de 1.2 a 3.5 segundos; intentar abastecer a 500 usuarios simultáneos ejecutando filtrados dinámicos en una interfaz web provoca contención extrema de memoria, saturación de hilos en la JVM y una experiencia degradada.
Para entregar respuestas sub-50ms bajo cargas de más de 10,000 Consultas Por Segundo (QPS), el Modern Data Stack incorpora un Nivel de Servicio OLAP Vectorizado en Tiempo Real. En 2026, tres motores dominan esta capa especializada: ClickHouse, StarRocks y DuckDB.
Vectorización SIMD y Motores MergeTree en ClickHouse
ClickHouse representa la cúspide del rendimiento en escaneos analíticos sobre tablas individuales desnormalizadas. Construido en torno a instrucciones SIMD (AVX-512 y ARM Neon), ClickHouse procesa la información en bloques vectoriales a nivel de registro de CPU en vez de evaluar tuplas individuales. Su arquitectura de almacenamiento base—la familia de motores MergeTree—ordena físicamente los registros por clave primaria y genera índices primarios dispersos (granularity predeterminada de 8,192 filas), permitiendo al motor saltar el 99.9% de los bloques de datos durante la evaluación de filtros.
ClickHouse maximiza la densidad de compresión y la velocidad de descompresión aplicando códecs especializados por columna:
DoubleDelta: Almacena las diferencias entre marcas de tiempo consecutivas, comprimiendo marcas datetime de 64 bits a 1–2 bits por fila.Gorilla: Algoritmo de compresión XOR especializado en números en coma flotante para métricas financieras y lecturas de telemetría IoT.T64: Transpone la matriz de bits de enteros para potenciar drásticamente la compresión por diccionario posterior con ZSTD o LZ4.
-- Tabla MergeTree Vectorizada en ClickHouse con Códecs de Compresión Avanzados
CREATE TABLE default.eventos_analitica_usuarios (
    event_id UUID CODEC(ZSTD(3)),
    tenant_id UInt32 CODEC(T64, ZSTD(3)),
    event_timestamp DateTime64(3, 'UTC') CODEC(DoubleDelta, LZ4),
    response_time_ms Float32 CODEC(Gorilla, ZSTD(3)),
    http_status_code UInt16 CODEC(T64, LZ4),
    user_agent LowCardinality(String) CODEC(ZSTD(3)),
    payload_size_bytes UInt64 CODEC(T64, ZSTD(3))
)
ENGINE = ReplacingMergeTree()
PARTITION BY toYYYYMM(event_timestamp)
PRIMARY KEY (tenant_id, event_timestamp)
ORDER BY (tenant_id, event_timestamp, event_id)
SETTINGS index_granularity = 8192;
StarRocks: Pipeline MPP en C++ y Desnormalización en Tiempo Real
Mientras que ClickHouse históricamente presentó dificultades para resolver joins complejos entre múltiples tablas en esquemas en estrella o copo de nieve, StarRocks fue concebido específicamente para conquistar los joins distribuidos multi-tabla. Desarrollado como un motor Massively Parallel Processing (MPP) íntegramente vectorizado en C++, StarRocks cuenta con un Optimizador Basado en Costes (CBO) de última generación capaz de reordenar árboles de más de 20 joins en milisegundos.
Además, StarRocks funciona como una capa de aceleración y caché sobre formatos abiertos de Lakehouse: puede consultar tablas Apache Iceberg y Delta Lake directamente en S3 utilizando caché local en discos NVMe SSD, o construir Vistas Materializadas Asíncronas Transparentes (MVs). Cuando un usuario consulta un cuadro de mando, el CBO de StarRocks reescribe automáticamente la consulta para consumir la vista materializada pre-agregada, entregando tiempos de respuesta P99 inferiores a 20ms mientras sincroniza de forma continua las deltas desde las tablas Iceberg subyacentes. (Analiza nuestra comparativa detallada en ClickHouse vs StarRocks: Duelo de Motores OLAP Vectorizados).
-- Integración de Catálogo Externo Iceberg y Vista Materializada Asíncrona en StarRocks
CREATE EXTERNAL CATALOG catalogo_iceberg_prod
PROPERTIES (
    "type" = "iceberg",
    "iceberg.catalog.type" = "rest",
    "iceberg.catalog.uri" = "https://polaris.internal/api/catalog",
    "aws.s3.use_instance_profile" = "true"
);

-- Vista Materializada con Caché Local en NVMe SSD sobre tabla externa Iceberg
CREATE MATERIALIZED VIEW mv_metricas_horarias_inquilinos
REFRESH ASYNC EVERY (INTERVAL 5 MINUTE)
PARTITION BY date_trunc('hour', event_time)
PROPERTIES (
    "datacache.enable" = "true",
    "datacache.partition_duration" = "7d"
)
AS SELECT
    tenant_id,
    date_trunc('hour', event_timestamp) AS event_time,
    count(event_id) AS total_solicitudes,
    avg(latency_ms) AS latencia_media,
    percentile_approx(latency_ms, 0.99) AS p99_latencia
FROM catalogo_iceberg_prod.telemetria.eventos_stream
GROUP BY tenant_id, date_trunc('hour', event_timestamp);
DuckDB: Analítica Embebida en el Propio Proceso para Edge BI
DuckDB transformó el trabajo diario de los ingenieros analíticos y científicos de datos al popularizar el concepto del "SQLite para la Analítica". Al ejecutarse directamente dentro del proceso anfitrión (Python, Node.js, WebAssembly en el navegador o binario CLI) sin requerir servicios en segundo plano ni infraestructura cliente-servidor, DuckDB procesa vectores columnares mediante paralelismo guiado por morsels (Morsel-driven parallelism).
En el Modern Data Stack de 2026, DuckDB actúa como el motor definitivo para desarrollo local, analítica en el borde y cuadernos de datos interactivos. Empleando sus extensiones nativas para S3 e Iceberg, los analistas ejecutan consultas vectorizadas de altísimo rendimiento sobre conjuntos de datos remotos de cientos de gigabytes directamente en Jupyter notebooks sin incurrir en costes de computación de Snowflake o Databricks:
# Analítica Serverless In-Process con DuckDB sobre Iceberg en Amazon S3
import duckdb
import os

conn = duckdb.connect()

# Cargar extensiones nativas de almacenamiento HTTP e Iceberg
conn.execute("INSTALL httpfs; LOAD httpfs;")
conn.execute("INSTALL iceberg; LOAD iceberg;")

# Parámetros S3 obtenidos desde variables de entorno (cero claves expuestas)
conn.execute(f"""
SET s3_region='us-east-1';
SET s3_access_key_id='{os.environ.get("AWS_ACCESS_KEY_ID", "CLAVE_LAKEHOUSE")}';
SET s3_secret_access_key='{os.environ.get("AWS_SECRET_ACCESS_KEY", "SECRETO_LAKEHOUSE")}';
""")

# Agregación vectorizada SIMD directa sobre archivos Parquet de Iceberg
df = conn.execute("""
SELECT
    tenant_id,
    COUNT(*) AS total_eventos,
    ROUND(AVG(latency_ms), 2) AS latencia_media_ms,
    APPROX_COUNT_DISTINCT(device_type) AS dispositivos_unicos
FROM iceberg_scan('s3://empresa-lakehouse-gold-us-east-1/warehouse/telemetria/eventos_stream')
WHERE event_timestamp >= NOW() - INTERVAL '24 hours'
GROUP BY tenant_id
ORDER BY total_eventos DESC
LIMIT 10;
""").df()

print(df)
6. La Capa Semántica y Gobernanza de Métricas Empresariales
Uno de los fallos más costosos y destructivos en la gestión de datos es la deriva de métricas (metric drift). En organizaciones sin una arquitectura semántica centralizada, las definiciones matemáticas de métricas críticas para el negocio—tales como "Usuarios Activos Mensuales" (MAU), "Tasa de Retención Bruta" o "ARR Neto"—se encuentran codificadas de manera dispar y redundante dentro de múltiples herramientas de visualización. El equipo de finanzas redacta una consulta SQL en PowerBI definiendo el churn de clientes a partir del retraso de facturas; marketing construye un cuadro de mando en Tableau definiendo el churn según la inactividad de sesiones web; y el equipo de producto escribe una vista en Looker considerando churn la cancelación de suscripciones en la app.
El desenlace es la parálisis directiva: las reuniones ejecutivas se diluyen en estériles debates sobre qué departamento posee el dato verídico.
Desacoplamiento de la Semántica de Negocio frente al BI Monolítico
El Modern Data Stack de 2026 erradica este problema mediante la Capa Semántica Centralizada. La capa semántica se interpone directamente entre los motores de almacenamiento del Lakehouse y las herramientas consumidoras (BI, aplicaciones analíticas embebidas, reverse ETL, agentes de IA). Actúa como un compilador unificado que traduce definiciones lógicas de métricas y dimensiones a consultas SQL optimizadas para el motor de destino:
- Métricas Definidas como Código: Dimensiones, medidas, relaciones de agregación y rutas de unión (joins) se declaran estrictamente en archivos versionados (YAML/JSON) en repositorios Git.
- Protocolo Universal de Consumo: La capa semántica expone interfaces estándares (puerto wire protocol de PostgreSQL para clientes SQL, APIs REST y endpoints GraphQL). Cualquier herramienta que consulte el sistema obtiene exactamente el mismo resultado.
- Pre-Agregación y Aceleración Multi-Inquilino: Motores semánticos como Cube o dbt Semantic Layer / MetricFlow generan y mantienen automáticamente tablas físicas de pre-agregación en el Lakehouse, acelerando consultas complejas de minutos a milisegundos.
Especificación de Métricas Semánticas en Producción (Cube / MetricFlow)
El siguiente modelo semántico define métricas de ingresos recurrentes (MRR) y retención con jerarquías dimensionales y pre-agregaciones automáticas:
# Definición Universal de Métricas Semánticas en Cube / dbt MetricFlow
cubes:
  - name: analitica_suscripciones
    sql_table: lakehouse.gold_finanzas.fct_movimientos_mrr

    dimensions:
      - name: subscription_id
        sql: subscription_id
        type: string
        primary_key: true

      - name: tenant_id
        sql: tenant_id
        type: string

      - name: plan_tier
        sql: plan_tier
        type: string

      - name: billing_country
        sql: billing_country
        type: string

      - name: snapshot_date
        sql: snapshot_timestamp
        type: time

    measures:
      - name: total_mrr
        sql: mrr_amount_usd
        type: sum
        format: currency

      - name: suscriptores_activos
        sql: customer_id
        type: count_distinct_approx

      - name: expansion_neta_mrr
        sql: "CASE WHEN movement_type = 'EXPANSION' THEN mrr_change_usd ELSE 0 END"
        type: sum

      - name: churn_bruto_mrr
        sql: "CASE WHEN movement_type = 'CHURN' THEN mrr_change_usd ELSE 0 END"
        type: sum

    pre_aggregations:
      - name: mrr_por_plan_mensual
        measures: [total_mrr, suscriptores_activos, expansion_neta_mrr]
        dimensions: [plan_tier, billing_country]
        time_dimension: snapshot_date
        granularity: month
        refresh_key:
          every: 1 hour
7. Contratos de Datos y Calidad Shift-Left en la Ingeniería de Datos
En los equipos tradicionales de ingeniería de datos, la calidad de la información se gestiona como una verificación tardía al final del pipeline. Un ingeniero de software refactoriza un microservicio backend, modifica el tipo de una columna en PostgreSQL de BIGINT a VARCHAR, o altera la estructura de un JSON anidado. Las pruebas unitarias de la aplicación pasan con éxito y el código se despliega en producción. Doce horas más tarde, cientos de modelos de dbt fallan, los pipelines de facturación automática se detienen y los informes directivos muestran datos incompletos o erróneos.
Pilares Fundamentales de los Contratos de Datos
Los Contratos de Datos tratan la información analítica como una API de software formal, versionada y ejecutable. Establecen un acuerdo vinculante entre los productores de datos (equipos de software transaccional) y los consumidores (ingenieros de datos, analistas y científicos de ML). Un contrato integral incluye cuatro pilares:
- Esquema Estricto: Tipos de datos inmutables, restricciones de no nulidad y claves primarias/foráneas verificadas en tiempo de compilación y ejecución.
- Expectativas Semánticas: Rangos de valores admisibles, conjuntos de enumeraciones válidas y reglas de coherencia matemática.
- Acuerdos de Nivel de Servicio (SLAs/SLOs): Compromisos formales sobre latencia máxima de ingestión, disponibilidad del flujo y tasa de refresco.
- Clasificación y Seguridad: Etiquetado explícito de columnas con PII (Datos de Carácter Personal) y niveles de sensibilidad (Público, Interno, Confidencial, Restringido).
Validación Shift-Left: Soda Core y Contratos de Modelo en dbt
La verificación de calidad se desplaza a la izquierda (shift-left) incorporándose directamente a las pipelines de CI/CD de los productores de software. Una migración de base de datos no puede fusionarse en Git si no supera la validación automática de compatibilidad retrospectiva con los contratos de los consumidores:
# Contrato de Datos y Aserciones Automáticas con Soda Core (checks.yml)
table_name: lakehouse.silver_comercio.transacciones_clientes
contracts:
  - name: contrato_productor_transacciones_v2
    columns:
      - name: transaction_id
        data_type: string
        nullable: false
      - name: customer_id
        data_type: string
        nullable: false
      - name: amount_usd
        data_type: decimal(12,2)
        nullable: false
      - name: currency_code
        data_type: string
        nullable: false

checks for transacciones_clientes:
  # Validación estricta de unicidad en la clave primaria
  - missing_count(transaction_id): 0
  - duplicate_count(transaction_id): 0

  # Restricciones de coherencia matemática y valores válidos
  - min(amount_usd) > 0.00
  - max(amount_usd) < 1000000.00
  - invalid_count(currency_code): 0
    valid values: ['USD', 'EUR', 'GBP', 'CAD', 'JPY', 'MXN', 'BRL', 'CLP', 'COP']

  # SLO de Frescura: Los datos no pueden superar los 15 minutos de antigüedad
  - freshness(created_at) < 15m
8. FinOps en Almacenamiento y Optimización de Archivos Parquet
Migrar a una arquitectura de Lakehouse con ingestión continua por streaming introduce importantes desafíos de sostenibilidad económica. Sin una gobernanza activa, el flujo continuo genera el temido Problema de los Archivos Pequeños (Small File Problem): millones de archivos Parquet diminutos (de 10KB a 1MB) dispersos en Amazon S3. Esto ralentiza exponencialmente la planificación de consultas, dispara las facturas por llamadas a las APIs LIST/GET de la nube y satura los catálogos de metadatos.
Antipatrón de Archivos Fragmentados y Algoritmos de Compactación
Un Lakehouse moderno implementa tareas programadas y continuas de compactación en segundo plano para consolidar los archivos Parquet en tamaños ideales:
- Compactación Bin-Packing: Empaqueta múltiples archivos Parquet pequeños dentro de una misma partición en archivos consolidados con un tamaño objetivo de 128MB a 512MB. El algoritmo no ordena los registros, minimizando el consumo de CPU y el tiempo de ejecución.
-
Compactación Sort-Order y Z-Order: Reescribe los archivos organizando y ordenando las filas a lo largo de columnas de alta cardinalidad frecuentemente filtradas (ej.
tenant_id,customer_id). Esta ordenación maximiza la efectividad de las estadísticas mín/máx en los pies de página de Parquet y manifiestos de Iceberg, facultando a los motores a descartar entre el 80% y el 95% de los archivos sin leerlos. -
Expiración de Instantáneas y Limpieza de Huérfanos: Cuando las tablas sufren actualizaciones o compactaciones con Merge-on-Read, las instantáneas históricas permanecen almacenadas para permitir consultas de time-travel. Las rutinas de FinOps deben expirar periódicamente los snapshots que superen la ventana de retención (ej. 7 días) y ejecutar
remove_orphan_filespara purgar bytes huérfanos del almacenamiento de objetos.
Economía Comparativa de Códecs de Compresión: Snappy vs ZSTD
La elección del códec de compresión para archivos Parquet supone un impacto financiero determinante a escala de petabytes:
| Códec de Compresión | Ratio de Compresión | Velocidad de Compresión | Rendimiento de Descompresión | Recomendación FinOps |
|---|---|---|---|---|
| Snappy | 1.0x (Base: ~2.8x vs texto plano) | Rápida (~250 MB/s/núcleo) | Alta (~500 MB/s/núcleo) | Estándar heredado; adecuado únicamente en colas de staging temporal donde la CPU prima sobre el coste de almacenamiento. |
| ZSTD Nivel-3 | 1.32x superior a Snappy | Moderada (~180 MB/s/núcleo) | Extrema (~1,200 MB/s/núcleo) | Estándar de Oro en el Lakehouse. Reduce la factura de almacenamiento S3 entre un 25% y un 35% y acelera las consultas al descomprimir mucho más rápido. |
| ZSTD Nivel-7+ | 1.48x superior a Snappy | Lenta (~45 MB/s/núcleo) | Alta (~1,100 MB/s/núcleo) | Tablas históricas de archivo regulatorio de escritura única y consulta muy infrecuente. |
| Gzip | 1.25x superior a Snappy | Muy Lenta (~30 MB/s/núcleo) | Lenta (~180 MB/s/núcleo) | Obsoleto para analítica moderna; CPU-ineficiente y sin ventajas competitivas frente a ZSTD. |
Capas de Caché en Discos NVMe SSD Locales sobre Almacenamiento de Objetos
El almacenamiento de objetos cloud (Amazon S3 Standard, GCS, Azure Blob) exhibe una latencia física de primer byte situada entre 60ms y 120ms. Para cuadros de mando analíticos con SLAs inferiores a 50ms, leer directamente de S3 en cada petición resulta inviable. Motores como StarRocks y ClickHouse resuelven este desfase implementando arquitecturas de almacenamiento jerárquico con caché NVMe local:
Donde el ancho de banda del bus NVMe (B_nvme > 3,500 MB/s) y su latencia mínima (< 0.1ms) generan una aceleración de I/O de 35x a 80x frente a la lectura directa en S3 para los datos calientes.
9. Matriz Comparativa Empresarial de 25 Criterios de Herramientas de Datos
El ecosistema contemporáneo de ingeniería de datos abarca diversas filosofías de arquitectura. La siguiente matriz técnica exhaustiva de 25 criterios evalúa en profundidad las principales tecnologías que configuran el Modern Data Stack en 2026:
| Criterio Arquitectónico | Apache Iceberg | Delta Lake 3.x | ClickHouse | StarRocks | Apache Kafka | Redpanda | Snowflake | Databricks |
|---|---|---|---|---|---|---|---|---|
| 1. Clasificación de Capa | Formato Abierto de Tabla | Formato Abierto de Tabla | OLAP Vectorizado de Servicio | OLAP MPP Vectorizado | Registro de Eventos Distribuido | Streaming Thread-per-core | Almacén Cloud Propietario | Plataforma Unificada Lakehouse |
| 2. Motor de Ejecución Primario | Agnóstico al Motor | Agnóstico (Spark/Photon) | ClickHouse C++ SIMD | StarRocks C++ MPP | N/A (Broker de streaming) | N/A (Broker de streaming) | Propietario de Snowflake | Photon C++ Vectorizado |
| 3. Nivel de Aislamiento ACID | Serializable / Instantáneas | Serializable / Instantáneas | Atómico por Partición | Transaccional / MVCC | Read Committed (EOS) | EOS gobernado por Raft | Read Committed | Serializable |
| 4. Estándar de Catálogo | Catálogo REST OpenAPI | Unity Catalog / UniForm | Metadatos Nativos de Motor | Nativo / Iceberg Externo | Quórum de Metadatos KRaft | Raft en Espacio de Usuario | Propietario Snowflake | Unity Catalog |
| 5. Poda y Evolución de Particiones | Particionado Oculto y Evolución | Liquid Clustering (Hilbert) | Dispersión de Clave Primaria | Poda Dinámica de Particiones | Enrutamiento Topic-Partición | Enrutamiento Topic-Partición | Micro-particionado Automático | Liquid Clustering |
| 6. Arquitectura de Mutaciones | MOR (Position Deletes) y COW | Vectores de Borrado (Roaring) | ReplacingMergeTree | Primary Key Engine (Del-Vec) | Tópicos Compactados (Tombstones) | Tópicos Compactados | Híbrido COW / Micro-part | Vectores de Eliminación |
| 7. Vectorización SIMD por Hardware | Dependiente del Motor | Dependiente del Motor | Nativa AVX-512 / Neon | Nativa AVX-512 / Neon | N/A | N/A | SIMD Propietario | SIMD Nativo Photon |
| 8. Latencia de Consulta P99 | Dependiente del Motor (1s–10s) | Dependiente del Motor (1s–10s) | < 35ms | < 50ms | N/A (Escritura en stream) | N/A (Sub-5ms en escritura) | 450ms – 2.5s | 350ms – 1.8s |
| 9. Escalabilidad de Concurrencia (QPS) | Moderada (Sujeta a motor) | Moderada (Sujeta a motor) | Extrema (10,000+ QPS) | Alta (5,000+ QPS) | 100,000+ Escrituras/s | 300,000+ Escrituras/s | Moderada (Multi-clúster) | Moderada (Serverless) |
| 10. Frescura de Ingestión Streaming | 500ms – 5s (Flink) | 1s – 10s (Structured Stream) | Sub-segundo (Buffer / Kafka) | Sub-segundo (Routine Load) | Sub-10ms pub-a-sub | Sub-2ms pub-a-sub | 10s – 60s (Snowpipe) | 1s – 10s (Streaming) |
| 11. Desacoplamiento Almacén/Cómputo | 100% Totalmente Desacoplado | 100% Totalmente Desacoplado | Shared-Nothing o Caché S3 | Shared-Data con Caché NVMe | Almacenamiento Jerárquico | Almacenamiento Jerárquico | Desacoplado Gestionado | Desacoplado Gestionado |
| 12. Time Travel y Rollback Histórico | Por Instantáneas (As-Of) | Por Registro (As-Of versión) | Particiones / Backups | Instantáneas / Tablas Ext | Búsqueda por Desplazamiento | Búsqueda por Desplazamiento | Time Travel (Máx 90 días) | Delta Time Travel |
| 13. Ramificación Git sin Copia | Sí (mediante Project Nessie) | Limitada (Clonación de área) | No | No | No | No | Clonación Zero-Copy | Clonación Shallow |
| 14. Estrategia de Compactación | rewrite_data_files Binpack | OPTIMIZE Binpack / Z-Order | Fusión de Partes MergeTree | Motor de Compactación | Roll / Purga de Segmentos | Roll / Purga de Segmentos | Micro-clustering Automático | Auto-compactación (Photon) |
| 15. Integración con OpenLineage | Nativa vía Trino/Spark | Nativa vía Unity/Spark | Registro de consultas custom | Exportación de auditoría | Cabeceras OpenTelemetry | Cabeceras OpenTelemetry | Snowflake Access History | Linaje en Unity Catalog |
| 16. Nativo en Almacén S3/GCS/Azure | Sí (S3FileIO Nativo) | Sí (Directo en S3/ADLS/GCS) | Sí (Discos S3 / Caché) | Sí (Lectura Directa Lakehouse) | Archivo S3 Jerárquico | Espejo en Almacén Cloud | Etapas internas propietarias | Directo en Almacén Cloud |
| 17. Disponibilidad Open Source / FOSS | 100% Open Source (Apache) | 100% Open Source (Linux Fdn) | 100% Open Source (Apache 2.0) | 100% Open Source (Apache 2.0) | 100% Open Source (Apache 2.0) | Source-Available (BSL/Apache) | No (Solo SaaS Cerrado) | Parcialmente (Spark/Delta FOSS) |
| 18. Oferta SaaS Gestionada | Tabular, Dremio, Snowflake | Databricks, Microsoft Fabric | ClickHouse Cloud | StarRocks CelerData | Confluent Cloud, AWS MSK | Redpanda Cloud | Servicio Gestionado Snowflake | Servicio Gestionado Databricks |
| 19. Modelo de Precios | Gratis FOSS / Coste S3 Puro | Gratis FOSS / Coste S3 Puro | Cómputo/Nodo o Crédito SaaS | Cómputo/Nodo o Crédito SaaS | Instancia VM / Confluent | Instancia VM / Redpanda | Consumo de Créditos ($2–$4) | Consumo de DBUs ($0.15–$0.55) |
| 20. Interoperabilidad Multi-Motor | Máxima (Universal) | Alta (mediante UniForm) | Exclusiva de ClickHouse | Catálogos Externos StarRocks | Protocolo Universal Kafka | Protocolo Universal Kafka | Bloqueado (Requiere Snowflake) | Alta (Estándar Delta Lake) |
| 21. Joins Complejos Distribuidos | Dependiente del Motor | Dependiente del Motor | Moderada (Broadcast/Colocate) | Superior (CBO Vectorizado) | N/A | N/A | Superior | Superior |
| 22. Integración Edge BI / Python | DuckDB / PyIceberg | Delta-rs / DuckDB | clickhouse-client / HTTP | Protocolo MySQL Wire | Librerías Cliente Kafka | Librerías Cliente Kafka | Conectores Snowflake | Databricks Connect |
| 23. Niveles de Almacén Frío/Caliente | S3 Glacier / Standard | S3 Glacier / Standard | Jerarquía NVMe → S3 | Caché SSD Local → S3 | NVMe Local → Tiered S3 | NVMe Local → Tiered S3 | Gestión Interna Automatizada | Gestión Interna Automatizada |
| 24. Complejidad Operativa | Baja (Gestionado por catálogo) | Baja (Auto-mantenido) | Moderada (ZooKeeper/Keeper) | Moderada (Nodos FE/BE) | Alta (Ajuste de JVM / KRaft) | Baja (Binario C++ único) | Mínima (SaaS Turnkey) | Moderada (SaaS Turnkey) |
| 25. Escenario Ideal de Despliegue | Almacén Universal de Lakehouse | Ecosistema Databricks / Spark | Logs y Telemetría en Tiempo Real | BI Sub-Segundo y Joins Complejos | Bus Central de Eventos | Ingestión Masiva en C++ | BI Corporativo y Data Sharing | ML Empresarial y ETL Masivo |
10. Sinergia de Benchmarks y Navegación Contextual en CBStack
Configurar un Modern Data Stack robusto exige fundamentar cada decisión técnica en métricas empíricas de rendimiento y no en reclamos comerciales de proveedores. Recomendamos examinar nuestros análisis comparativos detallados para cada nivel del stack:
- Elección de Formatos Abiertos de Tabla: Para una evaluación exhaustiva de árboles de manifiestos, Liquid Clustering y puentes de metadatos UniForm, lee nuestra comparativa técnica: Apache Iceberg vs Delta Lake: Benchmark de Formatos Abiertos.
- Motores de Servicio Analítico Vectorizado: Si necesitas diseñar cuadros de mando interactivos con tiempos de respuesta sub-segundo, consulta nuestro análisis empírico de consumo de memoria y rendimiento en ClickHouse vs StarRocks: Duelo de Motores OLAP Vectorizados.
- Cómputo en Almacenes Cloud vs Lakehouses: ¿Evaluando si migrar de créditos de computación propietarios al Lakehouse Abierto? Revisa Snowflake vs Databricks: Benchmark Empresarial de Lakehouses.
- Plataformas de Mensajería y Streaming de Eventos: Determina la arquitectura de tus intermediarios comparando hilos en C++ frente a la JVM en Redpanda vs Apache Kafka y Apache Kafka vs RabbitMQ.
- Orquestación de Pipelines y Flujos de Trabajo: Compara modelos de micro-orquestación y tolerancia a fallos en Temporal vs Apache Airflow.
- Transformación Moderna y Planificación de Activos: Evalúa la orquestación declarativa basada en activos de datos frente a pipelines SQL en dbt vs Dagster: Orquestación Analítica Moderna.
- Ingestión Automatizada de Datos SaaS (ELT): Analiza costes de conectores y mantenimiento en Fivetran vs Airbyte: Comparativa de Plataformas ELT.
- Caché Distribuida de Alta Velocidad en Memoria: Optimiza las búsquedas de estado y metadatos con Upstash vs Redis Cloud.
- Optimización FinOps Global de la Nube: Aplica control de costes en computación, redes e infraestructura con nuestra guía estratégica: Guía de Cloud FinOps: Optimización de Costes en AWS, GCP y Kubernetes.
11. Gobernanza de Datos, Linaje de Columna y Cumplimiento RGPD / CCPA
Un Modern Data Stack resulta inviable en entornos corporativos si carece de mecanismos formales de auditoría, trazabilidad y cumplimiento normativo. El principal peligro de los lagos de datos tradicionales fue el antipatrón del "pantano de datos" (data swamp): petabytes de archivos Parquet dispersos en S3 sin control de procedencia ni capacidades para ejecutar requerimientos de privacidad.
Linaje Automatizado a Nivel de Columna con OpenLineage
El estándar abierto OpenLineage se ha consolidado como el protocolo universal de telemetría de metadatos. Integrado de forma nativa en los motores de procesamiento (Spark, Trino, Flink, dbt), OpenLineage emite eventos JSON estructurados durante la ejecución de las consultas. Plataformas como DataHub o Apache Atlas procesan estos flujos para construir grafos dirigidos acíclicos (DAGs) de extremo a extremo que trazan la ruta del dato desde el write-ahead log original de PostgreSQL, pasando por los tópicos de Kafka y las capas bronze/silver/gold de Iceberg, hasta los elementos visuales individuales de los informes en PowerBI o Tableau.
Ante una alteración de esquema o la identificación de datos personales desprotegidos, los oficiales de seguridad pueden verificar en segundos cada tabla y cuadro de mando afectado en la compañía.
Cumplimiento del Derecho al Olvido (RGPD / CCPA) sin Reescribir Particiones Completas
Conforme al Artículo 17 del RGPD y regulaciones análogas en América Latina, las empresas deben suprimir de manera permanente los datos personales de un usuario en un plazo inferior a 30 días tras su solicitud. En un data lake inmutable tradicional, eliminar una fila obligaba a leer particiones históricas completas de varios gigabytes, filtrar el registro correspondiente y reescribir archivos Parquet totalmente nuevos, incurriendo en un gasto computacional prohibitivo y una sobrecarga extrema en las llamadas a la API de S3.
En un Lakehouse moderno basado en Iceberg o Delta Lake, el Derecho al Olvido se ejecuta a través de un ciclo disciplinado en dos fases:
-
Fase 1: Supresión Determinista por Merge-on-Read: El orquestador ejecuta una sentencia SQL
DELETEdirigida al identificador del cliente. El motor registra un archivo Position Delete ligero o un Vector de Eliminación marcando la fila como cancelada sin alterar el archivo Parquet subyacente. Los motores de consulta dejan de retornar el registro de inmediato, cumpliendo el requerimiento legal en milisegundos. -
Fase 2: Compactación Física y Purgado de Instantáneas: Durante el mantenimiento semanal programado, la rutina de FinOps ejecuta
rewrite_data_files, eliminando definitivamente las filas marcadas y reescribiendo bloques Parquet optimizados. A continuación, el orquestador ejecutaexpire_snapshotssuperando la ventana de gracia legal de 30 días y correremove_orphan_filespara destruir irreversiblemente los datos del almacenamiento físico.
-- Procedimiento Automatizado de Cumplimiento RGPD en Apache Iceberg
-- 1. Borrado transaccional inmediato con Merge-on-Read
DELETE FROM lakehouse.gold_crm.clientes
WHERE customer_id = 'cust_99281a8b';

-- 2. Consolidación física de archivos Parquet eliminando filas canceladas
CALL lakehouse.system.rewrite_data_files(
    table => 'gold_crm.clientes',
    strategy => 'binpack'
);

-- 3. Expiración de instantáneas históricas superado el plazo de gracia legal
CALL lakehouse.system.expire_snapshots(
    table => 'gold_crm.clientes',
    older_than => TIMESTAMP '2026-02-01 00:00:00',
    retain_last => 5
);

-- 4. Supresión física de archivos huérfanos sin referencia en Amazon S3
CALL lakehouse.system.remove_orphan_files(
    table => 'gold_crm.clientes',
    older_than => TIMESTAMP '2026-02-01 00:00:00'
);
12. Modelos Matemáticos de TCO a 3 Años: Escenarios para 10TB, 100TB y 1PB
El respaldo financiero para transformar la arquitectura de datos corporativa y migrar hacia un Lakehouse Abierto en Tiempo Real se sustenta en fórmulas cuantitativas rigurosas de coste unitario:
Fórmula del Coste Total de Propiedad (TCO) del Lakehouse
Donde:
• C_almacenamiento = V_tb * (1 - R_zstd) * P_s3_standard + V_meta * P_s3 + N_peticiones_api * P_operaciones_s3
• C_computo_etl = H_horas_compactacion * N_nucleos * P_instancia_spot
• C_computo_servicio = N_nodos_olap * P_instancia_reservada + Q_coste_serverless
• C_recargo_propietario = 0 (Formatos de tabla 100% abiertos, cero recargo por créditos de consulta)
Tres Escenarios Corporativos: Comparativa Financiera Proyectada a 3 Años
Escenario A: Mid-Market 10 TB de Huella Analítica
25 Usuarios Concurrentes • Micro-Lotes Horarios
- DWH Cloud Heredado (Snowflake/BigQuery): $148,000 / año ($444,000 en 3 años). Ocasionado por almacenes virtuales siempre activos y sobrecostes de almacenamiento.
- Lakehouse Abierto (Iceberg + DuckDB/ClickHouse Cloud): $58,000 / año ($174,000 en 3 años). Almacenamiento estándar S3 y servicio analítico serverless.
- Ahorro Neto a 3 Años: $270,000 (Reducción Neta del 60.8%).
Escenario B: SaaS en Crecimiento 100 TB de Huella Analítica
150 Usuarios Concurrentes • Streaming CDC Continuo
- DWH Cloud Heredado (Snowflake Enterprise + Fivetran): $580,000 / año ($1,740,000 en 3 años). Facturación intensiva por créditos de Snowpipe y clústeres multi-almacén.
- Lakehouse Moderno (Iceberg + Redpanda + StarRocks + dbt): $215,000 / año ($645,000 en 3 años). Almacenamiento S3 + nodos reservados OLAP + streaming open-source.
- Ahorro Neto a 3 Años: $1,095,000 (Reducción Neta del 62.9%).
Escenario C: Gran Empresa 1 PB de Huella Analítica
1,000+ Usuarios Globales • Malla Multi-Cloud
- Arquitectura DWH Propietaria Tradicional: $2,450,000 / año ($7,350,000 en 3 años). Elevadísimo consumo de créditos de cómputo, replicación de datos entre regiones y costes de salida.
- Enterprise Lakehouse (Polaris + Iceberg + Trino + StarRocks): $810,000 / año ($2,430,000 en 3 años). Almacenamiento S3 con Intelligent-Tiering + clústeres Trino en instancias Spot.
- Ahorro Neto a 3 Años: $4,920,000 (Reducción Neta del 66.9%).
Modela la escala analítica específica de tu organización y calcula el ahorro económico exacto de desmantelar almacenes propietarios en favor de un Lakehouse Abierto en Tiempo Real:
13. Playbook de Migración al Lakehouse en 90 Días para Chief Data Officers
Migrar una infraestructura analítica en producción desde un almacén propietario heredado hacia un Lakehouse Abierto en Tiempo Real exige una ejecución por fases metodológica y libre de riesgos para la continuidad del negocio. El siguiente plan de 90 días detalla el itinerario técnico para líderes de datos y arquitectos de sistemas:
Fase 1 (Días 1–30): Cimientos, Despliegue del Catálogo REST e Ingestión CDC en Sombra
- Días 1–10: Despliegue del Catálogo REST Corporativo: Implementa una instancia de Catálogo REST de Apache Iceberg (Apache Polaris o Project Nessie) en Kubernetes o cloud gestionado. Configura los buckets de almacenamiento en Amazon S3 con políticas de ciclo de vida e IAM de privilegios mínimos.
- Días 11–20: Ingestión por Streaming y Captura CDC Espejo: Configura la captura de cambios de estado con Debezium o PeerDB sobre las bases transaccionales primarias. Canaliza los flujos hacia Redpanda o Kafka. Despliega conectores con Apache Flink o Spark Streaming para escribir tablas Iceberg Bronze con Merge-on-Read en paralelo al warehouse tradicional.
- Días 21–30: Validación de Doble Escritura sin Impacto: Verifica que las tablas Bronze y Silver en Iceberg reciban transacciones en tiempo real con latencias sub-segundo sin degradar el rendimiento de las bases de datos transaccionales en producción.
Fase 2 (Días 31–60): Conciliación en Paralelo, Contratos de Datos y Capa Semántica
- Días 31–40: Migración de Modelos dbt a Iceberg: Adapta las transformaciones analíticas a dbt Core/Cloud apuntando hacia un motor abierto (Trino o Spark). Habilita la validación formal de contratos de modelo mediante
contract: enforced: true. - Días 41–50: Auditorías de Conciliación y Paridad Automatizada: Despliega pruebas de integridad con Soda Core comparando recuentos de filas, sumatorios métricos y sumas de verificación (checksums) entre el warehouse heredado y las tablas Gold del Lakehouse. Mantén la doble ejecución durante 10 días hasta constatar una paridad del 99.999%.
- Días 51–60: Implementación de la Capa Semántica Unificada: Despliega Cube o dbt Semantic Layer (MetricFlow). Estandariza las métricas clave y publica endpoints con protocolo PostgreSQL wire para herramientas de BI (Tableau, PowerBI, Superset).
Fase 3 (Días 61–90): Transición al Servicio Vectorizado, Compactación y Desmantelamiento
- Días 61–70: Activación del Nivel OLAP Vectorizado: Despliega un clúster de StarRocks o ClickHouse con caché local NVMe sobre las tablas Gold de Iceberg. Conmuta las conexiones de los cuadros de mando directivos hacia este nivel; comprueba la caída en la latencia P99 de 2.5s a menos de 150ms.
- Días 71–80: Automatización de Compactación FinOps y Purga de Instantáneas: Programa ejecuciones automáticas de
rewrite_data_filescon bin-packing yexpire_snapshotsen horas valle para consolidar archivos Parquet en 128MB y mantener una ventana de retención de 7 días. - Días 81–90: Apagado Definitivo del Almacén Tradicional: Traslada los analistas ad-hoc restantes a Trino/DuckDB. Pasa el warehouse propietario a modo solo-lectura durante 14 días y procede al desmantelamiento de sus almacenes de computación, consolidando un ahorro mensual recurrente del 55% al 68%.
14. Modelo Operativo, Principios de Data Mesh y KPIs Clave del Lakehouse
La tecnología por sí sola no evita que las plataformas analíticas degeneren en silos ineficientes. Adoptar un Modern Data Stack requiere reorganizar la estructura de los equipos según los principios de Data Mesh y gobernar la plataforma mediante Objetivos de Nivel de Servicio (SLOs) cuantificables.
Propiedad de Datos Descentralizada Orientada a Dominios
En lugar de canalizar todas las solicitudes a través de un departamento centralizado y saturado de ingenieros de datos, el paradigma de Data Mesh delega la responsabilidad a equipos multidisciplinares de dominio (ej. Dominio de Pagos, Dominio de Logística, Dominio de Clientes).
- Equipos de Dominio como Propietarios de Productos de Datos: Los desarrolladores del servicio de pagos definen los contratos de datos y mantienen las tablas Bronze y Silver de sus transacciones en Iceberg. Publican "Datos como Producto" respaldados por acuerdos de calidad y frescura formales.
- Equipo de Plataforma de Datos Central: Opera como proveedor interno de infraestructura compartida. Administra los clústeres en Kubernetes, el Catálogo REST Apache Polaris, los nodos StarRocks, las herramientas de linaje en OpenLineage y las puertas de enlace de CI/CD.
KPIs Operativos Críticos de la Arquitectura de Lakehouse
| KPI Operativo | Objetivo de Referencia (2026) | Acción Correctiva si se Incumple |
|---|---|---|
| Ratio de Amplificación de Escritura (WAR) | < 1.25x en ingestión streaming | Migrar de Copy-on-Write (COW) a Merge-on-Read (MOR) con position deletes o incrementar el intervalo de confirmación de 500ms a 5s. |
| Proporción de Archivos Pequeños (< 32MB) | < 5% del total de archivos por partición | Ampliar la ventana de micro-lotes en Flink o acelerar la frecuencia de compactación mediante rewrite_data_files con bin-packing. |
| Latencia P99 de Cuadros de Mando BI | < 250ms a 1,000 QPS concurrentes | Trasladar las consultas de Trino a StarRocks/ClickHouse empleando caché NVMe local y Vistas Materializadas transparentes. |
| Retraso de Frescura (Ingestión a Servicio) | < 30 segundos en dominios críticos | Reemplazar procesos batch heredados por flujos CDC con Debezium y Flink escribiendo directamente en Iceberg. |
| Tasa de Aprobación de Contratos de Datos | > 99.98% en todas las ejecuciones | Bloquear migraciones de esquema incompatibles en el CI/CD de los repositorios Git upstream mediante comprobaciones de Soda Core. |
| Eficiencia de Compresión FinOps | > 3.2x frente a JSON sin comprimir | Estandarizar las configuraciones de los escritores Parquet en el códec de compresión ZSTD nivel-3. |
15. Preguntas Frecuentes Técnicas (FAQ)
Benchmarks Arquitectónicos de Datos Relacionados
Explora nuestros análisis técnicos empíricos sobre infraestructura moderna de datos, motores de almacenamiento, brokers de eventos y costes de propiedad en la nube: